
LM Studioは、AIモデルをローカルで実行するためのアプリケーションとして、最もよく知られているものの1つです。ローカルLLM GUIとして、ローカルモデルとのチャットや新しいモデルのテストに最適化されており、初心者から愛好家まで幅広く支持されています。ただし、ニーズによっては最適な選択肢ではない場合もあります。
このガイドでは、次の内容を解説します。
- LM Studioの代替ツールを検討する理由
- AIモデルをオフラインで実行するためのおすすめLM Studio代替ツール。Mac、Windows、Linuxに対応するオープンソースやクロスプラットフォームの選択肢も紹介します
- 自分の用途に最適な代替ツール
要約
LM Studioの代替ツールを検討する主な理由は、古いハードウェアへの対応が比較的限られていること、AMD GPU向けの最適化が不足していること、デスクトップGUIを中心としたワークフローが自分の用途に合わないことです。ただし、LM StudioもllmsterによるGUIなしの実行に対応しています。ヘッドレス実行、スクリプトによる操作、エージェントを使う場合も、対応する機能を比べて選びましょう。(初めて取り組む方には、LLMをローカルで実行する方法のガイドで基礎を解説しています。)
オープンソースかどうかも検討要素です。ローカルAIのモデルやツールは、現在最も活発なオープンソースエコシステムの1つを形成しています。一方、LM Studioはプロプライエタリかつクローズドソースのままであり、それだけでも代替ツールを検討する理由になる人もいます。
では、おすすめのLM Studio代替ツールはどれでしょうか。私たちが選んだ主な候補は次のとおりです(順不同)。
- Atomic Chat。私たちが開発したローカルAIアプリです。Atomic Chatでは、Hugging Faceの1,000を超えるローカルAIモデルを自分のマシンで実行できます。OpenClaw、Hermes、Kiloなどのエージェント向けに、ヘッドレスで動作するモデルへのOpenAI互換インターフェースを提供し、KV最適化によって最大約4倍の性能向上をもたらすTurboQuantにも対応しています。
- Ollama。アプリケーション構築向けの軽量なローカルAIランタイム兼バックエンドです。シンプルなAPIを通じて、言語モデルのダウンロード、管理、配信を簡単に行えます。
- Jan。モデルをダウンロードしてチャットするだけでよい場合に最適な、オープンソースのデスクトップアプリです。特に使いやすいUIを備えており、オフラインでChatGPTのような体験を実現するのに最適です。
- llama.cpp。ラッパーを使わずに実行すると、GGUFモデルに対して高速かつ効率的なCPU・GPU推論を提供する推論エンジンです。
- AnythingLLM。ドキュメントと検索拡張生成(RAG)に重点を置いたローカルAIワークスペースです。自分のファイルについてチャットしたり、ナレッジソースを接続したり、自分のデータを基盤とするアシスタントを構築したりできます。
- Open WebUI。ローカルおよびホスト型AIモデル向けの洗練されたWebインターフェースです。複数モデルでのチャット、エージェント、ツール、ワークフローに対応していますが、その名前に反して、現在は完全なオープンソースではありません。
- Text Generation WebUI。ローカル言語モデルの実行、テスト、ファインチューニングに対応する包括的なインターフェースです。複数の推論バックエンドに対応し、ファインチューニング機能を内蔵する数少ないデスクトップツールの1つです。
- Lemonade。AMDハードウェア向けに設計されたローカル推論エンジンです。現在、CPUやGPUに加えてNPU上でのモデル実行にも対応する、唯一の主要ローカルAIランタイムです。
LM Studio代替ツールの比較
ローカルLLM GUIやバックエンドを選ぶ際に特に重要な機能について、各代替ツールを比較します。
| プロジェクト | オープンソース | 推論エンジン | MCP | ヘッドレス/APIサーバー | 手持ちのGGUFファイルの読み込み | 内蔵モデルブラウザー | モバイル | アカウントの必要性 | 主な用途 |
|---|---|---|---|---|---|---|---|---|---|
| LM Studio | いいえ | llama.cpp、MLX(Apple Silicon) | クライアント + サーバー | はい | はい | はい(Hugging Face連携) | いいえ | いいえ | 洗練されたデスクトップ向けローカルAIアプリ |
| Atomic Chat | はい | llama.cpp | はい | はい | はい | はい | はい | いいえ | 複数のデバイスで利用できるローカルAIチャット |
| Ollama | はい | Ollamaランタイム(llama.cppのコンポーネントがベース) | いいえ | はい | インポートのみ | はい | 公式アプリなし | いいえ | 開発者向けバックエンドとローカルAPI |
| Jan | はい | llama.cpp、Nitro | はい | 限定的 | はい | はい | いいえ | いいえ | オープンソースのLM Studio代替ツール |
| llama.cpp | はい | llama.cpp | 実験的 | はい | はい | いいえ | いいえ | いいえ | 低レベルの推論エンジン |
| AnythingLLM | はい | バックエンドに依存しない(Ollama、LM Studio、llama.cpp、vLLMなど) | はい | はい | バックエンド経由 | はい | いいえ | いいえ | RAGとドキュメントについてのチャット |
| Open WebUI | ソースコード公開 | バックエンドに依存しない | はい | はい | バックエンド経由 | はい | いいえ | 通常はローカルログインが必要 | ローカルモデル向けWebインターフェース |
| Text Generation WebUI | はい | Transformers、llama.cpp、ExLlamaV2など | はい | はい | はい | はい | いいえ | いいえ | 上級ユーザー向け、研究、ファインチューニング |
| Lemonade | はい | ONNX Runtime | MCPサーバー | はい | 限定的(管理対象のモデルディレクトリ) | はい | いいえ | いいえ | AMDハードウェアとNPUによる高速化 |
デスクトップAIアプリ
デスクトップAIアプリは、LM Studioを最も直接的に代替できる選択肢です。いずれもそれ自体がローカルLLM GUIであり、モデルのダウンロード、管理、チャットを行うグラフィカルインターフェースに、それぞれ独自の機能を加えています。
Atomic Chat
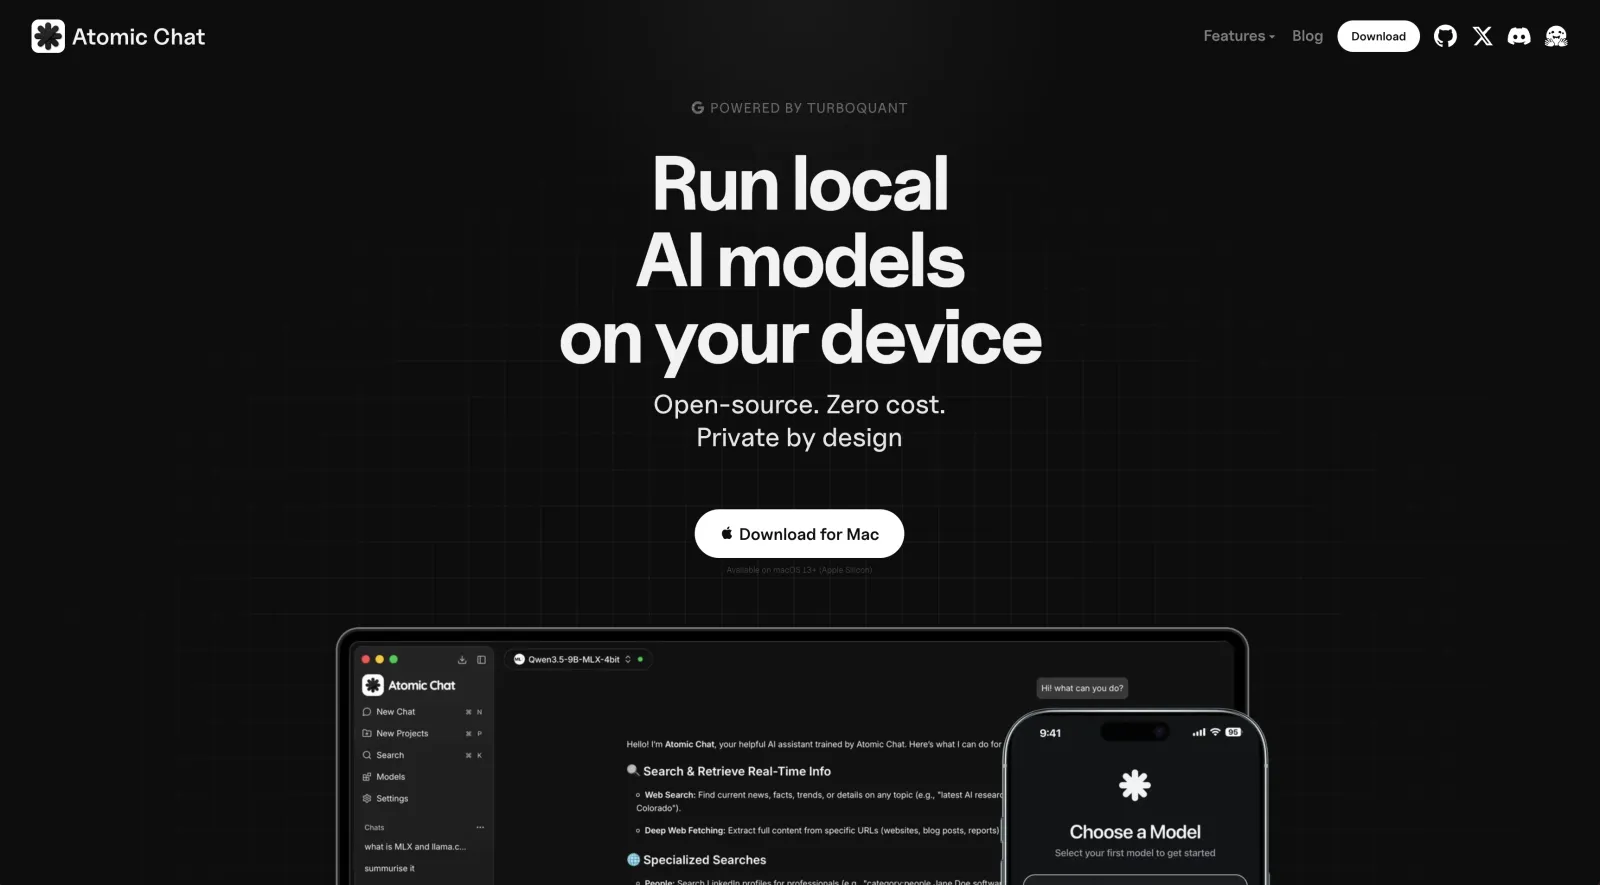
Atomic Chatは、私たちが開発したオープンソースのローカルAIアプリケーションで、次のことができます。
- AIモデルを簡単にローカルで実行
- デスクトップとモバイルデバイスでオフラインAIを実行
- ローカルモデルを、コーディングエージェントやMCPサーバーなどの最新AIツールに簡単に接続
Atomic Chatはアカウントを必要とせず、必須のクラウドサービスにも依存しないため、完全にオフラインで動作し、100%無料です。アプリにはHugging Faceブラウザーが統合されており、ローカルモデルの検索、ダウンロード、実行を非常に簡単に行えます。
Atomic Chatの主な機能:
- モバイルアプリ:Atomic Chatは、デスクトップとモバイルの両方にネイティブアプリを提供する数少ないローカルAIアプリケーションの1つです。小型のローカルモデルはスマートフォンやタブレット上で直接実行でき、Atomic Chatなら外出先でもオフラインAIを活用できます。(iPhoneとAndroid向けのオフラインAIアプリで、この分野のアプリをまとめて紹介しています。)
- エージェントとMCPへの対応:Atomic ChatはMCP(Model Context Protocol)に対応しており、ローカルモデルを外部のツールやサービスに接続できます。また、Claude Code、Codex CLI、Cline、OpenCode、Droid、Goose、OpenHands、Copilot CLI、Kilo Code、Zedなど、人気のコーディングエージェントをワンクリックで起動するランチャーも備えています。
- 複数の推論バックエンド:Atomic Chatは、ハードウェアとモデルの種類に応じて複数の推論エンジンに対応しています。TurboQuantによる最適化を施した独自のllama.cppフォーク、上流のllama.cpp、Apple Silicon上のビジョンモデル向けMLX-VLMです。ハードウェア構成に応じて異なるバックエンドを使用します。例えば、ARM MacではMLXバックエンドによって推論速度が最大4倍になります。
- TurboQuantによるメモリ最適化:TurboQuantは、生成中にそれまでのコンテキストを保存するコンポーネントであるKVキャッシュに必要なメモリを減らすように設計されており、CPUとGPUのワークロードでKVキャッシュのメモリ使用量を最大4.3×の圧縮率で削減します。
- 個別の性能最適化:Atomic Chatは、複数のトークンを先読みして予測することで生成速度の向上を目指すMTP(Multi-Token Prediction)と、投機的デコーディングの技術を使って特定のモデルを高速化するDFlashも使用しています。
- OpenAI互換のローカルAPI:Atomic Chatは、localhost:1337で動作するOpenAI互換のローカルAPIサーバーを提供しており、AIエージェントやアプリの接続先として指定できます。
Atomic Chatが最も適しているのは…デスクトップとモバイルで動作し、Hugging Faceのローカルモデルに対応し、最新のエージェントワークフローに直接統合できる、単一のローカルAIアプリケーションを求めるユーザーです。最小限のバックエンドや低レベルの推論ツールキットとしての役割には、あまり重点を置いていません。
Jan AI
Janは、LM Studioのようなツールに代わる、ローカルでの利用を優先したオープンソースのデスクトップAIアプリケーションです。ローカルモデルのダウンロードと実行を行うグラフィカルインターフェースを提供するとともに、ほかのアプリケーションがモデルに接続できるAPIも公開します。
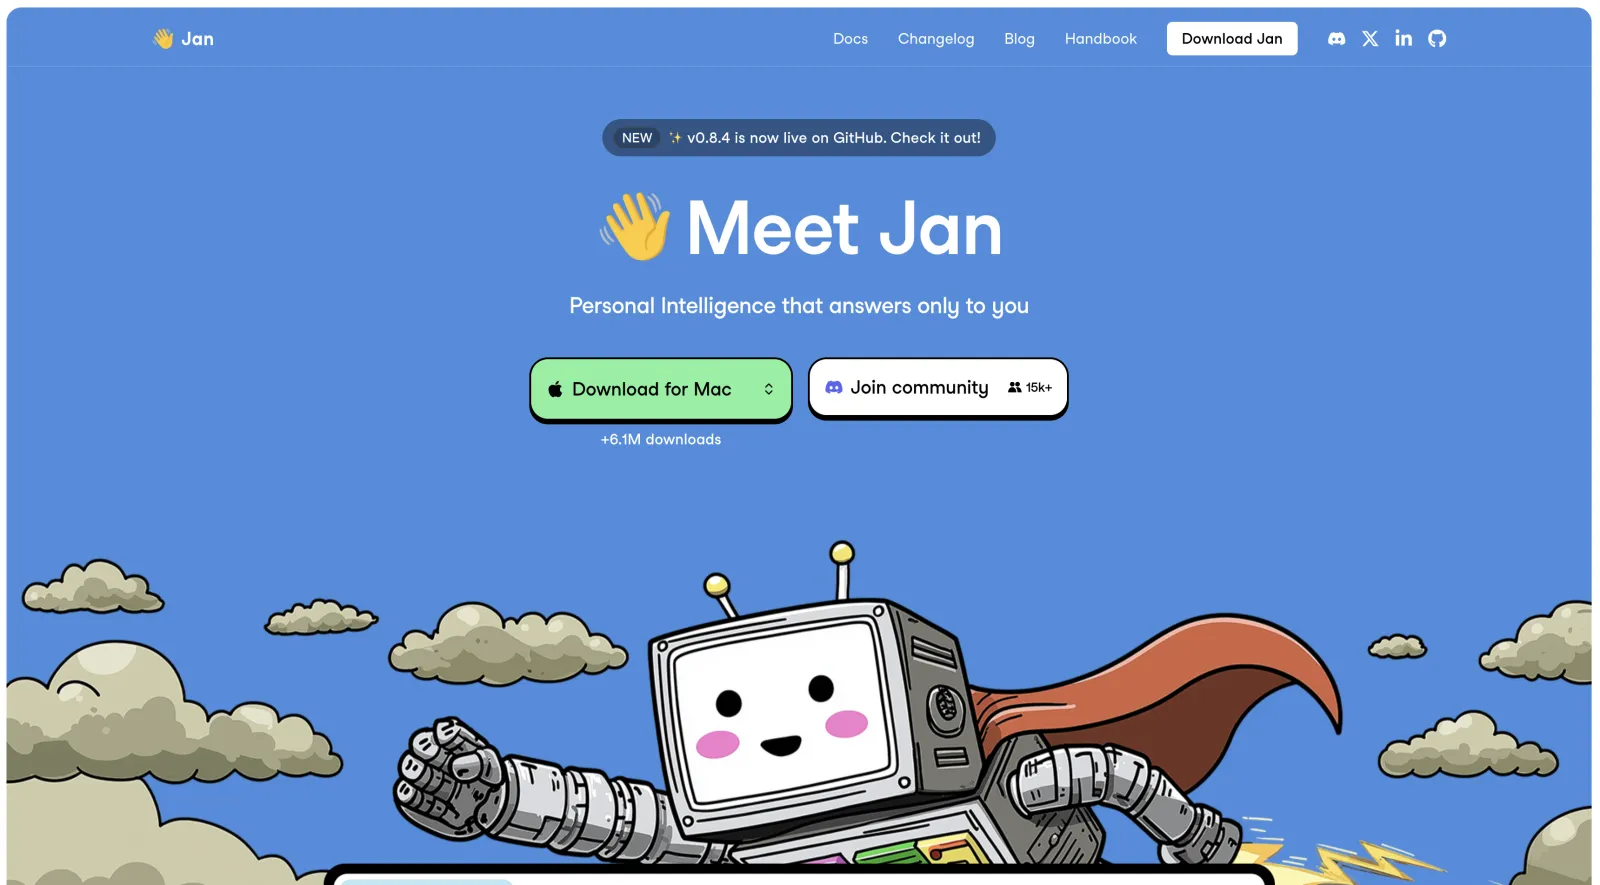
主にバックエンドランタイムとしての役割に重点を置くOllamaとは異なり、Janはモデル管理、チャット、拡張機能、開発者向け機能を1つのアプリケーションに組み込み、総合的なデスクトップ体験を提供することを目指しています。
Janの主な機能:
- オープンソースのデスクトップアプリ:JanはApache-2.0ライセンスで公開されています。アプリケーションスタック全体が公開されているため、内容の確認、変更、プロジェクトへの貢献が可能です。
- 複数の推論エンジン:Janは、llama.cppと独自のNitroエンジンを通じてローカル推論に対応しています。これにより、一般ユーザー向けの高水準インターフェースを提供しながら、GGUFモデルを実行できます。
- モデル管理:Janにはモデルブラウザーとダウンローダーが統合されており、ファイルを手動で管理しなくてもモデルを検索してインストールできます。既存のGGUFモデルのインポートも可能です。
- MCPへの対応:JanはModel Context Protocolに対応しており、標準化されたインターフェースを通じてローカルモデルを外部のツールやサービスに接続できます。
- OpenAI互換API:JanはOpenAI互換APIを通じてローカルモデルを公開できるため、対応アプリケーションでクラウドAIプロバイダーのローカルな代替として利用できます。
Janの制約:Janはヘッドレスサーバーではなく、主にデスクトップアプリケーションです。APIアクセスを提供できますが、通常は先にデスクトップアプリケーションを起動する必要があるため、Ollamaやllama.cppと比べると常時稼働のサーバー環境にはあまり適していません。
Janが最も適しているのは…洗練されたデスクトップインターフェース、ローカルモデル管理、MCPなどの最新AI連携への対応を備えた、オープンソースのLM Studio代替ツールを求めるユーザーです。サーバーへのデプロイや最小限の推論バックエンドとしての役割には、あまり重点を置いていません。
ローカルAIバックエンド
ローカルAIバックエンドを使うと、オフラインAIモデルをヘッドレスモードで実行し、AIを利用するほかのアプリに配信したり、OpenClaw、Kilo、Clineのようなコーディングエージェントを動作させたりできます。
Ollama
Ollamaは主にバックエンドとして設計されています。モデルをローカルで実行し、ほかのアプリケーション、スクリプト、AIエージェントが接続できるAPIを提供します。この設計により、ローカル推論における開発者の事実上の標準となりました。(ランタイムとエンジンの違いについてはOllamaとllama.cppの比較を、LM Studioとの直接比較についてはOllamaとLM Studioの比較をご覧ください。)
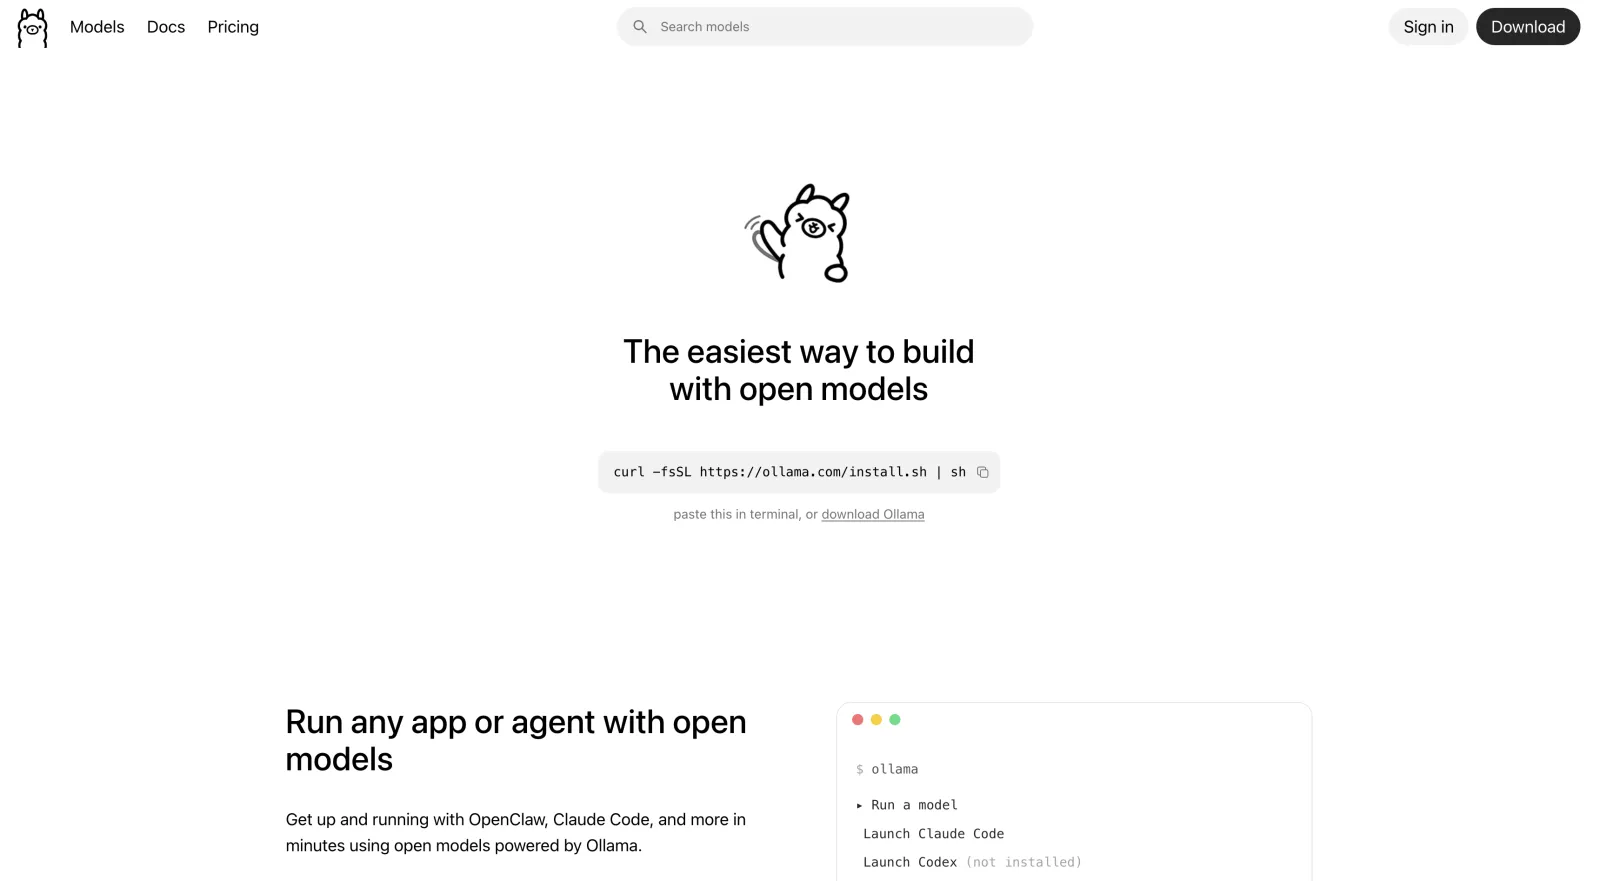
Ollamaの主な機能:
- オープンソースのランタイム:OllamaはMITライセンスで公開されています。デスクトップアプリケーションは当初別個に開発されていましたが、後にそのソースコードがメインのオープンソースリポジトリに統合されました。
- 複数の推論バックエンド:Ollamaは、独自のランタイムコンポーネント、llama.cppベースの実行機構、Apple Silicon向けのMLX対応を組み合わせて使用しています。
- エージェント向けツール:Ollamaは、コマンド実行、ファイルアクセス、Webツール、承認制御、コンテキスト管理、Anthropic方式のSkillsシステムなど、エージェントワークフロー向けのツールを内蔵しています。
- デプロイを前提とした設計:Ollamaは、バックグラウンドサービス、Dockerコンテナ内、ヘッドレスサーバーとして実行できます。そのため、ローカルモデルを基盤とするアプリケーションを構築する開発者によく選ばれています。
- API互換性:OllamaはOpenAI互換APIに対応し、Anthropic方式のワークフローとの互換性も提供しているため、既存のAIツールと簡単に接続できます。
Ollamaの制約:特に、OllamaはMCP(Model Context Protocol)にネイティブ対応していません。連携レイヤーとしてMCPを採用する代わりに、独自のエージェントツールのエコシステムを開発しています。モデル管理も、多くのデスクトップAIアプリとは異なります。Ollamaは、ユーザーがGGUFファイルの任意のフォルダーを直接参照できる方式ではなく、独自の管理ストレージシステムにモデルを保存します。既存のモデルは通常、Modelfileを使うワークフローでインポートする必要があり、移行中に追加のディスク容量が必要になる場合があります。
Ollamaが最も適しているのは…アプリケーション、スクリプト、自動化、AIエージェント向けに、信頼性の高いローカルAIバックエンドを必要とする開発者です。Ollamaがしっくりこない場合は、おすすめのOllama代替ツール10選で各選択肢を比較しています。
llama.cpp
llama.cppは低レベルの推論エンジンです。Atomic Chat、LM Studio、JanのようなGUIアプリとは異なり、完全なユーザーインターフェースやモデルマネージャーは提供しません。代わりに、CPU、GPU、さまざまなOS上で大規模言語モデルを効率よく実行するために設計された、非常に軽量なエンジンを提供します。性能、移植性、幅広いハードウェア対応を理由に、多くのローカルAIアプリケーションが基盤エンジンとしてllama.cppを使用しています。
通常、llama.cppをラッパーなしで実行することはあまりありませんが、それが有利になる状況もあります。例えば、ハードウェアリソースの割り当てを完全に制御したい場合、制約のある環境でメモリのオーバーヘッドを最小限に抑えたい場合、独自の自動化スクリプトに直接組み込みたい場合です。
llama.cppの主な機能:
- オープンソースの推論エンジン:llama.cppはMITライセンスで公開されており、ローカルLLM推論で最も広く使われているプロジェクトの1つです。
- 幅広いハードウェアへの対応:llama.cppはCPU推論に加え、NVIDIA GPU向けのCUDA、Apple Silicon向けのMetal、Vulkan、その他のハードウェアアクセラレーションレイヤーなど、複数のバックエンドによる高速化に対応しています。
- ほぼあらゆる環境で実行可能:llama.cppは、コマンドラインアプリケーション、ローカルサーバー、組み込みライブラリ、ほかのアプリケーション内の推論バックエンドとして実行できます。
- 高度な最適化:llama.cppには、量子化対応、GPUオフロード、Flash Attention対応、投機的デコーディングなど、メモリ使用量を削減して生成速度を向上させるための幅広い性能最適化が組み込まれています。
llama.cppの制約:llama.cppは低レベルの推論エンジンです。内蔵のモデルマーケットプレイス、洗練されたチャットインターフェース、モバイルアプリ、ドキュメント管理、エージェントワークフローは提供しません。
llama.cppが最も適しているのは…ローカルモデルの実行、ハードウェアアクセラレーション、デプロイを最大限に制御したい開発者、研究者、上級ユーザーです。
Lemonade
Lemonadeは、特にAMDシステムやNPU搭載の最新AI PCにおけるハードウェアアクセラレーションに重点を置いた、オープンソースのローカルAIランタイムです。LM StudioやJanのような汎用アプリケーションとは異なり、主流のAIツールでは見過ごされがちなハードウェア上で、ローカル推論を効率化することを中心に設計されています。

主な目標は、AMD GPU、Ryzen AI NPU、その他の対応ハードウェアなど、利用可能なアクセラレーターを使ってローカルモデルを実行するための統一された方法を提供することです。
Lemonadeの主な機能:
- ハードウェアアクセラレーション:LemonadeはAMDおよびNPUベースのシステムを中心に設計されており、NVIDIAエコシステム以外のハードウェアを明確に対象とする数少ないローカルAIプロジェクトの1つです。CPU推論だけに頼るのではなく、最適化されたランタイムを使って利用可能な計算リソースを活用します。
- AMDを重視した対応:多くのローカルAIアプリケーションは、NVIDIA CUDAやApple Siliconを優先しています。Lemonadeは、従来ソフトウェア対応がより分散していたAMDユーザーの利用体験を改善することに重点を置いています。
- ローカルモデル管理:Lemonadeは、ユーザーが個々のモデルファイルを手動で管理する方式ではなく、独自のモデルカタログと管理システムを通じて対応モデルへのアクセスを提供します。
Lemonadeの制約:Lemonadeはユーザーインターフェースよりもハードウェアに重点を置いています。一般的なチャット、モデルの探索、洗練されたデスクトップ体験において、LM Studioのようなアプリケーションを置き換えることを目的とした設計ではありません。
Lemonadeが最も適しているのは…AMD GPU、Ryzen AIシステム、NPUを使用し、ローカルAIのさらなる高速化と、自分のハードウェアを中心に設計されたランタイムを求めるユーザーです。
AIワークスペースと特化型ツール
これらのアプリは、情報検索やドキュメントについてのチャットなど、特定のAI用途に高度に最適化されています。実際にモデルを実行するAtomic ChatやLM StudioなどのデスクトップAIアプリと組み合わせて使う場合もあります。これにより、モデルでできることが広がります。
AnythingLLM
AnythingLLMは、検索拡張生成(RAG)とドキュメントについてのチャットを通じて、モデルをドキュメント、ナレッジベース、業務データに接続するために設計されています。
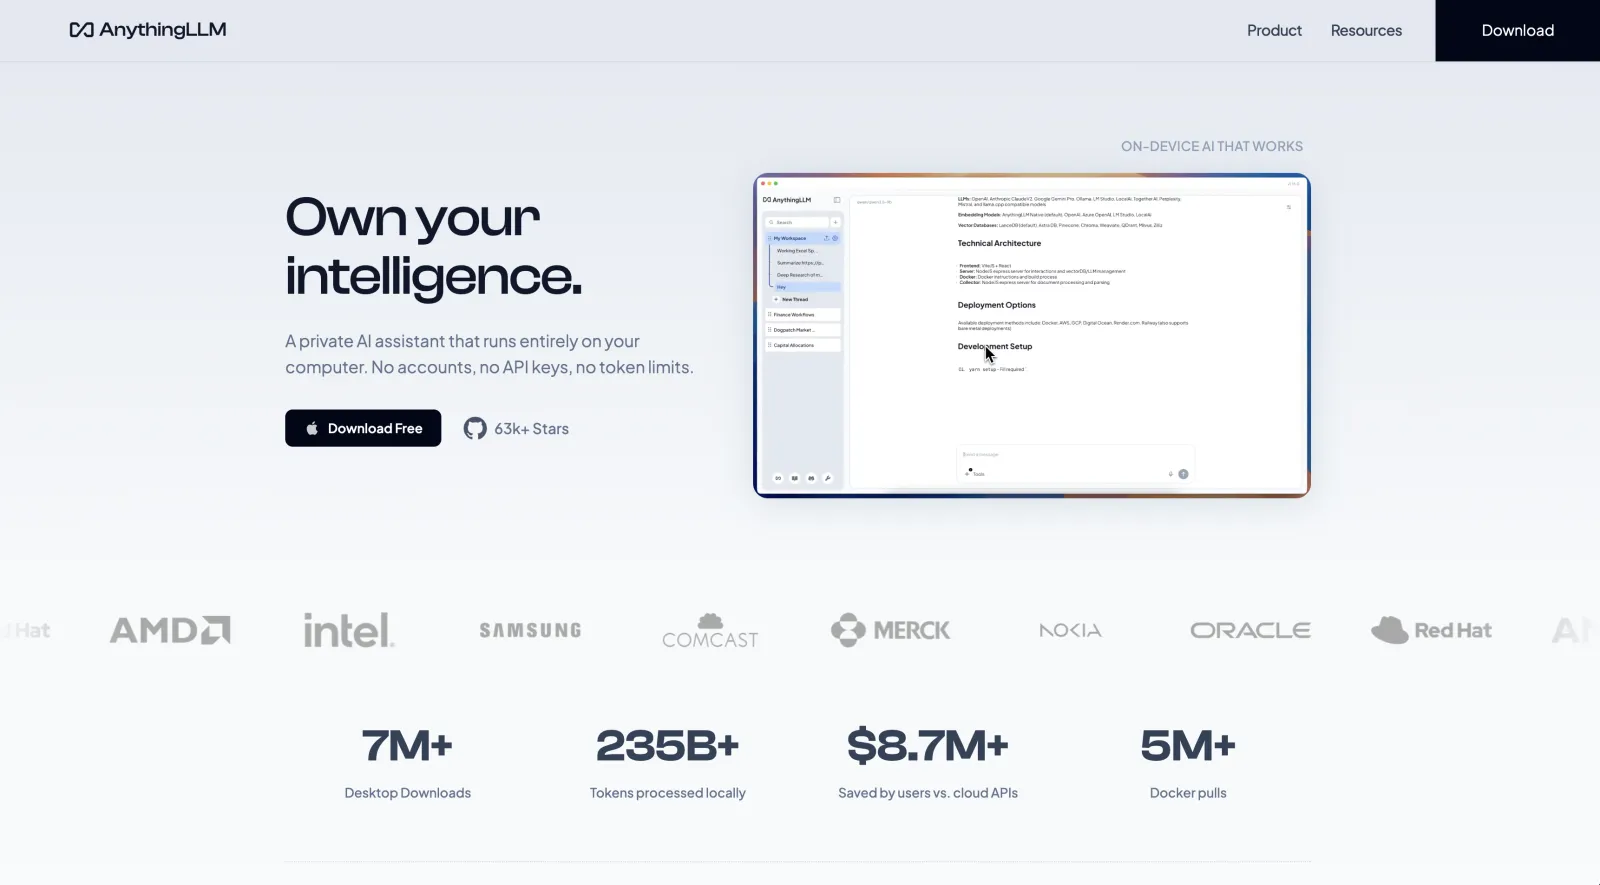
Ollama、LM Studio、llama.cppベースのサーバー、クラウドプロバイダーなど、多様なAIバックエンドに接続できるフロントエンドとして動作します。
AnythingLLMの主な機能:
- ドキュメントAIとRAG:AnythingLLMは、ユーザーが自分のファイルについてチャットできるようにすることに主眼を置いています。ドキュメントをアップロードして処理し、ローカルモデルが会話中に参照できる検索可能なナレッジベースに変換できます。
- エージェントとツール:AnythingLLMには、ツールの使用、接続されたサービスとのやり取り、単純なチャットを超えたタスクの実行ができるAIエージェントが含まれています。モデルを外部ツールに接続するMCP連携にも対応しています。
- サーバーへのデプロイ:AnythingLLMはセルフホスト型のWebアプリとしてデプロイできるため、チームでの利用に適しています。
AnythingLLMの制約:AnythingLLMはナレッジとワークフローのレイヤーです。モデルをローカルで実行するには、別途対応するバックエンドが必要なため、性能やハードウェア対応は選択したモデルランタイムに依存します。
AnythingLLMが最も適しているのは…自分のドキュメント、メモ、社内ナレッジを基盤として、プライベートなAIアシスタントを構築したいユーザーです。
Open WebUI
Open WebUIは、ローカルモデルとリモートモデルにChatGPTのような利用体験を提供するために設計された、セルフホスト型のAIインターフェースです。モデル自体は実行せず、モデルとやり取りするための機能豊富な環境を作ることに重点を置いています。利用するには、Atomic Chat、LM Studio、Janのようなエンジンが必要です。
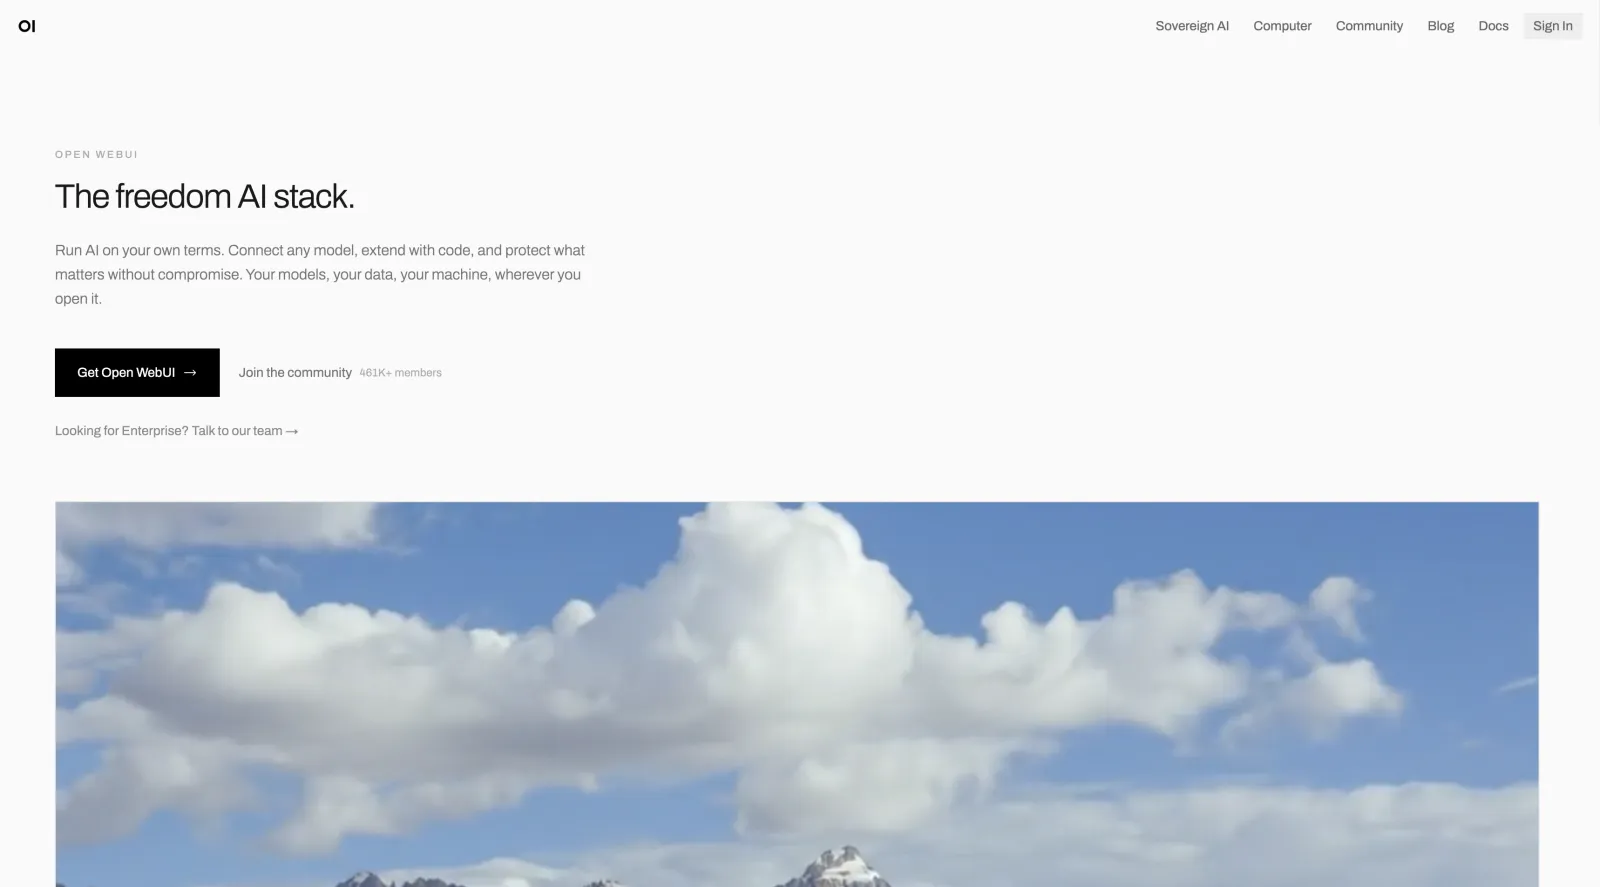
Open WebUIの主な機能:
- 異なるバックエンドで動作するモデルとやり取り可能:Atomic Chat、Ollama、OpenAI互換API、llama.cppサーバー、その他のローカル推論バックエンドに対応しています。
- ChatGPT風のインターフェース:Open WebUIの見た目は、ローカル版のChatGPTによく似ています。
- ドキュメントについてのチャットとRAG:Open WebUIは検索拡張生成に対応しており、ユーザーはドキュメントをアップロードし、ローカルモデルを使ってその内容について質問できます。
- 複数ユーザーへの対応:Open WebUIは、ユーザーアカウント、権限、管理機能を備え、社内AIサービスとしてホストできるため、共有環境での運用を想定して設計されています。
- セルフホストでのデプロイ:Open WebUIはDocker経由でもサーバー上で直接でも実行できるため、デスクトップで時々使う用途よりも、常時稼働の環境に適しています。
Open WebUIの制約:主な制約は、Open WebUIが推論エンジンではないことです。フロントエンドであるため、モデルを実行してその出力をOpen WebUIに提供する別のアプリが必要です。サーバーのセットアップ、アカウントの管理、バックエンドの設定が必要になるため、LM StudioやJanよりも少し複雑になります。
Open WebUIが最も適しているのは…Webインターフェース、複数ユーザー、ドキュメントを扱うワークフロー、多数のモデルバックエンドへの対応を備えた、セルフホスト型AIプラットフォームを求めるユーザーです。
TextGen(Text Generation WebUI)
TextGen(旧称Text Generation WebUI)は、ローカル言語モデルの実行や実験に使える、強力なオープンソースのインターフェースです。さまざまな推論エンジン、モデル形式、拡張機能、ファインチューニングツールを利用したい上級ユーザーを対象としており、モデルの読み込み方や最適化の方法を制御する必要がある愛好家、研究者、開発者によく使われています。
Text Generation WebUIの主な機能:
- 多数の推論バックエンドへの対応:Text Generation WebUIは、Transformers、llama.cpp、ExLlamaV2、AutoGPTQなどのバックエンドに対応しており、手動で選択できます。
- 特色のあるモデル形式への対応:Text Generation WebUIはGGUFだけでなく、例えばsafetensorsや、NVIDIA GPUおよびTransformerベースのワークフローに最適化されたその他の形式にも対応しています。
- ファインチューニングへの対応:TextGenの特に大きな利点の1つは、LoRAファインチューニングを含むモデル学習ワークフローへの対応を内蔵していることです。
- 拡張機能とカスタマイズ:Text Generation WebUIには大規模な拡張機能のエコシステムがあり、追加ツール、独自のインターフェース、マルチモーダル機能、外部連携などの機能を追加できます。
- 高度な制御:TextGenでは、生成パラメーター、メモリ設定、量子化オプション、コンテキスト長を調整して、モデルの動作をカスタマイズできます。このカスタマイズの深さは上級ユーザーに最適ですが、複雑さに圧倒される場合もあります。
Text Generation WebUIの制約:Atomic Chat、LM Studio、Jan、Ollamaと比べると、TextGenはセットアップや設定、特に適切なバックエンドとモデル形式の選択において、はるかに扱いにくいツールです。TextGenはモデルで実験するために設計されているため、APIを提供したり、単にモデルに質問したりする用途では、OllamaやAtomic Chatほど手軽ではありません。
Text Generation WebUIが最も適しているのは…ローカルモデル、実験、ファインチューニングを最大限に制御したい上級ユーザーです。
よくある質問
LM Studioはオープンソースですか?
いいえ。LM Studioのデスクトップアプリケーションはプロプライエタリであり、そのソースコードはGitHubで公開されていません。ユーザーが独自にアプリを監査したり、中核コンポーネントを変更したりすることはできません。ただし、LM Studioは中核部分に多くのオープンソースコンポーネントを使用しています。lmsコマンドラインインターフェース、Apple Silicon向けのMLXベースのランタイムコンポーネント、公式のJavaScriptおよびPython SDKは、MITなどの寛容なライセンスで公開されています。
LM Studioは無料ですか?
LM Studioは、ローカル推論の利用制限なしで無料で使えます。ただし、クラウドサービスに関連する有料機能もあります。例えば、LM Studioは、アカウントと課金が必要なLM Studio Secure Cloudに接続するAIエージェント、Bionicをリリースしました。
LM Studioを仕事や商用プロジェクトに使えますか?
はい。2025年7月以降のライセンスでは、個人利用と社内業務での利用が認められています。制限は主に、再配布、再販、LM Studio自体をホスト型サービスとして提供する行為に適用されます。
LM Studioのシステム要件は何ですか?
LM Studioは、一般的な用途に少なくとも16 GBのRAMを推奨しています。OSのソフトウェア要件は次のとおりです。
- macOS:macOS 14以降を実行するApple Silicon Mac。Intel搭載Macには対応していません。
- Windows:x64版とARM版に対応しています。x64システムにはAVX2 CPU命令が必要です。
- Linux:主にAppImageパッケージとして配布されており、Ubuntu 20.04以降の環境に対応しています。
AIモデルをヘッドレスモードで実行するのに最適なLM Studio代替ツールはどれですか?
ヘッドレスでの運用では、主なLM Studio代替ツールはOllamaとllama.cppです。どちらのアプリも、コマンドラインとサーバーベースのワークフローを中心に設計されています。
LM Studioに代わる最適な無料ツールはどれですか?
チャットや、ローカルモデルを使ったAIエージェントの実行が作業の中心なら、Atomic ChatとJanが、LM Studioと同等の用途で最も近い代替ツールです。
まとめ
LM Studioは、AIモデルをローカルで実行するための最も簡単な方法の1つです。特に、モデルをダウンロードしてチャットするためのシンプルなデスクトップアプリだけが必要な場合に適していますが、すべての用途に最適とは限りません。ソースコードの監査、モバイルデバイスからのローカルAIモデルとのチャット、AMDグラフィックスカードでの最高性能が必要になると、その制約が明確になります。GUIなしでの実行については、LM Studio自体もllmsterに対応しています。要点は次のとおりです。
- LM Studioは、今でもローカルモデルを実行するための最もシンプルな方法の1つです。コマンドラインツールを必要とせず、洗練されたインターフェース、統合されたモデル検索機能、初心者にも使いやすい体験を提供します。
- Atomic Chatは、LM Studioを最も直接的に代替できるツールです。同じ中核機能に加え、TurboQuant、MTP(Multi-Token Prediction)、DFlashによる性能最適化を提供し、スマートフォンやタブレットでローカルAIモデルを実行するためのモバイルアプリも提供しています。
- ローカルAIソフトウェアには、デスクトップアプリ、推論エンジン、AIワークスペース、開発者向けバックエンドなど、さまざまな種類があります。
- LM Studioはオープンソースではありません。ソースコードを監査したり、クローンしたりしたくてもできませんが、私たちが開発したAtomic ChatやOllamaなど、ここで取り上げたほかのアプリの大半では可能です。
- LM Studioは、ほかのAIアプリと併用し続けることもできます。例えば、Open WebUIをフロントエンドとして、AnythingLLMをRAGエンジンとして使うのは一般的です。
- ここで紹介した代替ツール以外にも、GPT4AllやKoboldCppなど、検討する価値のあるローカルLLM GUIがあります。ただし、ほとんどのユーザーにとって、上記の選択肢でデスクトップ、バックエンド、ワークスペースに関する一般的なニーズを満たせます。