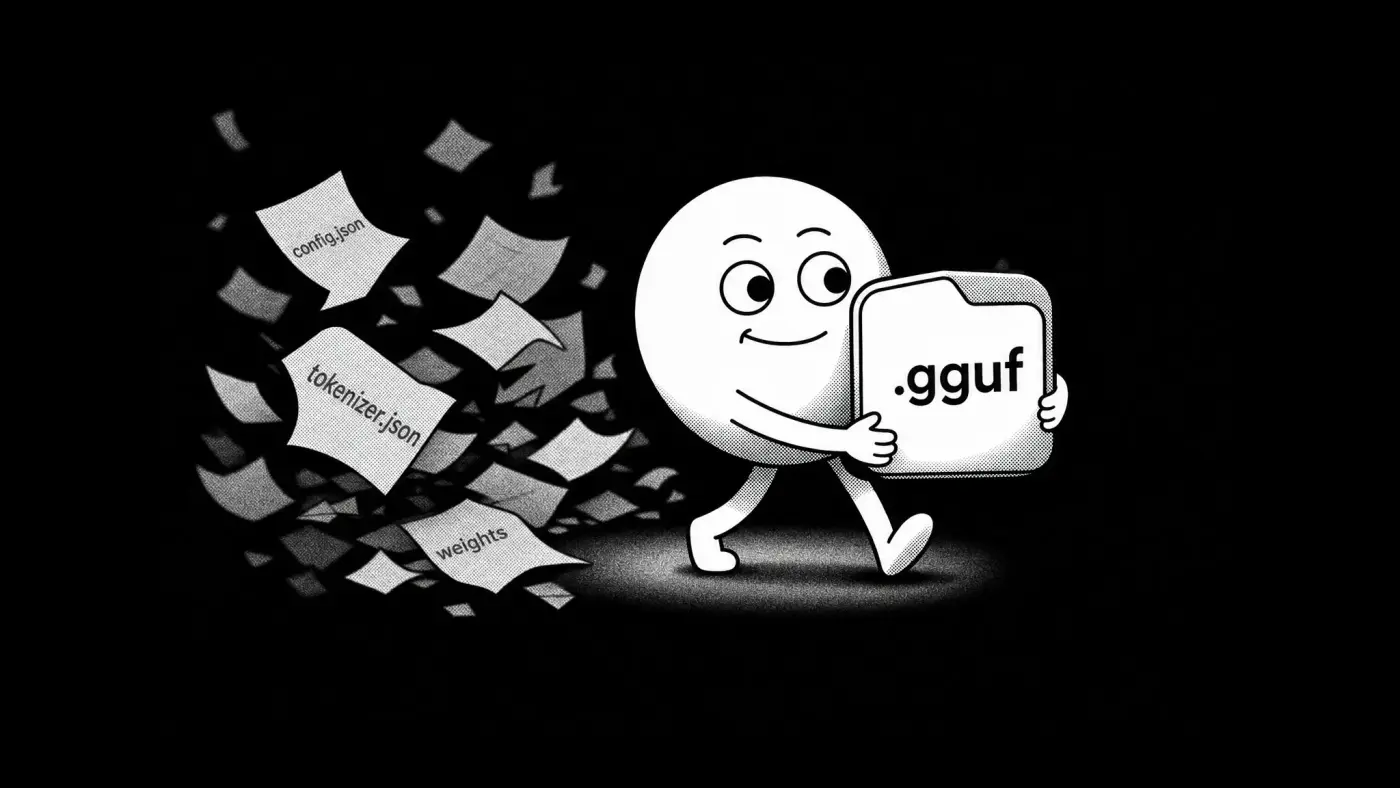


GGUFは、大規模言語モデル(LLM)の配布に使われるファイル形式です。
GGUFファイルは、モデルの重み、トークナイザー、アーキテクチャのメタデータ、ローカルモデルの実行に必要なその他の情報を1つのファイルにまとめ、モデルの共有とデプロイを容易にします。
さらに、ほとんどのモデルは、モデルの重みの精度を下げる量子化のレベルが異なる複数のGGUFファイルとして公開されています。量子化のレベルが高いほど、モデルの実行に必要なRAMやVRAMは少なくなります。
この記事では、次の内容を解説します。
- GGUFとは何か、なぜ作られたのか
- GGUFの仕組み
- GGUFモデル名を読み解き、自分のハードウェアに適した量子化レベルを選ぶ方法
GGUF形式を解説
GGUFは、推論エンジンがローカルの大規模言語モデルを読み込んで実行するために必要なものを、すべて1つのファイルに格納するよう設計されたバイナリコンテナ形式です。LLM向けの.zipファイルや.rarファイルのようなものと考えられます。.ggufファイルには通常、次のものが含まれます。
- モデルの重み
- トークナイザーのデータ
- モデルのアーキテクチャ情報
- テンソルのメタデータ
- 特殊トークン
- 量子化の詳細
- 実行時の設定値
GGUFはこれらの構成要素をまとめることで、モデルを持ち運び可能な単一ファイルとして配布できるようにします。この形式がなければ、モデルを共有するために複数のディレクトリにまたがる複数のファイルが必要になります。実際、GGUF以前は、次のものを個別に格納したリポジトリとしてモデルが配布されていました。
- モデルのパラメータを格納した重みの分割ファイル
- モデルのアーキテクチャを記述する
config.json - トークン化のルールを格納した
tokenizer.json - トークナイザーの設定を含む
tokenizer_config.json - 生成設定ファイル

研究者は、特に学習では今もこうしたディレクトリ形式を使っていますが、Hugging Faceなどのプラットフォームでモデルを広く配布する際には、GGUFが現在の標準になっています。
GGMLとGGUFの比較
GGUFは、以前のGGMLという形式に取って代わりました。GGMLも、Georgi Gerganovがllama.cppとともに作成したものです。GGMLはモデルの重みを効率よく格納できましたが、その重みを説明するためのメタデータが十分ではありませんでした。モデルがどのアーキテクチャを使っているかを確実に識別する方法がなく、新しい設定を追加すると、古いローダーが明確なエラーもなく正常に動作しなくなる可能性がありました。
GGUFは、固定されたフィールドの一覧ではなく、拡張可能なキーと値のメタデータとしてモデル情報を格納することで、この問題を解決しました。ローダーは認識できるキーを読み取り、それ以外を無視するため、新しいアーキテクチャは既存のファイルや読み込みプログラムを壊さずにパラメータを追加できます。GGMLが現在は旧式と見なされるのはこのためです。GGUFはGGMLの機能をすべて取り込み、欠けていた互換性のレイヤーを追加しました。
ほぼすべてのローカルLLMがGGUFを使う理由
GGUFがローカルLLMで最も広く使われている形式なのは、ローカルモデルの実行に有利な機能をいくつも備えているためです。
- モデル全体を1つのファイルとして共有できます
- GGUFは低精度のモデルの重みを効率よく格納し、性能の低いハードウェアでも、より大きなモデルを実行できるようにします。
- GGUFモデルは、CPU、GPU、またはその両方を組み合わせて実行できます。
- GGUFは、llama.cppのサポートを通じて、ほぼ全面的に採用されています。
現在、GGUFはllama.cpp、LM Studio、Jan、KoboldCpp、GPT4All、text-generation-webui、Atomic Chatをはじめ、多くのローカルAIプロバイダーでサポートされています。
ハードウェアを柔軟に活用
GGUFの実用面で特に重要な特徴の1つは、GPUだけに最適化されているわけではないことです。一般消費者向けのハードウェアではよくあることですが、モデルが利用可能なVRAMに収まらない場合、推論エンジンは一部のレイヤーをCPUに送り、ほかのレイヤーをGPUに残すことができます。これにより、グラフィックスカードのメモリ容量を超えるモデルも実行できます。ただし、モデル全体をGPUで実行する場合より、通常は性能が低くなります。
これは、GPTQ、AWQ、EXL2などのほかの形式と比べて、今もGGUFの大きな利点です。これらの形式は、GPU推論に特化して最適化されていることが多く、モデル全体がVRAMに収まる場合には優れた性能を発揮できます。ただし、収まらない場合は性能が低下することがあります。
GGUFはllama.cppのネイティブ形式です。多くのローカルAIアプリケーションは、llama.cppを基盤として構築されているか、互換性のあるライブラリを使っています。llama.cppのエコシステムに改善が加わると、ほかのアプリもその恩恵を受けることがよくあります。
例えば、以下はMulti-Token Prediction(MTP)のデモです。これは、生成中にモデルが複数の後続トークンを予測できるようにする最適化です。検証処理がこれらの予測を確認することで、一部のワークロードでは、モデル自体を変更せずに生成速度を高められます。
Atomic ChatはGemma 4の実装に貢献し、アシスタントモデルを量子化してGGUF形式に変換するとともに、これらの最適化を示すベンチマークとソースコードを公開しました。
LLaMA.cpp向けのMulti-Token Prediction(MTP)!
— atomic.chat (@atomic_chat_hq) 2026年5月7日
Gemma4のローカルモデルを1.5倍高速に実行。
私たちはLLaMA.cppにパッチを適用しました。Gemma 4のアシスタントモデルを量子化し、GGUF形式に変換しました。MacBook Pro M5Maxでテストを実施しました。MTPを使うGemma 26Bは、ドラフトトークンを40%高速に生成します。ベンチマーク、ソースコード、モデルはこちら 👇 pic.twitter.com/hHH1cu1jLi
GGUFにおける量子化とは?
GGUFの最大の利点の1つは、量子化を効率よくサポートしていることです。大規模言語モデルは、重みと呼ばれる数十億個の数値として知識を格納しています。必要なメモリ量は、それらの重みをどれほど精密に表現するかによって変わります。
ほとんどのモデルは、内部では16ビット浮動小数点精度(FP16またはBF16)を使って学習およびリリースされます。この方法は正確ですが、ファイルが非常に大きくなります。
量子化は、モデルの重みを格納する際の精度を下げます。量子化されたモデルでは、各値を16ビットで表す代わりに、8、6、5、4ビットで格納する場合があります。
例えば、次のようになります。
- 70億パラメータのモデルを16ビット精度で格納すると、約15 GBのストレージが必要になる場合があります
- 同じモデルを4ビットに量子化したバージョンは約4〜5 GBになり、必要なメモリ量はおよそ3分の1になります。
その代償として、精度を下げると近似誤差が生じます。格納された値は元の重みと同一ではなくなるため、モデルの出力品質にわずかな影響が出る可能性があります。影響の大きさは、モデル、量子化手法、評価指標によって異なります。ただし多くの場合、4ビットや5ビットに量子化したモデルは、フル精度版の能力の大部分を維持しながら、一般消費者向けGPU、ノートPC、さらにはCPUでも実行できるほど小さくなります。
ここでGGUFが特に役立ちます。GGUFは、精度ごとに別のモデル形式で配布するのではなく、量子化された重みと必要なすべてのメタデータを、標準化された単一ファイルにまとめます。そのため、ほとんどのローカルLLMのリリースでは、同じモデルに対して、量子化レベルが異なる複数のGGUFファイルが提供されます。ユーザーは、自分のハードウェアにとって、メモリ使用量、推論速度、出力品質のバランスが最もよいバージョンを選べます。
GGUFファイル名の読み方
ここからは、大規模言語モデルをローカルで実行したい人に向けて、GGUFを理解するための実践的な内容に入ります。Hugging FaceでGGUFモデルを探すと、通常は同じモデルに対して、次のような名前のファイルが複数見つかります。
Q4_K_M
Q5_K_S
IQ4_XS
Q8_0
これらのファイル名は、おおよそのビット精度、量子化手法、場合によっては具体的なバリエーションなど、モデルがどのように量子化されたかを表しています。読み方が分かれば、自分のハードウェアに適したモデルをはるかに選びやすくなります。
GGUFの一般的な命名パターン
量子化されたGGUFファイルの名前は、ほとんどが次のパターンに従っています。
Q<number>_<method>_<variant>
または
IQ<number>_<variant>
各部分には、それぞれ意味があります。
| 構成要素 | 意味 |
|---|---|
| Q | 標準的な量子化を施した重み |
| IQ | 重要度を考慮した量子化を施した重み |
| 数値 | 重み1つあたりに使うおおよそのビット数 |
| 手法 | 量子化アルゴリズム(例えばK) |
| バリエーション | 同じ手法の異なるバージョン(S、M、Lなど) |
注:通常は同じパターンですが、異なる場合もあります。例えば、古い量子化手法では、手法やバリエーションの部分が省略されることがあります。
GGUFファイル名の例を分解する
次のファイル名を見てみましょう。
Q4_K_M
左から右に読むと、次のようになります。
| 構成要素 | 意味 |
|---|---|
| Q | 標準的な量子化 |
| 4 | 重み1つあたり約4ビット |
| K | K-quant量子化手法を使用 |
| M | 中サイズのバリエーション |
同様に、次のように読み取れます。
Q5_K_S= 5ビットのK-quant、小サイズのバリエーションQ6_K= 6ビットのK-quantQ8_0= 古い量子化方式を使う8ビット量子化IQ4_XS= 重要度を考慮した4ビット量子化、極小サイズのバリエーション

K-quantsとは?
お気づきかもしれませんが、上のファイル名の例にあるKという文字はK-quantsを表しています。K-quantsは、ほとんどのGGUFモデルで使われている現代的な量子化手法のファミリーです。古い量子化方式と比べ、一般に同程度のファイルサイズで、より高い品質を実現します。
一部のK-quantsには、サイズのバリエーションがあります。
- S(小):より強い圧縮により、ファイルサイズを小さくします
- M(中):品質とサイズのバランスをよりよくします
- L(大):精度を高めるため、ファイルがやや大きくなります
一般的な目安として、Q4_K_MのK-quantは、圧縮と性能低下のバランスが最も優れています。
I-quantsとは?
GGUFファイルの中には、次の例のようにIQで始まるものがあります。
IQ4_XSIQ3_MIQ2_S
これらは、重要度を考慮した量子化です。
I-quantsは、モデルのすべての部分を同じように扱うのではなく、キャリブレーションデータを使って、どの重みが精度低下の影響を最も受けやすいかを特定します。これにより、利用可能なビットをより効率よく割り当てられます。この利点はビットレートが非常に低い場合に最も顕著で、I-quantsは同程度のサイズのK-quantsよりも品質を維持できることがよくあります。
- メモリが非常に限られている場合:
IQ4_XSなどのI-quantsや、さらに低ビットのIQバリエーションを検討してください。
古い量子化形式
古いGGUFリポジトリには、次のようなファイルが含まれている場合もあります。
Q4_0Q4_1Q5_0Q5_1
これらは、以前のGGMLエコシステムから引き継がれた従来の量子化形式です。多くの推論ツールで引き続きサポートされていますが、一般にK-quantsのほうが、同程度のファイルサイズで高い品質を実現します。
次のようなものを見かけることもあります。
F16BF16F32
これらは量子化されていません。モデルをフル精度で格納するため、ファイルサイズが大幅に大きくなります。主な用途は日常的なローカル推論ではなく、開発、モデル変換、ファインチューニングです。
量子化の早見ガイド
| 量子化 | 適した用途 |
|---|---|
Q8_0 | メモリを気にせず、最高品質を求める場合 |
Q6_K | 高品質なローカル推論 |
Q5_K_M | 品質重視の汎用用途 |
Q4_K_M | ほとんどのユーザーにとって最適な標準の選択肢 |
IQ4_XS | メモリ容量が少ない場合 |
IQ3 / IQ2 | 必要な場合の極端な圧縮 |
どのGGUF量子化をダウンロードすべきか?
GGUFとは何か、GGUFファイル名をどう読むかが分かったところで、それを実際にどう活用して、自分のシステムに適したモデルサイズを選べばよいのでしょうか。目標は、可能な限り高い精度を使うことではなく、ハードウェアに余裕を持って収まり、実用的な生成速度を得られる最適な量子化レベルで、できるだけ大きなモデルを見つけることです。
おすすめの早見ガイド
Q4_K_Mが第一候補です。
ファイルサイズと出力品質のバランスが優れており、モデルのリリースでは通常、標準の量子化として使われます。次の場合には、量子化の精度を下げたり上げたりできます。
- 利用できるメモリに余裕がある場合:より高い品質を得るために、
Q5_K_MまたはQ6_Kを使ってください。 - メモリが非常に限られている場合:
IQ4_XSや、さらに低ビットのI-quantsを検討してください。 - 評価作業の場合:
F16やQ8_0などの高精度形式を使ってください。
量子化の比較表
例を見てみましょう。以下の表は、7Bモデルにおけるおおよその違いを示しています。
| 量子化 | おおよそのサイズ(7B) | 品質への影響 | 推奨用途 |
|---|---|---|---|
F16 | 15 GB | 基準 | 開発とテスト |
Q8_0 | 8 GB | ごくわずかな低下 | メモリに余裕がある場合の高品質な選択肢 |
Q6_K | 6 GB | 最小限の低下 | 品質に優れた選択肢 |
Q5_K_M | 5.4 GB | 低下は少ない | 品質重視の標準の選択肢 |
Q4_K_M | 4.7 GB | わずかな低下 | 一般的な用途で最もおすすめ |
IQ4_XS | 4.2 GB | より小さいサイズで同程度の品質 | メモリ節約に適した選択肢 |
Q3_K_M | 3.8 GB | 目立つ低下 | メモリが限られている場合にのみ使用 |
Q2_K | 3 GB | 大幅な低下 | やむを得ない場合の圧縮 |
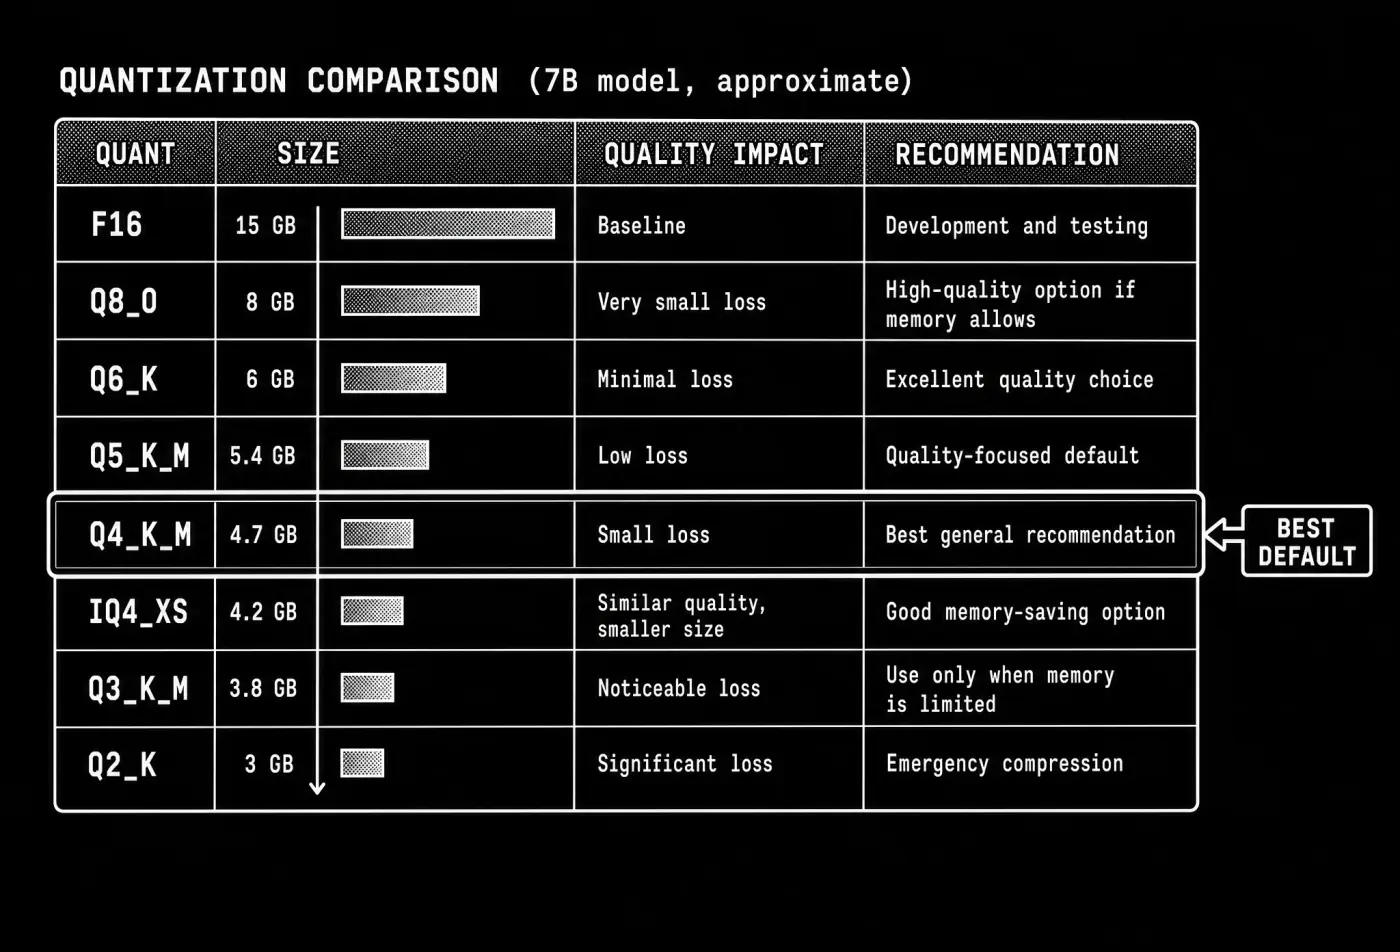
注:高ビットの量子化同士の差は、必要なメモリ量の差から想像するより小さいことがよくあります。Q4_K_MからQ6_Kに変更すると品質が向上する可能性がありますが、その分のメモリを使えるのであれば、通常は、高精度に量子化した小さいモデルよりも、低精度に量子化した大きいモデルのほうが高い性能を発揮します。
品質が最も大きく低下するのは、通常、ビットレートが非常に低い場合です。およそ4ビットを下回ると、強い圧縮による品質低下が目立つようになります。この領域では、重要度を考慮したI-quantsが、古い低ビットのK-quantsよりよい結果を出せる場合があります。
RAMやVRAMに合わせて量子化を選ぶ
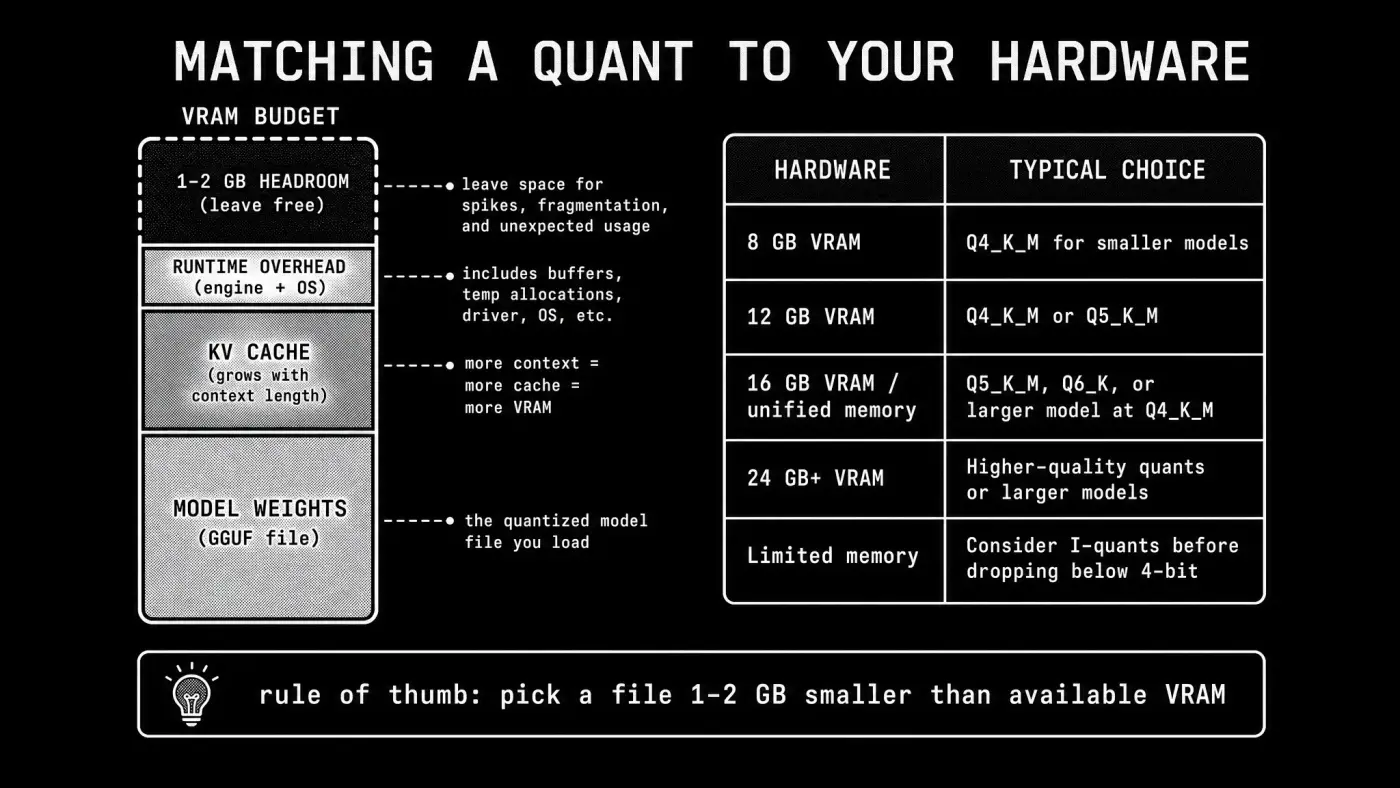
GGUFファイルを選ぶ際に最も重要なのは、推論中にハードウェアが余裕を持ってモデルを保持できるかどうかです。モデルの重みは、必要なメモリの一部にすぎません。推論エンジンは、次の用途にもメモリを必要とします。
- KVキャッシュ:過去の会話のトークンを保存し、モデルが効率よく生成を続けられるようにします。
- 実行時のオーバーヘッド:推論エンジンとオペレーティングシステムが使用するメモリです。
- コンテキスト長:会話が長くなるほど、より大きなKVキャッシュが必要になります。
このため、利用可能なVRAMとちょうど同じサイズのモデルは、うまく動作しない可能性があります。GPUメモリをモデルの重みだけで埋め尽くさず、空きメモリを残してください。
一般的な目安は、利用可能なVRAMより1〜2 GBほど小さいGGUFファイルを選ぶことです。これはあくまで最初の目安であり、コンテキストウィンドウやモデルが大きい場合は、さらに余裕が必要になることがあります。
Apple Silicon搭載Macなど、ユニファイドメモリを使うシステムでは、利用可能なRAMの総量に同じ考え方を適用してください。
| ハードウェア | 一般的な選択肢 |
|---|---|
| 8 GB VRAM | 小さめのモデルにQ4_K_M |
| 12 GB VRAM | Q4_K_MまたはQ5_K_M |
| 16 GB VRAM / ユニファイドメモリ | Q5_K_M、Q6_K、またはQ4_K_Mのより大きなモデル |
| 24 GB以上のVRAM | より高品質な量子化、またはより大きなモデル |
| メモリが限られている場合 | 4ビット未満に下げる前にI-quantsを検討 |
モデルが収まらない場合、通常は次の順に妥協点を探します。
- サイズが小さくなる量子化を使う。
- 同程度のサイズのI-quantを使う。
- より小さいモデルを使う。
- コンテキスト長を短くする。
Q4_K_Mを使わないほうがよい場合
上では、通常はQ4_K_Mを第一候補にするとよいと説明しましたが、別の量子化レベルを選ぶほうがよい場合もあります。
難度の高いタスクで、最大限の正確性が必要な場合。
モデルの重みのわずかな変化に、より敏感なワークロードもあります。例えば、プログラミング、数学的推論、構造化出力の生成は、一般的なチャットや要約よりも誤差の影響を受けやすい場合があります。特にこれらのタスクでは、Q5_K_MやQ6_Kに上げる価値があるかもしれません。
代わりに、より大きなモデルを実行できる場合。
多くの場合、量子化レベルよりもモデルサイズのほうが重要です。低精度に量子化した大きなモデルが、高精度に量子化した小さなモデルを上回ることがあります。例えば、Q4_K_Mの13Bモデルは、形式の精度が低くても、Q8_0の7Bモデルよりよい結果を出すことがよくあります。
一般的な優先順位は次のとおりです。
- 自分のハードウェアに収まる最大のモデルを選ぶ。
- 品質を許容できる範囲に保てる量子化レベルを使う。
- メモリの制約で必要になる場合を除き、4ビット未満に下げるのは避ける。
GGUFモデルのダウンロード先
公開GGUFモデルの最大のコレクションはHugging Faceで利用できます。このプラットフォームにはGGUFのライブラリフィルターがあり、ローカル推論向けに変換済みのモデルを見つけやすくなっています。
GGUFモデルを探すには、Hugging FaceのモデルページでLibrariesフィルターのGGUFを選ぶか、GGUFモデルフィルターを直接使ってください。
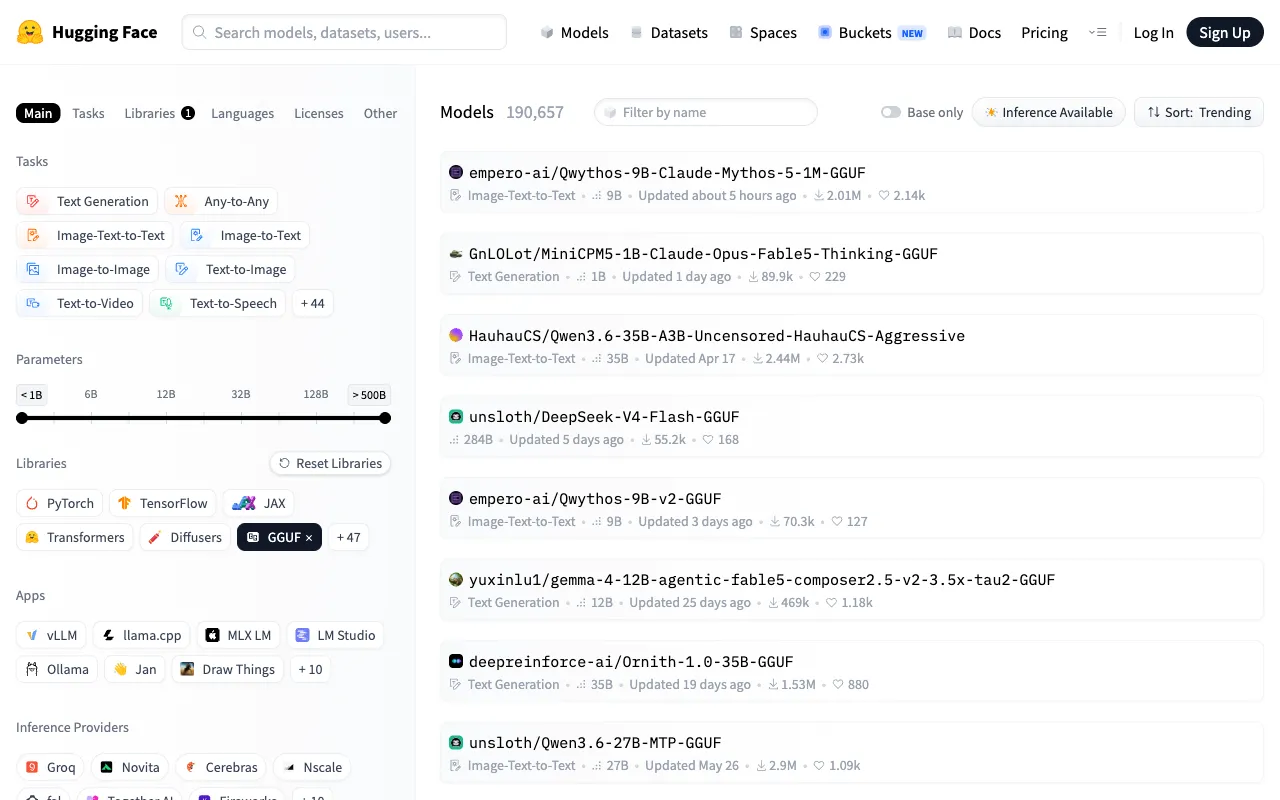
使いたいモデルを検索し、GGUFファイルを含むリポジトリを探してください。人気のあるオープンモデルでは、量子化を専門とするコミュニティメンバーが、元のモデルのリリース直後にGGUF変換版を公開することがよくあります。

信頼できるアップロード元
GGUFファイルは誰でも作成できますが、量子化の品質は変換処理と、モデルに含まれるメタデータによって左右されます。
実績のあるアップロード元は、通常、次のものを提供しています。
- 複数の量子化オプション
- 明確なファイルサイズ情報
- 推奨ハードウェア
- モデル固有の注意事項とベンチマーク
- 正しいトークナイザーとメタデータのファイル
広く利用されているGGUFのアップロード元には、次のようなものがあります。
- bartowski:幅広い量子化リリースと、推奨事項を含む詳細なモデルカードで知られています。
- unsloth:新しくリリースされたモデルのGGUF版を、ドキュメント付きで頻繁に公開しています。
- mradermacher:多くのI-quantリリースを含む、大規模なカタログを維持しています。
- TheBloke:ローカルLLMの量子化エコシステムにおける、初期の主要な貢献者の1人です。このアカウントの古いGGUFリポジトリは、今も数多く利用できます。
GGUFファイルを実行できるローカルLLMアプリは?
.ggufファイルは、あくまでモデルファイルです。使うには、モデルを読み込んでテキストを生成できる推論エンジンやアプリケーションが必要です。GGUFは、次のような多くのローカルAIアプリケーションでサポートされています。
- llama.cpp:GGUF推論の参照実装です。低レベルの制御が可能で、CPU、GPU、ハイブリッド推論をサポートしています。
- Ollama:モデル管理、CLI、ローカルAPIを提供するローカルモデル用ランタイムです。
- LM Studio:ローカルモデルを探し、ダウンロードし、チャットするためのデスクトップアプリケーションです。
- Jan:ローカルでの利用を優先するAIを中心に設計された、オープンソースのデスクトップアプリケーションです。
- Open WebUI:Ollamaやllama.cppなどのローカル推論バックエンドに接続するブラウザーインターフェースです。
- Atomic Chat:GGUFモデルの検索と、ハードウェアに応じたモデル選択の機能を内蔵したローカルAIアプリケーションです。
ローカルAIアプリケーションを比較している方は、OllamaとLM Studioの比較と、おすすめのローカルLLMアプリに関するガイドをご覧ください。
Atomic ChatでGGUFモデルを実行する
Atomic Chatは、GGUFをネイティブのモデル形式として使い、ローカルモデルの実行を大幅に簡単にすることを目指しています。
次の作業をユーザーに任せるのではなく、
- Hugging Faceを手動で検索する
- 数十種類の量子化バリエーションを比較する
- 利用可能なメモリにモデルが収まるかを見積もる
Atomic Chatが、その作業の多くを代わりに行います。
このアプリは、互換性のあるGGUFモデルを見つけ、ハードウェアに基づいて量子化を推奨できるため、モデルをダウンロードする前に、Q4_K_Mのようなファイル名を読み解いたり、必要なメモリ量を手計算したりする必要がありません。
もちろん、推論中にメモリを使うのはモデルの重みだけではありません。もう1つの大きな要素がKVキャッシュです。過去のトークンの情報を保存することで、モデルが一貫性のある応答を生成し続けられるようにします。会話が長くなるにつれて、KVキャッシュも大きくなります。
この問題に対応するため、Atomic Chatには追加のメモリ最適化が組み込まれています。その一例が、Google Researchチームが開発したKVキャッシュ圧縮技術のTurboQuantです。モデルの品質を維持しながらKVキャッシュの精度を下げることで、メモリ使用量を抑えつつ、より長いコンテキストウィンドウを利用できます。モデルの重みの精度を恒久的に下げるモデル量子化とは異なり、KVキャッシュ圧縮が影響するのは、推論中に使われる一時的なメモリだけです。この2つの技術は独立しており、併用できます。
その結果、基盤となるGGUFモデルを変えずに、より少ないメモリで長い会話を続けられます。
LLaMA.cpp上のQwen向けMulti-Token Prediction(MTP)!
— atomic.chat (@atomic_chat_hq) 2026年5月14日
性能+40%!採用率90%。MacBook Pro M5 Max 64GBでローカル実行
私たちはLLaMA.cppにパッチを適用し、TurboQuantを使ってQwen 3.6 27Bを量子化してGGUF形式に変換し、さらにMTPのドラフト生成を組み込んでリリースしました。ベンチマーク、ソースコード、モデル👇 pic.twitter.com/TV4O1UOcZk
GGUFとほかのモデル形式の比較
なお、ローカルAIモデルや本番環境のAIモデルで使われる形式は、GGUFだけではありません。形式ごとに、最適化されているワークフローが異なります。
形式によっては、次の点を重視しています。
- 学習とファインチューニング
- GPUでの推論サービング性能
- Apple Silicon向けの最適化
- 幅広いハードウェアとの互換性
適切な形式は、モデルをどこで、どのように実行するかによって変わります。
| 形式 | 適した用途 | 主な利点 | 主な制約 |
|---|---|---|---|
| GGUF | ローカル推論 | CPU、GPU、混在するハードウェアで実行可能 | 通常はGPU特化の形式より遅い |
| Safetensors | 学習とモデル配布 | 安全で効率的なテンソル保存 | ローカル推論に必要なものをすべて含む形式としては設計されていない |
| GPTQ | GPU推論 | 成熟した4ビット量子化のエコシステム | 互換性のあるGPUソフトウェアスタックが必要 |
| AWQ | GPU推論 | 品質と性能のバランスに優れる | 主にGPUを重視 |
| EXL2 | GPU速度の最大化 | VRAMのみを使う非常に高速な推論 | 対応するバックエンドが必要 |
| MLX | Apple Silicon | Macのハードウェアに最適化 | Appleデバイスに限定 |

GGUFとSafetensorsの比較
Safetensorsは、主に学習、ファインチューニング、配布に使われるモデル保存形式です。モデルのテンソルを安全かつ効率的に格納します。ファイルの読み込み時に任意のコードを実行する可能性がある、Pythonのpickleベースの形式に代わるものとして作られました。
一般的なHugging Faceのモデルリポジトリには、次のものが含まれている場合があります。
- モデルの重みを格納したSafetensorsファイル
- アーキテクチャを記述する設定ファイル
- トークナイザーファイル
- 追加のメタデータ
GGUFは、ローカル推論に必要な情報を1つのファイルにまとめ、効率的な量子化済みの重みのサポートを追加します。
一般的なワークフローは次のようになります。
- モデルを学習し、Safetensorsなどの形式を使って公開する。
- モデルをGGUFに変換する。
- GGUF版を量子化し、ローカル推論向けに配布する。
TransformersやvLLMなどのGPUサービングフレームワークでモデルを実行するユーザーは、Safetensorsを直接使うことがよくあります。デスクトップPCやノートPCでモデルをローカル実行するユーザーは、一般にGGUFを使います。
GGUFとGPTQの比較
GPTQは、モデルサイズを縮小するために設計された、初期の学習後量子化手法で、一般に4ビット精度に量子化します。フル精度版では大きすぎる大規模モデルを、一般消費者向けGPUで実行できるようにしたことで普及しました。ただし、GPTQは主にGPU推論を中心に設計されており、通常は利用可能なVRAMにモデルが収まる必要があります。
GGUFは、CPU、GPU、CPUとGPUの混在構成で実行できるため、より柔軟です。GPTQは、データセンターなどのGPUを重視した推論環境では今も有用ですが、一般的なローカル利用では、通常、GGUFのほうが柔軟な選択肢です。
GGUFとAWQの比較
AWQ(Activation-aware Weight Quantization)もGPUを重視した量子化手法で、精度を下げながら重要なモデルの重みを保持するよう設計されています。
古いGPTQのワークフローと比べ、AWQはGPU推論フレームワークで優れた性能と品質の特性を発揮できる場合があります。
主な違いは、重視するハードウェアです。
- AWQは、モデルがVRAMに収まる場合のGPU推論に最適化されています。
- GGUFは、さまざまなハードウェア構成に柔軟に対応できるよう最適化されています。
専用のGPUサーバーでは、AWQが優れた選択肢になる場合があります。ノートPC、デスクトップPC、CPUとGPUの混在システムでは、通常はGGUFのほうが実用的です。
GGUFとEXL2の比較
EXL2は、exllamav2のエコシステムで高性能なGPU推論を行うために設計された量子化形式です。
利点の1つは、小数のビットレートに対応していることです。4.65bpwのようなファイルが可能になり、従来の整数のラベルよりも、メモリと品質のトレードオフを細かく制御できます。
EXL2は、モデル全体がVRAMに収まる場合、極めて高速に動作できます。ただし、GPUのみでの推論を中心に設計されており、特定の対応バックエンドに依存します。
GGUFとMLXの比較
MLXは、Apple Siliconデバイス専用に設計されたAppleの機械学習フレームワークです。MLXモデルは、Appleのユニファイドメモリアーキテクチャとハードウェアアクセラレーションに最適化されているため、Macで優れた性能を発揮できます。
Macユーザーにとっては、モデルやアプリケーションに応じて、MLXもGGUFも有効な選択肢です。両者の性能は、MacでのGGUFとMLXの比較で直接比較しています。
よくある質問
GGUFは何の略ですか?
GGUFという略称には、公式な正式名称がありません。形式の仕様書では、その名前は定義されていません。記録されている由来では、GGUFはGGMLに続くもので、GGMLの名前は作成者のGeorgi Gerganovと、機械学習を意味する「ML」に由来します。
GGUFとGGMLの違いは何ですか?
GGMLは、以前llama.cppで使われていたモデル形式です。テンソルを効率よく格納できましたが、新しいモデルアーキテクチャの多くをサポートするために必要なメタデータシステムがありませんでした。
GGUFは2023年にGGMLに取って代わりました。モデル情報をキーと値のメタデータとして格納する、より拡張性の高い形式で、新しいアーキテクチャとの互換性が向上しました。
GGUFはsafetensorsより優れていますか?
それぞれ用途が異なります。
Safetensorsは、主にモデルの保存、配布、ファインチューニングに使われます。GGUFは、特に量子化モデルを使った、効率的なローカル推論のために設計されています。
最初はSafetensors形式だったモデルが、後からローカル利用向けにGGUFへ変換されることもあります。
どのGGUF量子化を選べばよいですか?
ほとんどのユーザーには、Q4_K_Mが第一候補です。
メモリに余裕があり、より高い品質を求めるなら、Q5_K_MまたはQ6_Kを選んでください。メモリが非常に限られている場合は、古い低ビット形式へ移る前に、サイズの小さいI-quantsを検討してください。
Q4_K_Mは何を意味しますか?
Qは、モデルが量子化された重みを使うことを意味します。4は、約4ビットの精度を示します。Kは、K-quant量子化ファミリーを表します。Mは、中サイズのバリエーションを示します。
数値は、すべての重みの正確なビット数ではなく、おおよその平均精度を表しています。
GGUFはGPUを使えますか?
はい。GGUFは、CPU、GPU、またはその両方を組み合わせて実行できます。
対応するアクセラレーションは、推論エンジンとハードウェアプラットフォームによって異なり、CUDA、Metal、ROCm、Vulkanなどの技術が含まれます。
GGUFの利点の1つは、モデル全体がGPUメモリに収まらなくても、一部の処理をCPUにオフロードすることで実行できる場合が多いことです。
GGUFモデルはどこでダウンロードできますか?
公開GGUFモデルの最大のコレクションは、Hugging Faceで利用できます。明確なモデルカード、量子化情報、推奨ハードウェアを提供している、実績のあるアップロード元を探してください。
よく利用されるGGUFのアップロード元には、bartowski、unsloth、mradermacherがあります。
safetensorsをGGUFに変換できますか?
はい。llama.cppには、convert_hf_to_gguf.pyなどの変換ツールと、その後に使うllama-quantizeなどの量子化ツールが用意されています。
人気のあるモデルのほとんどには、すでにGGUF版があるため、通常、変換が必要になるのは、新しいモデルやあまり一般的でないモデルだけです。
Q8は常にQ4より優れていますか?
Q8はより高い精度を維持しますが、高精度が常に最善の選択とは限りません。
多くのユーザーにとって、Q8で追加で必要になるメモリは、より大きなモデルの実行やコンテキスト長の拡大に使うほうが有益です。高品質な量子化同士の実用上の差は、モデルサイズによる差より小さいことがよくあります。
量子化モデルとは何ですか?
量子化モデルは、元のモデルより低い精度の値を使って重みを格納します。
量子化モデルでは、16ビット精度などの形式を使う代わりに、8、6、5、4ビットの表現を使うことがあります。これにより、品質の低下を一定の範囲に抑えつつ、必要なメモリ量を減らせます。
まとめ
GGUFは、可搬性、量子化のサポート、幅広いハードウェアとの互換性を兼ね備えているため、多くのオープンソース言語モデルをローカルで実行するための標準形式です。重要なポイントは次のとおりです。
- GGUFは、モデルと必要なメタデータを1つのファイルにまとめます。Hugging FaceやほかのローカルLLMハブでモデルを配布する際に、最も普及している形式です。
- 理解の助けになるなら、GGUFは大まかには、モデル向けの.zipファイルや.rarファイルのようなものと考えられます。
- GGUFの主な利点の1つは、量子化を効率よくサポートしていることです。量子化は、モデルの重みを低い精度で格納します。これにより、わずかな品質低下と引き換えにモデルを圧縮し、より少ないRAMやVRAMに収められます。
ローカルの大規模言語モデルを使い始める方法について詳しく知りたい方は、LLMをローカルで実行する方法のガイドをご覧ください。または、お使いのシステムに最適なGGUFモデルを自動で提案し、ワンクリックでインストールできる、私たちのローカルLLMアプリAtomic Chatをダウンロードしてください。




