ローカルAIモデルの提供にOllamaとvLLMのどちらを使うべきか迷っている方に向けて、このガイドでは次の点を解説します。
- この2つのアプリの違い
- Ollamaを選ぶべき場面
- vLLMを選ぶべき場面
- そして、それぞれがどのようなユーザーに向いているか
Ollama vs vLLM:比較早見表
Ollamaは、オフラインAIモデルを提供したい開発者向けの、使いやすいローカルAIアプリです。一方、vLLMは、規模の大小を問わずチームが利用するサーバー向けに設計された推論エンジンです。多数のリクエストを同時に処理する場合、vLLMはOllamaを大きく上回る性能を発揮します。同時リクエスト数が50に達すると、同一のハードウェア上でその差はおよそ6倍になります。
| Ollama | vLLM | |
|---|---|---|
| 概要 | CLI、デスクトップアプリ、REST APIを備えたローカルモデル実行ツール | OpenAI互換APIを通じてモデルを提供するPython推論エンジン |
| 対応OS | macOS、Windows、Linux | 公式対応はLinux。WindowsではWSL2またはDocker経由、macOSではDocker Model Runnerのvllm-metalバックエンド経由で利用可能 |
| モデル形式 | GGUF | FP16/BF16のSafetensorsに加え、FP8、AWQ、GPTQ。GGUFは実験的なプラグイン経由でのみ対応 |
| 同時処理 | モデルごとの並列リクエスト数は設定可能(デフォルトは1件) | 100+ |
| メモリの挙動 | 必要に応じて読み込み、5分間使用されないとメモリから解放 | 起動時にVRAMの約90%を事前に確保し、そのまま保持 |
| マルチGPU | モデルをメモリに収めるため、複数のGPUに分割 | 高速化のためのGPU間のテンソル並列処理、Ray経由のマルチノード処理 |
| 適した用途 | 1人での利用、ノートPC、プロトタイピング、コーディングエージェント | チーム、本番アプリ、バッチ処理パイプライン |
Ollamaとは
Ollamaは、大規模言語モデル(LLM)をローカルで実行するためのオープンソースアプリケーションです。AIモデルのダウンロード、管理、提供を担う統合ランタイムを備え、推論のライフサイクル全体を処理します。
- モデルファイルのダウンロード
- モデルファイルのメモリへの読み込み
- ハードウェアアクセラレーションの設定
- アプリケーションがテキスト、埋め込み、その他のAI出力の生成に利用できるローカルAPIの公開。

Ollamaは使いやすく、簡単に使い始められるように設計されています。たとえば、最適化されたGGUFビルドとしてモデルを配布するライブラリを内蔵しており、ランタイムが利用可能なCPUとGPUのハードウェアを自動的に検出し、適切なモデルを選択して、読み込みを管理します。
OllamaはAPIリクエストに対応できますが、主に単一ユーザーによるローカル推論向けに設計されています。モデルは必要に応じてメモリに読み込まれ、一定期間使用されないとリソース使用量を抑えるために自動的にメモリから解放されるため、Ollamaは次の用途に適しています。
- 個人用AIアシスタント
- ソフトウェア開発
- 実験
- オフラインのワークロード
vLLMとは
vLLMは、大規模言語モデル(LLM)を提供するためのオープンソース推論エンジンです。もともとはUC Berkeleyで開発され、多数のリクエストを同時処理する推論向けに設計されています。つまり、多数のユーザーやアプリケーションが同じモデルに同時に送信するリクエストを処理できます。これを実現するのが、主に次の2つの技術です。
- 連続バッチ処理は、GPUリソースが利用可能になり次第、処理中のバッチに新しいリクエストを追加できるようにする技術です。従来のバッチ処理では、次のバッチを開始する前にバッチ全体の完了を待つ必要があるため、GPUの処理能力を使い切れないことがあります。
- PagedAttentionは、vLLMによるモデルのKVキャッシュ管理を改善する技術です。各会話のキャッシュを1つの大きな連続したメモリ領域に格納するのではなく、より効率的に割り当てられる小さなページに分割します。これによりメモリの無駄が減り、より多くの会話を同時に処理できるようになります。

vLLMは、主にAIモデルを継続的に実行するサーバー向けに構築されています。通常はNVIDIA CUDAまたはAMD ROCmに対応したLinuxシステム上で動作し、GPUメモリの設定や並列処理オプションなど、手動での設定項目が多くなります。
vLLMはモデルをGPUメモリに読み込んだ状態で保持し、多数のリクエストを一度に処理するよう最適化されているため、本番環境のAPI、AIアプリケーション、共有推論サーバーでよく使われます。GPUリソースをほかのタスクと共有するマシンで、気軽にローカル利用する用途にはあまり向いていません。
Ollama vs vLLM:セットアップ
それぞれのツールをインストールし、最初のモデルを動かすまでに必要な手順を見ていきましょう。
インストールと最初のモデルの実行
Ollama
Ollamaは、使いやすいローカルAIエンジンとして設計されています。公式サイトからインストーラーをダウンロードするか、次のコマンドを実行してアプリをインストールします。
curl -fsSL https://ollama.com/install.sh | sh
インストール後は、1つのコマンドでOllamaのモデルライブラリからモデルを直接ダウンロードして実行できます。たとえば、次のように実行します。
ollama run gemma3:12b
モデルがまだインストールされていない場合、Ollamaが自動的にダウンロードしてローカルに保存し、対話形式のチャットセッションを開始します。
vLLM
vLLMの一般的なインストールには、次のものが必要です。
- Linuxシステム。
- Python 3.10以降。
- NVIDIA CUDAまたはAMD ROCmに対応した互換性のあるGPU。
- Python経由でインストールしたvLLMパッケージ:
pip install vllm
インストール後は、次のコマンドでモデルを起動できます。
vllm serve <model>
デフォルトでは、vLLMは高精度(多くの場合FP16)でモデルを読み込みますが、AWQやGPTQなどの量子化形式を使用するよう設定することもできます。
モデル形式:GGUF vs safetensors
モデル形式は、メモリ使用量、互換性、モデルの読み込み方法に影響するため、OllamaとvLLMの最も大きな違いの1つです。
| 比較項目 | Ollama | vLLM |
|---|---|---|
| 主なモデル形式 | GGUF | safetensors(Hugging Face) |
| 一般的な精度 | 量子化済みで、一般的には4ビット | 高精度で、多くの場合FP16 |
| 8Bモデルに必要なメモリ | 約5 GB(4ビットGGUF) | 約16 GB(FP16、重みのみ) |
| 量子化の選択肢 | 量子化済みのGGUFビルド | FP8(新しいNVIDIA GPU)、AWQ、GPTQ |
| GGUF対応 | ネイティブ対応 | vllm-gguf-plugin経由で限定的に対応 |
Ollamaは主にGGUFモデルを使用します。GGUFファイルは通常、モデルの重みを高精度の形式からより少ないビット数に圧縮した量子化形式で配布されます。一般的な選択肢は4ビット量子化で、モデルの実行に必要なメモリを大幅に削減できます。たとえば、一般的な4ビットGGUF形式の8Bパラメータモデルは、必要なVRAMが約5GBで済む場合があり、多くのコンシューマー向けGPUで実行できます。
vLLMは、主にsafetensors形式で保存されたHugging Faceモデルを前提に設計されています。これらのモデルは通常、FP16などのより高い精度で読み込まれます。FP16の8Bパラメータモデルでは、KVキャッシュやランタイムによる追加のオーバーヘッドを考慮する前の、重みだけで約16GBのメモリが必要です。
vLLMは量子化モデルにも対応していますが、より高精度の形式で実行することを想定しています。vLLMのGGUF対応は限定的です。別プロジェクトのvllm-gguf-pluginを通じて対応しており、vLLMが設計の前提としている形式ほど最適化されていません。
モデルの切り替えとVRAMの挙動
Ollama
Ollamaは、同じマシン上でモデルを切り替えることを前提に設計されています。別のモデルを実行すると、Ollamaはそのモデルをメモリに読み込み、使われなくなった非アクティブなモデルを自動的にメモリから解放できます。GPUの空きVRAMが十分にあれば、複数のモデルを同時に読み込んだままにできます。そうでない場合は、必要に応じてモデルの読み込みと解放を行い、メモリを管理します。そのため、AIワークロード、ゲーム、クリエイティブアプリケーション、その他のソフトウェアでGPUを共有する個人用コンピューターで便利に使えます。

vLLM
vLLMは、モデルを長時間稼働するサーバーとして実行することを前提に構築されています。vLLMインスタンスを起動すると、選択したモデルをGPUメモリに読み込み、受信するリクエストに対応できる状態で保持します。モデルを変更するには通常、現在のサーバーを停止し、別のモデルで新しいサーバーを起動して、読み込み処理が再び完了するのを待つ必要があります。起動時間は、モデルのサイズ、ストレージの速度、利用可能なハードウェアによって異なります。
たとえば--gpu-memory-utilizationでメモリ使用量を制限すれば、同じGPU上で複数のvLLMインスタンスを実行できますが、そのためにはモデル間でリソースを手動で配分する必要があります。実際の運用では、vLLMは通常、専用GPU上で1つのモデルを継続的に実行する構成で導入されます。
対応ハードウェアとOS
| Ollama | vLLM | |
|---|---|---|
| オペレーティングシステム | Windows、macOS、Linux | 主にLinux |
| NVIDIA GPU | CUDA経由で対応 | CUDA経由で対応 |
| AMD GPU | ROCm経由で対応 | ROCm経由で対応 |
| Apple Silicon | ネイティブバックエンド経由で対応。新しい構成ではMLXも含む | 限定的な対応。GPUアクセラレーションには追加のツールやコミュニティによるソリューションが必要 |
| CPU推論 | 対応 | 対応しているが、主な用途ではない |
OllamaはNVIDIAとAMDのGPUに加え、Apple Silicon搭載Macにも対応しており、MacではMLXバックエンドがMシリーズチップ向けに最適化された性能を提供します。
一方、vLLMはサーバー向けに構築されているため、対応するコンシューマー向けハードウェアの範囲はかなり限られます。ただし、WindowsではWSL2またはDocker経由で利用できます。
そのため、個人のマシンでモデルを実行する場合、Ollamaのほうがはるかに簡単にセットアップできます。
同時処理
ここでは、両システムが複数のリクエストの同時実行をどのように処理するかを説明します。この話題にはすでに簡単に触れましたが、同時処理の扱いはOllamaとvLLMの最も大きな違いの1つなので、さらに詳しく見ていきましょう。
| Ollama | vLLM | |
|---|---|---|
| リクエストの処理方法 | 限られた数のリクエストを並列処理し、それを超えるリクエストはキューで待機 | 推論中に受信したリクエストを動的にバッチ化 |
| 主な最適化の目的 | ローカル利用をシンプルに保ち、挙動を予測しやすくする | GPU使用率とスループットを最大化する |
| 一般的な用途 | 個人用アシスタント、開発、ローカルでの実験 | API、共有サービス、本番環境の推論 |
Ollama
Ollamaのモデルごとの並列リクエスト数は、OLLAMA_NUM_PARALLELで設定できます。現在の公式FAQでは、デフォルト値は1件です。並列数を増やすには、十分なメモリが必要です。
並列処理数の上限を引き上げると、メモリ使用量も増加します。処理中の各リクエストには専用のKVキャッシュが必要なため、必要なメモリ量は並列リクエスト数とコンテキスト長に応じて増加します。たとえば、32kのコンテキストウィンドウで4件のリクエストを並列処理するには、最大128kトークン分のKVキャッシュ用メモリが必要です。
利用可能な並列処理スロット数を超えたリクエストは、キューに入れられます。キューの上限はデフォルトで512件で、OLLAMA_MAX_QUEUEで変更できます。
複数のユーザーが同じモデルを共有すると、リクエストが利用可能なスロットを取り合うため、待ち時間が長くなります。
vLLM
vLLMは連続バッチ処理を前提に設計されています。固定されたリクエストのバッチが完了するのを待つのではなく、GPUリソースが利用可能になると、新しいリクエストを処理中のバッチに追加できます。これをPagedAttentionと組み合わせることで、多数の会話を同時に処理しながら、メモリをより効率的に管理できます。完了したリクエストはメモリブロックを解放するため、バッチ全体を再構築しなくても、新しいリクエストが空いた領域を利用できます。その結果、GPUが制約要因になるまでは、同時処理数の増加に伴ってスループットが向上します。
これが、vLLMが共有推論サーバーや本番環境のAPIによく使われる一方、Ollamaがよりシンプルなローカルのワークロードに重点を置いている主な理由です。
Ollama vs vLLM:性能ベンチマーク
単一ユーザーでの利用と同時利用の両方について、OllamaとvLLMの性能を比較します。
単一ユーザーでの性能
一度に1件のリクエストを実行する場合、同じモデルと同じ精度を使用していれば、OllamaとvLLMの生成速度は一般的に同程度です。
ただし、Ollamaには多くの場合、利点があります。量子化されたGGUFモデルを前提に構築されていることです。量子化モデルは必要なVRAMが少ないため、より大きなモデルをコンシューマー向けGPUに収められます。たとえば、24GBのRTX 4090では、FP16では収まらない30BクラスのGGUFモデルを数多く実行できますが、同じGPUでもFP16では通常、より小さなモデルに限られます。
複数ユーザーでの性能
複数のユーザーやアプリケーションが同じモデルを共有すると、その差ははるかに顕著になります。
Ollamaは限られた数のリクエストを並列処理し、それを超えるリクエストはリソースが利用可能になるまでキューに入れます。同時処理数が増えると、やがてスループットは頭打ちになり、新しいリクエストがキューで待つ時間が長くなるため、リクエストのレイテンシが増加します。
実環境でのvLLMとOllamaの性能比較として、Red Hatが公開したベンチマークを見てみましょう。このベンチマークでは、1基のNVIDIA A100 40GB GPU上でLlama 3.1 8Bを実行し、同時処理の負荷を増やしながら両ツールを比較しています。
| 指標 | Ollama(デフォルト) | vLLM |
|---|---|---|
| ピークスループット | 41トークン/秒 | 793トークン/秒 |
| P99トークン間レイテンシ | 673 ms | 80 ms |
| 最初のトークンが出力されるまでの時間 | リクエストがキューにたまるにつれて増加 | 比較的安定した状態を維持 |
このOllamaとvLLMのベンチマークは、両者を選ぶ決め手が、単一ユーザーでの純粋な速度ではなく同時処理にある理由を示しています。
OllamaとvLLMを使い分ける場面
適切な選択は、純粋な性能よりも、モデルをどのように使う予定かによって決まります。
次の場合はOllamaを選びましょう。
- 主に自分のコンピューターでモデルを実行する。
- 最小限の設定で、できるだけ簡単にセットアップしたい。
- WindowsまたはmacOSを使用しており、WSL2、Docker、Linuxサーバーよりもネイティブアプリケーションを使いたい。
- 量子化されたGGUFモデルを使って、限られたVRAMでより大きなモデルを実行したい。
- 開発や実験の際に、異なるモデルを頻繁に切り替える。
- GPUをほかのアプリケーションと共有しており、モデルが使用されていないときには自動的にメモリから解放したい。
次の場合はvLLMを選びましょう。
- 同じモデルを複数のユーザーやアプリケーションに同時に提供する必要がある。
- 継続的に稼働するAPI、チャットボット、AIサービスを構築している。
- 同時処理のワークロードでGPU使用率とスループットを最大化したい。
- 評価、合成データ生成、文書処理など、大規模な推論ジョブを実行する。
- AI推論用に確保した1基以上のGPUを搭載する専用のLinuxマシンがある。
OllamaとvLLMに代わる最適な選択肢:Atomic Chat
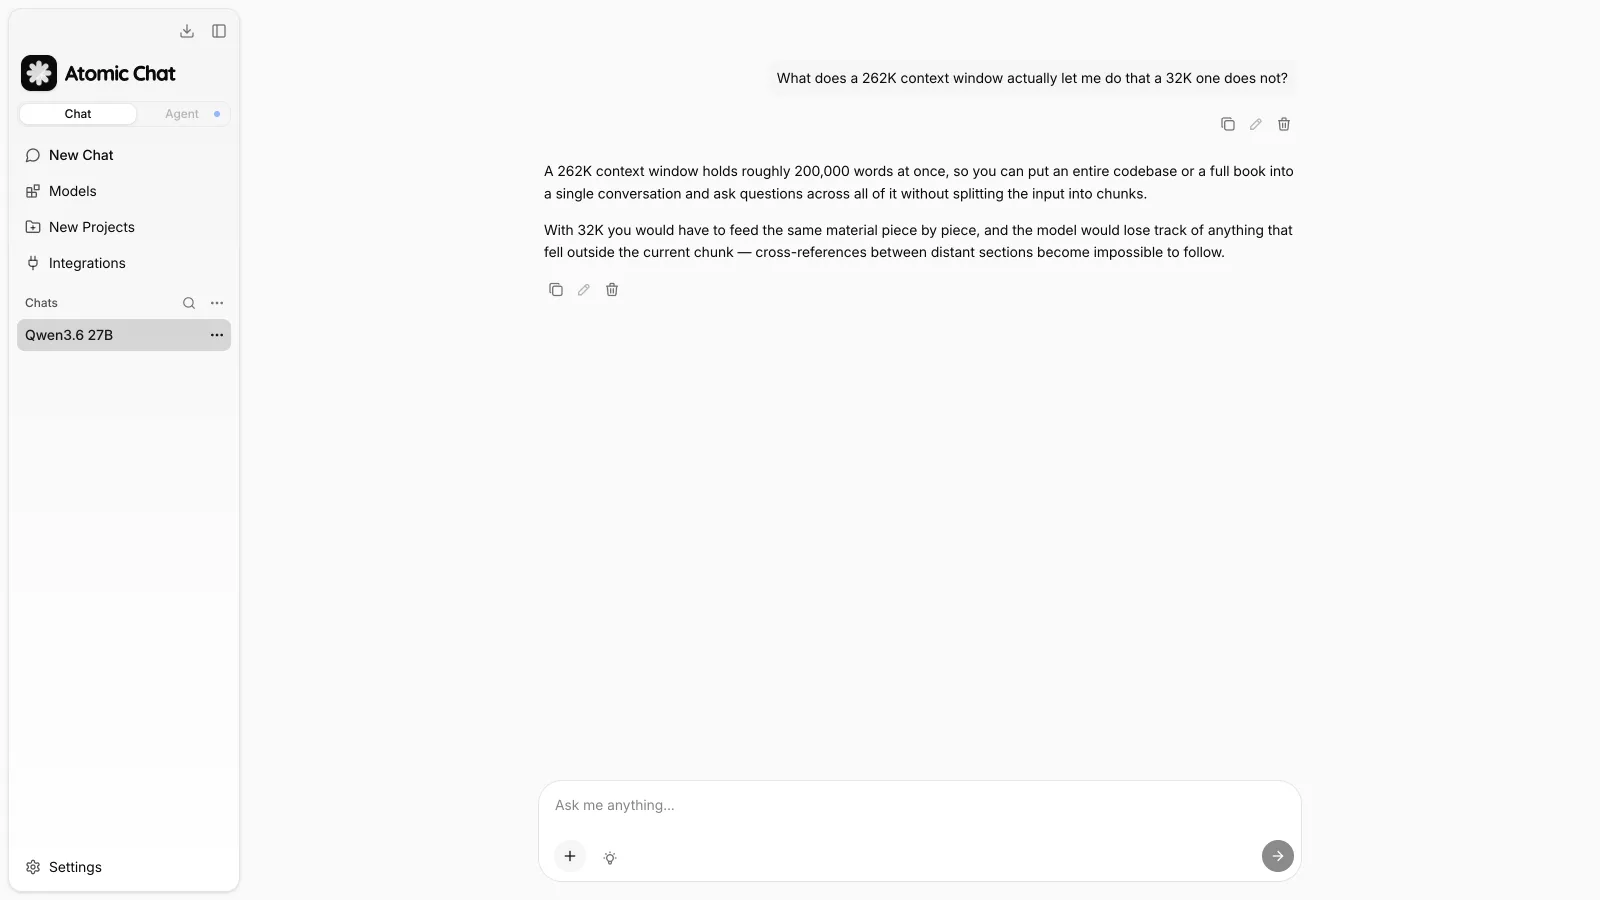
Atomic Chatは、私たちが開発したオープンソースのローカルAIアプリケーションです。ローカルモデルを簡単に実行できるように設計されており、内蔵ブラウザーを使ってHugging Faceから1000以上のモデルをダウンロードして実行し、モデルを簡単に切り替え、内蔵チャットで対話できます。

私たちはAtomic ChatをOllamaと同じように使いやすくするとともに、設計にあたってはvLLMと同様、KVキャッシュの最適化に特に力を入れました。Atomic Chatは、大幅にカスタマイズしたllama.cppエンジンを使用しており、TurboQuantに対応しています。これは、キャッシュの値を16ビットではなくおよそ3ビットで格納し、実行時のキャッシュメモリ使用量を最大6分の1に削減するKVキャッシュ圧縮アルゴリズムです。ローカル推論は主にメモリ帯域幅によって制約されるため、長いチャットでも生成速度は変わらないか、わずかに速くなり、精度は非圧縮のベースラインとまったく同じに保たれます。実際には、Q4_K_Mの34Bモデルは重みに約20 GBを必要としますが、KVキャッシュを圧縮すれば、24 GBのMacBookで実行できます。
私たちは、Android端末とApple端末のどちらでも、スマートフォン上でオフラインAIモデルを実行できるAtomic Chatのモバイルアプリも開発しました。アプリは、iPhone向けにはApp Store、Android向けにはGoogle Playで入手できます。
よくある質問
vLLMはOllamaより速いですか?
1人のユーザーが一度に1件のリクエストを実行する場合、vLLMはOllamaより速いわけではありません。ただし、同時処理のワークロードでは、多数のリクエストを効率的にバッチ化してスケジューリングするよう設計されているため、vLLMのほうが大幅に速くなる場合があります。
個人利用でvLLMを使う価値はありますか?
通常はありません。自分のコンピューターでモデルを実行するなら、一般的にはOllamaのほうがインストール、モデルの切り替え、管理が簡単です。vLLMがより役立つのは、同じモデルを複数のユーザーやアプリケーションに同時に提供する場合です。
vLLMでGGUFモデルを実行できますか?
はい。ただし、現在のGGUF対応はコアランタイムではなく、別プロジェクトのvllm-gguf-pluginを通じて提供されています。vLLMは主に、safetensors形式のHugging Faceモデル向けに設計されています。
vLLMはWindowsで動作しますか?
WindowsユーザーはWSL2またはDocker経由でvLLMを実行できますが、vLLMはWindowsに公式対応していません。vLLMは主にLinuxシステム向けに設計されています。
ローカルAIにはOllamaとvLLMのどちらが適していますか?
個人利用では、vLLMよりOllamaのほうが適しています。単にAIモデルをローカルで実行して作業を自動化したり、モデルとチャットしたりしたい場合、vLLMの性能最適化による恩恵は得られませんが、Ollamaのシンプルさは役立ちます。
Ollamaとllama.cppの違いは何ですか?
llama.cppは低レベルの推論エンジンで、Ollamaはその上に構築されたローカルAIアプリです。Ollamaは、モデル管理、デスクトップGUI、ローカルAPIなどの機能を追加しています。Ollama、vLLM、llama.cppを比較する場合は、llama.cppを基盤となるエンジン、Ollamaをその上に構築された使いやすいアプリ、vLLMをサーバー向けに構築された別のエンジンと考えてください。
まとめ
OllamaとvLLMはどちらもローカルモデルを実行しますが、根本的に異なる目的のために作られています。一方は個人利用向けのローカルAIアプリで、もう一方はサーバーや本番環境への導入向けの高性能な推論エンジンです。主なポイントは次のとおりです。
- Ollamaは、自分のコンピューターでAIモデルを実行するために設計されています。
- vLLMは、多数のユーザーにAIモデルを同時に提供するために設計されています。
- 1人での利用では性能差は小さいものの、同時処理のワークロードでは差が急速に広がります。
- Ollamaは圧縮されたGGUFモデルを実行するよう設計されているのに対し、vLLMは主に非圧縮のsafetensorsを実行するよう設計されています。
また、複数のランタイムを自分で管理せずにローカルモデルを使いたい場合、Atomic Chatなら、さまざまなローカルAIバックエンドを1つのインターフェースで利用できます。セットアップはOllamaと同じくらい簡単で、TurboQuantによる性能向上も得られます。