

要点
ローカルLLMアプリを使う場合、モデルの重み全体を自分のマシンにダウンロードします。モデルはデバイス上でプロンプトを直接処理し、OpenAIなどのクラウドプロバイダーには何も送信しないため、データのプライバシーが完全に保たれます。ローカルLLMアプリはオフラインでも動作するので、飛行機や電車の中、インターネットがまったくない場所など、どこでもLLMをローカルで実行できます。ただし、モデル全体がメモリに読み込まれるため、実行には大量のVRAMを搭載した高性能なGPUが必要です。
- ローカルLLMアプリはデバイス上でAI推論を実行します。モデルファイル全体をディスクにダウンロードし、推論ではローカルのGPUを使って回答を生成します。
- ローカルLLMアプリは無料です。クラウドのサブスクリプションでは、プロバイダーがサーバーの利用料を請求し、料金はトークン数で計算されます。ローカルLLMではモデルを自分で実行するため、誰にも料金を支払いません。
- ローカルLLMアプリは機密性の高い内容を扱う作業に適しています。その仕組み自体がプライバシーを守るからです。
- ローカルLLMアプリは、モデルとやり取りするためのユーザーインターフェースを提供します。たとえばAtomic Chatのようなアプリにはチャットウィンドウがあり、モデルとのやり取り、メモリとコンテキストの管理、モデルのインストールと削除、AI設定の調整ができます。
- ローカルLLMアプリはオープンソースと同義です。ほとんどのローカルLLMアプリがオープンソースソフトウェアであるだけでなく、Hugging Faceなどのプラットフォームから無料でダウンロードできるオープンソースモデルも実行します。
- Atomic Chatは総合的に最もおすすめのローカルLLMアプリです。ワンクリックのセットアップと1,000以上のモデルに加え、標準的なツールよりも少ないメモリで大規模モデルを高速に実行する独自の推論エンジンを備えているからです。
ローカルLLMアプリを使う理由
ローカルLLMアプリケーションでは、OpenAI、Anthropic、Googleにプロンプトを送信することなく、プライバシーを保ちながら自分のマシン上で直接LLMをローカルで実行できます。
ローカルLLMアプリはデータのプライバシーを守ります。クラウドLLMはプロンプトを企業のサーバーに送信し、多くのAI企業は会話を記録してモデルの学習に利用します。一方、ローカルLLMはテキストや文書をどこにも送信せず、デバイスの外に出るデータは0バイトです。
ローカルLLMアプリは無料で使えます。月額サブスクリプションやトークン単位のクラウドAPI料金を支払う必要はありません。かかる費用は電気代だけです。
ローカルLLMアプリは幅広いカスタマイズに対応します。ローカルアプリなら、人気モデルをコミュニティが調整したさまざまなバージョンをダウンロードしたり、自分でモデルをファインチューニングしたり、気に入ったモデルを無期限に使い続けたりできます。プロバイダーによる提供終了や、アップデートに伴う調整内容の変更を心配する必要はありません。コミュニティに愛されたOpus 4.6から、今でも多くの人が後退だと評するOpus 4.7/4.8への移行で見られたような事態です。
ローカルアプリなら、仕事で頼りにしているツールが意図せず変更され、実績のあるワークフローが動かなくなるリスクを回避できます。
ローカルLLMアプリはどのような人に向いていますか?
ローカルLLMアプリは、プライバシーとオフラインでの利用を優先する人、自分でモデルをファインチューニングしたい人、コミュニティがファインチューニングしたモデルを使いたい人に最適です。
- プライバシーを重視するユーザー。医療記録、法的文書、財務情報、非公開のソースコードを日常的に扱う場合、モデルをローカルで実行すれば、そのデータを自分のマシン内にとどめられます。
- 開発者と上級ユーザー。1日に数千回モデルを呼び出すアプリケーションでは、すべてのリクエストをクラウドAPI経由で処理すると高額になることがあります。ローカルモデルなら、リクエストごとの料金がなくなります。
- オフラインLLMを必要とする人。ローカルのオフラインLLMは、飛行機の中、インターネット接続が不安定な地域、クラウドサービスを利用できないエアギャップ環境でも動作し続けます。
- 趣味でAIを使う人やAI愛好家。モデルをローカルで実行すると、モデルの比較、量子化の検証、設定の調整が容易になり、LLMの内部の仕組みをより深く理解できます。
知っておきたい注意点は、ローカルAIアプリは、ベンチマークでGPT-5.5やClaude Opus 4.8に匹敵する最高水準の性能を求め、可能な限り大きなモデルを実行したい人には向かないことです。
量子化を使っても、最先端水準のモデルを一般消費者向けハードウェアで実行することは不可能です。
とはいえ、現在のローカルAIモデルは十分に高性能で、中規模のローカルモデルでも最上位モデルの約85%の性能を得られます。
2026年のおすすめローカルLLMアプリ10選
ローカルAIアプリとは何か、なぜ使いたいと思うのかを確認したところで、2026年のおすすめローカルLLMアプリをランキング形式で紹介します。
1. Atomic Chat:総合的に最もおすすめのローカルLLMアプリ
Atomic Chatは、重みが公開されているモデルを自分のデバイス上で実行し、使いやすいインターフェースでやり取りできる、無料のオープンソースローカルAIアプリです。私たち自身が開発しているアプリでもあるため、その点は最初に明示しておきます。
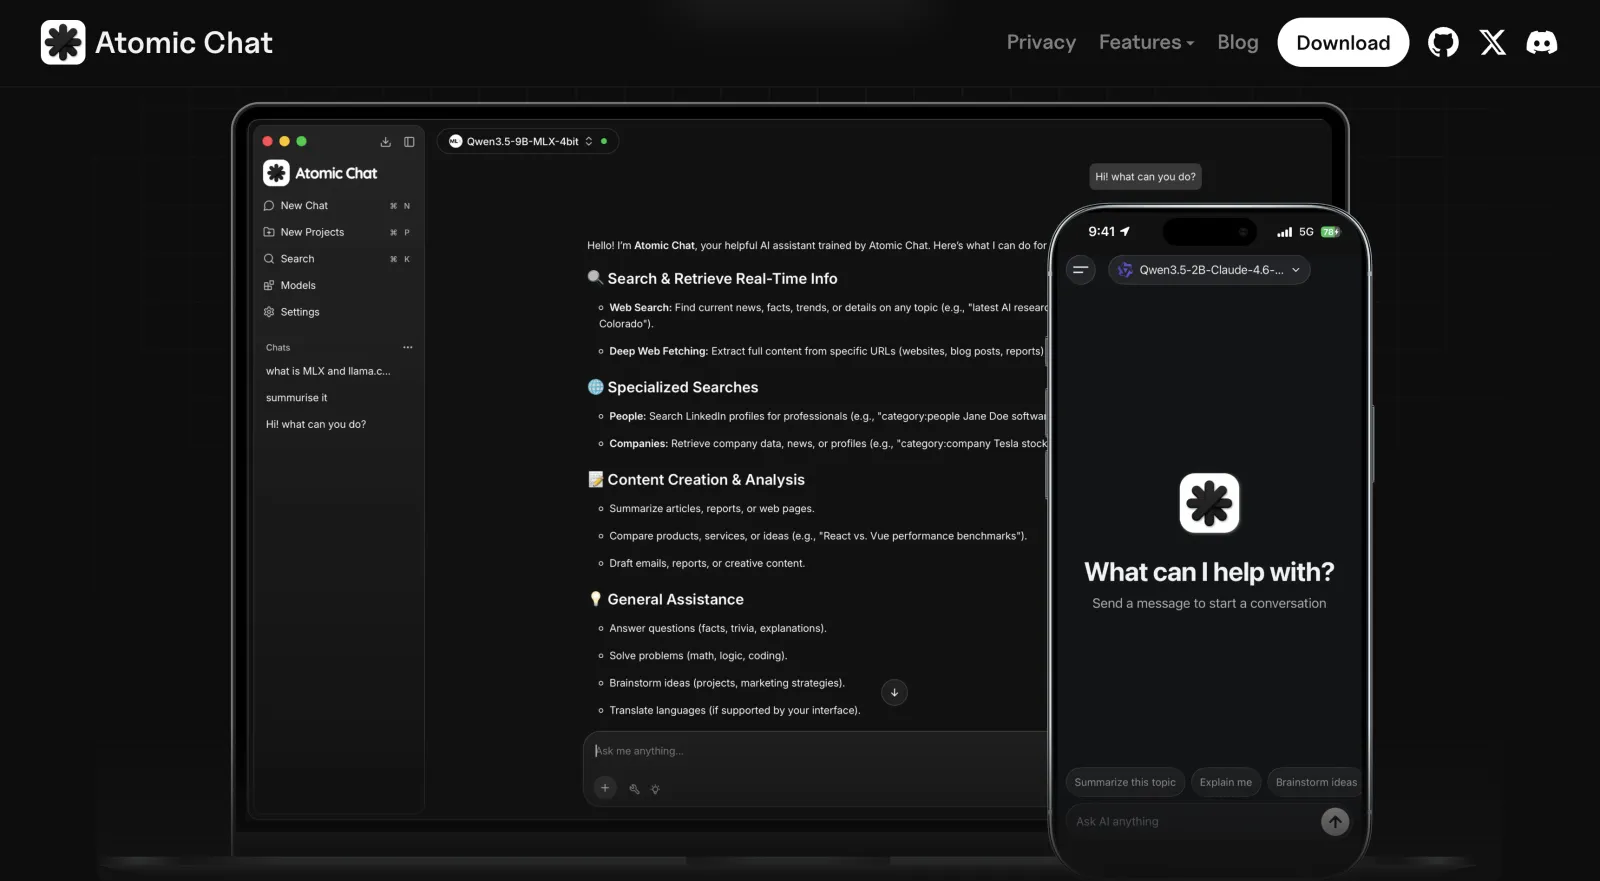
Atomic Chatの開発では、ローカルAIモデルの動作を高速化し、ローカルのハードウェア上での性能を向上させる機能の追加に注力してきました。そのため、Atomic Chatには、次の2つを行うAI圧縮アルゴリズムTurboQuantを独自にフォークしたものを搭載しています。
- 3ビット量子化はモデルの重みを小さくするため、通常なら少なくとも24GBのメモリが必要なモデルを、わずか6GBで実行できます。精度はわずかに低下しますが、量子化した24GBのモデルは、量子化していない6GBのモデルよりもはるかに賢いままです。
- KVキャッシュ圧縮は、全体のメモリ使用量を減らすことで、モデルが利用できるコンテキストウィンドウを大幅に効率よく活用できるようにする一連の技術です。長時間続くタスクでモデルの精度が大幅に向上し、内容を忘れる頻度も減ります。
Atomic Chatには、モデルの推論速度、つまりモデルが出力トークンを生成する速さを向上させる機能が、さらに2つあります。
| 手法 | 仕組み | 高速化の効果 |
|---|---|---|
| Multi-Token Prediction(MTP) | 1ステップで1つではなく複数のトークンを予測 | 30~70%高速化、Gemma 4では最大3倍 |
| DFlash | ブロック拡散デコーディング | Qwen 3.6、Gemma 4、Kimi K2.5で最大6倍高速化 |
上記のすべてを組み合わせることで、メモリ使用量を約6分の1に削減し、モデルの実行で最もメモリを消費するアテンション処理を最大8倍高速化できます。
アプリはRustとTauriで開発し、Apache 2.0ライセンスで公開しました。macOS、Windows、Linux、iPhone、Androidで実行できます。
Apple Siliconでは、Atomic Chatはビジョンモデル向けのMLX-VLMエンジンに切り替えることもでき、このエンジンはMacのNeural Engineで動作します。
Atomic Chatはワンクリックでインストールでき、内蔵のモデルブラウザーを使ってHugging Faceからモデルを取得し、GGUF、MLX、ONNX形式の1,000以上のモデルから好きなものをインストールできます。チャット履歴はメモリとともにセッションをまたいで保持されます。
エージェントを使う作業向けに、http://localhost:1337/v1でOpenAI互換APIサーバーをローカルに公開する機能も用意しています。Claude CodeやCursorなど、任意のIDEプラグインやAI搭載IDEの接続先に指定し、それを通じてローカルモデルを利用できます。
最後に、Atomic ChatはModel Context Protocol(MCP)に完全対応しているため、MCPサーバーを接続して、モデルにファイルアクセス、ウェブ検索、独自のツールを提供できます。Gmail、Slack、Telegram、Figmaなどとの連携機能を標準搭載しています。
最適なユーザー:スマートフォンを含むあらゆるデバイスで、高速かつ完全にプライバシーを保つローカルAIを、最も手軽に使いたい人。
2. LM Studio:初心者に最適なGUI
LM Studioも、ローカルモデルを探し、ダウンロードして実行できるデスクトップアプリです。Mac、Windows、Linuxで利用できます。
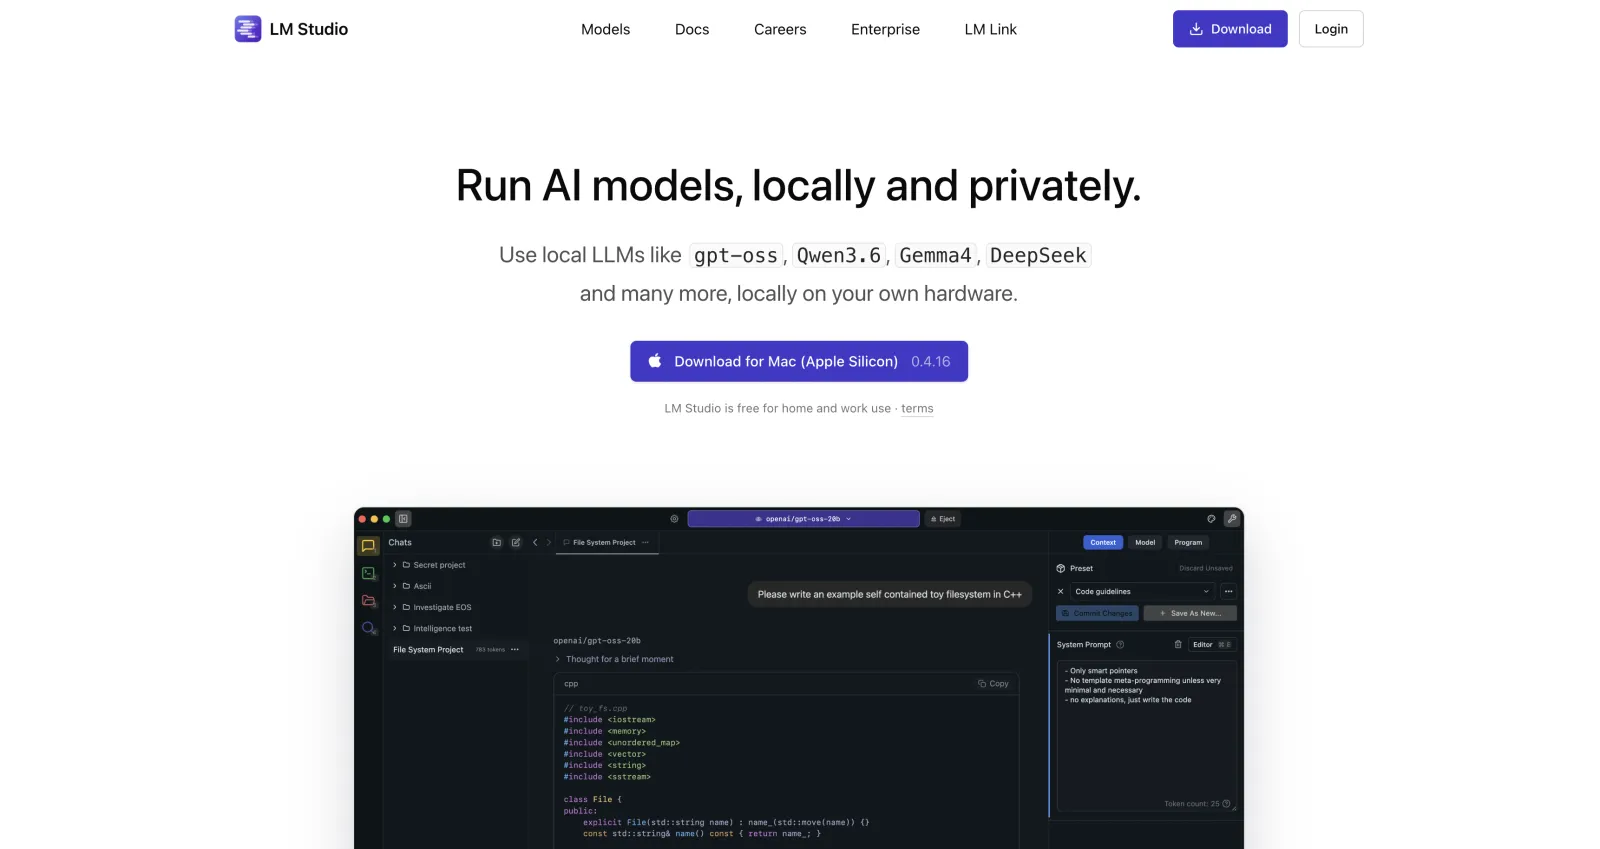
LM Studioは、最もダウンロードされているローカルAIアプリの1つであり、機能が最も充実しているアプリの1つでもあります。
サイズ、形式、量子化で絞り込めるHugging Faceモデルブラウザー、Apple Siliconでの高速推論に向けたネイティブなMLX対応、MCPのツール呼び出し、ポート1234で動作するOpenAI互換サーバーを備えています。
開発者向けには、TypeScriptとPythonのSDKに加え、スクリプトからの操作に使えるlms CLIを提供しています。
注意:Atomic Chatを含む、ここで紹介する多くのアプリとは異なり、LM Studioはクローズドソースです。
また、匿名の利用状況分析がデフォルトで有効になっていることも確認しています。設定でいつでも無効にできますが、完全なプライバシーを保ちたい場合は、この点を覚えておいてください。
最適なユーザー:すっきりした高機能なデスクトップアプリを求め、ソースコードの公開を必要としない初心者。
3. Ollama:CLIワークフローに最適
Ollamaは2026年初頭に月間ダウンロード数が5,200万回を超え、世界で最もダウンロードされているローカルLLMアプリの1つになりました。それでも、私たちがOllamaから連想するのは開発者向けのワークフローです。Ollamaはリリース当初、CLIツールしか提供していませんでしたが、その後GUIも追加されました。
従来の方法、つまりターミナル経由でOllamaを使うには、ollama run llama3.3でモデルを取得します。Ollamaは、ほかのツールが接続できるOpenAI互換APIを提供します。以前は、フロントエンドとしてOpen WebUIと組み合わせることがよくありました。
OllamaはMITライセンスのオープンソースで、Mac、Windows、Linuxで動作します。
では、Ollamaを選ぶ理由は何でしょうか?
- Ollamaは軽量
- コンテナで簡単に実行できる
- サービスとして動作する
- Apple SiliconではMetalによるGPUアクセラレーションを自動的に使用する
- Ollamaサーバーとのやり取りに使える、非常に多くのアプリと連携できる
- テレメトリを一切収集しない
ターミナル中心のワークフローに慣れている開発者には、Ollamaが私たちの第一候補です。
最適なユーザー:開発の基盤となる、スクリプトから操作可能なローカルAPIや、ほかのアプリのバックエンドを求める開発者。
4. Jan:完全オープンソースのローカルLLMアプリとして最適
Janは、モデルをローカルで実行し、必要に応じてクラウドAPIに切り替えられる、ChatGPT風のオープンソースデスクトップアプリです。シンガポールを拠点とするAI研究所Menlo Researchが開発しており、llama.cppエンジンを基盤としています。
GitHubで43,000を超えるスターを獲得している、最も人気のあるローカルAIアプリの1つで、Apache 2.0ライセンスで公開されています。Mac、Windows、Linuxで動作します。
Janの主な機能と、この一覧に選んだ理由は次のとおりです。
- ローカルモデルハブ:Hugging FaceからLlama、Gemma、Qwen、GPT-OSSなどのオープンモデルをダウンロードできます。
- ローカルとクラウドのハイブリッド:同じ会話の中で、ローカルモデルとGPT-5.5などのクラウドモデルを切り替えられます。
- OpenAI互換API:Janはポート1337でローカルサーバーを公開するため、独自のツールからJanのモデルを利用できます。
- MCP対応:Model Context Protocolサーバーを接続し、モデルにツールやエージェント機能を提供できます。
- カスタムアシスタント:独自のシステムプロンプトやペルソナを保存できます。
注意:Janは標準のllama.cppエンジンを使用しており、たとえばAtomic Chatが備える高度な圧縮やデコーディングの最適化がないため、同じハードウェアで同じモデルを動かすと、動作は遅くなります。
最適なユーザー:チャットをローカルに保存し、テレメトリのない完全にオープンなアプリを求める、プライバシーを徹底して重視する人。
5. GPT4All:文書を使ったチャットに最適
GPT4AllはNomic AIが開発した、最も歴史が長く、スター数も多いローカルAIアプリの1つで、GitHubで77,000以上のスターを獲得しています。GPT4AllにはMac、Windows、Linux向けのアプリがあります。
GPT4Allの特徴はLocalDocs機能です。これはPDF、Wordファイル、テキスト文書をインデックス化し、それらについて質問できる内蔵RAGパイプラインです。ベクトルデータベースと同じ役割を果たすため、実際のベクトルデータベースを設定することなく、ローカルAIを「第2の脳」として使えます。
GPT4AllはGPUアクセラレーションにVulkanバックエンドを使用しており、幅広いNVIDIAおよびAMDのグラフィックスカードで動作します。
最適なユーザー:主に自分の文書についてオフラインでチャットしたい、技術に詳しくないユーザー。
6. AnythingLLM:RAGに最適
AnythingLLMは、Mintplex Labsが開発した、文書チャットとエージェントを中心とするオールインワンのローカルAIアプリケーションです。LLMエンジン、CPUで動作する埋め込みモデル、LanceDBベクトルストアを備え、文書をインデックス化して、その文書についてチャットできるようにします。
AnythingLLMのワークフローは、次のような機能を通じて、ローカルのナレッジベース構築に最適化されています。
- Workspaces:それぞれ独自の文書セットを保持し、プロジェクトを分離します。
- 30以上のモデルプロバイダー:あるワークスペースでは非公開ファイル用にローカルモデルを実行し、別のワークスペースではクラウドAPIを接続先に指定できます。
- 内蔵AIエージェント:ツールを使用できます。
- 幅広いベクトルDBへの対応:デフォルトのLanceDBに加え、Pinecone、Qdrant、Weaviateなどに対応します。
デスクトップアプリは完全に無料で、ローカルモデルも無料で実行できます。クラウドホスティングは月額$50からの有料アドオンですが、利用は完全に任意です。
最適なユーザー:自分の文書にRAGとエージェントを活用し、ローカルのナレッジベースを構築したい人。
7. Msty:モデルを並べて比較する用途に最適
Mstyは、CloudStack, LLCが開発した、ローカル利用を優先するデスクトップアプリです。Mac、Windows、Linuxで動作し、無期限の無料プランがあります。
Split Chatsという機能で知られており、同じプロンプトを複数のモデルに一度に送り、回答を並べて読んで比較できます。
Mstyのそれ以外のチャットUXは、かなり標準的です。会話の分岐、会話フォルダー、プロンプトライブラリ、Knowledge Stacksを備えています。Mstyはテレメトリを一切収集せず、ローカルを優先してデータを保存します。
アプリは無料で使えます。Mstyには有料のAurumプランがあり、料金は1ユーザーあたり年額$149、または買い切り$349で、上級ユーザーやチーム向けの追加機能を利用できますが、アプリを使うために加入する必要はありません。
最適なユーザー:ここで紹介する中で最も洗練されたチャットワークフローを使い、同じプロンプトで複数のモデルを比較したい人。
8. Cherry Studio:多数のプロバイダーを1つのウィンドウで使う用途に最適
Cherry Studioは、ローカルモデルとクラウドモデルの両方と1か所でチャットできる、オープンソースのAIワークスペースです。GitHubで47,000以上のスターを獲得している、かなり人気のあるプロジェクトです。Windows、macOS、Linux版があります。
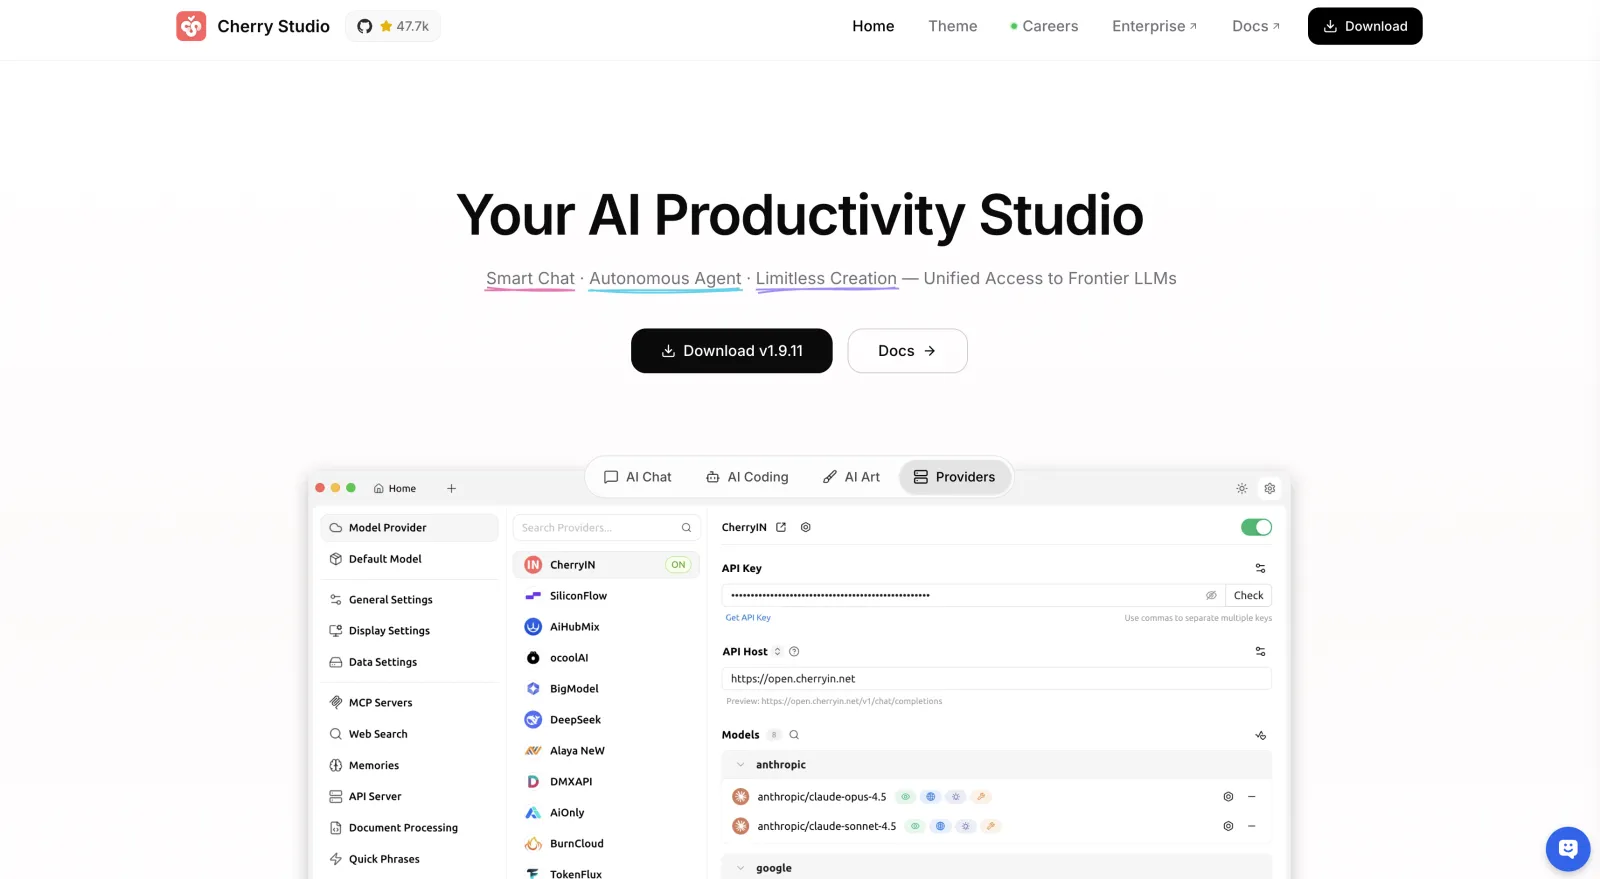
Cherry Studioは、300以上のAIアシスタントを収めたライブラリを内蔵しています。また、次の機能も備えています。
- PDF、Officeファイル、画像を対象とする文書RAG
- ツールとエージェントのためのMCPサーバーの連携制御
- 音声入力と画像生成
- Mermaidによる図、コードのハイライト表示、AI翻訳
デスクトップアプリは、個人でもチームでも無料で使えます。支払いが必要なのはクラウドプロバイダーの利用料だけで、その利用は任意です。
最適なユーザー:多数のローカルプロバイダーとクラウドプロバイダーを切り替えて使い、1か所にまとめたい人。
9. Open WebUI:セルフホスト型ウェブインターフェースとして最適
Open WebUIは、GitHubで143,000以上のスターを獲得している、最も人気のあるローカルAIアプリです。注意点として、ほかのアプリとは異なり、セルフホスト型でブラウザーから利用するフロントエンドです。
つまり、モデルを実行するには別のアプリが必要です。たとえばAtomic ChatをWebUIの接続先に指定すると、ChatGPTのようにブラウザーで開ける、すっきりしたマルチユーザー対応のチャットインターフェースを利用できます。
最も特徴的なのはマルチユーザー機能で、開発チームやホームラボなど、同じネットワーク上の複数の人に同じモデルを提供できます。
ただし、Atomic Chatのようなインストーラー形式のアプリよりも、セットアップが少し難しい点には注意してください。Open WebUIはDockerで動作し、バックエンドがすでに用意されていることを前提としています。
最適なユーザー:チームや家族で共有するローカルAIをセルフホストし、ブラウザー経由で利用したい人。
10. BoltAI:ネイティブMacクライアントとして最適
BoltAIは、Daniel Nguyenという1人の開発者が開発・運営している、ネイティブのmacOSクライアントです。WebUIと同様に、それ自体ではモデルを実行せず、クラウドAPIやAtomic Chat、Ollama、LM Studioなどのローカルバックエンドに接続するフロントエンドです。
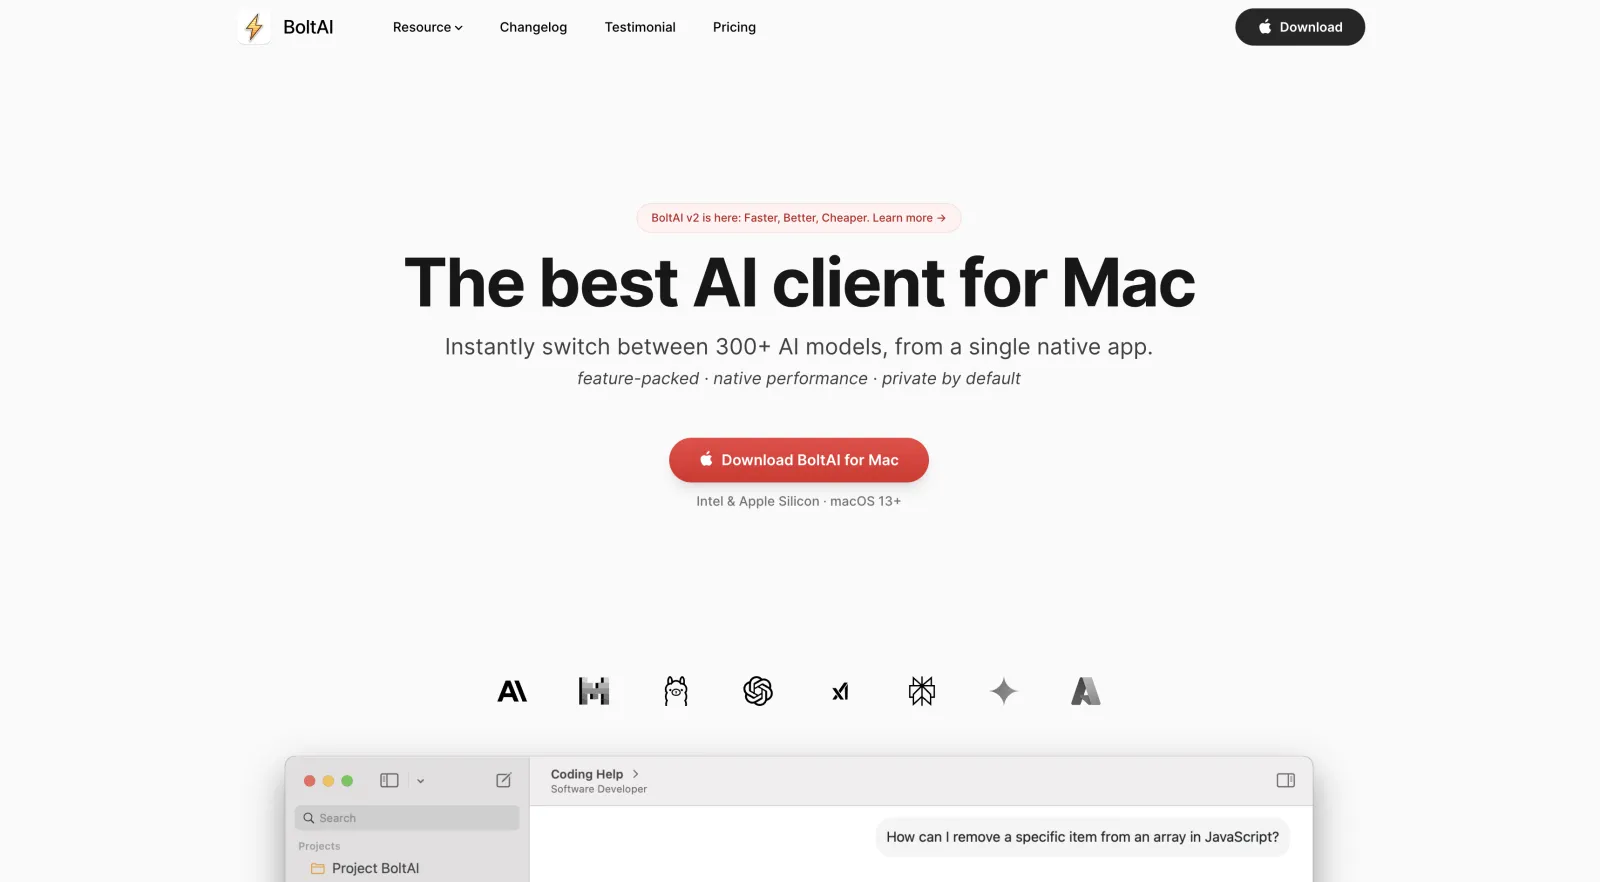
AI Command paletteという機能で知られており、どのアプリでもホットキーから数十種類のコマンドを呼び出せます。たとえば、テキストを選択してホットキーを押すと、AIが書き直しや校正を行い、同じ書式のまま元の場所に貼り付けます。非常に手間の少ないAIワークフローです。
Mac専用で、買い切りの永久ライセンスを購入する必要があります。Mac 1台あたり$79または$99で、1年間のアップデートが含まれます。
最適なユーザー:システム全体でAIコマンドを使える、高速なネイティブクライアントを求めるMacユーザー。
アプリで実行するモデルの選び方
アプリ選びは全体の半分にすぎません。もう半分は、どのローカルLLMモデルを読み込むかであり、それはハードウェアによって決まります。自分のマシンに最適なローカルLLMモデルを選び、それぞれに必要なRAM容量を確認するには、Atomic Chatの16GBのMacに最適なローカルLLM、Macで高速に動作するモデル、GGUF形式とMLX形式の比較に関するガイドをご覧ください。
ローカルLLMアプリの比較
これらのアプリはおおむね同じモデルを実行するため、重要な違いはインターフェース、対応プラットフォームの幅、オープン性、ツールを使えるかどうかです。10アプリを比較すると、次のようになります。
| アプリ | インターフェース | 対応プラットフォーム | オープンソース | モバイル | MCPツール | 料金 |
|---|---|---|---|---|---|---|
| Atomic Chat | GUI | Mac、Windows、Linux、iOS、Android | はい | はい | はい | 無料 |
| LM Studio | GUI | Mac、Windows、Linux | いいえ | いいえ | はい | 無料 |
| Ollama | CLI | Mac、Windows、Linux | はい | いいえ | いいえ | 無料 |
| Jan | GUI | Mac、Windows、Linux | はい | いいえ | はい | 無料 |
| GPT4All | GUI | Mac、Windows、Linux | はい | いいえ | いいえ | 無料 |
| AnythingLLM | GUI | Mac、Windows、Linux | はい | いいえ | はい | 無料 |
| Msty | GUI | Mac、Windows、Linux | いいえ | いいえ | はい | 無料 |
| Cherry Studio | GUI | Mac、Windows、Linux | はい | いいえ | はい | 無料 |
| Open WebUI | ウェブ | セルフホスト | はい | いいえ | はい | 無料 |
| BoltAI | GUI | Mac | いいえ | いいえ | いいえ | 買い切り$79から |
自分に合うローカルLLMアプリの選び方
あまり悩まずにローカルで実行するのに最適なLLMを使いたいなら、Atomic Chatから始めてください。無料かつオープンソースで、デスクトップとモバイルの各プラットフォームに対応し、必要なハードウェアに対して高い性能を発揮します。ニーズが変われば、後からいつでも乗り換えられます。アプリを選んだら、次はモデル選びです。おすすめについては、上でリンクしたローカルLLMモデルのガイドをご覧ください。
Atomic Chatが合わない場合は、次の簡単な判断フローを参考にしてください。
ターミナルでの作業を好む開発者は、Ollamaをバックエンドとして使うことがよくありますが、多くのユーザーにはグラフィカルなインターフェースのほうが適しています。
プライバシーも選択に影響することがあります。テレメトリのないオープンソースアプリケーションは、独立した監査が可能です。一方、クローズドソースのものや、デフォルトで利用状況の分析データを収集するものもあります。どちらかが本質的に優れているわけではありませんが、透明性を優先するなら、この違いが重要になる場合があります。
より具体的なおすすめについては、上の各アプリのレビューをご覧ください。最も幅広いデバイスに対応し、ほとんどの人に適した選択肢を1つ探しているなら、Atomic Chatが引き続き最もおすすめしやすいアプリです。
よくある質問
ローカルLLMアプリに関するよくある質問に答えます。
ローカルLLMアプリは無料ですか?
ほぼすべて無料です。この記事で紹介したアプリは、$79からの買い切りであるBoltAIを除き、すべて無料でダウンロードでき、実行するモデルも無料でダウンロードできる重み公開モデルです。MstyのAurumやAnythingLLMのクラウドホスティングなど、任意の有料プランを販売するアプリもありますが、ローカルのデスクトップ版は無料で、モデルを自分のハードウェアで実行するため、トークン数の制限もありません。
LLMをローカルで実行するにはGPUが必要ですか?
いいえ。十分なRAMがあれば、最近のCPUでLLMをローカル実行できます。小規模から中規模のモデルは問題なく動作しますが、GPUよりは遅くなります。より大きな制約はメモリです。7~8Bのモデルにはおよそ8GBの空きRAMが必要で、より大きなモデルにはさらに多くのメモリが必要です。Apple SiliconはユニファイドメモリがVRAMを兼ねるため、ちょうどよい選択肢です。36GBを搭載したM3 Pro MacBookなら、はるかに大きなLlama 3.3 70Bを毎秒約15トークンで実行できます。Atomic ChatのTurboQuantのようなエンジンは、モデルを圧縮することで必要なメモリ容量をさらに引き下げます。
ローカルLLMは安全で、プライバシーも守られますか?
モデルのローカル実行は、ソフトウェアとしてこれ以上ないほどプライバシーを守れる方法です。会話がマシンの外に出ることはないため、クラウドプロバイダーが記録したり、学習に使ったりするものがありません。確認すべき点はアプリ自体です。Atomic Chat、Jan、Ollamaのような、テレメトリのないオープンソースアプリは監査できますが、一部のアプリはデフォルトで匿名の分析データを送信しており、これは無効にできます。モデルの回答が間違っている可能性はあるため、AIの出力に対する通常の注意は必要です。
iPhoneに最適なローカルLLMアプリは何ですか?
Atomic Chatは、機能を削ったモバイル版ではなく、デスクトップ版と同じくプライバシーを保ちながらオフラインで動作する完全なローカルAIアプリなので、iPhoneで動作する選択肢の中で最も高機能です。スマートフォンでは小さなモデルを実行することになります。6~8GBのiPhoneなら、Phi-4 Miniのような3Bクラスのモデルを快適に扱えますが、モデルをダウンロードした後は完全にオフラインで動作します。
ローカルLLMはChatGPTの代わりになりますか?
プライバシーを重視する用途、オフラインでの利用、大量の処理には、代わりになります。優れたローカルモデルなら、クラウドに何も送信せずに、日常的な文章作成、要約、コーディング支援をこなせます。最も難しい推論や最大規模のコンテキストウィンドウでは、GPT-5.5やClaude Opus 4.8のような最先端のクラウドモデルが、今でもノートパソコンで実行できるモデルを上回っています。機密性の高い内容にはローカルアプリ、それ以外にはクラウドモデルというように、両方を使う人も多くいます。
コーディングに最適なローカルLLMは何ですか?
各アプリで同じコーディングモデルを実行できるため、アプリよりもハードウェアによって決まります。2026年に際立っているのはQwen3-CoderとKimi K2.5です。どのモデルをどのように実行すべきかを詳しく知るには、Atomic Chatのコーディングに最適なローカルLLMのガイドをご覧ください。
2026年に使える、おすすめのローカルLLMアプリは何ですか?
2026年のおすすめローカルLLMアプリはAtomic Chat、LM Studio、Ollama、Jan、GPT4Allで、私たちの第一候補はAtomic Chatです。いずれも無料でLLMをローカルで実行でき、どれが適しているかは、シンプルなGUI、開発者向けバックエンド、文書チャットのどれを求めるかによって決まります。
まとめ
ローカルAIアプリを1つだけ選ぶなら、私たちが2026年で最も優れたローカルLLMアプリだと考えるAtomic Chatから始めてください。
無料でオープンソース、インストールも簡単です。さらにTurboQuantエンジンを搭載しているため、通常なら手持ちのハードウェアでは実行できない、より大きく高性能なモデルを実行できます。




