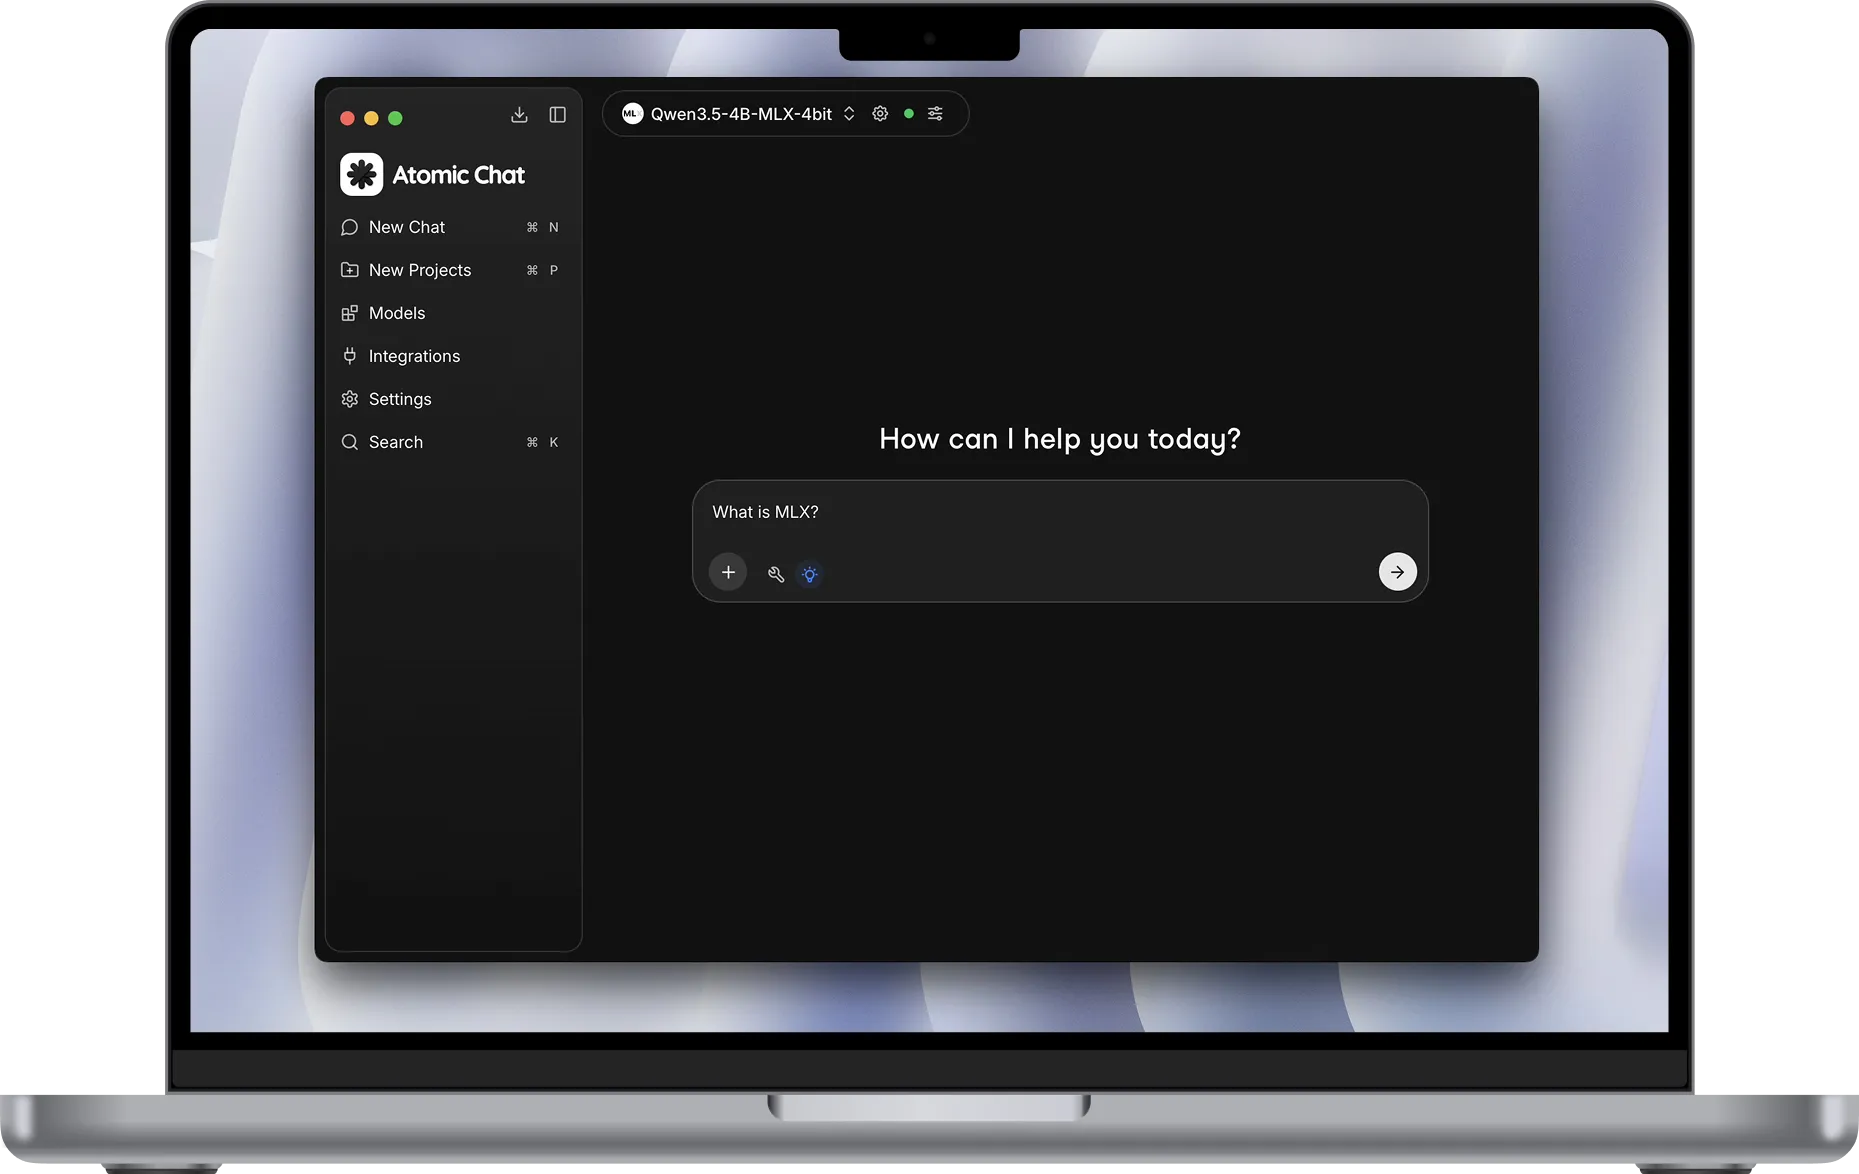


MacでローカルLLMを動かすのに必要なもの
いちばん速いのはApple Siliconで、どれだけ大きなモデルが載るかはメモリが決めます。16GBのM1チップでも、8Bモデルが人の読む速さで動きます。
MacでLLMを動かす手順
3ステップ、およそ10分。そのほとんどはモデルのダウンロード時間です。
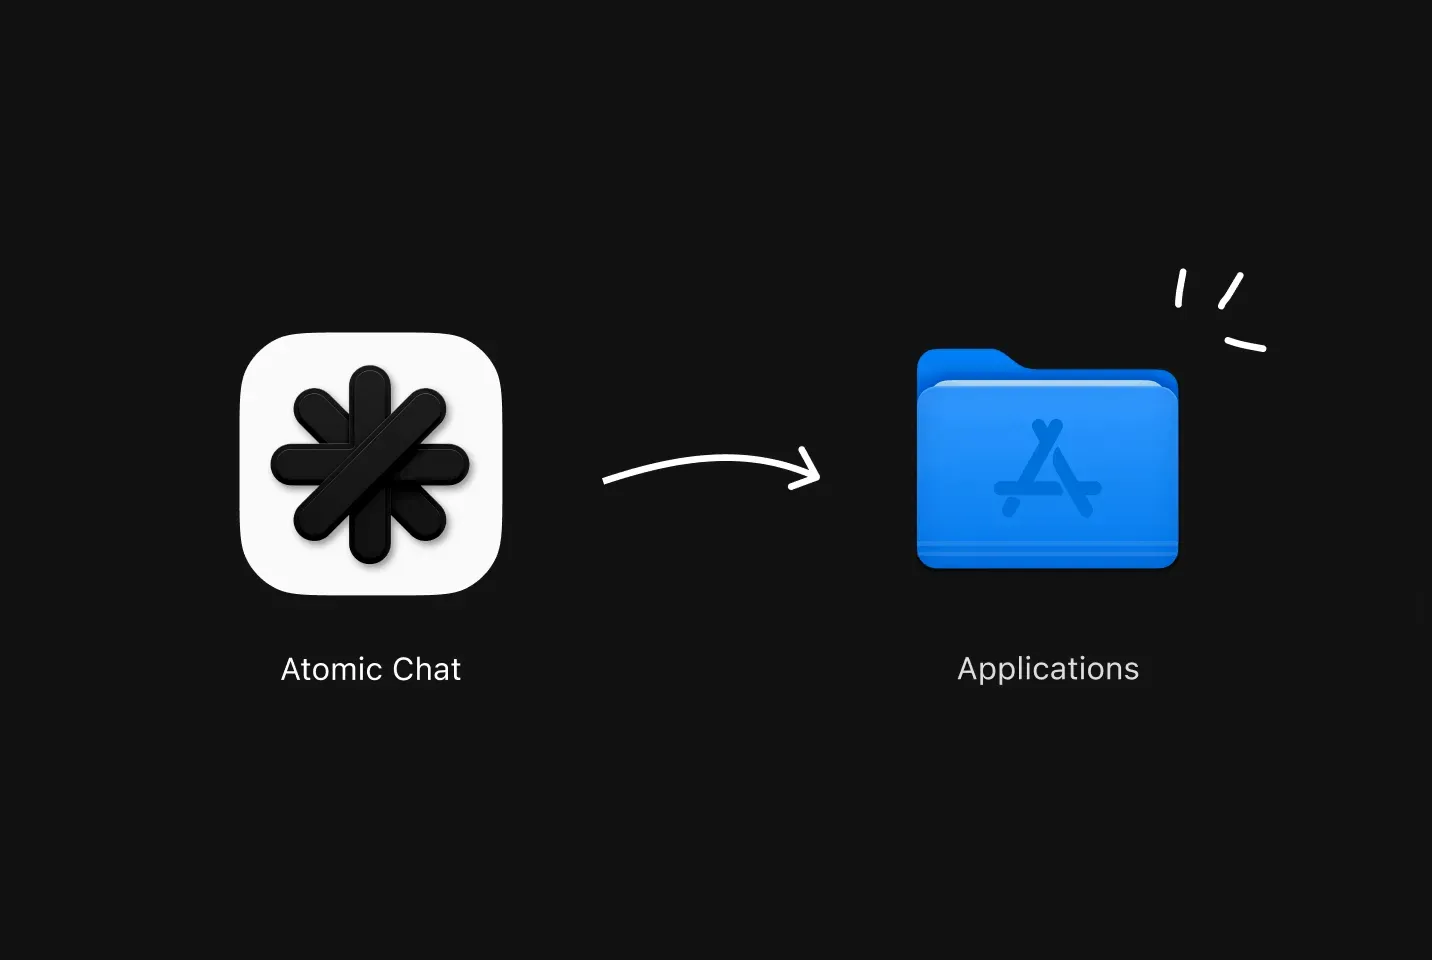
アプリをダウンロード
ユニバーサルインストーラ1つで、macOS 13.6以降のIntel MacとApple Silicon Macに対応します。Atomic Chatをアプリケーションフォルダにドラッグして開くだけです。
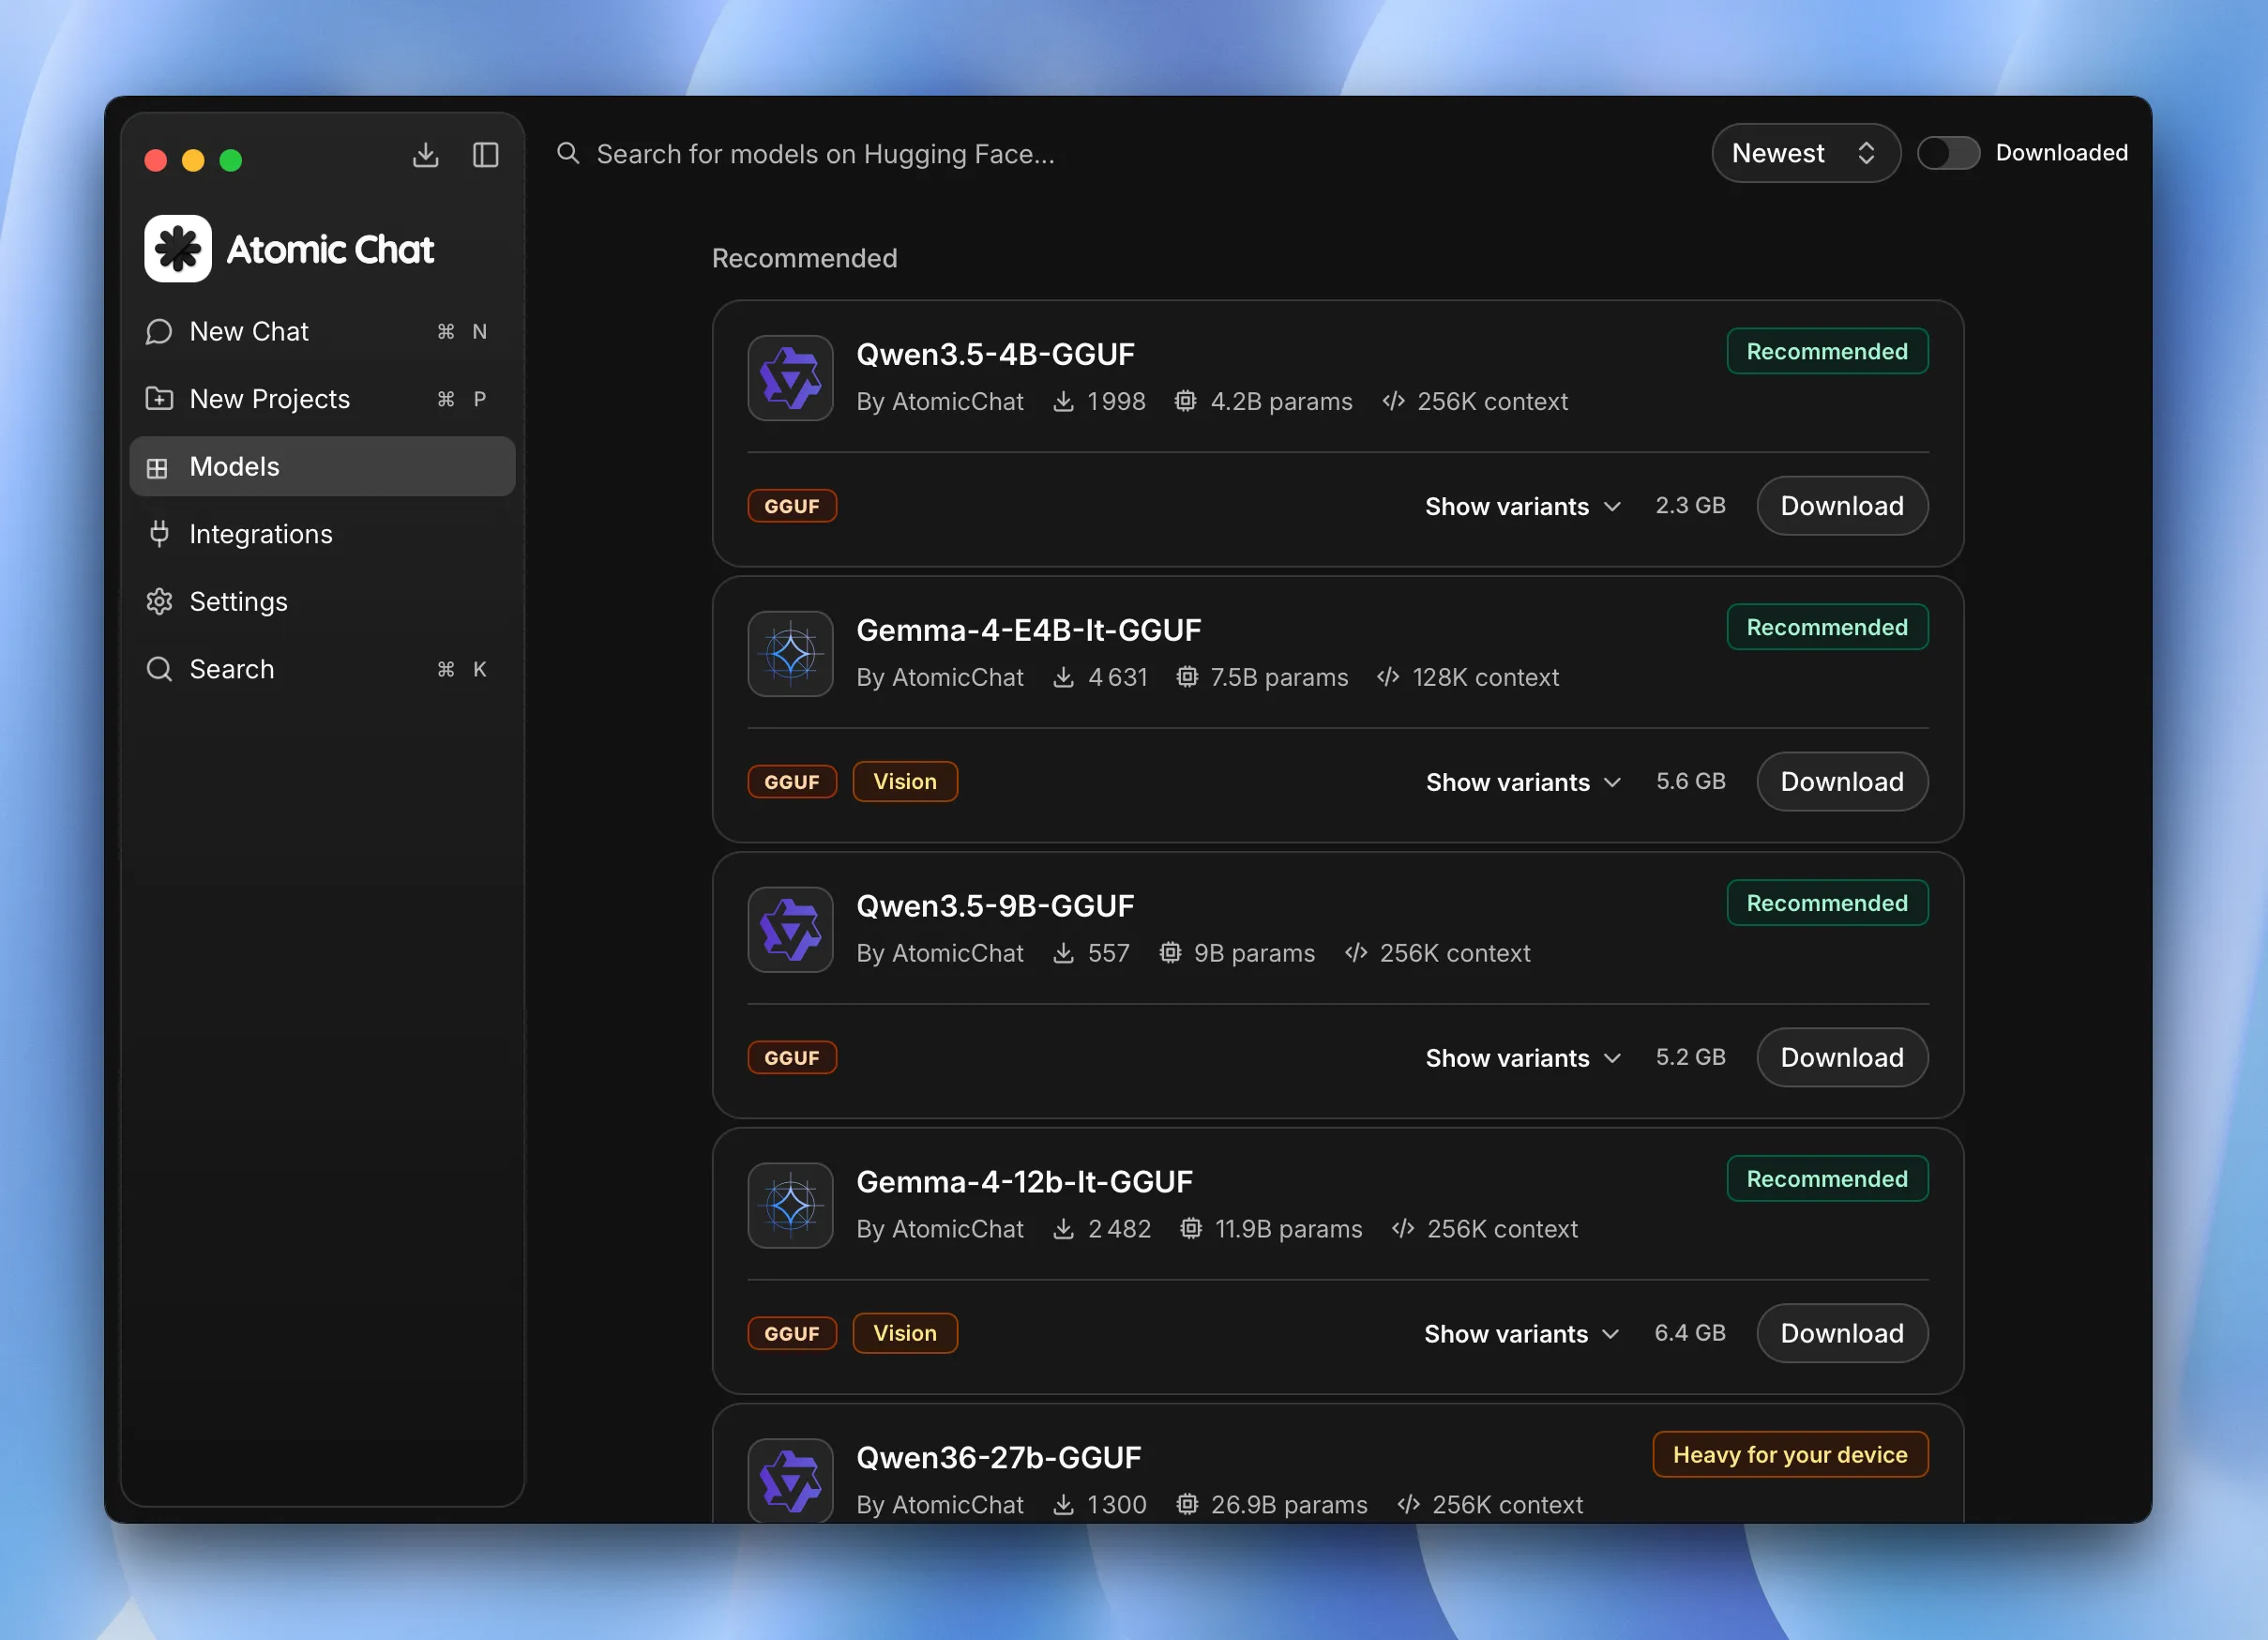
モデルを選択
1,000以上のオープンモデルを見て、メモリに収まるものを選びます。ダウンロードは1クリックです。
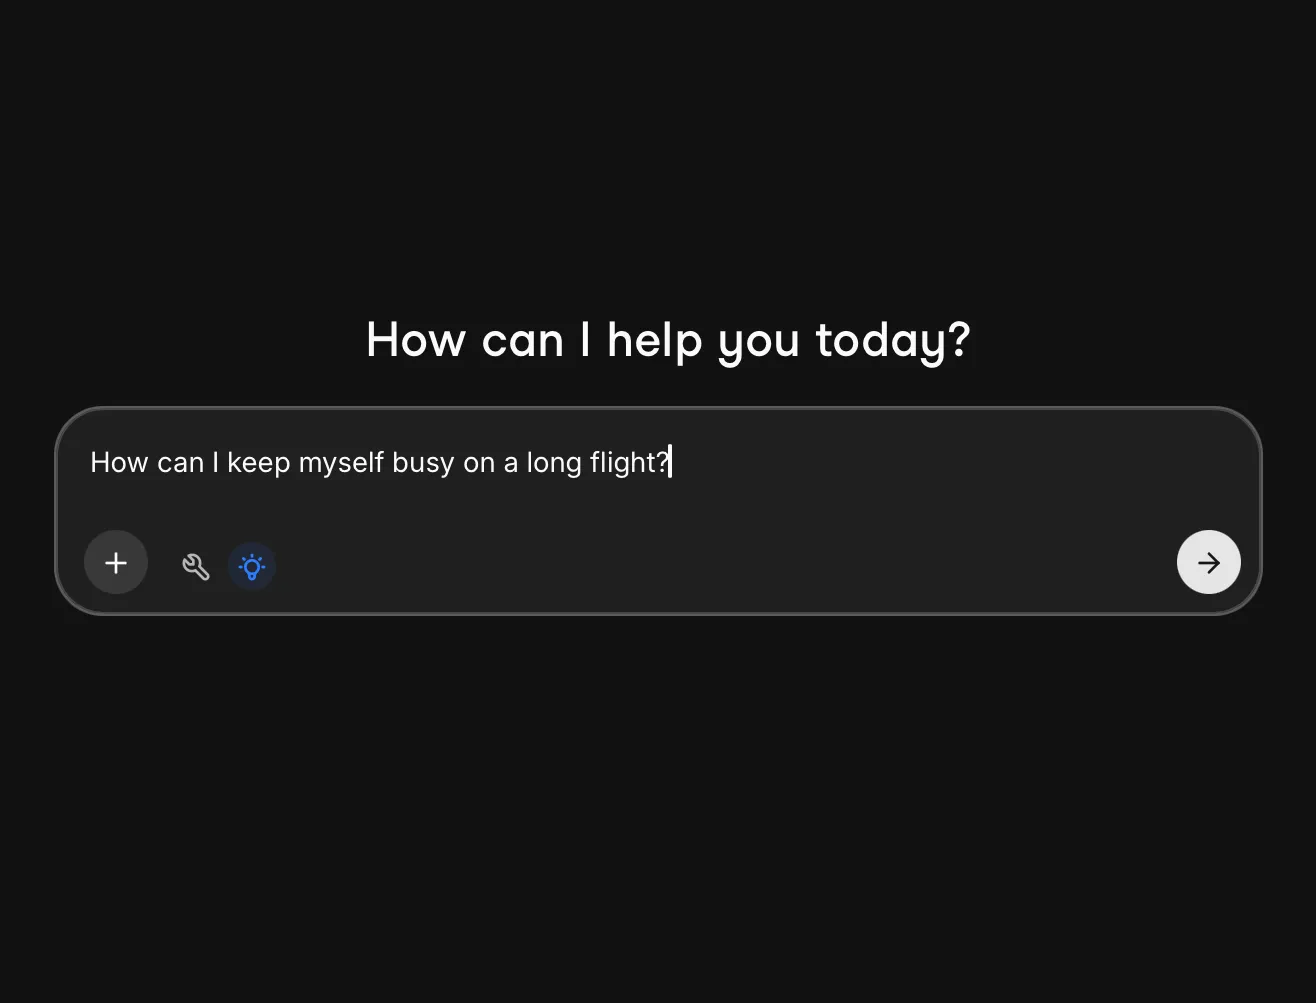
チャットを開始
モデルは自分のMac上で動きます。オフラインでも使えて、質問の回数に上限はありません。
MLXベースで動作
MLXはAppleの機械学習フレームワークで、Mシリーズチップのユニファイドメモリ向けに作られています。CPU、GPU、Neural Engineが同じメモリを読むため、プロセッサと独立したグラフィックスカードの間でデータをやり取りする必要がありません。
Apple SiliconでのTurboQuantの仕組み
TurboQuantは、収まるコンテキストの量そのものを変えます。RAMを足さずにコンテキストウィンドウを広げられます。
メモリを食うのはコンテキスト
キャッシュはメッセージのたびに大きくなり、会話が長くなるとモデル本体より大きくなることもあります。
ステップ1
そのキャッシュを圧縮
Atomic Chatのビルドでは、そのキャッシュを通常の16ビットではなく3ビットか4ビットで保持します。サイズは最大4.3分の1になります。
ステップ2
Macで何が変わるか
メモリが尽きるまでに交わせる会話が長くなり、モデルを動かしながらXcodeやChromeを開いたままにできます。
ステップ3
Atomic Chat vs ローカルLLMツール
この中で5つのプラットフォームすべてで動かせるのはAtomic Chatだけです。
OS


macOS
Google Play
よくある質問
MacでローカルLLMを動かす前によく聞かれる質問です。
はい。MシリーズのAirなら8GBで7Bや8Bのモデルを扱えますし、16GBのAirは14Bでも余裕があります。ファンレスなので、長い生成では本体が温まって少し遅くなりますが、問題なく動きます。
4ビットなら、8Bモデルでおよそ8GB、14Bで16GB、32Bで32GB、70Bで64GB以上が目安です。ユニファイドメモリはmacOS全体と共有されるので、ほかに開いているものの分も余裕を残してください。
純粋な速度では勝てません。1秒あたりのトークン数では専用のNVIDIAカードが上です。Apple Siliconが勝るのは容量で、ユニファイドメモリのおかげで64GBのMacは、そもそも収めるだけでも非常に高価なGPUが必要なモデルを読み込めます。
はい。Atomic Chatは、macOS 13.6以降のIntel MacとApple Silicon Macに対応しています。
はい。契約書や銀行の明細、表計算ファイルを放り込んで質問できます。読み込みも分析もMac上で行われるため、ファイルがアップロードされたり記録されたりすることはありません。
Macでのコードなら、Qwen 3.5とDeepSeekの蒸留モデルに落ち着く人がほとんどです。どちらも関数の説明、バグ探し、社外秘コードのリファクタリングを、何もマシンの外に出さずにこなします。NDAでクラウドが使えない場面では、そこがいちばん重要です。
はい。macOSにはOpenAI互換のローカルエンドポイントがあります。Kilo CodeやCline、OpenAI SDKをそこに向けるだけで、APIキーもトークン単位の課金も不要です。
いいえ。ほかのMacアプリと同じく.dmgからインストールします。アプリケーションフォルダにドラッグして開くだけです。コマンドラインの操作もパッケージマネージャも、作成するアカウントもありません。
完全にプライベートです。サーバーには何も送信されず、アカウントも不要で、クラウドに記録も残りません。チャットは自分のディスクの中にあります。
小さいモデルなら動きます。Atomic ChatはApp StoreとGoogle Playにあるので、コンパクトなモデルをスマートフォンに入れて、機内モードでもチャットできます。
ニュースレターを購読
Atomicの最新情報とローカルAIのニュースをメールでお届けします。


