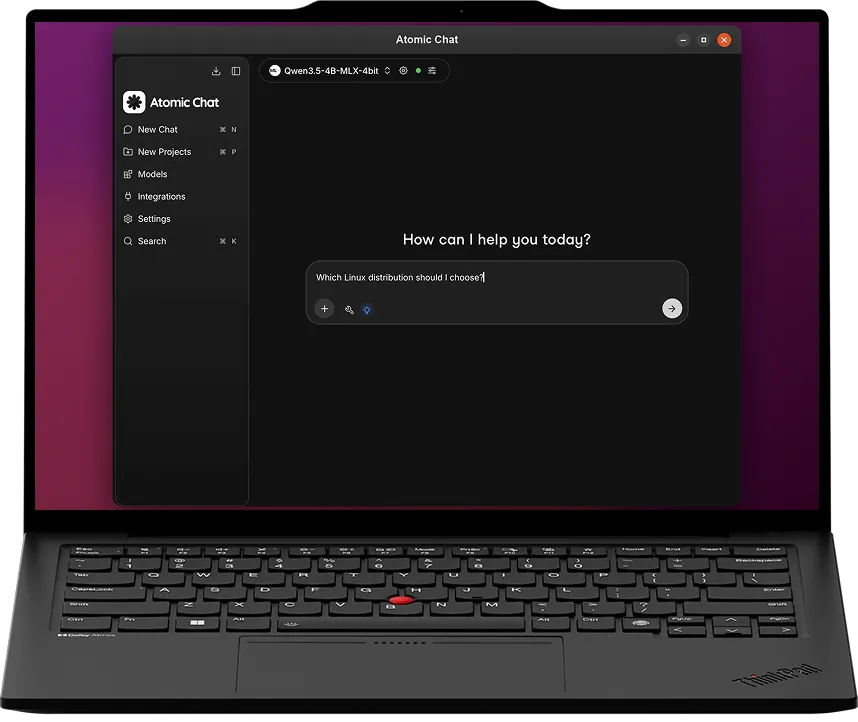


LinuxでローカルLLMを動かすのに必要なもの
GPUがあればいちばん速いですが、CPUでも動きます。VRAMが8GBあれば、8Bモデルを人が文章を読む速さで動かせます。
インストール
AppImage
かんたんセットアップ
GPUメモリ
8GB+
推奨
LinuxでLLMを動かす手順
3ステップ、およそ10分。そのほとんどはモデルのダウンロード時間です。
AppImageをダウンロード
ファイルはx86_64版が1つだけです。実行権限を付けて起動します。パッケージマネージャーもroot権限も要りません。
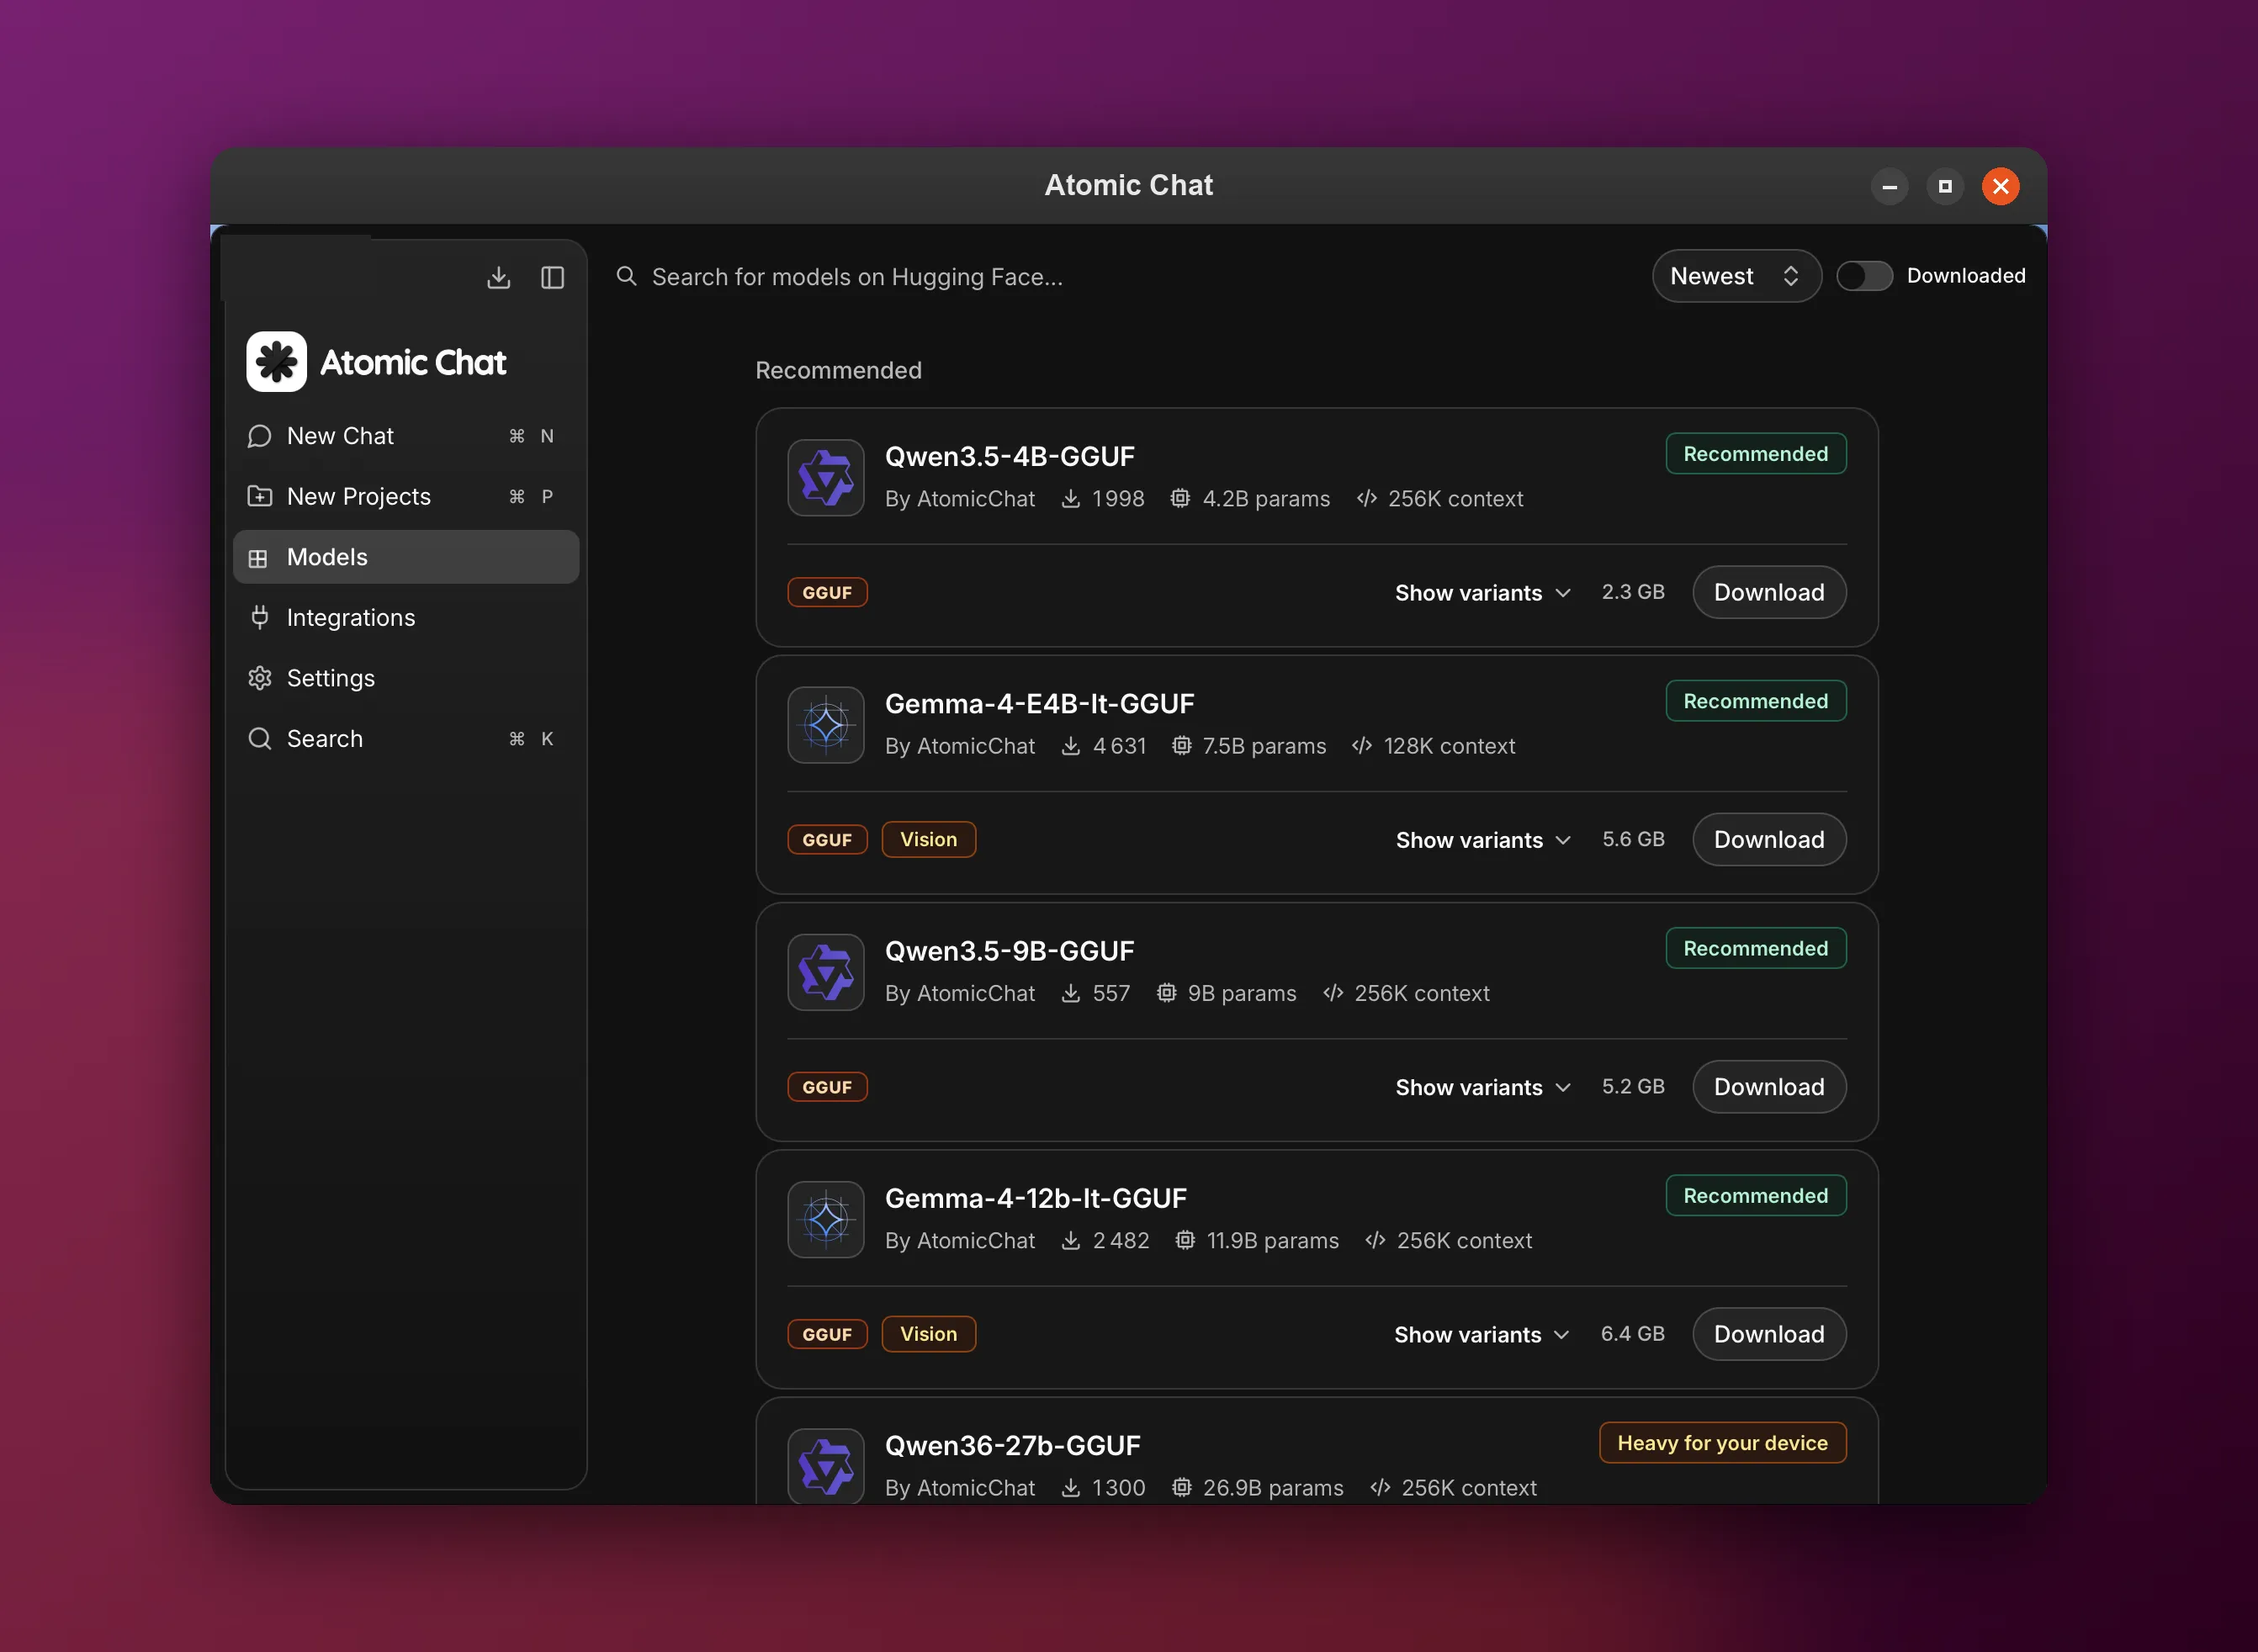
モデルを選択
1,000以上のオープンモデルから、メモリに収まるものを選びます。ダウンロードは一度だけです。あとはドライブから読み込まれ、手元のCPUやGPUで動きます。
チャットを開始
モデルは手元のマシンで動き、オフラインでもそのまま使えます。質問の回数に上限はありません。
LinuxでのTurboQuantの仕組み
TurboQuantは収まるコンテキストの量を変えるので、RAMを増やさずにコンテキストウィンドウを広げられます。
メモリを食うのはコンテキスト
キャッシュはメッセージのたびに大きくなり、会話が長くなるとモデル本体より大きくなることもあります。
ステップ1
そのキャッシュを圧縮
Atomic Chatのビルドでは、そのキャッシュを通常の16ビットではなく3ビットか4ビットで保持します。サイズは最大4.3分の1になります。
ステップ2
デバイス上で何が変わるか
メモリが尽きるまでに長く話せて、モデルを動かしながらエディタもブラウザも開いたままにできます。
ステップ3
Atomic Chatと他のLinux向けLLMアプリの比較
LinuxのOllamaにはウィンドウがまったくありません。LM StudioとAnythingLLMにはありますが、どちらもデスクトップアプリをオープンソースでは公開していません。Atomic Chatは、ウィンドウとヘッドレスサーバー、そしてApache-2.0のコードを揃えています。
OS


macOS
よくある質問
LinuxでローカルLLMを動かす前に、よく聞かれることをまとめました。
はい、いくつかあります。Atomic Chat、LM Studio、AnythingLLMはいずれもLinuxでウィンドウを持っています。Ollamaは違います。Linuxではコマンドラインツールとバックグラウンドサービスとして動き、デスクトップアプリはmacOSとWindowsだけです。
はい。ローカルサーバーを有効にして、OpenAI互換のAPIから呼び出します。デスクトップセッションは必要ありません。
はい。Atomic ChatはCUDAではなくVulkanを使うので、AMDのカードでも動きます。動作するVulkanドライバーは必要です。GPUがない場合はプロセッサで動きますが、その分だけ遅くなります。
glibc 2.35以降なら動きます。Ubuntu 22.04以降、Debian 12以降、Fedora 40以降、Arch、Mint、Pop!_OSが該当します。
はい。契約書やログファイル、表計算ファイルを開いて、その中身について質問できます。ファイルはディスクに残ったままで、アップロードされることはありません。
コードならQwen CoderやDeepSeekが候補です。RAMが許すかぎり大きいものを選んでください。書いた内容がマシンの外に出ることはありません。
はい。OpenAI互換のローカルエンドポイントがあります。Kilo CodeやCline、任意のOpenAI SDKを向けるだけです。キーも料金もありません。
いいえ。AppImageファイル1つだけです。実行権限を付けて起動します。.debも.rpmもありません。
はい。ケーブルを抜いても、ファイアウォールで塞いでも構いません。モデルをダウンロードしたあとは、Atomic Chatがネットワークを必要とすることは二度とありません。
はい。App StoreとGoogle Playにありますが、小さいモデル専用です。スマートフォンの3Bは、デスクトップの13Bとは別物です。オフラインで役に立ちますが、置き換えにはなりません。
ニュースレターを購読
Atomicの最新情報とローカルAIのニュースをメールでお届けします。


