
クラウドAIの魅力は、いつでも使えることです。ちょっとしたアドバイスが必要ですか?スマートフォンでClaudeに聞いてみましょう。長いコンテキストを扱う複雑なコーディング作業が必要ですか?ノートパソコンを開いて、デスクトップ版のClaude Codeを実行しましょう。いつでも頼れる存在です。
ローカルLLMも同じように使えますが、そのことを知らない人もいます。実はスマートフォンでもローカルで実行でき、AIに料金を払う代わりに、自分で所有できます。無料で、利用制限がなく、Wi-Fiもモバイル通信も必要ありません。アプリを選んでiPhoneやAndroidにダウンロードするだけで、いつでも持ち歩けます。
要点
最もおすすめのオフラインAIはどれですか? Atomic Chatは使いやすく、信頼性があります。最適なモデルがあらかじめ選ばれているので、切り替えながら最良の出力を得られます。Private LLMは、iPad M4で最も大きなモデルを扱えます。Locally AIはiPhoneとmacOSを同期し、負荷の高いデスクトップ向けモデルをスマートフォンから実行できます。
何ができませんか? リアルタイムの音声会話です(3-5 tok/secでは、衛星電話のような遅延を感じます)。iPhoneで3Bを超えるモデル、Androidで7Bを超えるモデルの実行もできません。バックグラウンド処理もできず、アプリを閉じると推論が止まります。
スマートフォンにはどの程度の性能が必要ですか? フラッグシップ機は必要ありません。2021年以降のミドルレンジのスマートフォンなら、RAMが6GBあれば、多くの機種で実用的な3Bモデルを問題なく実行できます。ローカルAIで重要な仕様はRAMであり、プロセッサーの速度や価格ではありません。
メモリはどのくらい必要ですか? 実用的な3Bモデルの実行には、少なくとも合計6GBのRAMが必要です。RAMが4GBのスマートフォンでは、1Bモデルを試せます。iPhoneで快適に使うには、実用上8GBが最低ラインです。Androidで7Bを実行するには、12GB以上が必要です。
オフラインで使えるAIはありますか? GGUFまたはMLX形式のモデルを使用するアプリは、モデルをダウンロードすればオフラインで実行できます。モデルファイルのサイズは、量子化された1Bモデルの700MBから、7Bモデルの5-8GBまであります。
スマートフォンでの「オフラインAI」とは
仕組みはシンプルで、ほかのローカルLLMと同じです。 モデルを一度ダウンロードすれば、処理はすべて端末内で行われ、リクエストがスマートフォンの外に出ることも、サーバーを介することもありません。
ただし、普段慣れているほどの速さではありません。 クラウドAIは1秒未満で応答しますが、スマートフォンのローカルAIでは100語の回答に15-20秒かかり、長時間のセッションでチップが熱くなると、さらに遅くなります。 とはいえ、「我慢できないほど遅い」というほどではありません。実際に試してみると、日常的なQ&Aや文書の下書き、書き直しには十分使え、場合によっては数学やプログラミングにも対応できます。完全にオフラインで動くモデルとしては、なおさらです。
技術自体はデスクトップのローカルAIと同じで、使えるメモリと熱設計上の余裕が小さいだけです。
必要なハードウェア:iPhoneとAndroid
先ほど述べたとおり、フラッグシップ機は必要ありません。AndroidでもiPhoneでも、2021年以降に発売されたスマートフォンなら、 軽量モデルを実行するには十分です。より大きなモデルを使う場合は、以下の表でRAMをよく確認してください。
Androidの場合
RAM容量を確認するには、Settings → About Phone → Memoryを開きます(正確な手順はメーカーによって異なり、SamsungではDevice Care → Memory、PixelではAbout phoneにあります)。
ユーザーによく使われているAndroid機種の例を紹介します。
| 端末 | RAM | 最大モデルサイズ | 速度 |
|---|---|---|---|
| Pixel 9 / 9 Pro | 12-16GB | 3-7B | 約3-5 tok/sec* |
| Galaxy S24 Ultra | 12GB | 7B | 約4 tok/sec |
| Galaxy S25 / S25+ / S25 Ultra | 12GB | 7B | 約5 tok/sec |
| OnePlus 13 | 16GB | 7B | 約5 tok/sec |
*Pixel 9 Proの注意点:RAMは16GBで、Google Tensor G4チップを搭載しています。利用できるハードウェアアクセラレーションはアプリとバックエンドによって異なり、NPUへのアクセスだけでCPUのみの推論になるとは判断できません。
7Bを超えるモデルは、どのスマートフォンでも実用的ではありません。ノートパソコンやデスクトップで使うほうが無難です。
iPhoneの場合
iOSでは、SettingsのどこにもRAM容量が表示されません。以下の表で、自分の機種の容量を確認できます。
| 端末 | RAM |
|---|---|
| iPhone 12 / 12 mini, iPhone 13 / 13 mini | 4GB |
| iPhone 12, 13, 14, Pro / Pro Max, 15 / 15 Plus | 6GB |
| iPhone 15, 16 Pro / Pro Max, iPhone 15, 16 / 15, 16 Plus, iPhone 17 | 8GB |
| iPhone 17 Air, 17 Pro, 17 Pro Max | 12GB |
| iPad Air M2 | 8GB |
| iPad mini (A17 Pro) | 8GB |
| iPad Pro M4 | 16GB |
総RAM容量から2-3GBを引いた容量が、実際にモデルに使えるメモリです。
推論を継続した場合のバッテリー消費に注意してください。iPhone 16 Proは、連続して負荷をかけると2-4時間でバッテリーが切れます。充電しながら推論を実行しないことが重要です。端末が熱くなると、サーマルスロットリングによって速度が30-50%低下します。
オフラインAIアプリでできること・できないこと
試すアプリを見ていく前に、AIアシスタントに期待する機能の一部は、ここでは使えないことを押さえておきましょう。モデルをスマートフォンのRAM内だけで動かす仕組みには、当然ながら限界があります。
最新の情報が必要な場合
ローカルモデルはインターネットにアクセスできません。今日のニュース、株価、運航状況、昨日の試合結果、レストランがまだ営業しているかを尋ねても、よくて自信ありげな推測、悪ければハルシネーションによる回答が返ってきます。
情報の鮮度が重要な内容には、引き続きクラウドを使うほうがよいでしょう。
代わりに得意なのは、自分で直接貼り付けた内容を扱うことです。ローカルモデルは、チャットに貼り付けた文書の要約、書き直し、文書についての質問への回答など、提供されたテキストを扱うのが得意です。自分でコンテキストを渡せば、モデルが世の中の出来事を知っている必要はありません。
長く、何度もやり取りする会話
20往復にわたって事業提案書を練り直す、何度も下書きを重ねて大量の文章を書くなど、モデルが思考の流れを見失わずに進めなければならない作業です。スマートフォン上の3Bモデルは、以前のコンテキストを見失い、矛盾したことを言い始めたり、それまでの修正を忘れたりします。
クラウドモデルは100K以上のトークンを性能低下なしに保持できるため、それまでの内容を積み重ねて進める作業には、より適したツールです。
複雑な推論やコーディング
200行の非同期コードからバグを見つける、特殊な記述がないかコードをレビューする、二つを比較するといった作業では、3Bモデルも回答はしますが、大きなモデルなら見落とさない点を見逃します。このような場合は、コーディング作業を十分にこなせるデスクトップでローカルAIを実行するか、そのコードに機密性がなく、自分のマシンの外に送信してもよいと確信できるなら、クラウドを使ってください。
簡単なコーディング作業なら、スマートフォンのオフラインアプリでも問題ありません。正規表現の作成、短い関数の動作説明、コンポーネントのひな形の生成、コードスニペットの別の言語への変換などです。これらは3Bモデルが安定して対応できる範囲に収まります。
2026年に使えるオフラインAIアプリ6選
| アプリ | 対応プラットフォーム | 料金 | モデル | 主な特徴 |
|---|---|---|---|---|
| Atomic Chat | iOS、Android、Mac、Windows、Linux | 無料 | モバイル向けに厳選した13モデル、デスクトップでは1,000以上 | iOS、Android、Mac、Windows、Linuxで共通のインターフェース。さまざまな作業(思考、プログラミング、画像、音声)向けに事前テスト済みの13モデル |
| PocketPal AI | iOS、Android | 無料 | Hugging Faceの任意のGGUF | 最も幅広いモデルの選択肢。あらゆるモデルを、任意の量子化で読み込み可能 |
| Google AI Edge Gallery | iOS、Android | 無料 | Gemma 4のみ | カメラと音声の機能。Google公式アプリ |
| Locally AI | iOS、iPad | 無料 | MLX(厳選モデル) | LM Link経由でMacのLM Studioに接続し、スマートフォンからデスクトップのモデルを実行 |
| Private LLM | iOS、iPad、Mac | $5.99 | GGUF(厳選モデル) | SwiftUIによるネイティブ実装。iPad Pro M4で13Bをクラッシュせずに読み込み可能 |
| MLC Chat | iOS、Android(サイドロード) | 無料 | コンパイル済み(厳選モデル) | 端末のチップに合わせてモデルをコンパイル。Snapdragon 8 Eliteでより高速 |
Atomic Chat

対応プラットフォーム: iOS、Android、macOS(IntelとApple Silicon)、Windows、Linux
料金: 無料、オープンソース(Apache 2.0)
ストレージ: アプリ約100MB+モデルのダウンロード分(GGUF、MLX、ONNX形式に対応)
モデル: スマートフォンと、特に需要の高い作業(思考、プログラミング、ファイル・画像・音声の処理)に合わせてテストし、選定した0.8B-8Bの13モデル(Qwen、Gemma、SmolLM、Bonsai、DreamShaperなど)
Atomic Chatは、デスクトップ、ノートパソコン、スマートフォンで利用できます。モバイルアプリ(iOSとAndroid)は独立しており、デスクトップとスマートフォンの間で会話を同期したり、セッションを共有したりすることはできません。ただし、インターフェースのデザインは共通です。すでにMacでAtomic Chatを使っているなら、スマートフォンアプリにもすぐになじめます。
モデルはあらかじめ用意されているので、Hugging Faceの膨大な一覧を見て、一つずつテストする必要はありません。Atomic Chatはスマートフォンで快適に動く最適な13モデルを選定しており、モデル間を数秒で切り替えられます。思考にはQwen 3.5(4B)、PDFや写真、さらには音声の処理にはGemmaを使えます。
スマートフォンの制約は引き続きあり、モバイルではTurboQuantを利用できません。
おすすめの用途: 簡単で使いやすいセットアップと、どのスマートフォンでも2分で使い始められる最適な組み込みモデルを求める場合。Hugging Faceで探す時間をかける必要がありません。モデルをすばやく切り替え、特定の作業(思考、画像、音声)でよりよい出力を得られます。
短所: ほかのスマートフォンアプリと同様、モバイルでは依然として1-3Bが上限です。デスクトップでは、できることがはるかに多くなります。
スマートフォンでローカルモデルを試す:
→ Android
→ iOS
Google AI Edge Gallery
対応プラットフォーム: iOS、Android
料金: 無料
ストレージ: アプリ+Gemma 4モデルのダウンロード分(選択するバリアントにより約1-2GB) モデル: Gemma 4ファミリー(Googleがオンデバイス向けに最適化)
特記事項: Google公式アプリ。両方のアプリストアで入手可能
Gemma 4はGoogleのモデルで、オンデバイス推論専用に構築されており、デスクトップ規模のチェックポイントを転用したものではありません。そのため、コールドスタート時の読み込みが速く、メモリ不足によるクラッシュも少なくなります。Hugging Faceにある汎用的な7BのGGUFは、どのスマートフォンで動かされるかを把握していませんが、このアプリのGemma 4は把握しています。
基本的なチャット以外にも、知っておきたい機能が3つあります。いずれもオフラインで動作し、データは端末の外に出ません。
- Ask Image:カメラを向けて質問できます。
- Audio Scribe:Whisper APIを使わず、端末上で文字起こしを行います。
- Mobile Actions:ファインチューニングされた270Mの関数呼び出しモデルが、端末上で直接ショートカットを実行します。
最後の機能は実験段階ですが、このアプリで技術的に最も興味深い機能です。
Googleのアプリの明確な制限は、Gemma 4しか実行できないことです。LlamaもQwenも、独自にファインチューニングしたモデルも使えません。特定のモデルが必要なら、このアプリは適していません。Atomic Chatを使って、Gemmaの能力をQwenや別のモデルの能力と組み合わせ、倍増させてみてください。Gemmaに加え、ほかの12のローカルLLMが組み込まれています。
おすすめのユーザー: マルチモーダル機能と音声機能を備え、設定不要で使える、完成度が高く公式サポートのあるアプリを求めるAndroidユーザー。
短所: Gemma 4に限定されており、Llama、Qwen、DeepSeek、独自モデルはありません。特定のモデルが必要な場合には役立ちません。
LM StudioのLocally AI
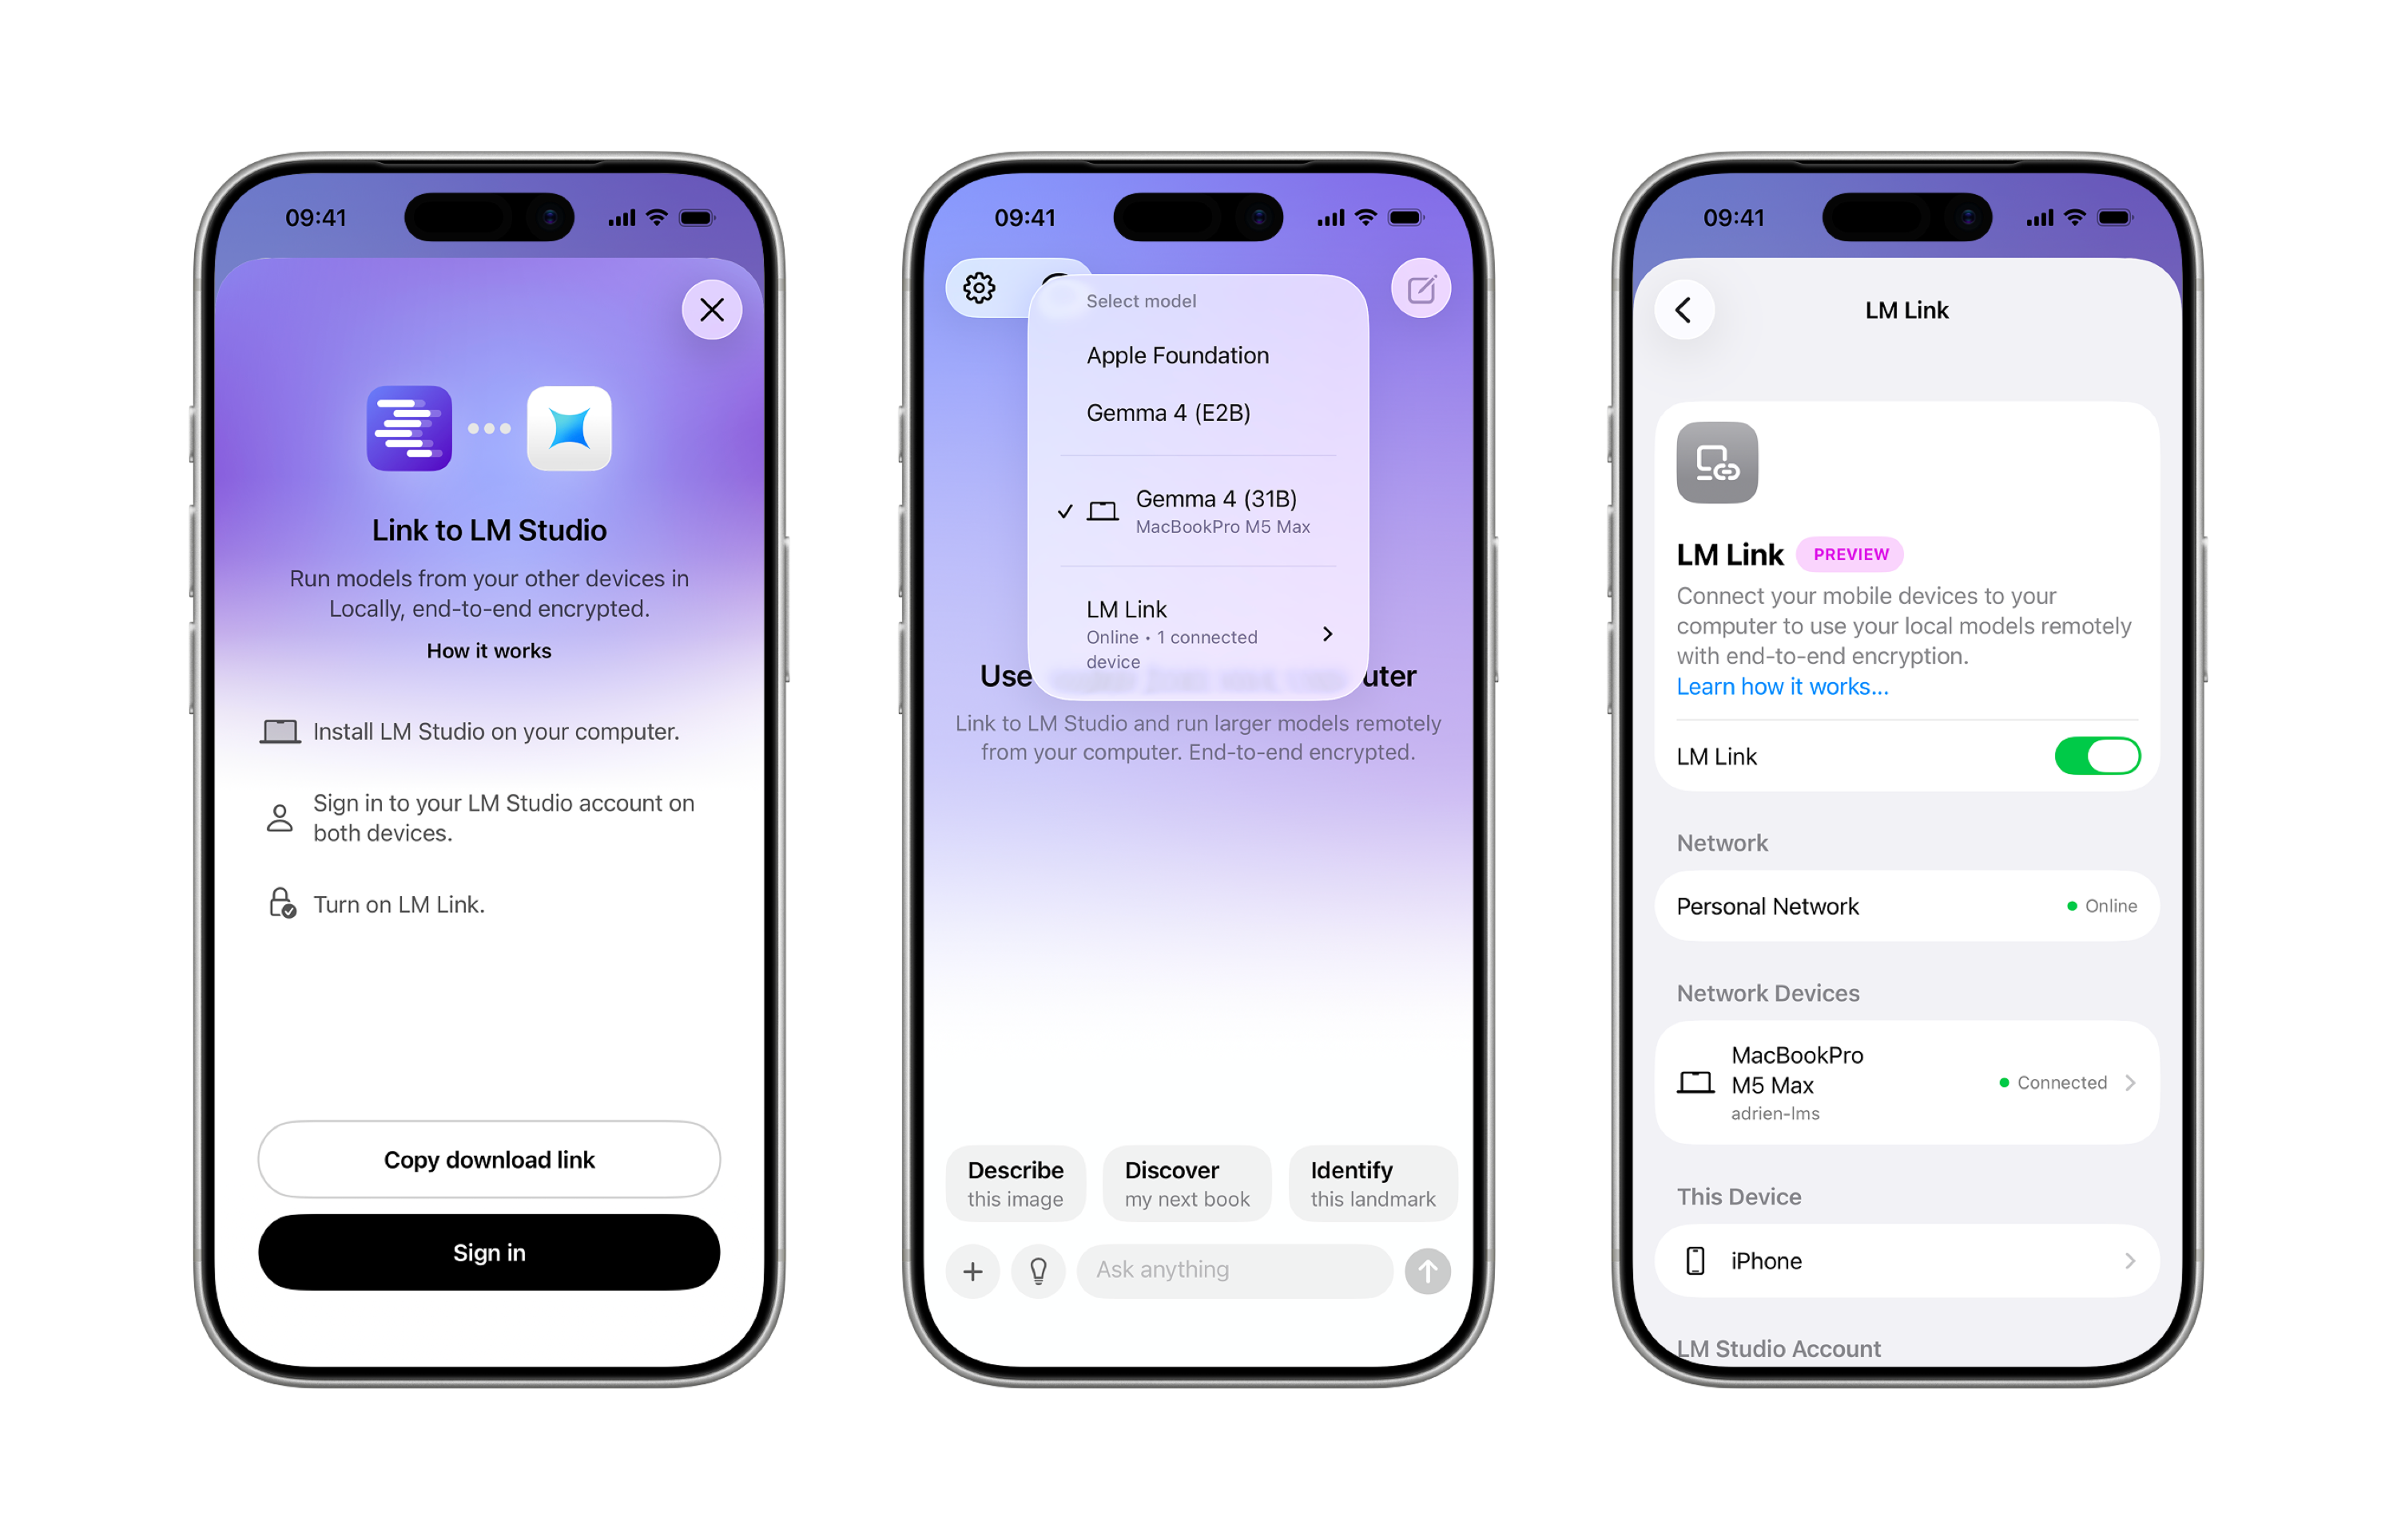
対応プラットフォーム: iOS、iPad(Android非対応)
料金: 無料
ストレージ: アプリ約60MB+MLXモデルのダウンロード分(1Bで約1.5GB、3Bで約2.5GB。MLXファイルは、同等のGGUFよりやや大きくなります)
モデル: Llama 3.2、Gemma 2 & 3、Qwen 3、DeepSeek。Apple MLX形式
Locally AIはApple MLXを使用し、CPUやGPUで推論を実行します。MLXはNeural Engineを直接利用する仕組みではありません。PocketPalのようなGGUFベースのアプリも、iOSのMetalを含むGPUアクセラレーションを利用できます。長時間使用した場合の性能は、端末、モデル、バックエンド、温度による制限に左右されます。モデル形式だけで速度や熱による性能低下の違いは判断できません。
このアプリを試す価値のあるものにしているのが、LM Linkです。MacでLM Studioを使っていれば、Locally AIがエンドツーエンド暗号化を使ってローカルネットワーク経由で接続し、デスクトップの13B、30B、さらには70Bのモデルを実行できます。仕組みは、スマートフォンがプロンプトを送り、Macが処理するというものです。
おすすめのユーザー: すでにMacでLM Studioを実行していて、LM Link経由でスマートフォンからデスクトップの大きなモデルを使いたいiPhoneユーザー。
短所: iOSのみ。Macとのデスクトップ連携がなければ、ここで紹介するほかのアプリに対する優位性はありません。MLXのモデルライブラリはGGUFより選択肢が少なくなります。
PocketPal AI
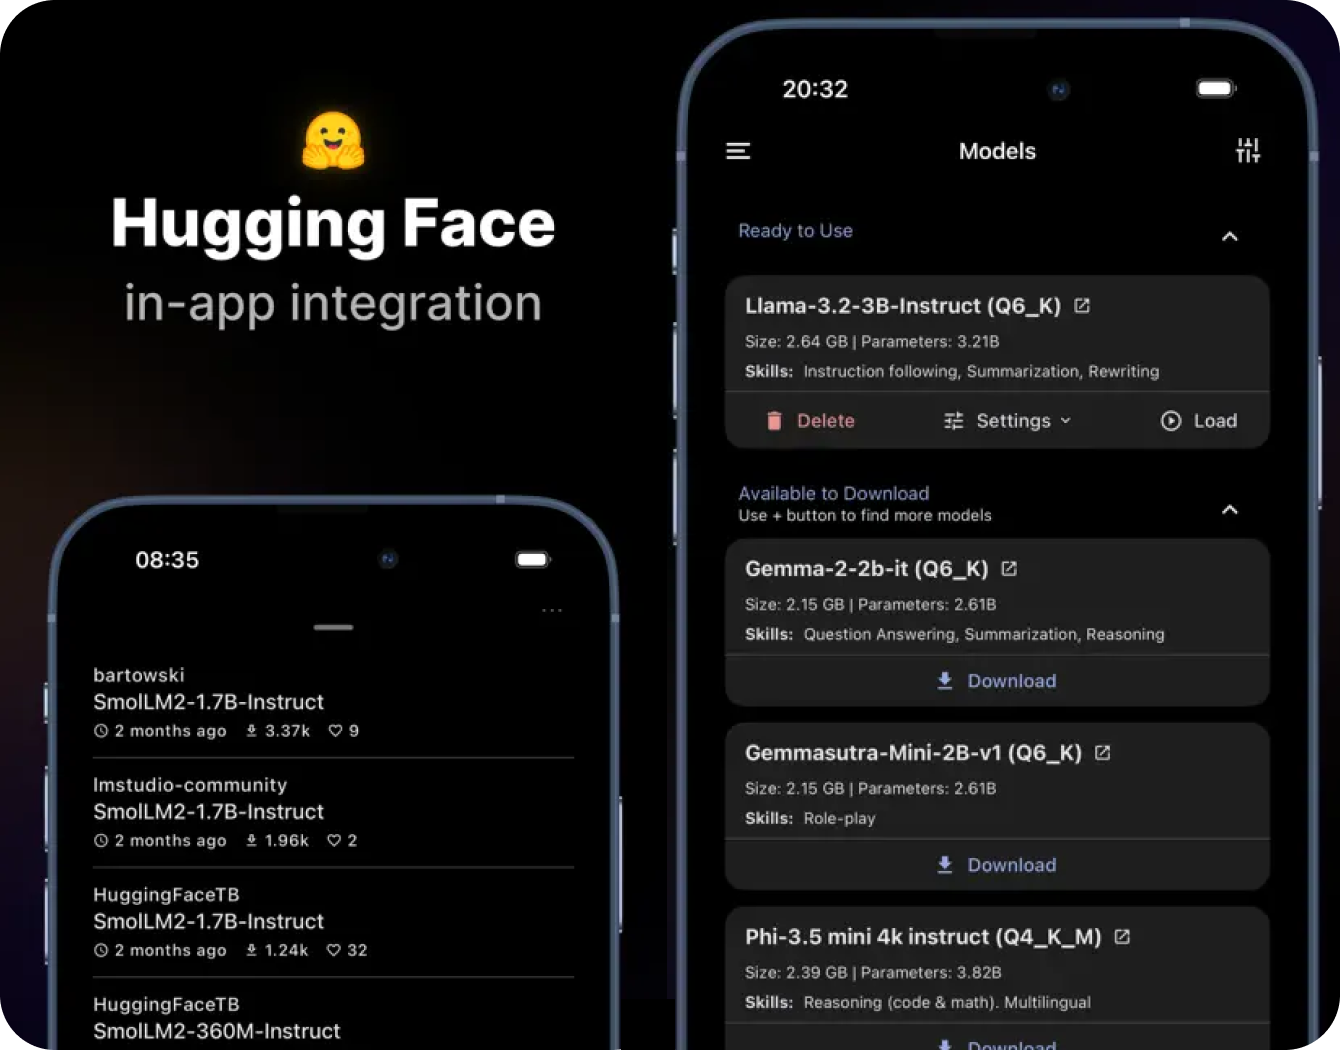
対応プラットフォーム: iOS、Android
料金: 無料、オープンソース
ストレージ: アプリ約60MB+モデルのダウンロード分(1B Q4で700MB、3B Q4で約2GB、7B Q4で約4.5GB)
モデル: GGUF形式。Phi-4 Mini、Gemma 2、Qwen 2.5、Llama 3.2のほか、Hugging Faceにある任意のモデル。
ローカルAIの実行に十分な経験がある人向けの、難易度の高いアプリです。PocketPalは、React Nativeのバインディングを介してllama.cpp(Ollamaでも使われている推論エンジン)上に構築されています。幅広いモデルに対応していますが、低価格帯のAndroid端末ではUIの動作が時折もたつきます。
Hugging Faceと連携しており、アプリ内で任意のGGUFモデルを検索できます。量子化レベルを選び(通常はQ4_K_Mがサイズと品質のバランスに優れます)、アプリを離れずにダウンロードできます。
組み込みのMulti-Token Predictionツールでモデルごとのtokens/secとメモリ使用量を確認できるため、4GBのダウンロードを始める前に、自分の端末で何を扱えるか判断するのに役立ちます。
おすすめのユーザー: Hugging Faceのカタログ全体にアクセスしたく、モデルと量子化を自分で選ぶことをいとわないユーザー。
短所: 低価格帯のAndroidではReact Nativeのフロントエンドに遅延が生じます。デスクトップ版はありません。モデルの選択には、ある程度の予備知識が必要です。
Private LLM
対応プラットフォーム: iOS、iPad、macOS(Apple Silicon)
料金: $5.99の買い切り
ストレージ: アプリ約100MB+アプリ内でダウンロードするモデル(GGUFと同じサイズ。3Bで約2GB、13Bで約8GB)
モデル: iPad Pro M4では3-13B、iPhoneでは1-3B
Private LLMはSwiftUIで開発されたネイティブアプリです。この一覧で唯一の有料アプリで、$5.99の買い切りですが、サブスクリプションはありません。16GBの統合メモリを搭載したM4 iPad Proでは、13Bモデルを約15 tok/secで実行できます。同じ端末でもPocketPalでは13Bの読み込みに苦労することがありますが、Private LLMはReact Nativeでラップされたものではなく、Apple Silicon向けにネイティブ開発されているため、問題なく処理できます。
iPhoneでは、その$5.99を節約するほうがよいと考えます。どのアプリを使っても、ハードウェアの制約によって上限は3Bです。ほかのアプリでも同じ上限に達しますが、少なくとも無料で使えます。
おすすめのユーザー: 13Bモデルをクラッシュせず安定して実行したいiPad Pro M4の所有者(ネイティブのSwiftUIは、React Nativeベースの代替アプリよりメモリを適切に扱えます)
短所: iPhoneでは、どのみちハードウェアの制約で3Bが上限となるため、$5.99を払う理由は乏しいでしょう。Androidには対応していません。
MLC Chat
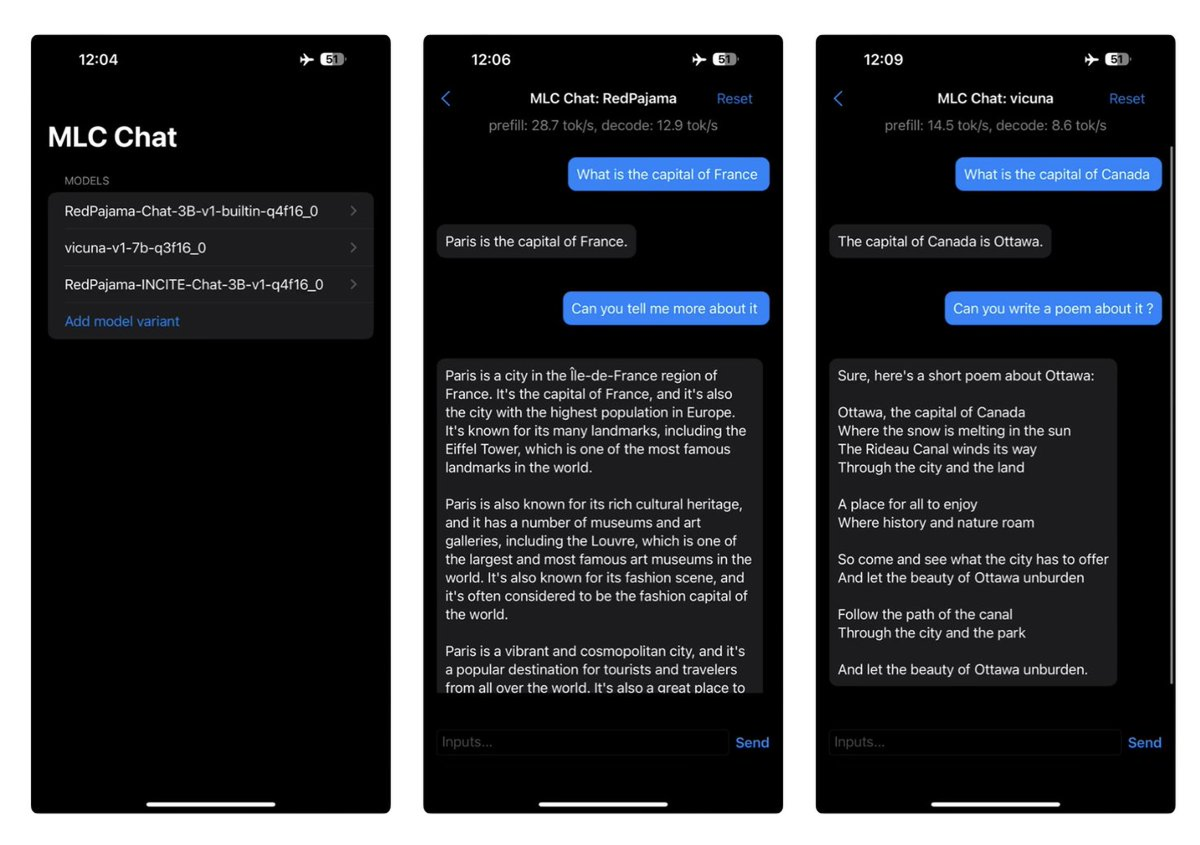
対応プラットフォーム: iOS、Android(APKのサイドロード)
料金: 無料、オープンソース
おすすめのユーザー: Snapdragon 8 Elite(Galaxy S25 Ultra、OnePlus 13)を使用し、Hexagon NPU経由で可能な限り高速な1-3Bの推論を求める技術に詳しいユーザー。
短所: 厳選されたモデルライブラリのみ。任意のGGUFファイルは読み込めません。AndroidではAPKを手動でサイドロードする必要があります。コンパイル済みモデルは、ほかのアプリでは使えません。
MLC Chatは対象プラットフォーム向けにモデルライブラリをコンパイルし、モバイルGPUで高速化します。この一覧のほかのアプリもハードウェアアクセラレーションを利用できるため、この方式だけでより高速だとは判断できません。Galaxy S25 Ultraでは、Phi-4 MiniがPocketPalの約16 tok/secに対し、約22 tok/secに達します。この差は長い出力で実感でき、短い返答ではそれほど目立ちません。難点は、この方式では事前にコンパイルされた固定のモデル一覧が必要で、自分のファイルを読み込めないことです。
また、Play Storeにはないため、AndroidユーザーはAPKをサイドロードする必要があります。iPhoneでは、1-3Bでの速度面の優位性は小さく、7Bは依然としてRAMの制限でクラッシュするため、上記のGGUFベースのアプリ(Atomic ChatやLocally AIなど)のほうが手軽な選択肢です。
ストレージ: アプリ約100MB+コンパイル済みモデルのダウンロード分(1Bで約1.5GB、3Bで約3GB。MLCでコンパイルされた重みは、アーキテクチャ固有の最適化により、元のGGUFよりやや大きくなります)
モデル: Llama、Qwen、Gemma、Phi。1Bから7B。効率化のためにMLCによるコンパイルを使用
よくある質問
オフラインAIアプリとChatGPTの違いは何ですか?
ChatGPTは入力をOpenAIのサーバーに送信し、リモートで処理して回答を返します。オフラインAIアプリは、モデルをスマートフォンのRAMに読み込み、ローカルで推論を実行します。端末の外には何も出ません。能力に差があるのは事実で、ChatGPTははるかに大きなモデルを使って動作します。その代わりに得られるのは、プライバシーとサブスクリプション費用がかからないことです。
古いスマートフォンでもオフラインAIアプリを実行できますか?
最低限必要なRAMは4GBです。2020年以降のスマートフォンの多くが、この条件を満たします。それ未満では、出力が始まる前にモデルの読み込みに失敗します。4GBの端末では、1Bモデルまでにとどめてください。Qwen 2.5 0.5BまたはLlama 3.2 1Bが実用的な選択肢です。それより大きいモデルは、クラッシュするか、待つ価値がないほど出力が遅くなります。
オフラインAIを使うとバッテリーの減りは速くなりますか?
はい。推論中はバックエンドに応じてCPU、GPU、またはNPUに高い負荷がかかり続けます。iPhone 16 Proは、通常の使用では8-10時間持つのに対し、推論を継続すると約2-4時間でバッテリーが切れます。10-15分のセッションなら問題ありませんが、長時間連続で使用すると発熱してサーマルスロットリングが発生し、出力がさらに遅くなります。
スマートフォンでオフラインAIをコーディングに使えますか?
短いコードスニペットなら使えます。3Bモデルは、コードの説明、簡単な補完、単一関数のデバッグに対応できます。複数ファイルのコンテキストや、数百トークンを超えるコードは、3-5 tok/secではすぐに実用的な範囲を超えます。本格的なコーディングには、13B以上のモデルを搭載したノートパソコンでのオフラインAIが、まったく別次元のツールになります。
オフラインAIはプライバシーを守れますか?
ここで紹介したすべてのアプリは、推論自体を端末上で実行します。ただし、プロンプトのデータがスマートフォンの外に出なくても、バックグラウンドでクラッシュレポートや分析データを送信するアプリもあります。PocketPal AIは、初期設定では何も送信しません。Atomic Chatはオープンソースなので、ネットワーク通信の呼び出しをコードで直接確認できます。プライバシーを理由にローカルで実行するなら、推論がローカルかどうかだけでなく、各アプリが提供元に何を送信しているかも確認してください。
おわりに
どのアプリから試せばよいかわからない場合は、スマートフォンとデスクトップの両方にAtomic Chatをダウンロードし、1-3Bモデルを選んで(無難な第一候補はQwen 3.5 2BまたはGemma 4 E2B IT)、1週間使ってみてください。
不満を感じるとすれば、主な原因は速度でしょう。3-5 tok/secでは、期待値を調整し、短いQ&A、下書き、要約などの適した作業に使うようになるまでは、遅く感じます。
3 tok/secでは使う気になれないなら、ローカルAIをストレスなく使えるだけの速度で実行できるモバイル端末は、iPad Pro M4だけです。13Bで15 tok/secという速度は、同じモデルをミドルレンジのノートパソコンで実行した場合に近いものです。それ未満の端末では、モデルサイズか速度のどちらかを妥協することになります。