


大半の大規模言語モデルは自己回帰的に動作します。つまり、新しいトークンを生成するたびに、それ以前のすべてのトークンから次のトークンを予測します。投機的デコーディングは、2022〜2023年にGoogle DeepMindの研究者が発表した手法です。基本的には複数のトークンを先読みして予測できるようにするもので、同じハードウェア上での生成を大幅に高速化します。
この記事では、投機的デコーディングとは何か、性能にどのような影響があるか、Atomic Chatでどのように利用するかを説明します。
要点
投機的デコーディングは、モデルの最終出力を変えずにテキスト生成を高速化します。通常、モデルはトークンを1つずつ生成します。一方、投機的デコーディングでは、軽量な「ドラフト」段階で複数のトークンを先読みして予測し、その予測をより大きな「ターゲット」モデルで検証します。一致する予測は受理され、最初の誤った予測とそれ以降の予測はすべて破棄されます。現代のGPUは、複数のトークンをまとめて処理しても単一トークンの処理とほぼ同じコストで済むことが多いため、ドラフトの予測精度が高ければ、わずかな追加計算でスループットを大幅に向上できます。Atomic Chatには、Multi-Token Prediction (MTP)やDFLASHなどの投機的デコーディングを組み込んだ、独自に調整された推論エンジンが搭載されています。そのため、ここで説明する方式のいくつかは、自分で設定する必要がなく、最初から利用できる機能になっています。
投機的デコーディングとは?
言語モデルは自己回帰的にテキストを生成します。つまり、新しいトークンは、それ以前のすべてのトークンから予測されます。標準的なデコーディングでは、モデルはトークンを1つ生成するたびに1回の順伝播を実行します。大規模なモデルでは、この処理はメモリ帯域幅によって制限されることがよくあります。GPUは順伝播のたびにメモリからモデルの重みを読み込むことに多くの時間を費やす一方で、新しく生成するトークンは1つだけだからです。投機的デコーディングは、この順伝播の回数を減らします。
投機的デコーディングでは、モデルはまず、計算コストの低いドラフト生成の仕組みを使って、候補トークンの短い列を生成します。通常は、次の3つのいずれかを使います。
- ドラフトモデルと呼ばれるはるかに小さなLLM。
- ターゲットモデルに取り付けられ、数トークン先までを推定する予測ヘッド。
- または、繰り返し出現するn-gramなど、以前に出現したテキストの再利用によって、可能性の高い続きを提案する方法。
その後、これらの候補をフルモデルが1回の検証パスで確認します。
候補がどのように生成されても、最終出力を決定するモデルはターゲットモデルだけです。また、検証段階では、通常の自己回帰デコーディングでターゲットモデルが計算するものと同じ条件付き確率を使うため、投機的デコーディングは完全に無損失です。
投機的デコーディングの仕組み
ドラフトが提案されると、ターゲットモデルはそれを評価し、通常の自己回帰デコーディングで得られる確率分布を変えずに、ドラフト内のどのトークンを保持できるかを判断します。
これは棄却サンプリングアルゴリズムによって実現されます。ターゲットモデルはドラフトのトークン列を左から右へたどり、提案された各トークンを自身の条件付き分布と照合します。ドラフト内のトークンxについて、ターゲットモデルがそのトークンに割り当てる確率をp(x)、ドラフト生成器が割り当てた確率をq(x)とします。そのトークンは、次の確率で受理されます。
p_accept(x) = min(1, p(x) / q(x))
ターゲットモデルの確信度がドラフト生成器以上の場合(p(x) ≥ q(x))、そのトークンは必ず受理されます。ターゲットモデルの確信度のほうが低い場合は、2つの分布がどの程度一致しているかに比例した確率で受理されます。
- ドラフト内のトークンが受理されると、次のトークンの検証に進みます。
- 最初に棄却されたトークンで、検証は停止します。そのトークンは残差分布
norm(max(0, p(x) − q(x)))から再サンプリングされ、それ以降のドラフト内のトークンはすべて破棄されます。それらは、もはや有効ではない接頭辞を条件として生成されたものだからです。
この受理規則によって、手続きの厳密性が保たれます。ドラフト生成器の提案全体で平均すると、残ったトークンはターゲットモデルの分布pに従うため、出力は標準的なデコーディングと一致します。
先頭から連続して受理された最長の部分だけが残ります。その後、修正されたトークン列から生成を再開し、新たな投機的処理の反復に入ります。
したがって、投機的デコーディングの効果を主に決めるのは、ドラフト内のトークンのうち検証を通過する割合である受理率です。
- 受理率が高いほど、計算コストの高いターゲットモデルの順伝播1回で、トークン列を1トークンではなく複数トークン分進められます。
- 受理率が低いと、ドラフト生成で行った処理がより多く無駄になるため、効果が小さくなります。
この関係は厳密に表せます。ドラフト内の各トークンが確率α(受理率)で受理され、ドラフト生成器が1ステップあたり最大γトークンを提案する場合、1回の検証パスで生成されるトークン数の期待値は次のようになります(Leviathan et al. (2023))。
E[tokens per step] = (1 − α^(γ+1)) / (1 − α)
この式は、ドラフト生成の計算コストを考慮する前の、ターゲットモデルによる1回の検証ステップで生成されるトークン数の期待値を表しています。
ドラフト長がγ = 4、受理確率がα = 0.7の場合、1回の検証ステップで生成されるトークン数の期待値は約2.8トークンです。これは、標準的なデコーディングと比較して、スループットが約2.8×になる可能性を示しています。
受理確率が1に近づくと、ドラフトのほぼ全体が受理され、生成トークン数の期待値は、1回の検証ステップで得られる最大値であるγ + 1トークンに近づきます。
実際には、ドラフト生成にもコストがかかるため、実現する高速化の倍率はこれより低くなります。ターゲットモデルの順伝播1回に対する、ドラフト生成1ステップの相対コストをcとします。標準的なデコーディングに対する実時間での高速化倍率は、次のようになります。
speedup = (1 − α^(γ+1)) / ((1 − α) × (γc + 1))
分子は、上で示した1ステップあたりのトークン数の期待値です。分母は、1回の検証パスにドラフト生成のオーバーヘッドγcを加えたものです。そのため、コストの低いドラフト生成器は、精度の高いドラフト生成器に対抗できます。n-gram検索のように、αが低くてもcがほぼゼロの方式は、より高精度でもcが大きいニューラルネットワーク型のドラフト生成器を上回る場合があります。
これを踏まえると、受理率とのバランスの取り方が異なる複数の投機的デコーディング方式があります。次のセクションでは、それぞれを詳しく説明します。
投機的デコーディング方式の種類
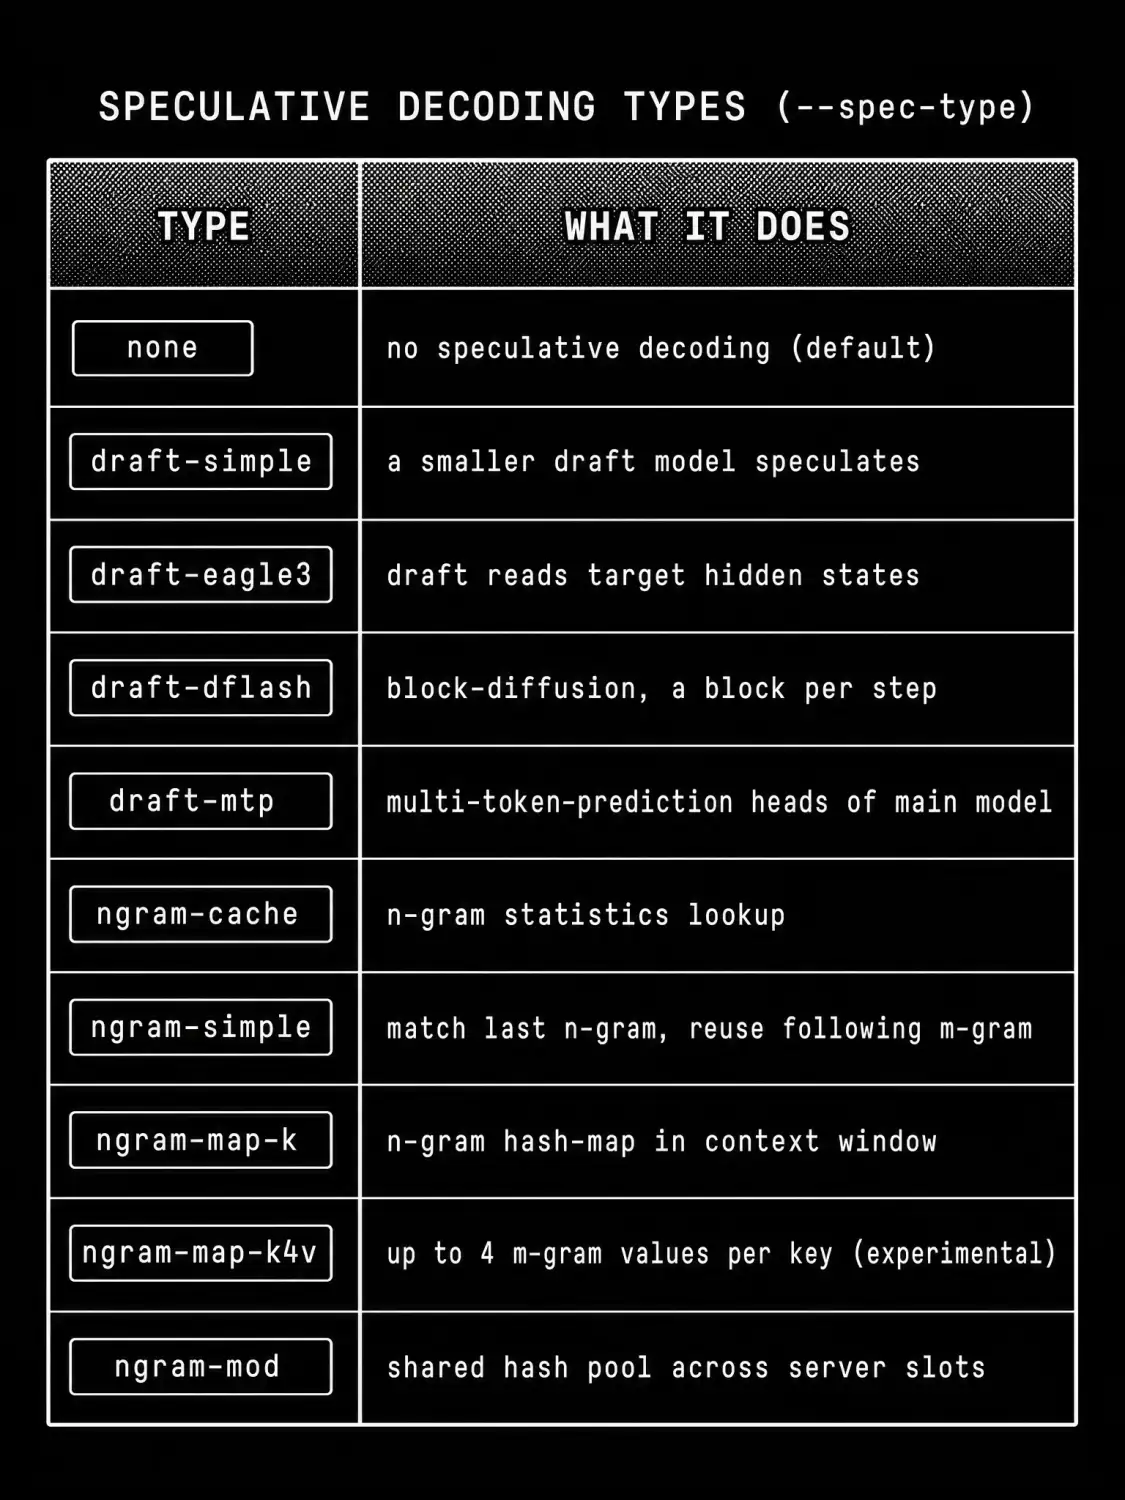
投機的デコーディングには、ドラフトトークンの生成方法が異なる複数の方式があります。大きく分けると、次の2つに分類できます。
- 補助モデルを使ってターゲットモデルの予測を近似する方式
- 既存のコンテキスト内のパターンから直接生成する方式
最初のカテゴリは、2つ目のニューラルネットワークを使ってターゲットモデルが検証する候補トークンを提案する、モデルベースのドラフト生成器です。
- ドラフトモデルは、ターゲットモデルを模倣するように学習された、別の小さな言語モデルを使います。
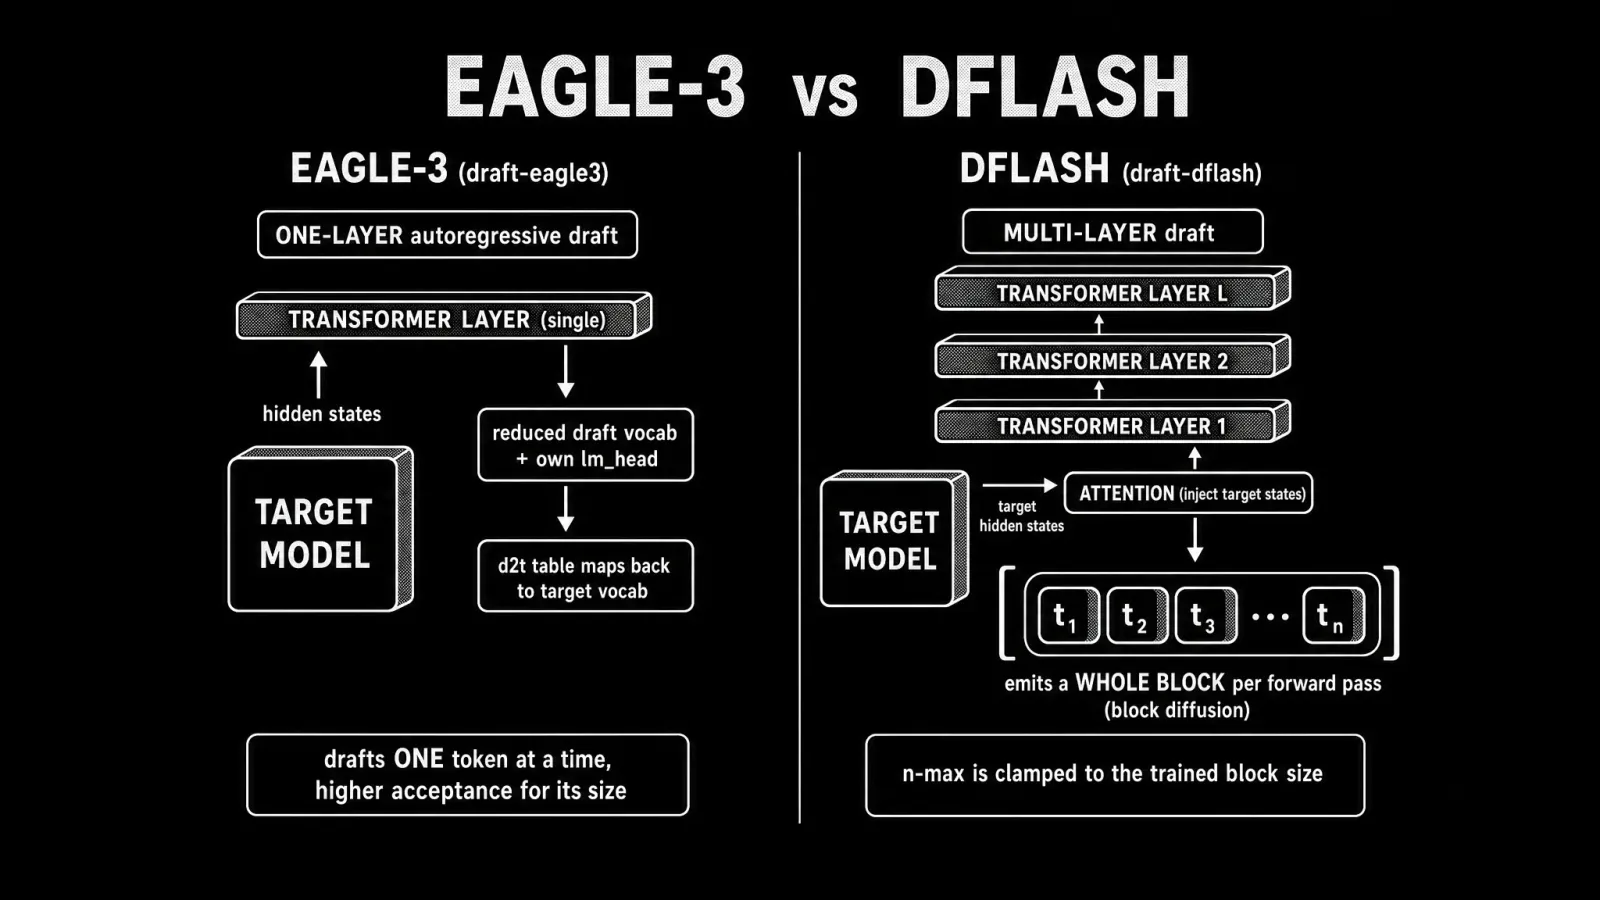
- EAGLE-3は、ターゲットモデルの隠れ層の活性値を利用する軽量な予測モジュールを取り付けます。
- DFLASHは、1回の順伝播でトークンのブロック全体を予測するブロック拡散モデルを使います。
- Multi-Token Prediction (MTP)は、ターゲットモデル自体に補助予測ヘッドを追加し、1回の順伝播で複数のトークンを提案します。
2つ目のカテゴリは、生成済みテキストにすでに存在する繰り返しを利用する、パターンベース、またはモデル不要の方式です。追加の計算をほとんど、あるいはまったく行わないため、推論のオーバーヘッドはほぼ発生しません。ただし、その効果はプロンプトと繰り返し構造の量に大きく依存します。
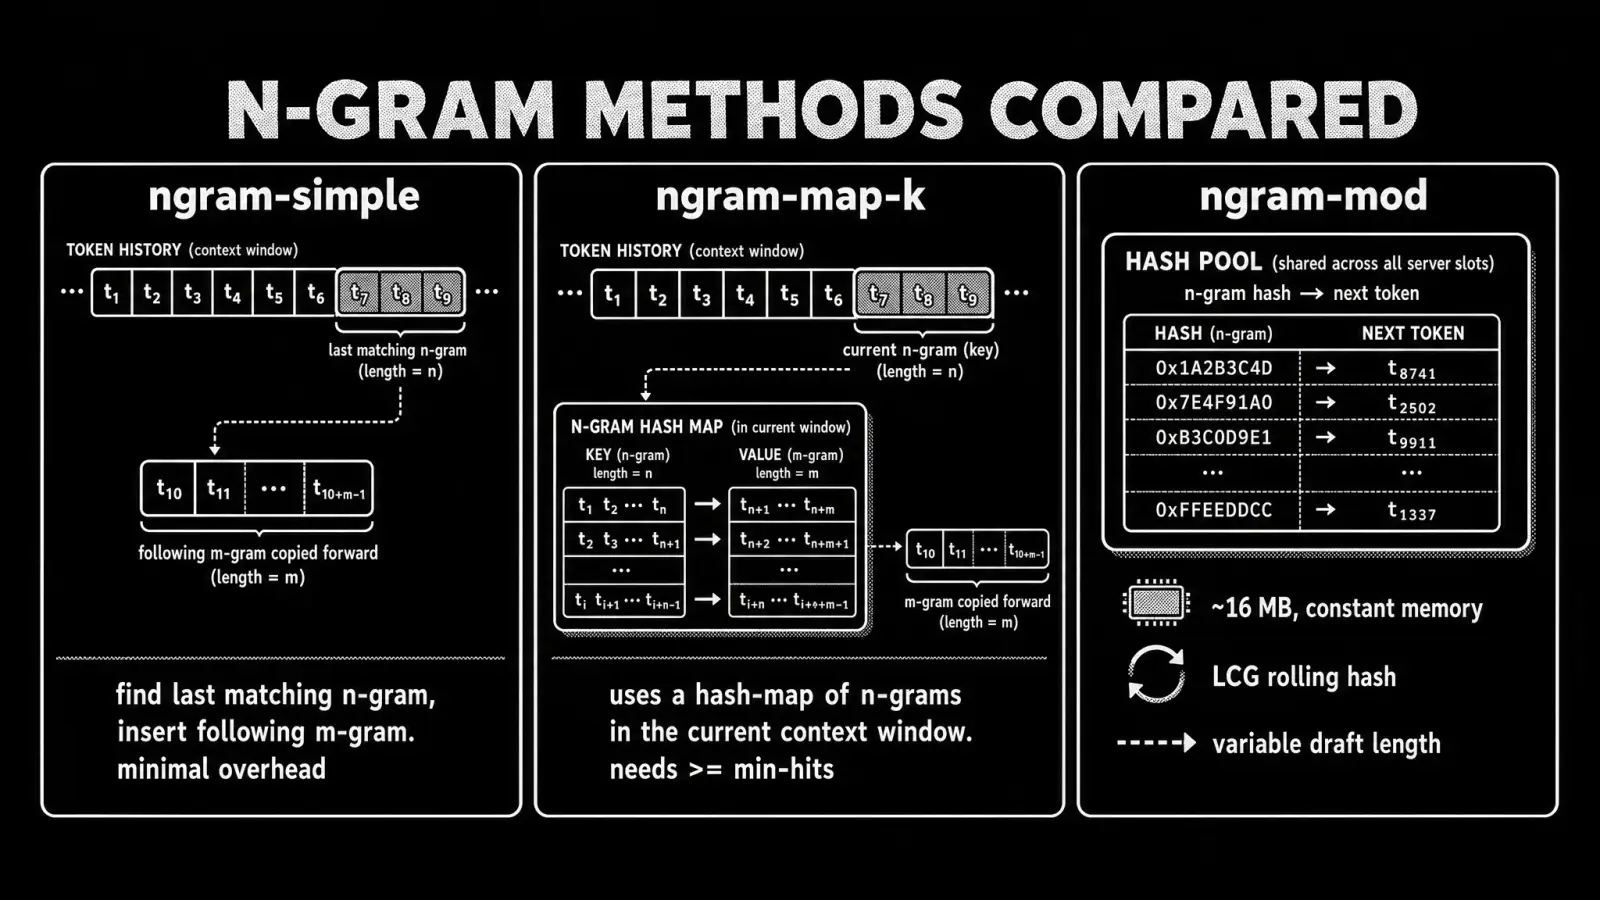
- N-gram cacheは、以前に観測されたn-gramの統計からドラフトの確率を構築します。
- N-gram simpleは、既存のコンテキストから一致する最も直近のn-gramを検索し、その前回の出現箇所に続いていたトークンを提案します。
- N-gram mapは、現在のコンテキストウィンドウ内のn-gramのハッシュマップを保持することで、こうした検索を高速化します。
- N-gram modは、固定サイズの共有ハッシュテーブルを使い、定数時間での検索を維持しながらメモリ使用量に上限を設けます。
これらのアプローチは併用できます。llama.cppのような実装では、パターンベースの方式は計算コストがほぼかからないため、先に試すことができます。適切な続きが見つからなければ、デコーダーはニューラルネットワーク型のドラフト生成器にフォールバックできます。これにより、低コストのパターンマッチングとモデルベースの投機的生成が互いを補完できます。
対応モデル
次のEAGLE-3投機モデルに対応しています。
| ターゲットモデルのファミリー | EAGLE-3投機モデル |
|---|---|
| LLaMA 3.1 / 3.3 | EAGLE3-LLaMA3.1-Instruct-8B, EAGLE3-LLaMA3.3-Instruct-70B |
| Qwen3 | Qwen3-1.7B/4B/8B/14B/32B_eagle3, qwen3_8b_eagle3, qwen3_30b_moe_eagle3 |
| Gemma 4 | gemma-4-31B-it-speculator.eagle3, gemma-4-26B-A4B-it-speculator.eagle3 |
| GPT-OSS | gpt-oss-20b-speculator.eagle3, EAGLE3-gpt-oss-120b-bf16, gpt-oss-120b-Eagle3-long-context |
DFLASHへの対応は、ターゲットに特化した投機モデルを通じて提供されます。たとえば、Qwen3をターゲットにする場合は、Qwen3-4B-DFlashのような対応するDFLASH投機モデルを使用できます。
Multi-Token Prediction (MTP)では、別のモデルをダウンロードしたり、読み込んだりする必要はありません。この方式を利用できるのは、MTPに対応するように学習されたモデルだけです。
Atomic Chatの投機的デコーディング
Atomic Chatは、Hugging Faceのモデルをワンクリックで実行できるローカルLLMアプリです。投機的デコーディングを統合した、独自に調整された推論エンジンを搭載しています。
Atomic ChatはGGUF、MLX、ONNX形式のモデルに対応し、http://localhost:1337/v1のOpenAI互換ローカルサーバーを通じて生成機能を提供します。対応モデルでは、Multi-Token Prediction (MTP)とDFLASHを使用して、投機的デコーディングを自動適用します。
Atomic ChatのMulti-Token Prediction (MTP)
Atomic Chatでは、MTPによって対応モデルのスループットが30〜70%向上します。追加の予測ヘッドがターゲット分布との高い一致度を維持できるモデルでは、より大きな向上が得られます。Gemma 4では、条件のよいワークロードで約3×に達する場合があります。たとえば、2基のRTX 5090 GPUで実行するQwen 3.6 27Bでは、毎秒51トークンから117トークンに増加し、約2.3×の向上となります。
Multi-Token Prediction (MTP)では、学習時に追加の予測ヘッドをモデルに組み込み、トークン列の先の位置にあるトークンを予測するように学習させます。各ヘッドは、現在のトークン位置からそれぞれ異なるオフセットに対応します。
推論時には、モデルの通常の出力ヘッドが次のトークンを予測する一方、追加のヘッドがさらに先の候補トークンを生成します。これらの予測が投機的な続きを構成し、その後、ほかの投機的デコーディング方式と同じ検証処理を使って、ターゲットモデルが検証します。
MTPはターゲットモデルの既存の計算を再利用し、追加の言語モデルを読み込む必要がないため、従来のドラフトモデル方式に比べてメモリのオーバーヘッドが大幅に低くなります。
DFLASH
Atomic Chatでは、生成されたブロックが高い受理率を維持できるワークロードにおいて、DFLASHによってQwen 3.6、Gemma 4、Kimi K2.5で最大6×の生成速度を実現します。その性能は、検証時にターゲットモデルとの整合性を維持する候補をブロック拡散モデルが生成できるかどうかに、特に大きく依存します。
DFLASHは先のトークンのブロックを同時に予測し、その後、ターゲットモデルが1回の検証ステップでブロック全体を検証します。この設計により、ドラフト生成段階の逐次処理によるボトルネックが軽減され、ドラフトモデルは候補トークン列をより効率よく生成できます。主な制約は、ブロック構造が学習済みのドラフトモデルによって決まることです。そのため、トークンを1つずつ生成するドラフト方式と比べて、ドラフト長を動的に調整できる範囲が限られます。
まとめ
投機的デコーディングは、計算コストの低いドラフト生成の仕組みで候補トークンを提案し、ターゲットモデルの1回の順伝播で検証することで、自己回帰生成を高速化します。Atomic Chatでは、投機的デコーディングによって、品質を一切損なうことなく、MTPで30〜70%程度のスループット向上、DFLASHで最大6×のスループットを実現します。
よくある質問
投機的デコーディングによってモデルの出力は変わりますか?
いいえ。検証では棄却サンプリング規則のもとでターゲットモデル自身の条件付き確率を使うため、生成されるテキストは標準的なデコーディングと数学的に同一です。変わるのは順伝播の回数だけで、生成されるトークンは変わりません。
投機的デコーディングによって品質や精度は低下しますか?
いいえ。仕組み上、無損失です。ドラフト内のトークンが保持されるのは、ターゲットモデルがいずれにせよサンプリングしたはずのトークンと一致する場合だけです。最初の不一致は、ターゲットモデルの分布から直接修正されます。同じ処理をより少ないパスで行うことで、高速化を実現します。
受理率とは何ですか?
受理率は、ドラフト内のトークンのうち検証を通過する割合で、受理されたトークン数を生成されたトークン数で割った値です。どれだけ高速化できるかを決める主な要因であり、受理率が高いほど、各検証パスでトークン列をより多くのトークン分進められます。
投機的デコーディングはどのような場合に最も効果がありますか?
コードを繰り返し修正する作業、以前の思考を繰り返す推論モデル、原文の表現を再利用する要約など、続きを予測しやすいワークロードです。こうしたワークロードでは、多くのトークンが連続して受理されます。効果が最も小さいのは、短く、新規性が高く、形式が自由なテキストです。この場合、受理率が低いために、ドラフト生成のオーバーヘッドが利点を上回ることがあります。
先を予測するドラフトを使うと、1トークンずつ生成するより速くなるのはなぜですか?
自己回帰生成を制限するのは、純粋な計算性能ではなくメモリ帯域幅です。トークンごとに、モデル全体の重みをメモリから読み込む必要があります。ドラフト内の複数トークンを1回のバッチ処理パスで検証すれば、1回の重み読み込みを多くのトークンに再利用できるため、正しい予測はほぼ追加コストなしで受理されます。
ドラフトモデルとMulti-Token Prediction (MTP)の違いは何ですか?
ドラフトモデルは、ターゲットモデルと並行して読み込み、実行する必要がある、別の小さなネットワークです。一方、MTPはターゲットモデル自体に予測ヘッドを追加するため、はるかに低いメモリのオーバーヘッドで、1回の順伝播から複数トークンのドラフトを生成できます。ただし、対応するには、その予測ヘッドを組み込んでモデルを学習させる必要があります。
Atomic Chatで投機的デコーディングを設定する必要はありますか?
いいえ。Atomic Chatは、独自に調整された推論エンジンを通じて、Multi-Token PredictionとDFLASHを使い、対応モデルに投機的デコーディングを自動適用します。手動で有効化したり、調整したりする必要はありません。




