TurboQuantで、チャットが6倍長く続く
長いチャットは少しずつメモリを食いつぶし、やがてクラッシュします。TurboQuantはその使用量を6分の1に抑えるので、何時間話しても、大きなドキュメントを放り込んでも、モデルは会話の冒頭を覚えたままです。
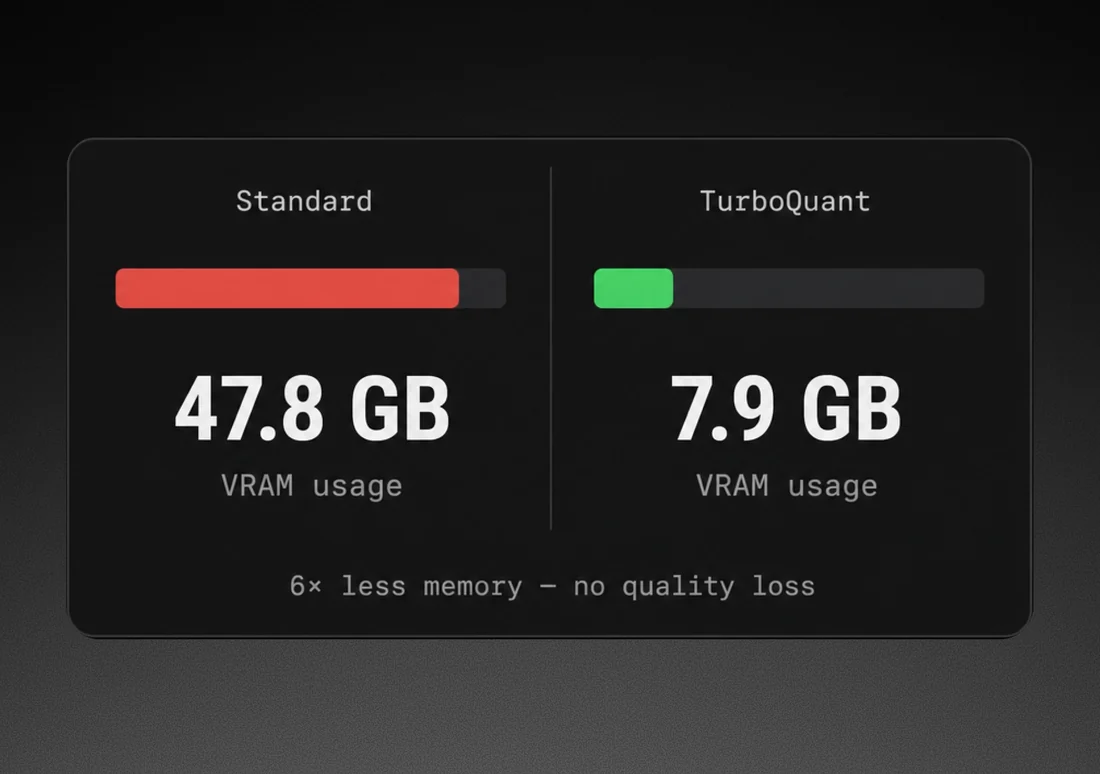
精度の劣化
ローカルで1,000+のモデルを実行


節約したRAMの使いみち
余ったままにはなりません。より大きなモデルに、より長い会話に、あるいはGPUなしでも快適に動くセッションに回せます。
大きなモデルで、より良い回答
大きなモデルほど、難しい問題への回答は鋭くなります。TurboQuantは実行時のメモリを削るので、RAMの上限に達するまでセッションを長く続けられます。
長いコンテキストでも、クラッシュなし
長いドキュメントや何時間もの会話は、これまでセッションをクラッシュさせる原因でした。TurboQuantはコンテキストが増えるそばから圧縮するので、RAMに収まったままです。
CPUで動作。GPUは不要。
データは手元にとどまります。TurboQuantはモデルと同じプロセス内、ローカルで動きます。
TurboQuantの仕組み
長いセッションでRAMを埋めているものと、3ビット圧縮が
精度を落とさずにそれを解決できる理由を説明します。
会話のたびに増えるRAM消費
モデルが返信を生成するとき、KVキャッシュが作られます。
これはセッション内のすべてのトークンの記録です。10,000トークンになると、モデルの重みに加えて数GBが上乗せされることもあります。圧縮しなければ、いずれクラッシュします。TurboQuantはキャッシュが大きくなるそばから各エントリを圧縮するので、セッションは動き続けます。
KV値1つを16ビットから3ビットへ
第1段階では、保存された各値を16ビット浮動小数点から3ビットに変換します。コンパクトですが、これだけでは精度が粗くなります。第2段階では1ビットの補正を加え、圧縮で失われた分を取り戻します。ピーク時のRAMは6分の1になり、出力は変わりません。

コンテキストウィンドウ全体を、
2GB未満に
会話にトークンを足すたびに、KVキャッシュも大きくなります。100kトークンになると、キャッシュだけで使えるRAMを超えることがあります。TurboQuantはこれを最大6分の1まで圧縮し、長いコンテキストのセッションを標準的なハードウェアで実用にします。
Google Researchの論文 →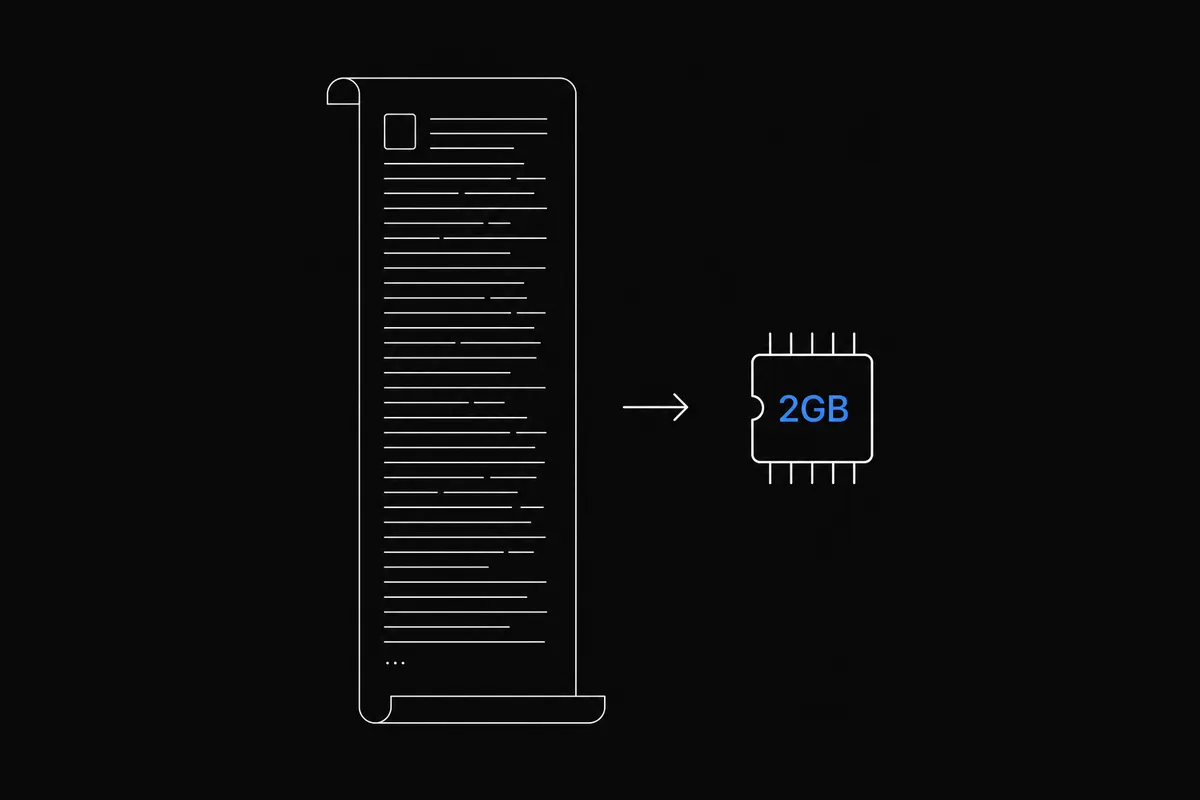
TurboQuantあり vs なし
LM Studio、Ollama、JanはGGUF量子化に対応しています。ただし、KVキャッシュ圧縮を備えたものはありません。その差は、モデルが大きいときやセッションが長引いたときに現れます。

- RAMに収まるモデルなら
どれでも長時間のセッション - RAM 6分の1で128kコンテキスト
- どんなCPUでも動作、GPUは不要
- 5つの標準ベンチマークで精度の劣化ゼロ
- 大きなモデルは使えるRAMを超過
- 長く話すほどセッションが低速化
- RAMが尽きるとセッションがクラッシュ
- RAMを増やすか、モデルを小さくするかの二択

大きなモデルでできること
50ページの契約書を1セッションで分析
ドキュメント全文を貼り付けて、読み進めながら質問できます。第30条までたどり着いても、モデルは第3条を見失いません。
コードベース全体をコンテキストに
数千ファイル規模のプロジェクト全体、コードベースまるごとを渡せます。TurboQuantは増え続けるコンテキストを、速度を落とさずRAMに保ちます。
機密データも、高性能モデルもローカルで
クラウドAPIに渡せないデータもあります。これまでの回避策は、
小さくて性能の低いローカルモデルを使うことでした。TurboQuantは実行時のメモリを抑えるので、性能の高い量子化モデルでもRAMの上限に収まります。
よくある質問
ハードウェアを変えずに、より大きなモデルを動かすために知っておきたいこと
Google Researchが開発し、ICLR 2026で発表されたKVキャッシュ圧縮アルゴリズムです。言語モデルが会話中に使う作業メモリを、1値あたり16ビットから約3ビットに減らします。実行時のRAMは6分の1です。Atomic Chatは、実行するすべてのモデルにこれを自動で適用します。
Q4_K_M形式のGGUFなら、34Bモデルの重みはおよそ20GBです。TurboQuantがKVキャッシュを圧縮した状態なら、24GBのMacBook ProやMacBook Airで問題なく動きます。36GBあればさらに余裕があります。16GBのマシンでは、13Bまでのモデルが快適に動きます。
遅くなりません。TurboQuantがKVキャッシュを圧縮するため、1トークンごとにメモリを流れるデータが減ります。ローカルLLMの主なボトルネックはメモリ帯域なので、応答の速度は変わらないか、むしろ少し速くなります。特に長いチャットで効いてきます。圧縮そのもののコストはほとんどありません。
落ちません。GoogleはGemma、Llama、Mistralを使い、LongBench、Needle-in-Haystack、ZeroSCROLLS、RULER、L-Evalで検証しました。すべてのタスクで、精度は非圧縮のベースラインと区別がつきませんでした。
別のものです。GGUF量子化はディスク上のモデルの重みを圧縮するもので、ファイルを作るときに一度だけ適用されます。TurboQuantはモデルが生成している最中に、実行時のKVキャッシュを圧縮します。解決するボトルネックが異なり、Atomic Chatでは両方が同時に動きます。
設定は何も必要ありません。Atomic Chatは、どのモデルを読み込んでもTurboQuantを自動で適用します。
Atomic Chatで動くモデルはすべて対応しています。Qwen、Gemma、DeepSeek、Llama、Mistralなどです。TurboQuantはモデルの重みを書き換えないので、ダウンロードしたすべてのGGUFモデルに適用されます。
TurboQuantは2段階で動きます。PolarQuantはKVベクトルを極座標に写像し、3ビットに量子化します。QJLはランダム化アダマール変換を使って1ビットの誤り訂正を加えます。単純な3ビット量子化なら出力が目に見えて劣化するところを、この組み合わせでほぼロスレスの圧縮を実現します。
Q4 GGUFの70Bモデルは、重みだけで38〜40GBほど必要です。TurboQuantはその上に乗るKVキャッシュを処理しますが、ベースの重みはRAMに収まる必要があります。70Bには48GB以上のユニファイドメモリが必要です。64GBのマシンなら快適に動きます。
開発はすべてオープンに
プロジェクトをフォローし、Issueを立て、Atomic Chatを作っている人たちと話せます。
ニュースレターを購読
Atomicの最新情報とローカルAIのニュースをメールでお届けします。


