

このガイドで学べること:
- Ornith 1.5の無検閲版とは何か、アブリテレーションによって何が変わったのか
- 各サイズで実行するコミュニティ製ビルドの選び方と、それぞれに必要なハードウェア
- Atomic Chatまたはllama.cppでOrnith 1.5の無検閲版をローカル実行する方法
この記事では無検閲版のビルドを扱います。DeepReinforceのオリジナルの重みについては、Ornith 1.5 9Bをローカルで実行する方法とOrnith 1.5 35Bをローカルで実行する方法のガイドをご覧ください。ローカルで使うコーディングモデルをより幅広く比較している場合は、コーディングにおすすめのローカルLLMのガイドをご覧ください。
Ornith 1.5 Uncensoredとは?
Ornith 1.5 Uncensoredは、DeepReinforceのOrnith 1.5をコミュニティが編集したバージョンです。9Bと35Bのコーディングモデルはそのままに、重みから拒否動作を取り除いています。これらのビルドを公開しているのはDeepReinforceではなく、Hugging Face上の個人です。
DeepReinforceは2026年8月19日、Ornith 1.5 9BとOrnith 1.5 35B-A3BをMITライセンスで公開しました。その後1日以内に、複数の人がモデルに要求を拒否させる重みの部分を編集し、その結果を再公開しました。ライセンスはこれを認めています。このガイドで紹介するビルドはすべて、そのようなコミュニティによる編集版で、それぞれ異なる人が異なる手法で作成しています。
このファミリーには、同じライセンスの第3のタグとして、フラッグシップの397B MoEもあります。397Bのコミュニティ派生版の合計ダウンロード数は194件で、35B-A3Bの103,866件、9Bの53,572件に比べて少ないため、このガイドでは人々が実際に編集して実行した2つのサイズを扱います。
基盤となるモデルは変わっていません:
| 仕様 | Ornith 1.5 9B Uncensored | Ornith 1.5 35B Uncensored |
|---|---|---|
| パラメータ数 | 9Bのデンスモデル | 合計35B、トークンごとに3Bがアクティブ |
| アーキテクチャ | ハイブリッドアテンション、線形アテンション24層 + フルアテンション8層 | ハイブリッドアテンション、線形アテンション30層 + フルアテンション10層、256エキスパートのうち8つがアクティブ |
| 層数 | 32 | 40 |
| コンテキスト長 | 262,144トークン | 262,144トークン |
| モダリティ | テキストと画像の入力 | テキストと画像の入力 |
| 推論 | 思考はデフォルトでオン、オフに切り替え可能 | 思考はデフォルトでオン、オフに切り替え可能 |
| マルチトークン予測 | 上流モデルにはヘッドが存在し、保持の仕方はビルドごとに異なる | 上流モデルにはヘッドが存在し、保持の仕方はビルドごとに異なる |
| ベースモデル | ornith-ai/Ornith-1.5-9B、2026年8月19日 | ornith-ai/Ornith-1.5-35B-A3B、2026年8月19日 |
| ライセンス | MIT、ベースモデルから継承 | MIT、ベースモデルから継承 |
アブリテレーションは重みを編集するもので、モデルを再学習させるものではありません。そのため、パラメータ数、層数、コンテキスト長、メモリ容量の計算はすべてオリジナルから引き継がれます。
モデルには、編集の対象外となる部分が2つあります。1つはビジョンタワーで、ここで紹介するすべてのビルドがこれを変更せずに残しています。Thunder13240はプロジェクターがベースモデルとビット単位で同一だと報告し、PocketAiHubはバージョンを固定した上流のタワーを変更せずに同梱しています。扱いが変わるのはマルチトークン予測ヘッドで、公開者ごとに対応が異なります。PocketAiHubは削除し、dealignaiは保持したうえでアブレーションを施し、gbuzhfはオリジナルのチェックポイントから再移植し、SC117は完全に置き換えています。ビルドのセクションにある表で、それぞれの違いを示します。
アブリテレーションはOrnith 1.5に何をするのか
研究者たちは、多くのアライメント済みモデルにおいて、拒否がモデルの残差ストリーム内の単一の方向に支配されていることを発見しました。残差ストリームとは、層から層へと受け渡される内部状態です。ArditiらはNeurIPS 2024で、重みが公開された13のチャットモデルを対象にこれを示しました。その1つの方向を消すとモデルは有害な指示を拒否しなくなり、加え直すと無害な指示を拒否するようになります。
その方向を見つけるには、対応をそろえた有害なプロンプトと無害なプロンプトの集合でモデルを実行し、活性値を記録して、両者の平均の差を取ります。次に、重み行列をその方向に対して直交化し、モデルがその方向に書き込む能力を恒久的に取り除きます。学習データも勾配降下法も使わないため、Ornith 1.5のアブリテレーション版はオリジナルから数週間後ではなく、1日以内に登場しました。
モデルやツールチェーンを横断して手法そのものを知りたい場合は、アブリテレーション済みモデルとは何かの解説をご覧ください。より広いビルドのカテゴリーについては、ローカルで実行するのにおすすめの無検閲LLMのまとめをご覧ください。別のモデルに同じ編集を施した例は、Qwen 3.8 27Bの無検閲版をローカルで実行する方法で紹介しています。ここからはOrnith 1.5固有の内容を扱います。このモデルには、編集の挙動とその測定方法を変える2つの特徴があるためです。
abliterated、uncensored、それとも別の呼び方?
abliteratedは手法を、uncensoredは結果を表す言葉です。uncensoredには、追加の指示データで学習することで同じ結果に到達したDolphinやHermesのようなモデルも含まれるため、一般にこの2語は同義ではありません。Ornith 1.5では、このガイドのすべてのビルドがファインチューニングではなく重みの編集で作られているため、たまたま同じファイルを指しています。
公開者の間で用語が統一されていないため、リポジトリは本来必要な以上に探しにくくなっています。mradermacher、junafinity、zaakirioは自分たちのビルドにuncensoredというラベルを付けています。huihui-ai、PocketAiHub、alztrk、codecraftersllcはabliteratedと表記しています。dealignaiは手法をCRACKと呼び、ファイル名にはどちらの単語も使っていません。Hugging Faceで片方の用語だけを検索すると、もう片方の大半を見落とします。
ablatedという表記や、誤用であるobliteratedという表記も見かけます。どちらも同じ技法を指しています。abliterationは、Arditiらがdirectional ablationと呼んだ手法に対してコミュニティが作った造語で、同論文には登場しません。
推論モデルでは通常の拒否テストが通用しない理由
Ornith 1.5は各回答を思考ブロックから始め、チャットテンプレートは生成用プロンプトをそのブロックの前ではなく、中で終えます。アブリテレーションツールはモデルの応答開始時点で活性値をサンプリングするため、このモデルでは推論の開始時点でサンプリングします。そこで得られる方向は、拒否しようとしているモデルではなく、拒否について考えようとしているモデルを表しており、両者は異なる特徴です。
Thunder13240は、その影響を記録しています。思考ブロック内でサンプリングした場合、200試行の探索と13通りの設定による検証でも、拒否数を100件中およそ22件より下げられず、アブレーションの強度を上げても拒否数は変わらないまま能力が損なわれました。方向を計算する前に応答プレフィックスを\n</think>\n\nに設定してブロックを閉じると、同じ設定で拒否数が100件中22件から0件になり、KLダイバージェンスも低下しました。
自分でツールを実行する場合、この診断方法は知っておく価値があります。Ornith 1.5 9Bは、思考ブロック内のテキストを採点すると拒否が100件中67件ですが、回答を採点すると100件中99件になります。安全性を調整したモデルなのに、検閲されている割合が3分の2程度と測定される場合は、採点対象のテキストを間違えている兆候です。
これが、次のセクションの拒否数を互いに直接比較できない理由でもあります。これらの測定すべてにおいて、思考モードは単独で最も大きな変動要因ですが、ほとんどの公開者は使用したモードを明記していません。
編集による代償
重み空間で見ると、編集は小規模です。gbuzhfはwikitext-2を使ってアブリテレーション済み35BとオリジナルのBF16の重みを比較し、平均KLダイバージェンスが0.0151、最上位トークンの一致率が95.04パーセントと報告しています。これはモデルをQ6_Kに量子化するよりも小さな変化です。Thunder13240は9Bで0.0376と報告しており、示されている損傷のしきい値は約0.5です。また、760個のテンソルのうち変更されたのは43個で、すべてテキストデコーダー内にあります。
dealignaiは、アブリテレーション前のベースモデルと同じ量子化でMMLUを採点した唯一の公開者です。これにより、編集の影響を量子化の影響から切り分けています:
| 量子化 | ベースモデルのMMLU | 編集後のMMLU | 変化 |
|---|---|---|---|
| Q8_0 | 79.0 | 80.7 | +1.7 |
| Q6_K | 78.6 | 79.0 | +0.4 |
| Q5_K_M | 80.7 | 80.1 | -0.6 |
| Q4_K_M | 80.0 | 77.8 | -2.2 |
| Q3_K_M | 76.0 | 78.4 | +2.4 |
| Q2_K | 77.9 | 69.8 | -8.1 |
3ビットを超える量子化では差がプラスにもマイナスにも振れており、これは単一のベンチマークで、編集の影響がノイズフロア内に収まっている場合の見え方です。Q2_Kではモデルが8ポイント低下しており、真剣に受け止めるべきなのはこの行です。これらのビルドについて、数学、コード、多言語、画像理解の数値を公開した人はいません。
これらのリポジトリには、実際より悪く見える数値が1つあります。Ornith 1.5では重みに何をしても最上位トークンの一致率が低めに出るため、90パーセントというスコアのビルドが損傷しているわけではありません。Thunder13240が対照実験を行ったところ、同じ評価環境で量子化した未編集のベースモデルは88.93パーセント、アブリテレーション版は90.81、DeepReinforce自身のQ4_K_Mは91.29でした。これらのファイルはKLダイバージェンスで判断してください。
この編集が何を取り除くかについては異論がありません。過剰な拒否と安全性のための拒否は、重みの中では同じ方向です。一方を取り除くともう一方もなくなるため、この分野のすべてのモデルカードには責任に関する条項が付いています。今や、処理の中で唯一のガードレールとなるのはあなた自身です。
Ornith 1.5の無検閲版はどのビルドを実行すべきか?
少なくとも12人がOrnith 1.5の無検閲版を公開し、それを再パッケージ化した人もいます。ダウンロードする価値があるのは5つで、理由はそれぞれ異なります。
| ビルド | サイズ | 手法 | 提供されている量子化 | 画像理解 | MTP |
|---|---|---|---|---|---|
| Thunder13240 | 9B | Heretic、サンプリング位置を修正 | 10種類を公開中、IQ1_SからQ4_K_M | 同梱、f16 | 元の重みに存在しない |
| mradermacher | 9B | 記載なし、junafinityの重みから量子化 | 12ファイル、Q2_Kからf16 | 同梱、Q8_0とf16 | 記載なし |
| PocketAiHub | 35B | 拒否方向の射影、第15層から第39層 | 3ファイル、Q4_K_MからBF16 | 同梱、f16 | 削除 |
| dealignai | 35B | CRACK、アテンション経路への外科的処置 | 6ファイル、Q2_KからQ8_0 | 同梱、f16 | 保持してアブレーションを実施 |
| gbuzhf | 35B | PocketAiHubの編集版を再量子化 | 9ファイル、14.4から30.2 GB | 未配布、PocketAiHubのものを使用 | オリジナルから再移植 |
9Bのビルド
何が得られるのかを把握したうえでダウンロードしたいなら、Thunder13240です。手法、測定結果、未変更のベースモデルとの対照実験をモデルカードに公開している唯一のOrnith 1.5ビルドです。オリジナルが100件中99件を拒否するのに対し、実際の拒否は100件中0件で、20のプロンプト群すべてで一様にこの結果となり、KLダイバージェンスは0.0376と報告しています。モデルカードには、上で説明した思考ブロックの問題も記録されており、その対処がこの結果につながりました。
難点は量子化のラインアップです。低速な接続で数時間かけて順次アップロードされており、現時点で公開されている最も高精度な量子化は5.6 GBのQ4_K_Mです。10ファイルが公開されていますが、大半は1ビットと2ビットです。Q8_0、Q6_K、Q5_K_M、IQ4_XS、Q4_K_Sは作成済みでアップロード待ちです。特定のファイルを前提に計画する前に、リポジトリを確認してください。
モデルカードには、自分でハイブリッドモデルを量子化する場合に知っておく価値のある改善も記載されています。llama.cpp標準のQ4_K_M設定では、再帰状態に入力を渡す射影を、基本の4ビット精度で量子化します。その72個のテンソルをQ8_0で保護すると、最上位トークンの一致率が90.81から92.97パーセントに上がり、DeepReinforce自身のビルドを上回ります。
mradermacherなら、すべての段階の量子化がそろっています。3.8 GBのQ2_Kから17.9 GBのf16まで12種類の量子化と、2つのプロジェクターファイルがあり、リポジトリのダウンロード数もそれに見合うものです。一方、編集に関する説明は一切ありません。モデルカードには手法の記載がなく、自ら編集したものではなくjunafinityの重みを量子化しています。Thunder13240がまだアップロードしていない特定のファイルサイズが必要な場合に選び、動作は自分でテストしてください。
35B-A3Bのビルド
PocketAiHubは、3つの中で最も慎重に測定されています。JailbreakBenchの有害なプロンプト100件と無害なプロンプト100件を、思考を無効にした各量子化モデルで実行し、フレーズ検出器で判定したうえで手作業で確認しています。Q4_K_Mの拒否は100件中3件、Q8_0は1件で、無害なプロンプト集合ではどちらも拒否はありません。モデルカードには独自のBF16に対する量子化ごとのKLダイバージェンスが公開されており、Q4_K_Mでは0.0728、Q8_0では0.0136です。制約は、テキスト用ファイルが3つしかない量子化のラインアップと、このビルドには含まれない予測ヘッドです。
dealignaiは、PocketAiHubが提供していないサイズをカバーします。13.2 GBのQ2_Kから37.8 GBのQ8_0まで6種類の量子化があり、8ビット未満のファイルには重要度行列と活性値を考慮した処理の両方が適用され、すべてのファイルで予測ヘッドが保持されています。能力の評価表がある唯一の35Bビルドです。最も弱い部分は拒否の数値です。HarmBenchの240の行動に対して攻撃成功率100パーセントという結果は良く見えますが、応答を成功と数える判定基準がモデルカードにまったく書かれていません。
投機的デコーディングを使いたいなら、gbuzhfが候補です。PocketAiHubのアブリテレーション済みの重みに、オリジナルのチェックポイントから予測ヘッドを再移植しています。14.4から30.2 GBまで9段階があり、すべてでKLダイバージェンスと最上位トークンの一致率が測定され、22.8 GBの段階ではドラフト受理率が96.77パーセントです。アブリテレーションはgbuzhfではなくPocketAiHubによるもので、本体には施されている一方、移植したドラフトヘッドには施されていないと、モデルカードに明記されています。プロジェクターはここでは再配布されていないため、PocketAiHubからダウンロードしてください。そうしないと、モデルは画像を認識できません。
表には載せませんが、もう1つ紹介する価値のあるビルドがあります。SC117は35BにHereticを適用し、探索ログでは拒否が100件中9件、エクスポート後の再採点では100件中11件、KLダイバージェンスは0.0105と報告しています。また、付属のヘッドがランダム初期化と一致するという理由から、オリジナルを移植するのではなく予測ヘッドを置き換えています。4段階のAPEXについては、モデルカードを読む価値があります。26.1 GBのI-Balancedが23.5 GBのI-Qualityより大きいためです。これらの段階はファイルサイズを順番に小さくするのではなく、テンソルごとにビット数を割り当てるので、ここでは大きいファイルのほうが優れているわけではありません。
Heretic自体も2つのサイズで挙動が異なりますが、どちらのモデルカードもそれに触れていません。デンスモデルの9Bでは、アテンションとMLPのダウンプロジェクションにアクセスでき、対応範囲をすべてカバーします。35Bではエキスパートがモジュールのリストではなく1つの融合テンソルとして保存されているため、それらを編集するループで発生したエラーが握りつぶされ、警告なしでアテンションだけを対象に処理が続行されます。これを修正する2つの試みはマージされずにクローズされており、メンテナーは、いずれにせよMLPに手を加えるほうが通常は損傷が大きいという立場です。それでもSC117のモデルカードはダウンプロジェクションを編集したと主張していますが、リポジトリにはそれを照合できる実行ログが公開されていません。
拒否数を直接比較できない理由
これらの公開者のうち4者が拒否に関する数値を報告しています。同じものを測定した組み合わせは1つもありません。
| ビルド | モデルカードの報告内容 | プロンプト集合 | 判定方法 | 思考 |
|---|---|---|---|---|
| Thunder13240 (9B) | 拒否は100件中0件、ベースモデルは99件 | 評価用に取り分けたプロンプト100件 | 記載なし | 記載なし |
| PocketAiHub (35B) | 拒否は100件中Q4_K_Mで3件、Q8_0で1件 | JailbreakBench、有害100件、無害100件 | フレーズ検出器で判定し、手作業で確認 | オフ |
| SC117 (35B) | 拒否は100件中9件、エクスポート後は11件 | Heretic独自の有害プロンプト集合 | 記載なし | 記載なし |
| dealignai (35B) | 攻撃成功率100パーセント、Q2_Kでは99.6 | HarmBench、240の行動 | 記載なし | 記載なし |
各行では、プロンプト集合、プロンプト数、回答を拒否と数える判定基準、モデルが思考していたかどうかが異なります。冒頭で警告した後に要求どおりの内容を返す応答は、ある公開者の検出器では拒否、別の公開者の検出器では要求への対応と判定されます。4者のうち思考モードを明記しているのは1者だけですが、推論モデルではこの設定が数値を最も大きく動かします。SC117の2つの数値は同じビルドのもので、採点したタイミングによって2ポイント異なっています。
mradermacher、huihui-ai、alztrkを表に載せていないのは、拒否に関する数値を一切公開していないためです。それ自体が1つの答えでもあります。
拒否率が表しているのは、ある公開者が自分のプロンプトと検出器で行った独自のテストです。ビルドを頼りにする前に、自分のプロンプトで試してください。その際は思考をオフにし、推論ではなく回答を採点するようにしてください。
量子化すると拒否が戻るのか?
戻りません。ある公開者が確認しています。gbuzhfは全段階をアブリテレーション済みBF16とオリジナルのBF16の両方に対して測定し、どの段階でもアブリテレーションは元に戻らないと報告しています。14.4 GBの段階に至るまで、すべてのサイズでオリジナルの重みからの距離が、アブリテレーション自体による距離0.0151を上回ったままです。また、2種類の損傷を合わせた影響は、それぞれを単純に足した値を大きく下回ることも分かっています。そのため、編集済みモデルを量子化する代償は、2つの影響を足し合わせて予想するより小さくなります。
低ビット量子化が影響するのは、それ以外のすべてです。gbuzhf自身のラインアップでは、平均KLダイバージェンスが30.2 GBの段階で0.0222だったものから14.4 GBでは0.2546に上がり、最上位トークンの一致率は94.05から80.70パーセントに低下しています。また、dealignaiのMMLU列ではQ2_Kで8ポイント低下しています。拒否の境界は編集済みモデルの中で最も不安定な特性ですが、4ビット未満でこれを測定しているリポジトリはdealignaiだけです。その報告ではQ3_K_MとQ2_KでもQ8_0と同じくほぼすべての要求に対応していますが、応答を対応済みと数える判定基準は示されていません。挙動は4ビット以上のビルドで判断してください。
Ornith 1.5無検閲版のハードウェア要件
確認すべきシステム要件はメモリです。Apple Siliconでは、以下の数値を統合メモリの75パーセントと比較してください。macOSがデフォルトでモデルに割り当てるのは、その容量までです。
9Bのサイズは、このサイズで唯一すべての段階がそろっているmradermacherのラインアップを基にしています:
| 使用可能メモリ | 推奨量子化 | 標準的なサイズ | 残る余裕 |
|---|---|---|---|
| 6 GB | Q3_K_M | 4.6 GB | 約8Kのコンテキスト |
| 8 GB | Q4_K_M | 5.6 GB | 約32Kのコンテキスト |
| 12 GB | Q5_K_M | 6.5 GB | 約128Kのコンテキスト |
| 16 GB | Q6_K | 7.4 GB | 長いコンテキストでも余裕あり |
| 24 GB以上 | Q8_0 | 9.5 GB | 最大262Kのコンテキスト全体 |
35Bの各段階は異なる公開者のものなので、それぞれにビルド名を記載しています:
| 使用可能メモリ | 推奨ビルド | ファイルサイズ |
|---|---|---|
| 16 GB | CRACK-Q2_K、dealignai | 13.2 GB |
| 20 GB | MTPv2-19G-ICE、gbuzhf | 18.8 GB |
| 24 GB | Q4_K_M、PocketAiHub | 21.2 GB |
| 32 GB | MTPv2-25G-ICE、gbuzhf | 24.9 GB |
| 48 GB以上 | CRACK-Q8_0、dealignai | 37.8 GB |
注:隣り合う2つのファイルで迷い、どちらもメモリに収まるなら、大きいほうを選んでください。必要容量は1、2ギガバイト増えますが、誤ったトークンを選ぶ頻度が目に見えて減ります。特に、品質が最も急激に落ちるラインアップの下位ではその差が大きくなります。
容量の小さいカードでは、35Bには9Bにない選択肢があります。小さいファイルに落とす代わりに、エキスパートをシステムRAMに置く方法です。エキスパートは重みの大半を占めますが、トークンごとに実行されるのはそのうち3Bだけなので、計算負荷を低く保ちながら、帯域幅の負担をRAMに移せます。同じトレードオフにより、DeepSeek V4 Flashもデスクトップのハードウェアで実用的に動かせます。llama.cppでは、--cpu-moeですべてのエキスパートをCPUに配置し、--n-cpu-moe Nで最初のN層のエキスパートをオフロードします。ダウンロードを計画する際は、ファイル全体のサイズをRAMとVRAMの合計容量と照合してください。
コンテキスト長によってメモリはどれだけ増えるのか?
上の数値はモデルの重みだけを対象にしています。エンジンはそれに加えてKVキャッシュを確保します。チャットが長くなるほどモデルがメモリ内に保持するコンテキストが増え、必要な容量も増えます。大きな文書やコードベースを会話に貼り付ける場合も同じです。
従来のデンスTransformerなら、9Bの全32層がすべてのトークンについてアテンションデータを保存します。このモデルでは32層のうち24層が固定サイズの状態を持つ線形アテンションを使い、フルアテンションを使う8層もKVヘッドはわずか4つです。オリジナルの重みを使った私たちのビルドで測定したところ、モデルはトークンあたり32 KBのアテンションキャッシュを保持します:
| コンテキスト長 | アテンションキャッシュ |
|---|---|
| 8K(一般的なチャット) | 約0.25 GB |
| 32K(長い文書) | 約1 GB |
| 128K(大規模なコードベース) | 約4 GB |
| 262K(ネイティブの最大コンテキスト長) | 約8.4 GB |
アブリテレーションはアテンションの構成に手を加えないため、これらの数値は編集済みビルドにもそのまま当てはまります。最大262Kのコンテキスト全体とQ8_0ファイルは、合わせて約18 GBになるため、24 GBのカードに収まります。
Ornith 1.5の無検閲版を実行できるハードウェアは?
- 8 GB GPU(RTX 3060 Ti、RTX 4060):4ビットの9BをすべてVRAM内で実行でき、約32Kのコンテキスト用の余裕があります。
- 12 GB GPU(RTX 3060 12 GB、RTX 4070):5ビットの9Bを128Kのコンテキスト用の余裕を残して実行するか、エキスパートをシステムRAMに置いて4ビットの35Bを提供できます。
- 16 GB GPU(RTX 4060 Ti 16 GB、RTX 5060 Ti):9BをQ6_Kで実行するか、35Bの最小の段階をすべてVRAM内で実行できます。
- 24 GB GPU(RTX 3090、RTX 4090):PocketAiHubの21.2 GBのQ4_K_MをすべてVRAM内で実行するか、9BをQ8_0で最大コンテキスト長まで使って実行できます。
- RTX 5090(32 GB VRAM):gbuzhfの24.9 GBの段階をコンテキスト用の余裕を残して実行でき、この段階では35Bの挙動が最もオリジナルに近くなります。
- MacBook Pro(16 GB統合メモリ):4ビットの9Bを実行できます。macOSはデフォルトでGPUが使用できるメモリを統合メモリの約75パーセントに制限するため、16 GBのMacではモデルが使えるのは約12 GBです。
- Mac Studio、MacBook Pro M4/M5 Max(32-64 GB):35Bの各段階を実行でき、GGUFの代わりにMLXビルドを試す価値があるのはこのクラスです。PocketAiHubは4ビット、8ビット、BF16のMLXを提供しています。形式の選択に迷っている場合は、GGUFとMLXの比較ガイドをご覧ください。
- スマートフォン:実行できません。スマートフォンで動くモデルについては、無検閲LLMのまとめにある小型モデルをご覧ください。
Atomic ChatでOrnith 1.5の無検閲版をローカル実行する方法
Atomic Chatは、私たちが開発した無料のオープンソースのローカルAIアプリです。Hugging Faceのモデルブラウザーとチャット機能を内蔵しており、llama.cppを手動でビルドする必要はありません。
Atomic ChatでOrnith 1.5の無検閲版を実行する手順は次のとおりです:
ステップ1:Atomic Chatをインストールする
atomic.chatからAtomic Chatをダウンロードし、使用するプラットフォーム向けのビルドをインストールします:
- macOS:ユニバーサル.dmg(IntelとApple Silicon)、macOS 13.6以降
- Windows:x64向けの.exeインストーラー
- Linux:root権限が不要な、x86_64向けの自己完結型.AppImage
- iOS:App Storeから
- Android:Google Playから
Linuxでは、chmod +xでAppImageに実行権限を付け、直接実行します。初回起動時にアプリからFUSEについて求められた場合は、DebianまたはUbuntuではsudo apt install fuse libfuse2、Fedoraではsudo dnf install fuse fuse-libsでインストールしてください。
ステップ2:Ornith 1.5無検閲版のGGUFを探す
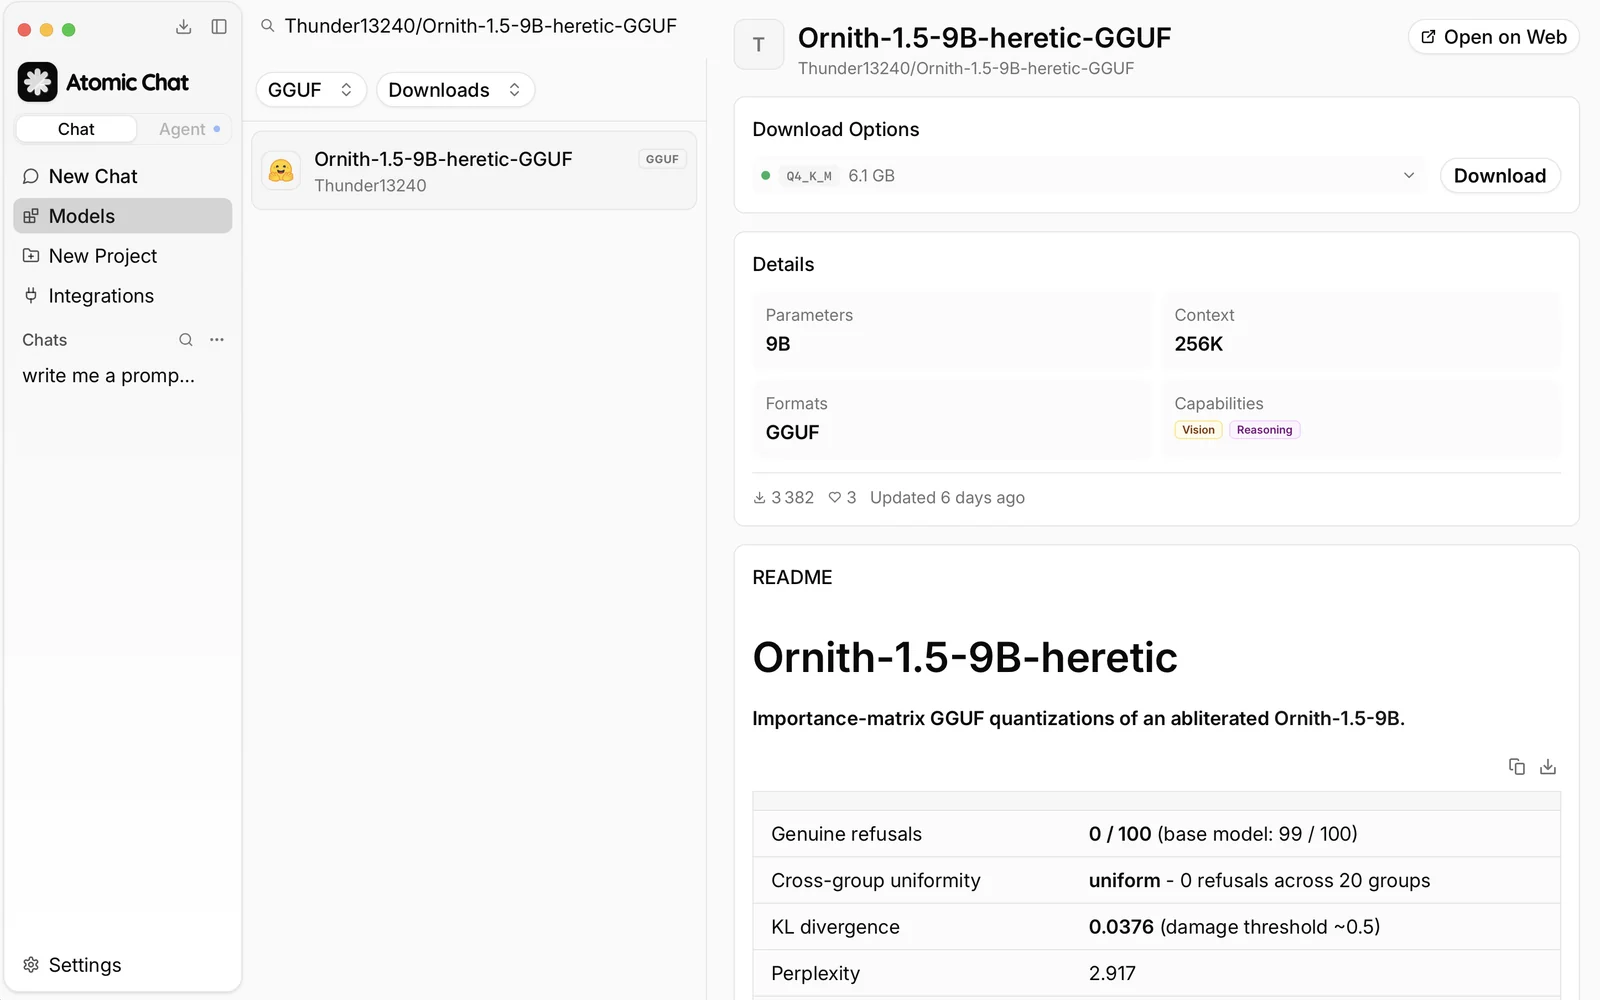
Modelsタブを開き、ビルドのセクションで選んだリポジトリを検索します。例えば次のものです:
Thunder13240/Ornith-1.5-9B-heretic-GGUF
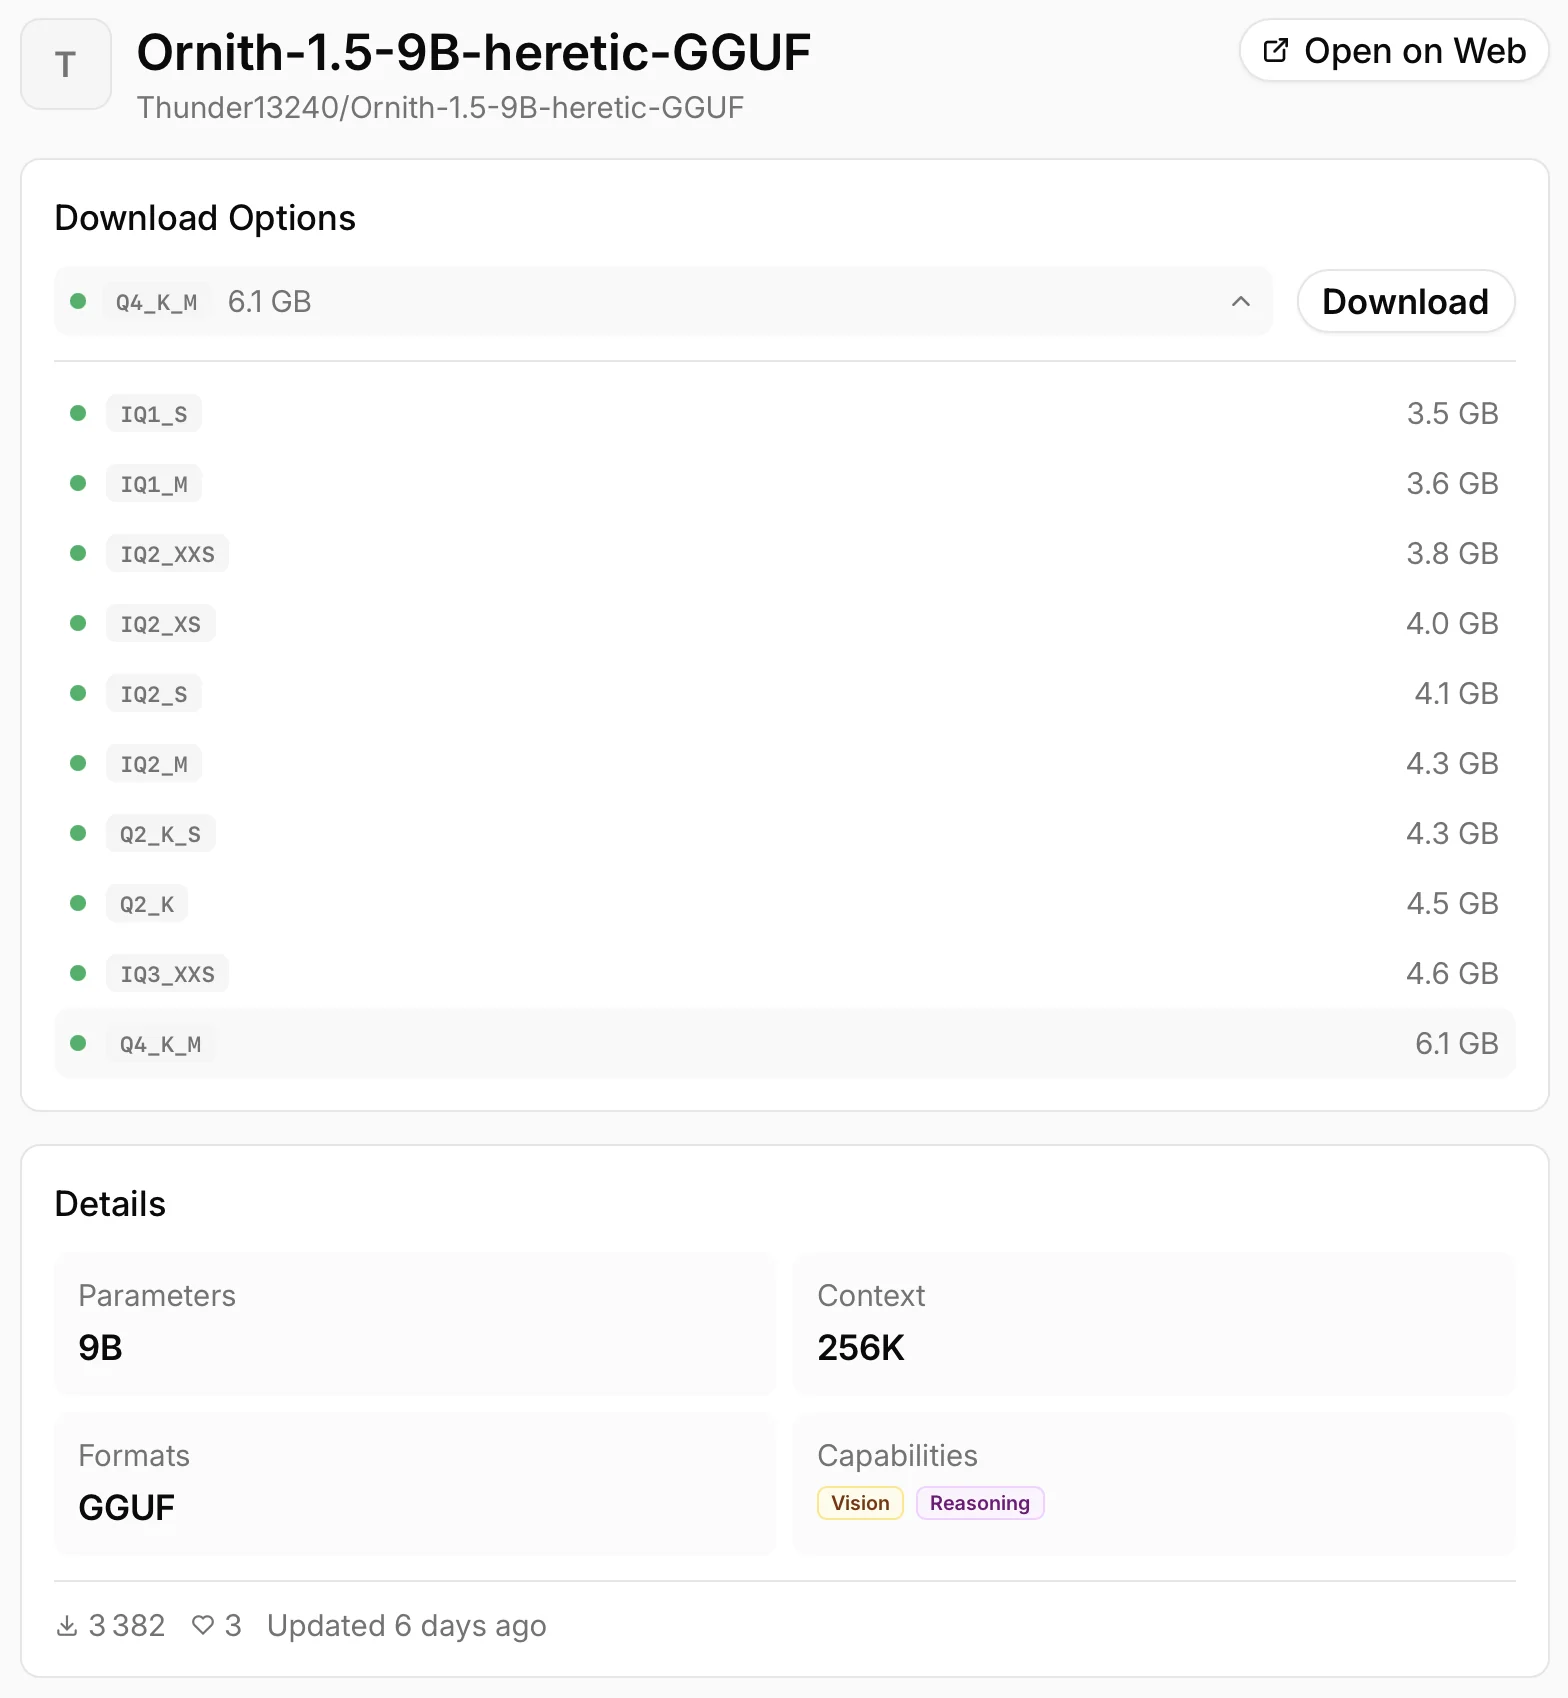
カタログはHugging Faceを利用しているため、公式リポジトリと並んでコミュニティのリポジトリも表示されます。ダウンロードする前に検索結果の公開者名を確認し、Download Optionsの選択メニューを展開して、利用できる量子化を一覧表示してください。
注:ほぼ同じ名前のリポジトリが複数あり、少なくとも1つのモデルカードは、すでにリポジトリに存在しないファイルを説明しています。ダウンロード前に確認すべき点は、トラブルシューティングのセクションをご覧ください。
ステップ3:メモリに合う量子化を選ぶ
上のハードウェア表を使ってください。特に一般的な構成では、次のものを選びます:
- 8 GB GPU:9BのQ4_K_M、5.6 GBをダウンロードします。
- 24 GB GPU:PocketAiHubの35B Q4_K_M、21.2 GBをダウンロードします。
- 32 GB以上:gbuzhfの25G-ICE、24.9 GBをダウンロードします。
選択メニューには、リポジトリ内のすべての量子化が短いタグ名で小さい順に表示され、ビジョンプロジェクターはその一覧から除外されます。表示される数値は表のファイルサイズより少し大きいため、横の数値ではなく量子化名でビルドを照合してください。コンテキスト用の余裕を残して収まる最大の量子化を選びます。量子化名の意味が分からない場合は、GGUFとは何か、量子化はどう機能するのかのガイドをご覧ください。
ステップ4:コンテキスト、思考、サンプリングを設定する
モデルは262Kのコンテキスト長を宣言していますが、最大値に設定するとKVキャッシュがあらかじめ確保されます。チャットでは8,192トークン、コードや文書の作業では32,768トークンから始め、処理内容に必要な場合だけ増やしてください。
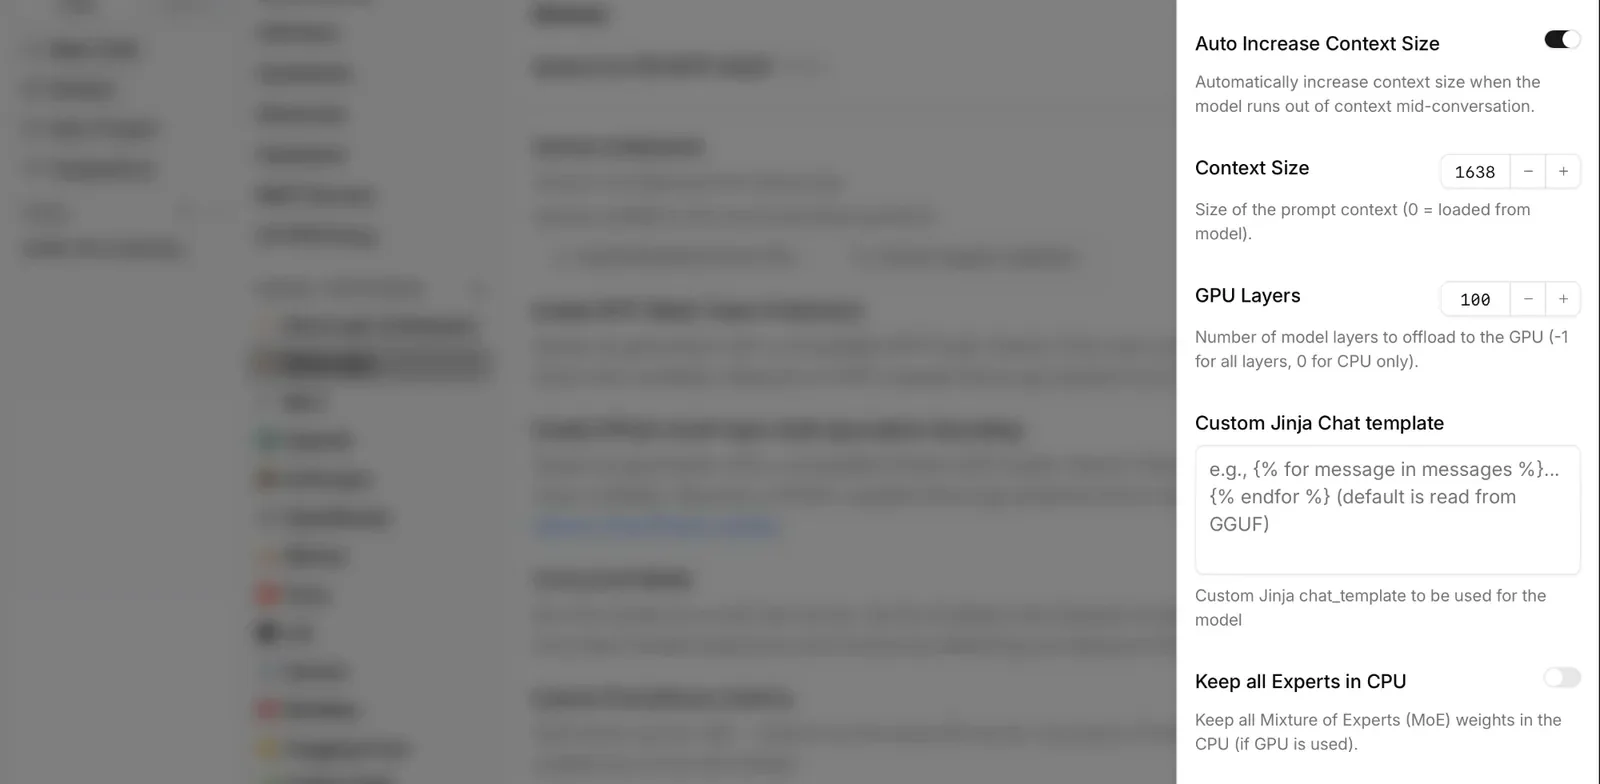
コンテキストサイズはモデル固有の設定にあります。Settings → Model Providers → Llama.cppを開き、モデル一覧で対象のビルドを見つけ、その行の歯車アイコンをクリックします。そこで3つの項目を設定します:
- Context Size:8192または32768に設定します。値が0の場合はGGUFから最大値を読み取るため、このモデルでは262Kのコンテキスト全体を使うことになります。
- Auto Increase Context Size:デフォルトでオンです。会話がコンテキストに収まらなくなるとサイズを増やすため、ぎりぎり収まっていたビルドがメモリ上限を超えることがあります。上限に近い状態で使う場合はオフにしてください。
- GPU Layers:-1にするとすべての層をオフロードします。ファイルがVRAMに収まる場合に適した設定です。
Context SizeまたはGPU Layersを変更するとモデルが再起動するため、長い会話を始める前に設定してください。
思考はデフォルトでオンです。チャット内の電球アイコンでオフに切り替えます。オフにすると推論ではなく回答を採点でき、ここで紹介した中でモードが明記されている唯一の拒否測定値も、PocketAiHubがこの方法で取得したものです。
サンプリングは別のパネルにあります。チャット上部のモデル名の横にあるスライダーアイコンをクリックしてください。DeepReinforceの推奨値はオリジナルの重みから引き継がれます。一般的な作業ではtemperature 1.0、top_p 0.95、top_k 20、presence penalty 1.5、コーディングではtemperature 0.6です。これらの設定はモデルではなく、チャットのプロファイルであるアシスタントに保存されるため、モデルを切り替えても変わりません。
ステップ5:ローカルでチャットする
ダウンロードが完了すると、Atomic Chatがモデルを読み込み、内蔵チャットで開きます。オリジナルが拒否するプロンプトを送り、ダウンロードしたビルドが編集版であることを確認してください。
どちらのサイズもネイティブの視覚言語モデルで、ビジョンタワーはアブリテレーション後も保持されています。そのため、同じリポジトリにある別ファイルのプロジェクターを量子化ファイルの隣に配置すれば、チャットに画像を添付して質問できます。画像、重み、プロンプトはあなたのマシン内にとどまります。
Atomic Chatは、http://localhost:1337/v1でOpenAI互換APIサーバーも公開します。Claude CodeやClineのようなコーディングエージェントを含め、OpenAI APIに対応したツールなら、クラウドモデルを置き換える形でローカルモデルを使えます。
llama.cppでOrnith 1.5の無検閲版を実行する方法
次のものが必要なら、llama.cppでモデルを直接実行するほうが適しているかもしれません:
- フラグでホストとポートを設定し、ヘッドレスで起動できるサーバー
- GPUオフロードの細かな制御。35BでエキスパートをシステムRAMに置く場合に必要です
- 再現可能なサーバー構成
これらのビルドはオリジナルと同じハイブリッドアーキテクチャを使っています。Ornith 1.5はこれをQwen 3.5から継承しており、上流のllama.cppは2026年2月にPR #19468がリリースされて以来、デンスモデルの9Bと混合エキスパートモデルの35Bの両方を、画像処理経路も含めてサポートしています。最新のビルドなら、パッチなしで実行できます。
ステップ1:最新のllama.cppをビルドする
NVIDIA CUDAの場合:
git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp
cmake -B build -DCMAKE_BUILD_TYPE=Release -DGGML_CUDA=ON
cmake --build build -j --target llama-cli llama-server llama-mtmd-cli
Apple Siliconでは、Metalがデフォルトで有効です:
cmake -B build -DCMAKE_BUILD_TYPE=Release
cmake --build build -j --target llama-cli llama-server llama-mtmd-cli
ステップ2:モデルを実行する
次のコマンドは、Hugging Faceから9BのQ4_K_Mをダウンロードし、すべての層をGPUにオフロードし、DeepReinforce推奨のサンプリング設定を適用して、コンテキスト長を8Kに制限します:
./build/bin/llama-cli \
  -hf Thunder13240/Ornith-1.5-9B-heretic-GGUF:Q4_K_M \
  --jinja \
  --temp 1.0 --top-p 0.95 --top-k 20 --presence-penalty 1.5 \
  -ngl 99 \
  -c 8192
24 GBのカードで35Bを使う場合は、代わりにPocketAiHubを指定します:
./build/bin/llama-cli \
  -hf PocketAiHub/Ornith-1.5-35B-A3B-Abliterated-GGUF:Q4_K_M \
  --jinja \
  --temp 1.0 --top-p 0.95 --top-k 20 \
  -ngl 99 \
  -c 8192
容量の小さいカードでエキスパートをシステムRAMに置くには、2つ目のコマンドに--cpu-moeを追加します。最初の20層のエキスパートだけをオフロードするには、--n-cpu-moe 20を追加します。
ステップ3:ローカルのOpenAI互換APIを公開する
llama-cliをllama-serverに置き換えます:
./build/bin/llama-server \
  -hf PocketAiHub/Ornith-1.5-35B-A3B-Abliterated-GGUF:Q4_K_M \
  --alias ornith-1.5-uncensored \
  --jinja --reasoning-format deepseek \
  --temp 1.0 --top-p 0.95 --top-k 20 \
  -ngl 99 \
  -c 8192 \
  --host 127.0.0.1 --port 8080
次のコマンドでテストします:
curl http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
-d '{ "model": "ornith-1.5-uncensored", "messages": [ { "role": "user", "content": "Summarize what linear attention changes about memory use." } ] }'ネットワーク上のほかのマシンからアクセスする必要がなければ、サーバーを127.0.0.1にバインドしてください。--reasoning-format deepseekフラグは、応答内で思考ブロックと回答を分離し、アプリケーションの出力に推論内容が混ざらないようにします。
llama.cppで画像理解を実行する
画像入力には追加のファイルとしてビジョンプロジェクターが必要です。リポジトリ内のすべての量子化で共通して使われ、サイズは約0.9 GBです。一度ダウンロードし、選んだ量子化ファイルと一緒に指定してください:
./build/bin/llama-mtmd-cli \
  -m Ornith-1.5-9B-heretic-Q4_K_M.gguf \
  --mmproj mmproj-Ornith-1.5-9B-heretic-f16.gguf \
  --image your-photo.jpg --image-min-tokens 1024 \
  -ngl 99 -c 8192 \
  -p "What is in this image?"
--image-min-tokens 1024は残してください。これがないと、グラフやスクリーンショットに割り当てられる視覚トークンが少なすぎます。プロジェクターファイルの名前はリポジトリごとに異なるため、上のファイル名をコピーする前に、使用するリポジトリのファイル一覧を確認してください。gbuzhfのリポジトリにはプロジェクターがありません。各段階の本体はPocketAiHubのものを基にしているため、PocketAiHubのプロジェクターを使ってください。
MTPヘッドを使った投機的デコーディング
オリジナルのチェックポイントには、投機的デコーディングを支える仕組みであるマルチトークン予測ヘッドが含まれています。これを保持したビルドでは、メインモデルに先行して次のトークンをドラフト生成できます。次のフラグを追加してください:
./build/bin/llama-server \
  -m Ornith-1.5-35B-A3B-Abliterated-MTPv2-23G-ICE.gguf \
  --spec-type draft-mtp --spec-draft-n-max 1 \
  -ngl 99 -c 8192
ヘッドを備えているのは一部のビルドだけです。gbuzhfはオリジナルのチェックポイントから移植し、22.8 GBの段階で96.77パーセントのドラフト受理率を測定しています。dealignaiはオリジナルを保持してアブレーションを施しています。PocketAiHubは削除しているため、これらのフラグを指定しても何も起きません。古いllama.cppのビルドは、これらのファイルを読み込んでも予測テンソルを通知なしで無視するため、高速化が見られない場合はまず更新してください。gbuzhfのビルドでは、本体にはアブリテレーションが施されている一方、ドラフトトークンはアブリテレーションされていないヘッドから生成されるとモデルカードに記載されています。それでも、すべてのドラフトトークンはモデル自体によって検証されるため、出力品質には影響しません。
OllamaまたはLM Studioで実行する
35Bの無検閲版には、Ollamaタグを持つビルドが2つあります:
ollama run codecraftersllc/ornith-1.5-35b-a3b-abliterated
ollama run aratan/Ornith-1.5-35B-A3B-Uncensored-GGUF:Q4_K_M
1つ目は、Q3_K_Mファイルとビジョンプロジェクターを合わせて18 GBダウンロードし、Qwen 3.5のレンダラー、32Kのコンテキスト、DeepReinforceのコーディング向けサンプリング設定を適用します。2つ目はQ4_K_Mで22 GBをダウンロードし、レンダラーを設定しないため、ツール呼び出しの挙動が異なります。1つ目の:latestと:q3_k_mは、異なる2段階の量子化ではなく、同じファイルを指す点に注意してください。
9Bの無検閲版にはOllamaタグがありません。huihui-aiはHugging Faceで両サイズのOrnith 1.5のアブリテレーション済みの重みを公開していますが、どちらもOllamaには公開していないため、通常の1コマンドで実行する方法はここでは使えません。
LM Studioは5つすべてのビルドのGGUFファイルを直接読み込めます。リポジトリ名で検索してください。dealignaiのモデルカードにも明記されています。Apple Siliconでは、LM StudioはPocketAiHubのMLXビルドも読み込めます。
トラブルシューティング
モデルがまだ拒否する
アブリテレーションは拒否を減らしますが、完全にはなくしません。ここで紹介した中で最も丁寧に測定された35Bビルドも、独自のテストセットでは100件中3件のプロンプトを拒否します。次の3点を確認してください:
- 電球アイコンで思考をオフにしてください。PocketAiHubの数値はその状態で測定されており、ほかのモデルカードは使用したモードを明記していません。そのため、思考は未確定の変動要因として残っています。
- 量子化を1段階上げてください。拒否の境界は編集済みモデルの中で最も不安定な部分であり、4ビット未満で測定した唯一の公開者も、応答を数える判定基準を示していません。
- 意図したビルドを読み込んでいることを確認してください。アプリのカタログでは、オリジナルの重みと編集済みの重みが非常によく似た名前で並んでいます。
モデルが考え続けて回答しない
返信が空で返ってくるか、テキストが表示される前にトークンの上限に達してしまいます。Ornith 1.5はすべての回答を思考ブロック内から始めるため、思考がオンでトークン上限が低いと、回答を始める前にそこで使い切ってしまいます。そのプロンプトでは思考をオフにするか、トークン上限をデフォルトより十分に高くしてください。これはダウンロードの破損ではありません。また、拒否に関する数値をモデルカードに載せているビルドでは、いずれも確認する価値があります。キーワード判定では、空の生成結果が要求への対応と見なされるためです。
ダウンロードしたビルドがモデルカードの説明と違う
コミュニティによる再アップロードには公開者の保証がなく、モデルカードも古くなります。見慣れないリポジトリからダウンロードする前に、モデルカードに具体的な手法の説明があること、ファイル一覧に妥当なサイズのGGUFファイルがあること、モデルカード内のコマンドが参照するファイルが実際に存在することを確認してください。4ビットの9Bモデルが400 MBになることはありません。alztrkのモデルカードが実例です。4つのGGUFファイルの表と、gguf/ディレクトリを参照するModelfileが掲載されていますが、アップロードから20分後のクリーンアップコミットで、これらはすべてそのリポジトリから削除されています。
画像を入力しても何も起きない
ビジョンプロジェクターは別ファイルであり、ダウンロードした量子化ファイルには含まれていません。同じリポジトリからプロジェクターを取得し、上の画像理解のセクションのように--mmprojで指定してください。リポジトリにプロジェクターがなければ、派生元のビルドのものを使ってください。
コンテキストが長くなるとメモリ不足になる
重みは収まるのに、長い会話でモデルがクラッシュします。これはKVキャッシュがメモリの余裕を超えて増えているためです。Context Sizeを0ではなく明示的な値に設定し、上限に近い場合はAuto Increase Context Sizeをオフにしてください。さらに余裕が必要なら、量子化を1段階下げます。9Bではトークンあたり32 KBのキャッシュを使うため、1ギガバイト空けるごとに約32Kのコンテキストを追加できます。
よくある質問
自分のハードウェアでOrnith 1.5の無検閲版を実行する際に、特によく寄せられる質問です。
アブリテレーション済みモデルと無検閲モデルの違いは?
アブリテレーション済みとは、モデルをどう変更したかを表します。重みの中で拒否を支配する1つの方向が取り除かれています。無検閲とは結果を表し、重みの編集ではなくファインチューニングによってそうなったモデルも含みます。このガイドのOrnith 1.5ビルドはすべてアブリテレーション済みなので、この場合は両方の言葉が同じファイルを指します。同じものを指してablatedやobliteratedという語が使われることもあります。
Ornith 1.5 UncensoredはDeepReinforceの公式リリースですか?
いいえ。DeepReinforceはOrnith 1.5をMITライセンスで公開しており、無検閲版は個々の公開者がその重みを編集したコミュニティ版です。DeepReinforceはこれらを作成しておらず、承認もしていません。
Ornith 1.5の無検閲版にはどれくらいのVRAMが必要ですか?
4ビットの9Bでは約5.6 GBなので、8 GB GPUならコンテキスト用の余裕を持って使えます。このハードウェアクラスについては、8GB環境におすすめのローカルLLMのまとめをご覧ください。35Bは4ビットで約21 GB必要なので24 GBのカードが必要で、2ビットでは13.2 GBです。Apple SiliconではmacOSがGPUメモリを統合メモリの約75パーセントに制限するため、16 GBのMacでは9B、32 GB以上では35Bを実行できます。
16GBのMacでOrnith 1.5の無検閲版を実行できますか?
はい、9Bなら実行できます。macOSは16 GBのマシンでモデルに約12 GBを割り当てるため、9Bは9.5 GBのQ8_0まで収まります。35Bは実用的な量子化ではどれも収まりません。このクラスで快適に動くほかのモデルについては、16GBのMacにおすすめのローカルLLMのまとめをご覧ください。
Ornith 1.5の無検閲版はどのビルドが最適ですか?
ほかのビルドにしかないものが必要でなければ、9BはThunder13240、35BはPocketAiHubです。この2つだけが、内容を検証できる拒否測定を公開しています。Thunder13240がまだアップロードしていない9Bのファイルサイズが必要ならmradermacher、35Bで最も幅広い量子化のラインアップが必要ならdealignai、投機的デコーディングを使いたいならgbuzhfを選んでください。
アブリテレーション済みモデルは賢さが落ちますか?
3ビットを超える量子化では、ほとんど落ちません。dealignaiは、自身の35Bとアブリテレーション前のベースモデルを同じ量子化でMMLU評価し、差は-0.6から+2.4ポイントの間でプラスにもマイナスにも振れました。これは変化がノイズフロア内に収まっている場合の見え方です。Q2_Kでは同じ比較で8.1ポイント低下します。重みの観点では編集は小規模で、gbuzhfの測定ではオリジナルからのKLダイバージェンスは0.0151と、Q6_Kへの量子化による影響より小さい値です。これらのビルドについて数学、コード、多言語、画像理解の数値を公開した人はいないため、頼りにする前に自分の作業でテストしてください。
Ornith 1.5の無検閲版は無料で商用利用できますか?
はい。Ornith 1.5はMITライセンスで提供され、無検閲版もそれを継承しています。商用利用、改変、再配布はすべて認められています。2者の公開者はベースのライセンスをMITと記しながらリポジトリにApache 2.0のラベルを付けていますが、それによってDeepReinforceに対する義務が変わるわけではありません。モデルで生成したものの責任はあなたにあり、現地の法律も引き続き適用されます。
Ornith 1.5の無検閲版をダウンロードしても安全ですか?
ここでのリスクは、悪意あるファイルよりも、間違ったファイルを取得することです。重みはプログラムではなくデータですが、モデルカードに具体的な手法が説明され、ファイル一覧がモデルカードの記載と一致するリポジトリを選んでください。ここで取り上げた少なくとも1つのモデルカードは、リポジトリにもう存在しないファイルを説明しています。
Ornith 1.5の無検閲版はローカルで画像理解に対応していますか?
はい。ビジョンタワーはアブリテレーションが編集するモデルの部分の外にあり、このガイドのすべてのビルドが変更せずに残しています。Atomic Chatではチャットに画像を添付し、llama.cppでは別ファイルのプロジェクターを--mmprojで指定します。
Ornith 1.5の無検閲版はOllamaやLM Studioで動きますか?
35Bなら動きます。ollama run codecraftersllc/ornith-1.5-35b-a3b-abliteratedはプロジェクターを含めて18 GBをダウンロードします。9Bの無検閲版にはOllamaタグがありません。LM Studioは、このガイドの5つすべてのビルドのGGUFファイルを読み込めるほか、Apple SiliconではPocketAiHubのMLXビルドも読み込めます。
Ornith 1.5に自分でアブリテレーションを施せますか?
はい。ただし、このモデル固有の注意点があります。Hereticは探索を自動化しますが、推論モデルではデフォルトで思考ブロック内の活性値をサンプリングするため、どれだけ強く適用しても拒否数を減らせる範囲に限界があります。まずそのブロックを閉じるように応答プレフィックスを設定してください。35Bには2つ目の制約があります。エキスパートがツールからアクセスできない1つの融合テンソルとして保存されているため、処理で編集されるのはアテンションだけです。
結論
Ornith 1.5の無検閲版を使いたくて8 GBのカードがあるなら、Thunder13240の9B Q4_K_Mをダウンロードし、8Kのコンテキストから始めてください。このサイズで、公開者が編集内容を記録し、オリジナルとの比較測定を行い、対照実験を公開した唯一のビルドです。24 GBのカードでは、35Bビルドの中で最も慎重に測定されたPocketAiHubの35B Q4_K_M、21.2 GBを選んでください。32 GB以上なら、gbuzhfの25G-ICEで、同じ編集と動作する予測ヘッドを使えます。どれをテストする場合も思考をオフにし、推論ではなく回答を採点してください。
重要なポイント:
- Ornith 1.5の無検閲版は、DeepReinforceのMITライセンスの重みをコミュニティが編集したものです。DeepReinforceが公開したものではありません。
- アブリテレーションは再学習せずに重みから拒否方向を取り除くため、サイズとメモリ容量の計算は変わりません。
- Ornith 1.5は推論モデルであり、思考ブロック内でサンプリングするツールは誤った方向を抽出します。ある公開者はそこだけを修正し、拒否数を100件中22件からゼロに減らしました。
- 公開者ごとの拒否率は、異なるプロンプト集合と異なる思考モードで測定されています。それらを直接比較して順位付けすることはできません。
- 量子化によって拒否は戻りませんが、それ以外のすべてが損なわれます。また、4ビット未満での唯一の拒否測定は、何を使って採点したかを一切示していないモデルカードによるものです。




