Sonnet 5.5は、標準APIトークン料金がOpus 5.5の半額でありながら、Anthropicが公開した一部のベンチマークでOpus 5.5に近い結果を出しています。FrontierCodeでは依然としてOpusがリードしており、Fable 5.1とGPT-6 Astraも比較対象となるクラウドの選択肢です。結果はタスクや評価設定によって変わるため、以下の表では、どのような条件で比較が成り立つかを説明します。
自分のコンピューターでモデルを実行したい場合は、選択肢が変わります。AnthropicはSonnetの重みを公開していません。重みが公開されている代替モデルには、サーバーハードウェアが必要なGLM-5.3やKimi K3などの大規模モデルから、デスクトップ向けのQwen3.8 27BやOrnith 1.5 9Bまであります。公開されている結果を比較してから、お使いのハードウェアに合うモデルとダウンロードファイルを選びます。
このガイドでは、次の内容を解説します。
- Sonnet 5.5の機能とAPI料金
- ベンチマークでのOpus、Fable、GPT-6 Astraとの比較
- 重みが公開されているモデルとSonnetの比較
- お使いのコンピューターに合うローカルモデルとダウンロードファイル
- Atomic ChatでSonnetのAPIに接続する方法
- Atomic Chatでローカルの代替モデルをダウンロードして実行する方法
Claude Sonnet 5.5とは?
Anthropicは、Sonnet 5の後継モデルとして、2026年9月28日にClaude Sonnet 5.5をリリースしました。ラインアップではOpus 5.5の下位に位置し、トークン料金が低く設定されています。
Anthropicのモデルドキュメントに基づくClaude Sonnet 5.5の主な仕様:
スワイプして比較 →
| 仕様 | Claude Sonnet 5.5 |
|---|---|
| APIモデルID | claude-sonnet-5-5 |
| コンテキスト長 | 100万トークン |
| 最大出力 | 128Kトークン |
| モダリティ | テキストと画像の入力、テキストの出力 |
| API入力料金 | 100万トークンあたり$2 |
| API出力料金 | 100万トークンあたり$10 |
| ローカル実行用の重み | 公開チェックポイントなし |
Sonnetは、Claudeまたは対応するクラウドプロバイダーを通じて利用できます。ダウンロードできるSonnetのGGUFはありません。モデルをオフラインで動作させたい場合は、このガイドの後半で紹介する、重みが公開されている代替モデルのいずれかが必要です。
Sonnet 5.5の料金はOpusやFableと比べていくらですか?
標準のAPIトークン料金は次のとおりです。
スワイプして比較 →
| モデル | 入力、100万トークンあたり | 出力、100万トークンあたり |
|---|---|---|
| Claude Sonnet 5.5 | $2 | $10 |
| Claude Opus 5.5 | $4 | $20 |
| Claude Fable 5.1 | $10 | $50 |
この料金では、キャッシュされていない入力100,000トークンと出力10,000トークンを含むリクエストは、追加のツール料金を除いてSonnetで$0.30かかります。同じトークン数をOpusで処理すると$0.60です。
タスクに対して支払う金額は、モデルが推論にかける時間や試行回数によっても変わります。Artificial Analysis独自の評価では、推論強度をmaxに設定したSonnet 5.5のコストはIntelligence Indexのタスクあたり$7.60で、Sonnet 5より約50%高くなりました。この評価には、その後修正された構造化出力のバグを含むリリース前のデプロイが使われていました。
実際に使う予定の推論強度設定から始め、完了したタスクにかかった合計料金を比較してください。Sonnetで再試行が多すぎる場合、次に試すモデルはOpusです。Anthropicのモデル選択ガイドでは、推論強度を高く設定したOpusでも力不足となる難しい作業にFableを位置づけています。
Claude Sonnet 5.5のベンチマーク
Anthropicのリリース時の表では、Sonnet 5.5をSonnet 5、Opus 5.5、GPT-6 Solと比較しています。
スワイプして比較 →
| ベンチマーク | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
Terminal-Bench 4.0 ターミナルエージェント | 70.6 | 10.3 | 66.4 | - |
FrontierCode v1.1 Main コード変更 | 46.2 | 42.4 | 54.4 | 49.3 |
CursorBench 4.0 コーディングエージェント | 55.5 | 34.1 | 57.8 | - |
GDPval-AA v2.1 専門的な業務 | 1844 | 1449 | 1846 | 1487 |
HLE with tools ツールを用いた推論 | 64.5 | 54.9 | 67.7 | - |
SonnetはGDPval-AAでOpusにほぼ並び、Terminal-Benchではリードしていますが、FrontierCodeのスコアは引き続きOpusのほうが高くなっています。
FrontierCodeに掲載されているSonnetの結果は推論強度がmaxの場合で、xhighでは52.1です。OpusのTerminal-Benchの結果にはxhighが使われています。GDPval-AAはEloスコアで、ほかの行はパーセンテージです。リリース時の脚注には、構造化出力に影響したリリース前のバグが修正済みであることと、GPT-6 Solの視覚機能に最近修正が加えられたことが記載されています。ハイフンは、その出典に結果がないことを意味します。
Sonnet 5.5とFable 5.1、GPT-6 Astraの比較
FableとAstraは、AnthropicのOpus 5.5発表に登場します。次の表では、そこで公開された結果をSonnetのリリース時のスコアと並べています。
スワイプして比較 →
| ベンチマーク | Sonnet 5.5 | Fable 5.1 | GPT-6 Astra |
|---|---|---|---|
Terminal-Bench 4.0 ターミナルエージェント | 70.6 | 55.8 | 57.9 |
FrontierCode v1.1 Main コード変更 | 46.2 | 50.3 | 53.3 |
HLE with tools ツールを用いた推論 | 64.5 | 65.6 | 57.2 |
これらの結果は、評価設定が異なるAnthropicの2つのリリース時の表から引用しています。AstraのTerminal-Benchスコアは推論強度がhighの場合で、上記のSonnetのFrontierCodeの結果はmaxの場合です。Anthropicは、Astraの結果の出典をOpenAIとしています。
Terminal-Benchはターミナル上のタスクを完了する能力を、FrontierCodeはレビュアーがマージするような変更を作成する能力を評価します。当サイトのGPT-6 Astraの代替モデルガイドでは、Astraとそのローカルの選択肢をさらに詳しく紹介しています。
Claude Sonnet 5.5に代わる重み公開モデル
重みが公開されているモデルをダウンロードすると、自分のハードウェアで推論を実行できます。コードベースを編集するには、そのモデルを利用できるコーディングツールも必要です。重みをダウンロードするだけでは、Claude Codeのワークフローを再現できません。
GLM-5.3は、重みが公開されている大規模なコーディングモデルで、vLLMとSGLangによるデプロイ手順が公開されています。Kimi K3の総パラメータ数は2.8兆で、トークンごとに有効になるパラメータ数は1,040億です。どちらもサーバーハードウェアが必要です。デスクトップ向けには、より小規模なQwen3.8 27BとOrnith 1.5 9Bが検討対象になります。
MoEモデルは、トークンごとにパラメータの一部だけを使用します。ただし、ダウンロードにはモデル全体が含まれます。当サイトのKimi K3ガイドでは、このクラスのモデルに必要なハードウェアとセットアップを解説しています。
Sonnet 5.5と重み公開モデルの比較
各ベンダーが報告しているモデルのスコアは次のとおりです。各開発元は独自の評価環境を使用しています。
スワイプして比較 →
| ベンチマーク | Sonnet 5.5 | GLM-5.3 | Kimi K3 | Qwen3.8 Flash Next | Qwen3.8 27B | Ornith 1.5 9B |
|---|---|---|---|---|---|---|
HLE with tools ツールを用いた推論 | 64.5 | 62.5 | - | - | - | 30.5 |
DeepSWE v1.1 ソフトウェアエンジニアリング | - | 66.9 | 67.5 | 58.7 | 42.2 | - |
GPQA Diamond 専門的な科学知識 | - | - | 93.5 | 91.7 | 89.2 | 86.4 |
出典:Anthropic、Z.ai、Moonshot、Qwen Flash Next、Qwen 27B、Ornith。
ツール、評価者、推論予算はベンダーによって異なるため、列間のわずかな差だけでは優劣は決まりません。Kimiは別途、ツールを使用したHLE-Fullで56.0と報告していますが、出典の表記からは同じ版のテストと確認できないため、HLEのセルを空欄にしています。DeepSWEでは、KimiはKimi Codeを、GLMはmini-swe-agentを使用し、QwenはClaude Codeとmini-SWE-agentのうち高いほうのスコアを採用しています。これらのスコアは元のモデルの結果であり、以下で推奨する量子化済みGGUFファイルの結果ではありません。
Sonnetのリリース時の表には、DeepSWEやGPQA Diamondの結果は掲載されていません。QwenのHLEの結果にはツールを使用したという表記がないため、最初の行には含められません。
Qwenは、公開している評価手順に基づくDeepSWEのスコアを、Flash Nextでは58.7、27Bでは42.2と報告しています。Flash Nextは当社の分割ビルドを使うと64 GBのMacで動作し、27Bは24 GBのGPUに収まります。
お使いのハードウェアに合うClaude Sonnet 5.5のローカル代替モデル
システム要件で確認すべきなのはメモリです。以下は具体的なダウンロードファイルで、これらとは別にランタイムと会話キャッシュ用の余裕が必要です。
スワイプして比較 →
| お使いのハードウェア | モデルとビルド | ダウンロードサイズ |
|---|---|---|
| 8 GBのGPU、テキストと短いコンテキストから開始 | Ornith 1.5 9B、AD-Q5_K-Q4_K | 5.93 GB |
| 24 GBのGPUまたは32 GBのApple Silicon Mac | Qwen3.8 27B、AD-Q4_K_M | 17.1 GB |
| SSDに空き容量がある64 GBのApple Silicon Mac | Flash Next、AD-3.84bpw-IQ4_XS-M64 | 合計84.9 GB、GPUに常駐する重みは45.8 GB |
画像を使用する場合、OrnithとQwen 27Bの視覚プロジェクターにより、それぞれ約0.92 GBと0.93 GBが追加されます。Flash NextはAtomicの分割ビルドで大きなn-gramテーブルをSSDに保存するため、ダウンロードサイズがMacのメモリ容量を超えていても利用できます。
24 GBのGPUまたは32 GBのMac向けのQwen3.8 27B
このハードウェアでは、Qwen3.8 27Bが第一候補です。テキストと画像を入力でき、17.1 GBのAtomic AD-Q4_K_Mファイルを使うと、24 GBのGPU上にランタイムと、コンテキスト長8,192トークンから始める会話のための余裕が残ります。会話が長くなるとKVキャッシュによるメモリ使用量が増えるため、8Kでモデルが収まるからといって、同じカードで最大コンテキスト長まで使えるとは限りません。
当サイトのQwen3.8 27Bガイドでは、ほかのビルドとllama.cppのコマンドを紹介しています。サイズの大きい量子化版を使いたい場合や、モデルをGPUとシステムメモリに分けて配置する必要がある場合は、そのガイドを参照してください。
64 GBのMac向けのQwen3.8 Flash Next
Flash Nextには、総パラメータ数125B、アクティブパラメータ数6Bのコアに加え、独立したn-gram埋め込みと予測ヘッドがあります。Atomicのビルドでは、主要な重みをメモリに置いたまま、n-gramテーブルをSSDに保持します。
当社のGGUFリポジトリでは、64 GBのMacBook Pro M5 MaxでAD-3.84bpw-IQ4_XS-M64ビルドを使用した場合、毎秒36トークンの生成速度と報告しています。
分割ファイルとメモリ設定については、Flash Nextセットアップガイドに従ってください。45.8 GBという数値は、GPUに常駐する重みの容量です。ランタイムとコンテキストキャッシュにも別途メモリが必要です。
8 GBのGPU向けのOrnith 1.5 9B
Ornith 1.5 9Bは、ダウンロードサイズが大幅に小さいデンスモデルです。当社の5.93 GBのAD-Q5_K-Q4_Kビルドは、このリポジトリで8 GBのVRAM向けに推奨されている選択肢です。視覚プロジェクターを追加する前に、テキストと短いコンテキストから始めてください。
開発元はSWE-bench Verifiedで70.6、SWE-bench Proで47.5と報告していますが、これらが評価するタスクは、Sonnetの結果が掲載されているTerminal-Benchとは異なります。ファイルと設定については、当サイトのOrnith 1.5ガイドを参照してください。
Prismのランタイムを使える場合のBonsai 2 27B
Bonsai 2 27Bは、Qwen3.8 27Bの重みを三値化して圧縮したモデルです。PTQ1_0の言語モデルファイルは5.95 GBで、PQ2_0のパッキング形式では7.21 GBです。
標準のllama.cppはこれらの三値パッキング形式を読み込めないため、これらのファイルにはPrism MLのllama.cppビルドが必要です。フォークとそのセットアップについては、Bonsai 2ガイドに従ってください。以下のAtomic Chatでのローカル実行手順は、Qwenの標準GGUFビルドを対象としています。
開発元のベンチマークは、元のQwenモデルと比較して圧縮の影響を測定したものです。BonsaiがSonnet 5.5に匹敵することを示すものではありません。
Atomic ChatでAPI経由でClaude Sonnet 5.5を使う方法
AnthropicのAPIをAtomic Chatに接続すると、ローカルモデルと併せてSonnetを利用できます。SonnetはAnthropicのホスティングサービスを通じて動作します。APIの利用料金はClaudeのサブスクリプションとは別に請求されます。
ステップ1:AnthropicのAPIキーを取得する
Claude Consoleを開き、APIキーを作成します。このサービスを初めて使う場合は、APIの支払い設定を行ってください。
ステップ2:Anthropicに接続する
Atomic ChatでCloudを開き、Anthropicを選択します。API keyにキーを貼り付け、Connectをクリックします。Base URLはデフォルトのままにしてください。
ステップ3:Sonnet 5.5を追加する
Reload modelsをクリックし、claude-sonnet-5-5を探します。見つからない場合は、Reload modelsの横にある+ボタンをクリックします。Model IDにclaude-sonnet-5-5を入力し、Add Modelをクリックします。
ステップ4:チャットを始める
チャットを開き、モデル選択メニューからSonnet 5.5を選択します。お使いのAnthropicアカウントに、このモデルへのAPIアクセス権が必要です。
自分のコンピューターで回答を生成したいときは、同じアプリ内でダウンロード済みのローカルモデルに切り替えられます。
Atomic Chatでローカルの代替モデルを実行する方法
Atomic Chatには、Hugging Faceのモデルブラウザーとチャット機能が組み込まれています。自分でllama.cppをビルドせずに、ローカルモデルをダウンロードできます。
Qwen3.8 27Bを実行する手順は次のとおりです。
ステップ1:Atomic Chatをインストールする
atomic.chatからデスクトップアプリをダウンロードし、お使いのプラットフォーム向けのビルドをインストールします。
ステップ2:QwenのGGUFを探す
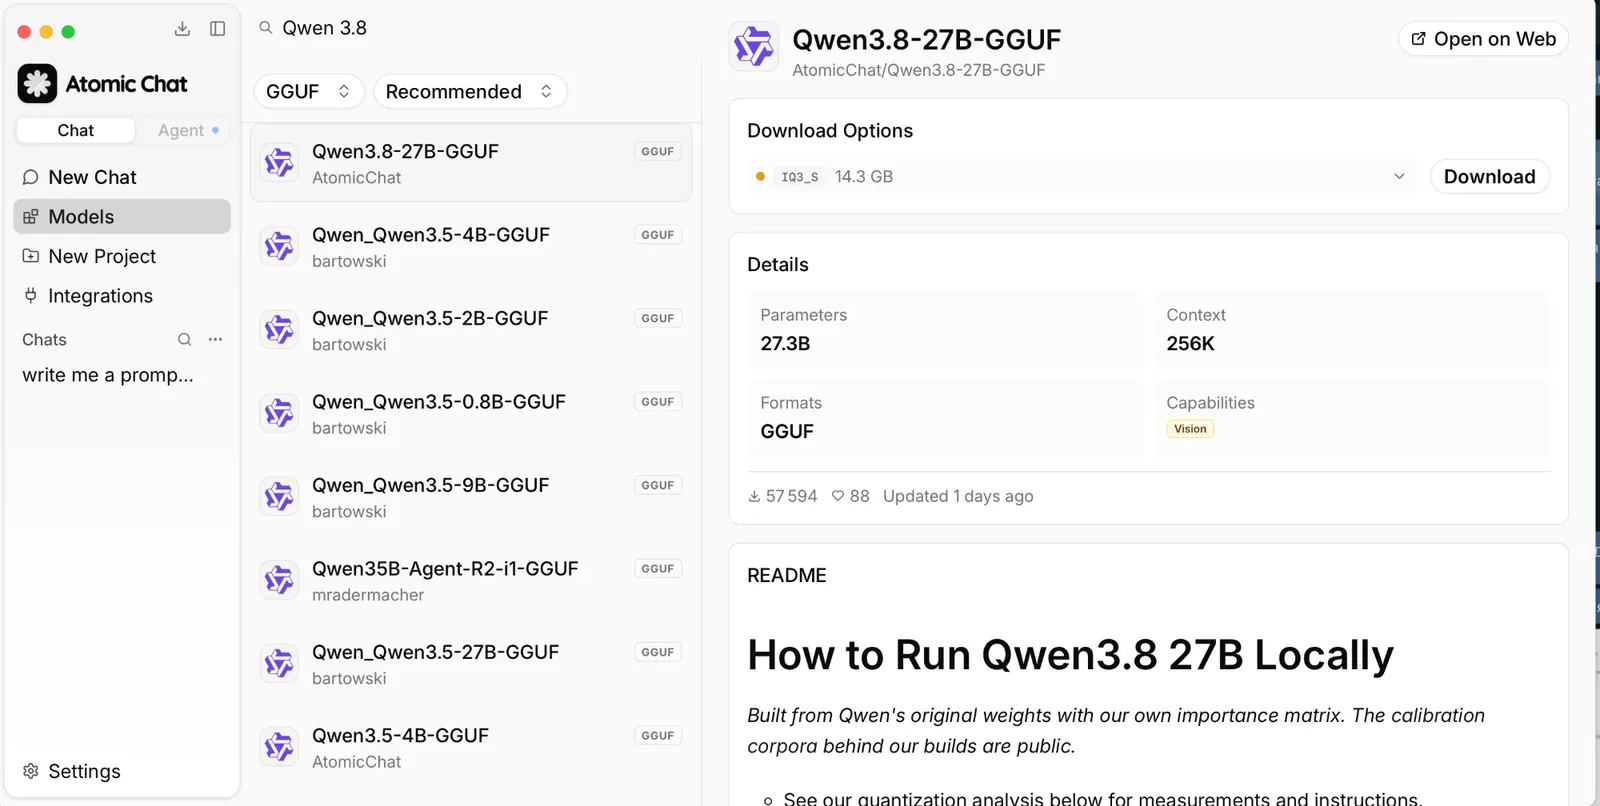
Modelsを開き、AtomicChat/Qwen3.8-27B-GGUFを検索します。AtomicChatのリポジトリを選択し、Download Optionsを展開します。
ステップ3:メモリ容量に合うビルドをダウンロードする
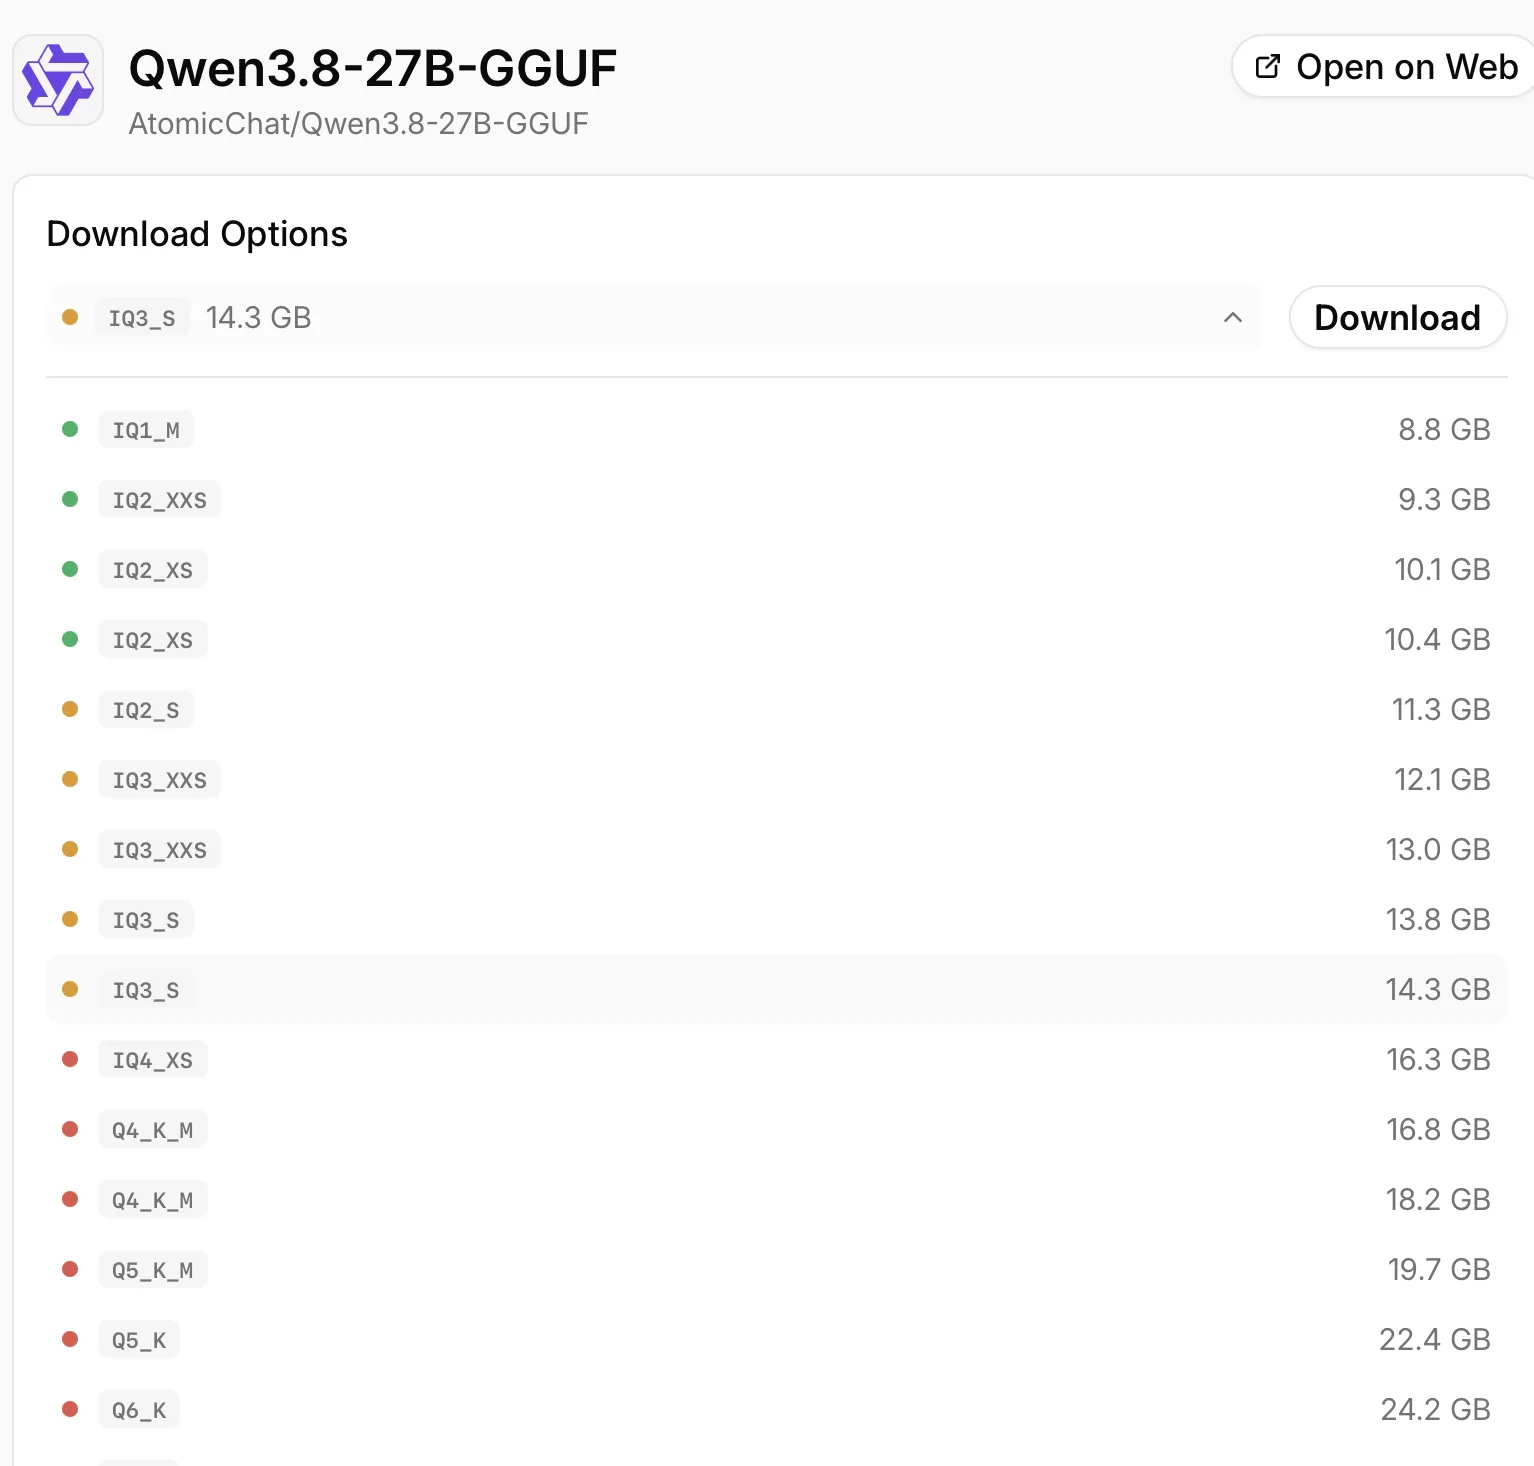
24 GBのGPUまたは32 GBのMacでは、AD-Q4_K_Mを選択してください。完全なファイル名はQwen3.8-27B-AD-Q4_K_M.ggufです。選択メニューでは短いQ4_K_Mタグが表示される場合があり、表示されるダウンロードサイズは表にある重みファイルのサイズと異なる場合があります。
ステップ4:コンテキスト長を設定してチャットを始める
Settings > Model Providers > Llama.cppを開き、ダウンロードしたモデルを見つけて、その行の歯車アイコンをクリックします。Context Sizeを8192に設定します。メモリに余裕がない場合は、チャットが長くなったときにマシンの容量を超えるメモリが割り当てられないよう、Auto Increase Context Sizeをオフにしてください。
ダウンロードしたモデルを読み込み、チャットを開きます。回答はお使いのコンピューターで生成されます。対応するコーディングツールを接続できるよう、Atomic Chatはhttp://localhost:1337/v1でローカルのOpenAI互換サーバーも提供しています。この方法はローカルLLMセットアップガイドで解説しています。
よくある質問
Claude Sonnet 5.5はローカルで実行できますか?
いいえ。ダウンロードできるSonnet 5.5の公開チェックポイントはありません。デスクトップアプリからClaudeを呼び出しても、利用するのはホスティングされたモデルです。Qwen、Ornith、Bonsaiにはダウンロード可能な代替モデルがあります。
Sonnet 5.5はOpus 5.5より優れていますか?
Anthropicのリリース時の表では、Terminal-Bench 4.0でSonnetがリードしていますが、上記のほかの4行ではOpusがリードしています。実際に使う予定の推論強度設定で、完了したタスクを比較してください。
24 GBのGPUに最適なSonnet 5.5のローカル代替モデルは何ですか?
Qwen3.8 27Bの17.1 GBのAtomic AD-Q4_K_Mビルドを、コンテキスト長8Kで使い始めてください。テキストと画像に対応し、そのハードウェアで使える実用的なローカルの選択肢です。
8 GBのGPUでローカルの代替モデルを実行できますか?
はい。Ornith 1.5 9Bには、そのメモリ容量向けに推奨されている5.93 GBのAtomicビルドがあります。テキストと短いコンテキストから始めてください。画像には追加のプロジェクターと、より多くの作業用メモリが必要です。
Bonsai 2は通常のGGUFと同じように読み込めますか?
三値化されたGGUFファイルには、そのパッキング形式を実装したランタイムが必要です。Prismは、この目的のために独自のllama.cppビルドについて説明しています。すべてのGGUFローダーがこれらのファイルに対応していると考えずに、そのセットアップ手順に従ってください。
ローカルモデルはClaudeのサブスクリプションを使いますか?
いいえ。ダウンロードしたモデルによる推論はお使いのコンピューターで実行され、Claudeの利用枠を消費しません。ただし、ハードウェアは電力を消費し、接続する外部ツールには独自の料金がかかる場合があります。
どのモデルを使うべきですか?
クラウドへのアクセスに見合う結果が得られる作業には、引き続きSonnetやOpusを使ってください。24 GBのGPUまたは32 GBのMacでローカル利用する場合は、Qwen3.8 27Bをダウンロードし、コンテキスト長8Kから始めてください。メモリの制約がより厳しい場合はOrnith 1.5 9Bを選びます。64 GBのMacでは、分割ビルドとSSD上のテーブルを使うFlash Nextが、より大規模な選択肢になります。