

無検閲LLMとは何か、モデルがそもそも回答を拒否する理由、abliterationとファインチューニングの違いを解説します。そのうえで、2026年に使いたいモデルを紹介します。それぞれの用途、独自ベンチマークで上位だったモデル、Atomic Chatでローカル実行する方法を見ていきましょう。
要点
無検閲LLMとは、モデルに回答を拒否させるアラインメント層を取り除いた、重みが公開されているモデルです。アラインメント済みモデルは、有害な依頼だけでなく単に慎重な扱いが必要な依頼まで幅広く拒否します。一方、無検閲モデルは回答し、その判断をユーザーに委ねます。私たちは1枚のRTX 3060で5モデルを測定しました。総合的に最も優れていたのはGemma Abliterated 9Bで、すべてのプロンプトに回答し、推論能力もほぼ維持していました(MMLUは68.0、アラインメント済み版は68.4)。コードにはDolphinCoderまたはQwen 3.6 Uncensored、創作にはNous Hermes 3、速度と長文処理にはLlama 3.2 Dark Championが候補です。大容量GPUがあるなら、測定した中で推論能力が最も高かったDolphin-Mistral 24Bを、実行できる環境があるならLlama 3.3 70B Abliteratedを選べます。Atomic Chatなら2クリックでローカル実行でき、回答の拒否も、質問内容を監視するクラウドもありません。
無検閲LLMとは?
無検閲LLMとは、基盤となる推論能力を維持しながら、回答を拒否する層を弱めるか取り除いた、重みが公開されているモデルです。
その意味を理解するには、モデルがどのように拒否を学習するかを知っておくと役立ちます。学習は3段階で進みます。
第3段階は意図的に幅広く設計されています。一般向け製品を提供するチームには、あらゆる状況を予測することはできないからです。その副作用が過度の一般化です。モデルは、本当に有害な具体的依頼だけを阻止するのではなく、安全性ベンチマークと同じ10分類全体を禁止対象として学習します。暴力、違法行為、ヘイト、嫌がらせ、性的コンテンツ、自傷、欺瞞、プライバシー、非倫理的行為、そして一般的な「有害」コンテンツです。家庭で起きる反応の化学的仕組み、歴史上の武器の動作、小説の犯罪プロットを質問しても、本来は実際の悪用を防ぐための反応が、正当な作業に対しても働いてしまいます。
検閲の除去が対象にするのは、まさにこの反応です。拒否するよう学習された傾向を弱め、重みにすでに備わっている能力を再び利用できるようにします。
また、重みが公開されているため、拒否とは無関係な利点もあります。ダウンロード、検査、量子化を行い、完全にオフラインで実行できます。入力内容が第三者に送信されたり、サーバーに記録されたり、学習データに使われたりすることはありません。法務、医療、金融、サイバーセキュリティ、非公開コードを扱う業務では、検閲の有無にかかわらず、この点だけでもローカル実行を選ぶ十分な理由になることがあります。
無検閲モデルの作り方
負荷の大きいものから小さいものまで、3つの方法があります。
ファインチューニング。追加の指示データでベースモデルをさらに学習させます。Dolphinファミリーの多くに見られる、ファインチューニングされた無検閲モデルは、回答する姿勢を含む新しい動作を、そのデータセットから学びます。実際に学習を行うため、拒否の除去だけでなく、指示追従、文体、書式も改善できます。一方、計算資源が必要で、データの質が低いとベースモデルの長所を損なうリスクがあります。
Abliteration。研究者は、多くのアラインメント済みモデルの拒否動作が、残差ストリーム内の単一の方向によって制御されていることを発見しました。残差ストリームとは、層から層へ渡される内部状態です。その方向を特定するには、対応する有害・無害なプロンプト群でモデルを実行し、活性化を記録して、両群の平均の差を求めます。その後、推論時にその方向を表現できなくするか、ダウンロード可能なチェックポイントでは、重み行列をその方向に対して直交化して恒久的に除去します。処理は速く、費用も低く、元のモデルに近い状態を保てます。ただし、わずかな能力低下を回復するため、通常は軽い「修復」ファインチューニングが必要です。Llama 3.2 Dark Championのように「abliterated」と表示されたモデルは、この方法で作られています。
優れたリリースでは、回答拒否を減らすためにabliterationを行い、その後ファインチューニングで品質を整えるなど、両者を組み合わせることがよくあります。この編集が推論モデルに与える影響については、無検閲のOrnith 1.5ビルドをご覧ください。
無検閲モデルの用途
「無検閲」という名前は注目を集めますが、実際の用途はごく一般的です。
多くの場合、問題は作業そのものの危険性ではなく、幅広い安全性の制約が作業を妨げることです。また、ローカルで実行すれば、データを自分の管理下に置けます。
制限のないLLMの利点とリスク
利点は次のとおりです。
リスクも同じように存在します。主な違いは、責任がユーザーに移ることです。
2026年にローカルで使いたい無検閲LLM
コミュニティによって継続的に維持されているビルドを重視しました。活発なメンテナー、通常は2ビットから8ビットまで10種類以上のGGUF量子化版、問題が起きた際に参照できるドキュメントが基準です。月間ダウンロード数が6桁に達するモデルもあり、MistralベースのDolphinビルドだけでも190kを超えています。一方、利用者は少なくてもサポートが充実したモデルもあります。各項目では、用途、検閲を除去した方法(ファインチューニングまたはabliteration)、選べるサイズを紹介します。
1. Dolphin 3.0:総合的に使いやすいモデル
手法:ファインチューニング
適した用途:コード、調査、日常業務などの一般用途
サイズ:約8B〜70B
Dolphin 3.0は、多くのユーザーにとって最初の候補です。高い指示追従能力を保ちながら拒否層を取り除くファインチューニングを施しています。コミュニティのサポートが幅広く、さまざまなサイズを選べます。依頼どおりに動作する信頼性が最も高く、中程度のサイズならコンシューマー向けGPUにも余裕をもって収まります。
2. Qwen 3.6 Uncensored:コードと多言語の推論
手法:Abliteration
適した用途:コード生成、デバッグ、リファクタリング、多言語処理
サイズ:8B、27B、35B-A3B(MoE)
コードと多言語推論に強いオープンなベースモデルの1つを基盤とし、無検閲版でもその能力を維持しながら拒否を減らしています。コード生成、デバッグ、リファクタリング用のローカルモデルを求める開発者に人気です。複数言語を扱う場合にも有力な候補です。Qwenのベースモデルは英語以外でも高い能力を持ち、性能が低いモデルが苦手とする構造的な推論にも対応できます。
3. DolphinCoder:コード専門モデル
手法:ファインチューニング(StarCoder2ベース)
適した用途:コードの作成、レビュー、修正、技術文書
サイズ:7B、15B
Dolphinファミリーのコードに特化したモデルです。DolphinCoderは汎用性を抑える代わりに、コード生成、レビュー、修正、技術文書などのプログラミング作業を得意とします。リポジトリの文脈を提供するエディターやエージェントとの併用に適しています。
4. Nous Hermes 3:チャットと創作
手法:ファインチューニング(Nous Research・Llama 3.1ベース)
適した用途:小説、ロールプレイ、世界観設定、対話、エージェントタスク
創作に携わる人向けの選択肢です。Nous Hermes 3は自然な文章、一貫したキャラクターの口調、長い対話に優れており、小説、世界観設定、ロールプレイに適しています。アラインメント学習によって多くのチャットモデルに生じる、平板で過度に慎重な文体を避けるため、企業向けアシスタントよりも共同制作者のような文章になります。Nous Hermesシリーズはエージェントタスクも得意で、創作分野以外にも利用者が広がっています。
5. Llama 3.2 Dark Champion Abliterated:制約が少なく長文に対応
手法:Abliteration + MoE
適した用途:没入感のある小説、ロールプレイ、長文処理
サイズ:18.4B MoE(8×3B)・128kコンテキスト
再学習ではなく、重みの段階で拒否を除去したMoEモデルです。他のモデルが正当でも慎重な扱いを要する話題に曖昧な回答をする場合に、直接向き合うモデルを求める人向けです。ただし、使い方については自分が全面的な責任を負うことになります。
6. Dolphin-Mistral 24B(Venice Edition):測定した中で最も高い推論能力、ただし低速
手法:ファインチューニング(Mistral Small 24Bベース)
適した用途:推論能力を重視する作業
サイズ:約24B
Mistral Small 24Bを基盤とし、制約を減らして拒否しにくい動作に調整した、無検閲のDolphinファインチューニング版です。テストした中で最も高いMMLUを記録し(後述)、依頼への応答率もほぼ完全でした。このグループで最も高い推論能力を示したモデルです。
7. Dolphin-Mixtral 8x7B:計算量に対する品質を重視するMoEモデル
手法:ファインチューニング(Mixtral MoEベース)
適した用途:推論能力を重視する作業
サイズ:8×7B(総パラメータ数は約47B、アクティブ数は約13B)
MixtralのMoE設計を基盤としており、トークンごとに一部のパラメータだけを有効にします。そのため、各ステップですべての計算を行わずに、はるかに大きなデンスモデルに近い品質を得られます。全エキスパートを収めるVRAMがあれば、無検閲のDolphin調整によって汎用性の高いモデルとして使えます。
8. Gemma Abliterated:軽量でノートPC向き
手法:Abliteration
適した用途:日常の作業、要約、短時間での下書き
サイズ:2B、9B、27B
GoogleのGemmaのabliterated版は、控えめな性能のハードウェアで使う定番です。小型で高速ながら、日常業務に十分な能力を備えています。ノートPCや入門用GPUで快適に動作し、必要ならCPUだけでも実行できます。私たちのテストでは9B版が総合的に最も優れており、すべての依頼に回答し、ベースモデルの推論能力もほぼ維持していました。
9. Llama 3.3 70B Abliterated:大規模モデルの高い推論能力
手法:Abliteration
適した用途:トップクラスのオープンモデルによる推論
サイズ:70B
適切なハードウェア(48 GB以上、または64 GBのMac)があれば、abliterated版Llama 3.3 70Bが大規模モデルの候補です。拒否層を取り除きながら、ベースモデルの高い推論能力と長文処理能力を保っています。最先端のホスト型モデルに最も近い体験をローカルで得られます。
10. Rocinante / Cydonia(TheDrummer):ロールプレイと長編小説
手法:ファインチューニング(TheDrummer)
適した用途:没入感のあるロールプレイ、長編ストーリー
サイズ:Rocinanteは約12B・Cydoniaは約22〜24B
没入感のあるロールプレイと長編ストーリー向けに作られた、TheDrummerによるコミュニティのファインチューニング版です。Rocinante(約12B)は軽量で高速な選択肢です。Cydonia(約22〜24B)は速度と引き換えに、長いセッションでも豊かで一貫した文章を生成します。
無検閲モデル5つをベンチマークで比較
ローカルのモデルはすべて、同じllama.cppの測定環境で実行しました。単一ターン、中立的なシステムプロンプト(「You are a helpful assistant」)、ジェイルブレイクなしの条件をそろえ、数値を比較できるようにしています。結論に合わせてプロンプトを作ったわけではありません。過剰拒否は公開済みの2つの学術ベンチマークで測定したため、結果は独立したデータセットに基づいています。測定したのは次の4項目です。
拒否の判定はLLM評価モデルが行い、人手で付けた120件のラベルと照合しました(κ = 0.64、実質的な一致)。
「過剰拒否」とはどのようなものか
過剰拒否を測定するには、正当でありながら境界に近く、慎重すぎるモデルが断りそうなプロンプトが必要です。どのプロンプトも説明や描写を求めており、危害を加えることは求めていません。
意外な結果もありました。人手で作成した28件のプロンプトでは、モデル間の差はほとんどありませんでした。最近のモデルはアラインメントの有無にかかわらず、ほぼすべてに回答したのです(92.9〜100%)。現在のLLMは「緊張感のある尋問シーンを書いて」といった依頼を、もはやほとんど拒否しません。しかし、OR-Benchの難しい設問になると、その差が大きく広がります。
重要な結果:abliterationには代償がある
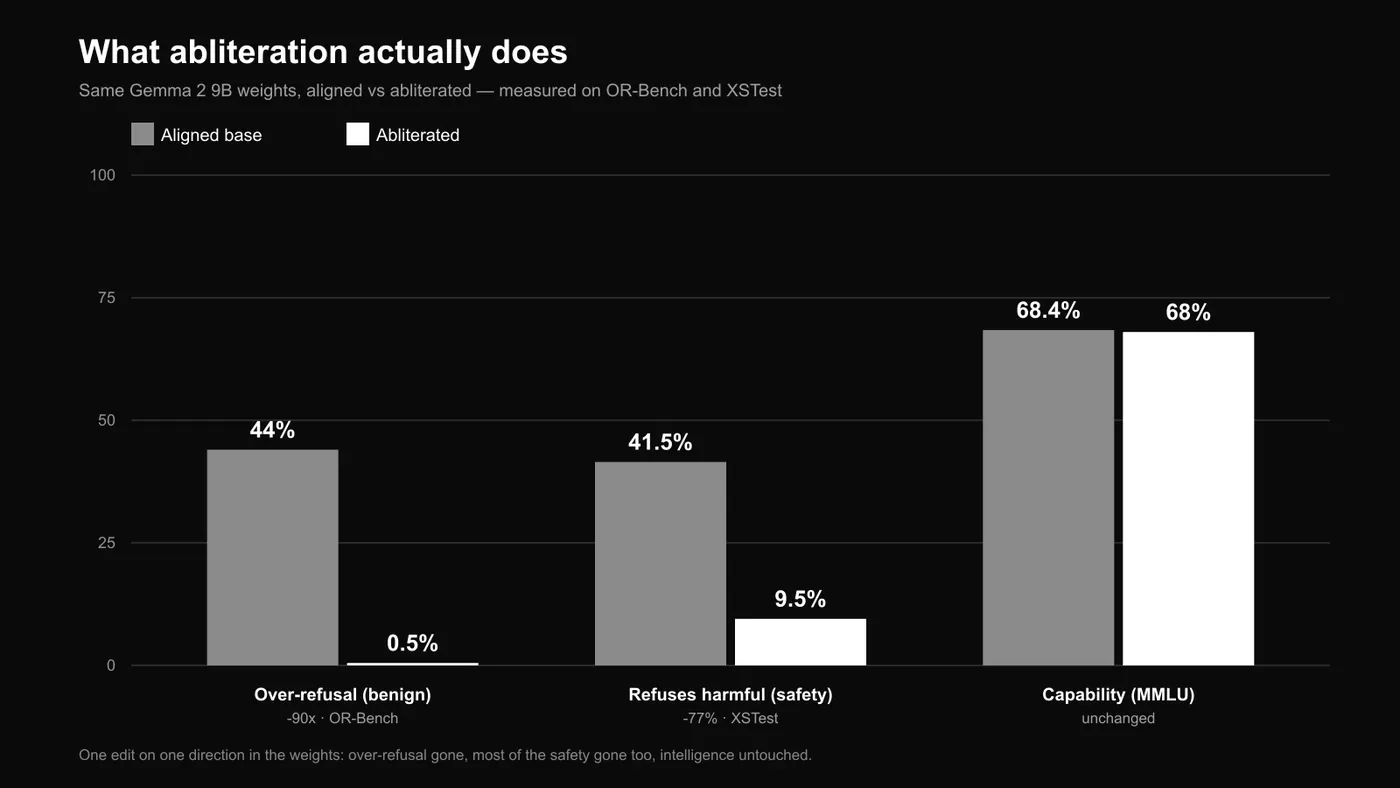
同じGemma 2 9Bの重みを、アラインメント済みとabliteration後で比較しました。OR-Benchの無害なプロンプトに対する過剰拒否率は44%から0.5%へ、約90分の1になりました。しかし、本当に有害なプロンプトへの拒否率も、41.5%から9.5%へ同時に低下しました。MMLUはほぼ変わりませんでした(68.4 → 68.0)。重み内の1つの方向を編集すると、煩わしい拒否が減り、安全性の大部分も失われますが、知的能力は維持されるのです。
過剰拒否と安全性は同じ調整軸にある
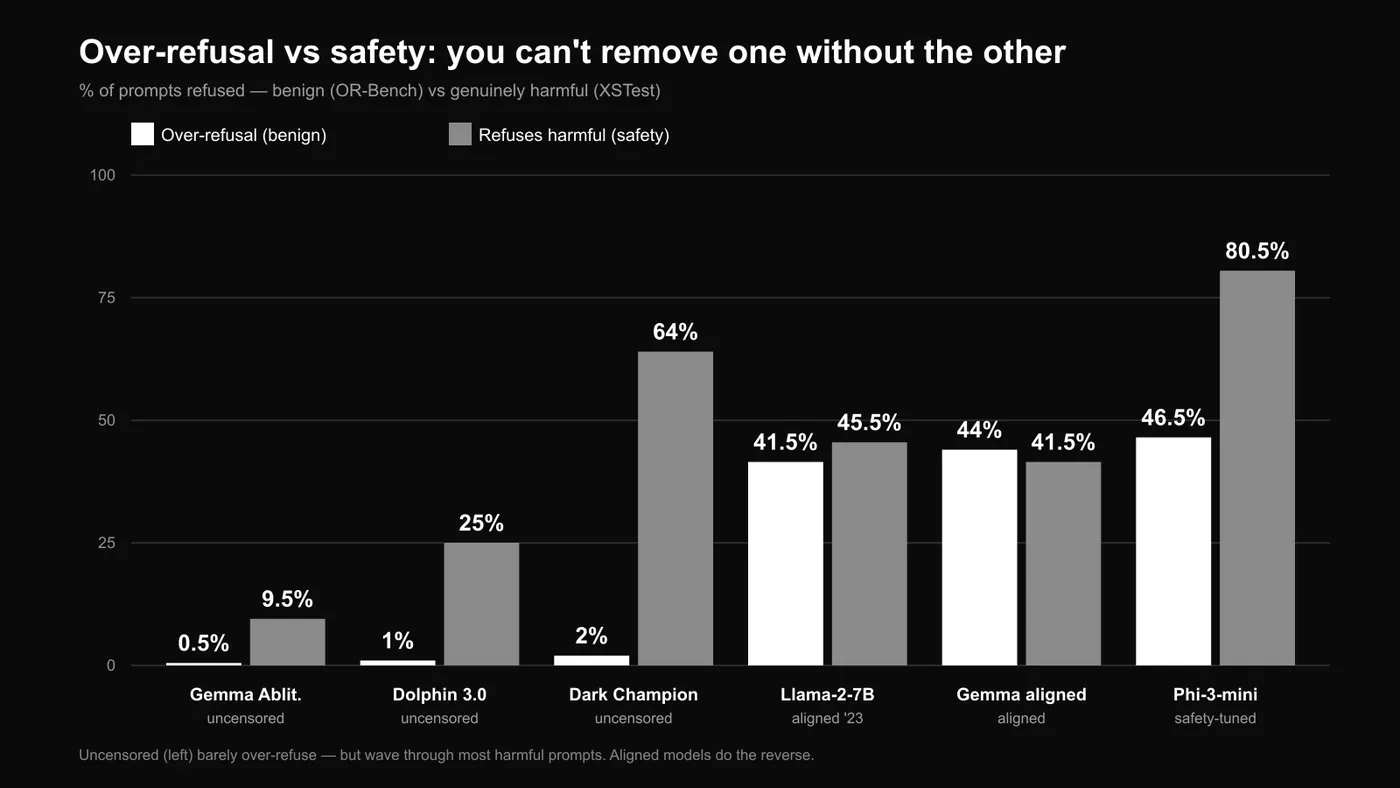
この傾向はすべてのモデルで見られます。無検閲のビルド(左側)は、無害なプロンプトをほとんど過剰拒否しませんが、本当に有害なプロンプトの大半にも回答します。アラインメント済みで安全性を調整したモデルは逆で、無害でも際どいプロンプトの約40%を断り、有害なプロンプトもより多く拒否します。有害なものだけを拒否するモデルはありません。これが無検閲モデルを使うときの実際のトレードオフです。
クラウドのモデルも回答する
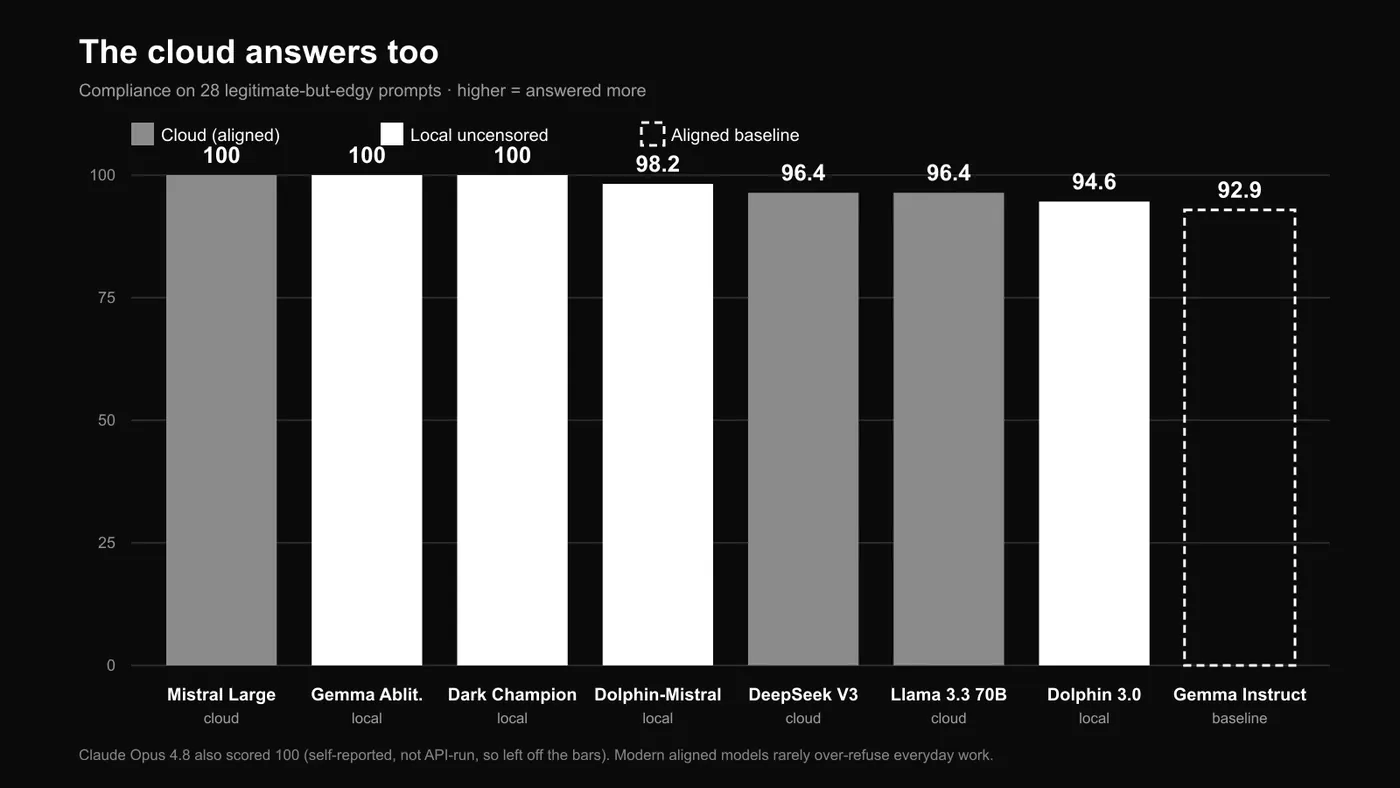
もう1つ意外な結果があり、「検閲されるクラウド」という説明は成り立たなくなります。同じ正当だが際どいプロンプトを、大手のホスト型モデルにも入力しました。Mistral LargeとClaude Opus 4.8はすべてに回答し、DeepSeek V3とLlama 3.3 70Bは96%に回答しました。いずれもアラインメント済みGemmaの基準値(92.9%)以上で、ローカルの無検閲モデルと同水準です。現在の最先端モデルは、宣伝で想定されるほど日常業務を過剰拒否しません。(クラウドモデルにはOR-Benchを実行できなかったため、この比較には人手で作成したデータセットを使っています。それでも差は十分に明確です。)無検閲モデルをローカルで実行する理由は、「クラウドが何でも拒否するから」ではなく、プライバシー、費用、そして完全な管理権にあります。
RTX 3060を1枚使った場合の速度
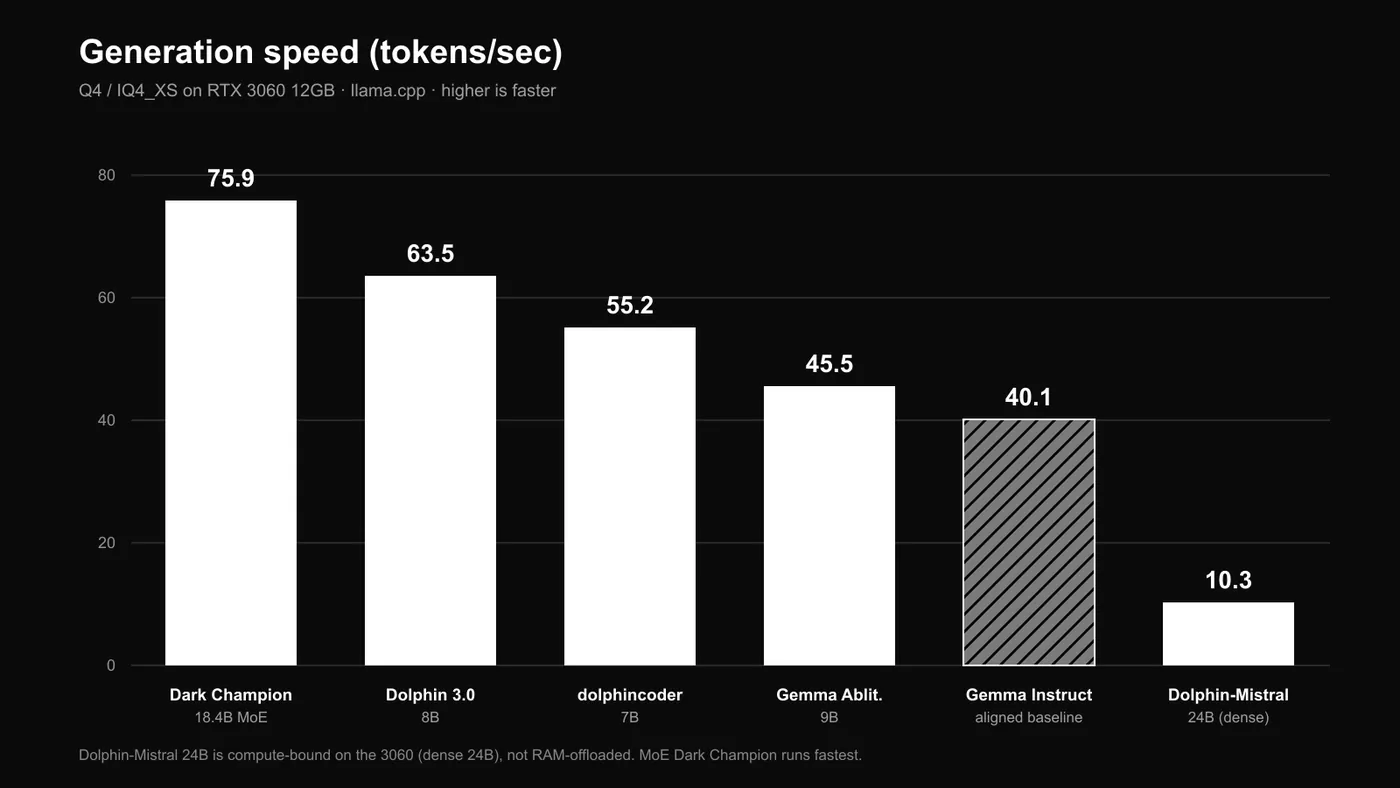
Q4での生成速度です。MoEのDark Championは、18.4Bのパラメータの一部だけをトークンごとに有効にするため、最速でした(約76 tok/s)。デンス型の24BモデルであるDolphin-Mistralは約10 tok/sと低速でした。これは中級GPUで計算処理がボトルネックになったためで、RAMへのオフロードが原因ではありません。
独自ベンチマークによる上位5モデル
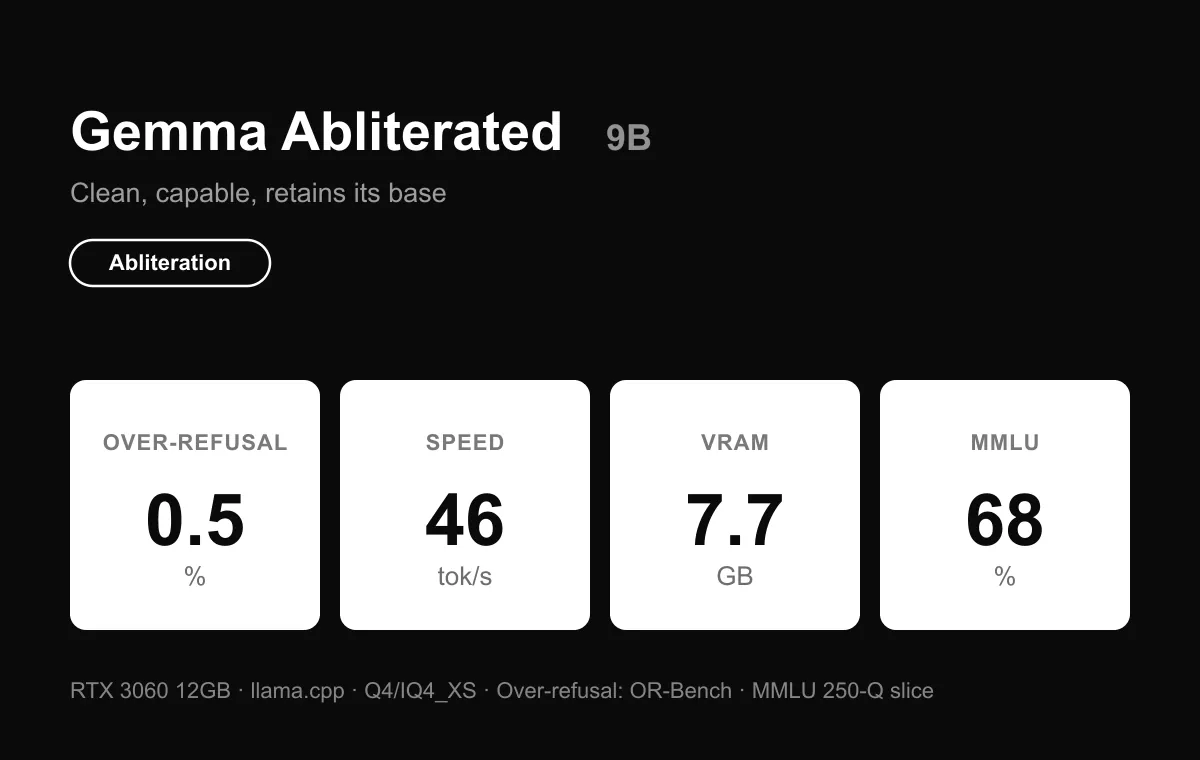
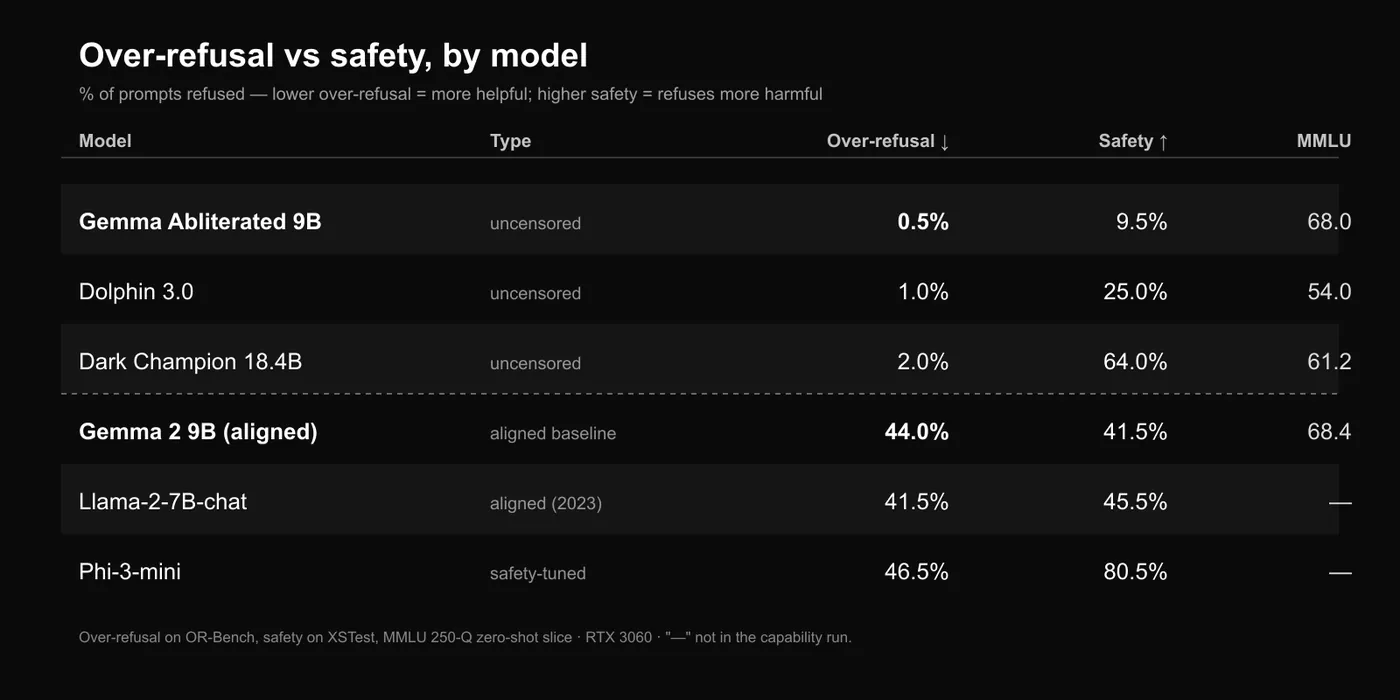
Gemma Abliterated 9B:総合で最も優秀。過剰拒否0.5%、MMLU 68.0、46 tok/s、7.7 GB。無害なプロンプトをほとんど拒否せず、ベースモデルの推論能力を保っています(68.4 → 68.0)。最初の候補に適しています。
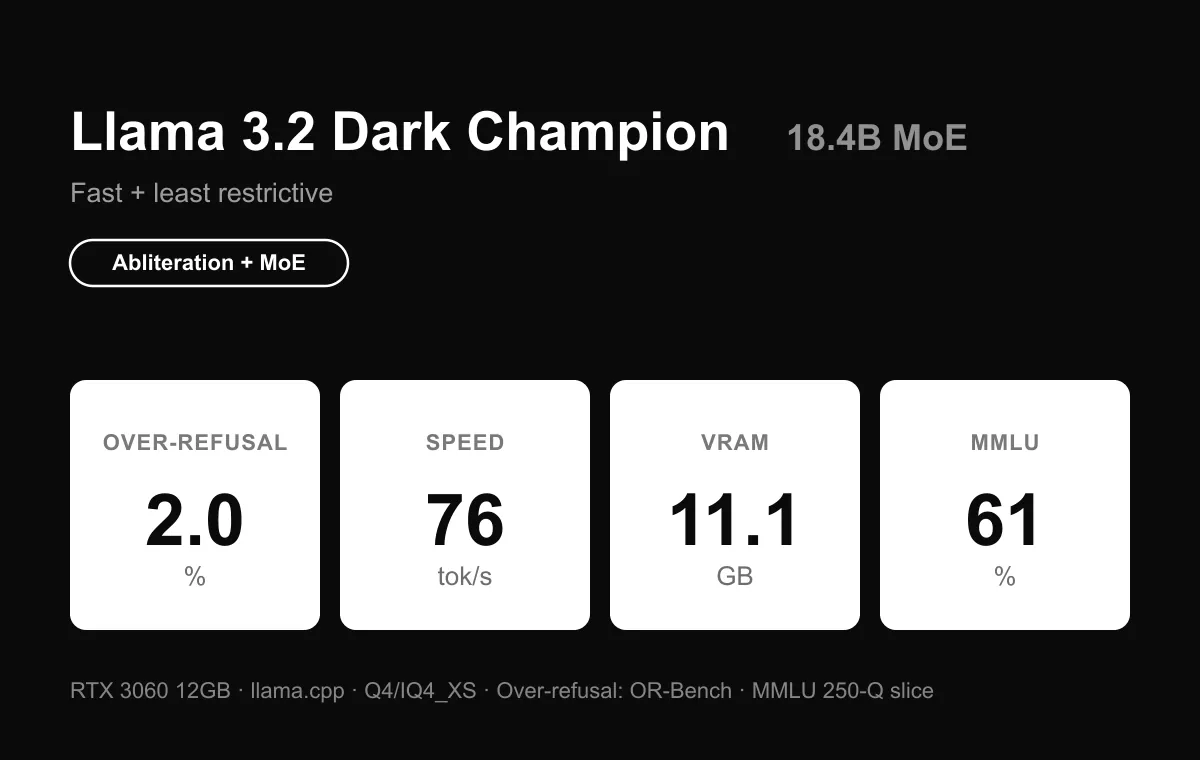
Llama 3.2 Dark Champion 18.4B MoE:制約が少なく高速。過剰拒否2.0%、76 tok/s(最速)、MMLU 61.2。控えめな性能のハードウェアで、創作や長文を扱う用途に適しています。
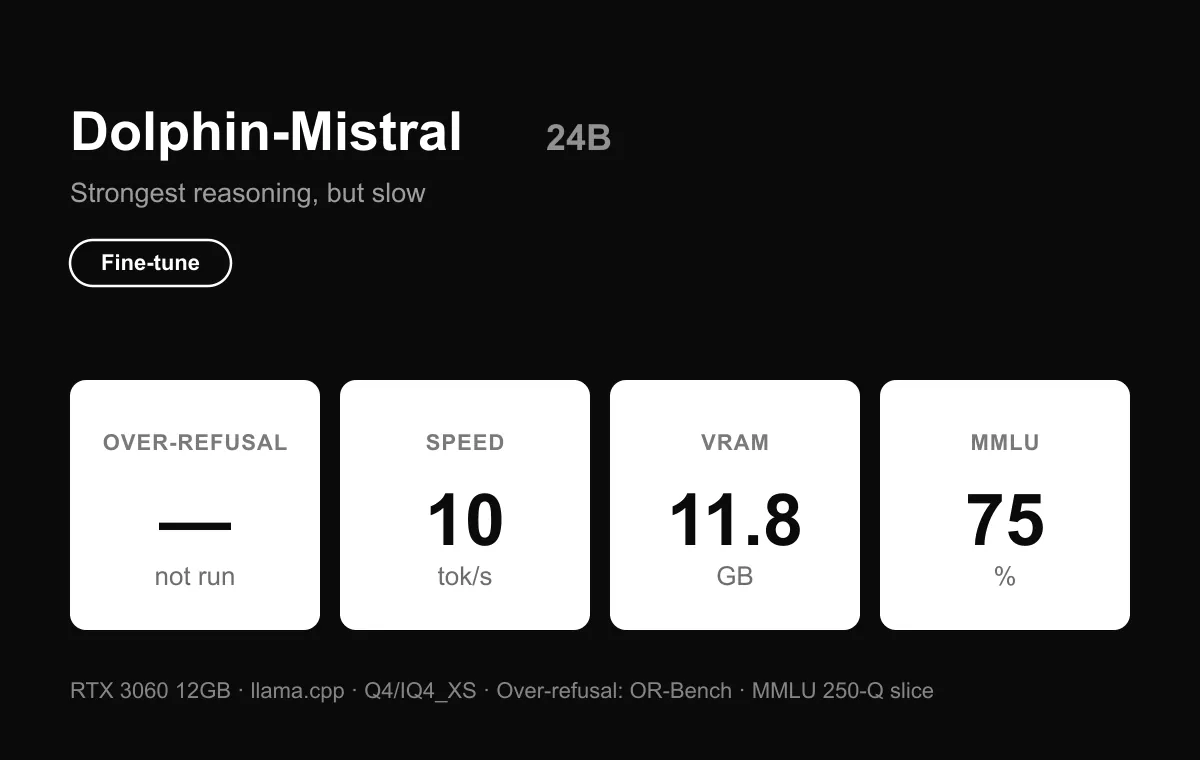
Dolphin-Mistral 24B:推論能力は最高、ただし低速。MMLU 75.2(最高)、10 tok/s。十分な性能の大容量GPUがあれば、有力な選択肢です。
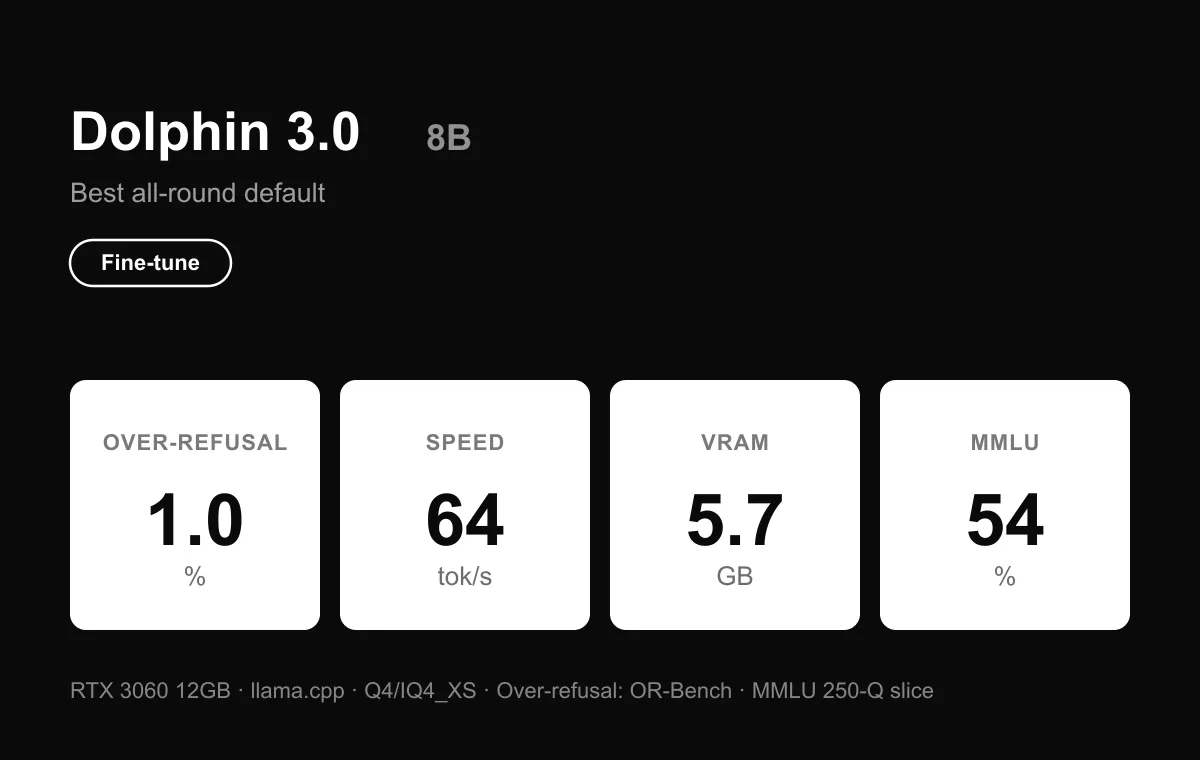
Dolphin 3.0 8B:軽量で高速。過剰拒否1.0%、MMLU 54.0、64 tok/s、5.7 GB。最も手軽に始められるモデルですが、アラインメント済みの基準モデルが回答したプロンプトに曖昧な返答をした、唯一のビルドでもありました。
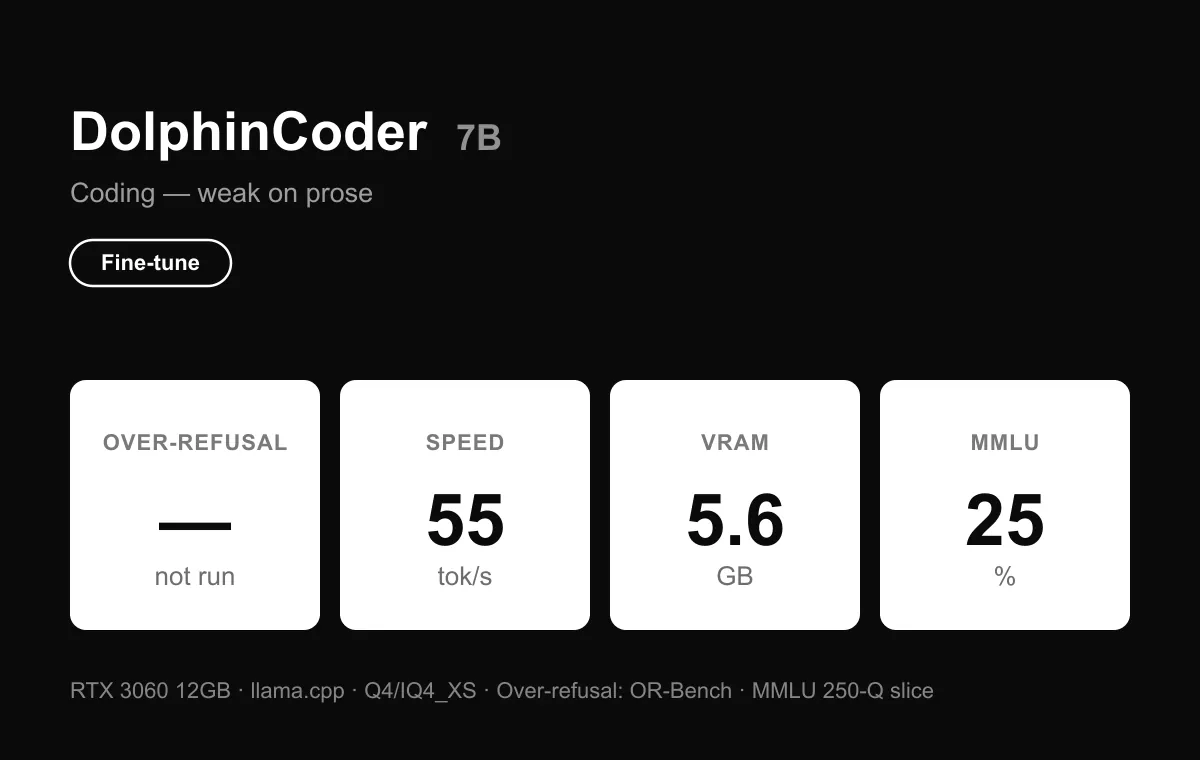
DolphinCoder 7B:コード専用。MMLU 25.2、55 tok/s。コードは得意ですが、文章は苦手です。無検閲のローカルコードモデルが特に必要なら、第一候補になります。
数値が示すこと
検閲の除去には効果があります。ただし、宣伝では触れられない代償もあります。Abliterationによってモデルの過剰拒否率は44%からほぼゼロになり、推論能力は低下しませんでした。これは実際に測定できる利点です。しかし、過剰拒否と安全性のための拒否は重み内の同じ方向に依存するため、同じ編集によって安全性のための拒否の大部分も失われました。片方を除けば、もう片方も失われます。プライバシーと管理権を重視する場面で無検閲モデルを使い、ハードウェアに合ったサイズを選び、自分が唯一の安全策になると理解したうえで利用しましょう。
Atomic Chatで無検閲LLMをローカル実行する方法
上の候補からモデルを選び、Atomic Chatで対応するGGUFビルドを探します。以下のスクリーンショットでは、無検閲のOrnith 1.5ビルドを例にしています。別のビルドでは、モデルのサイズや適切な設定が異なります。
ステップ1:Atomic Chatをインストールする
macOS、Windows、Linux向けのデスクトップアプリをダウンロードし、インストールして起動します。アプリとモデルのダウンロードにはインターネット接続が必要です。
ステップ2:無検閲モデルを探す
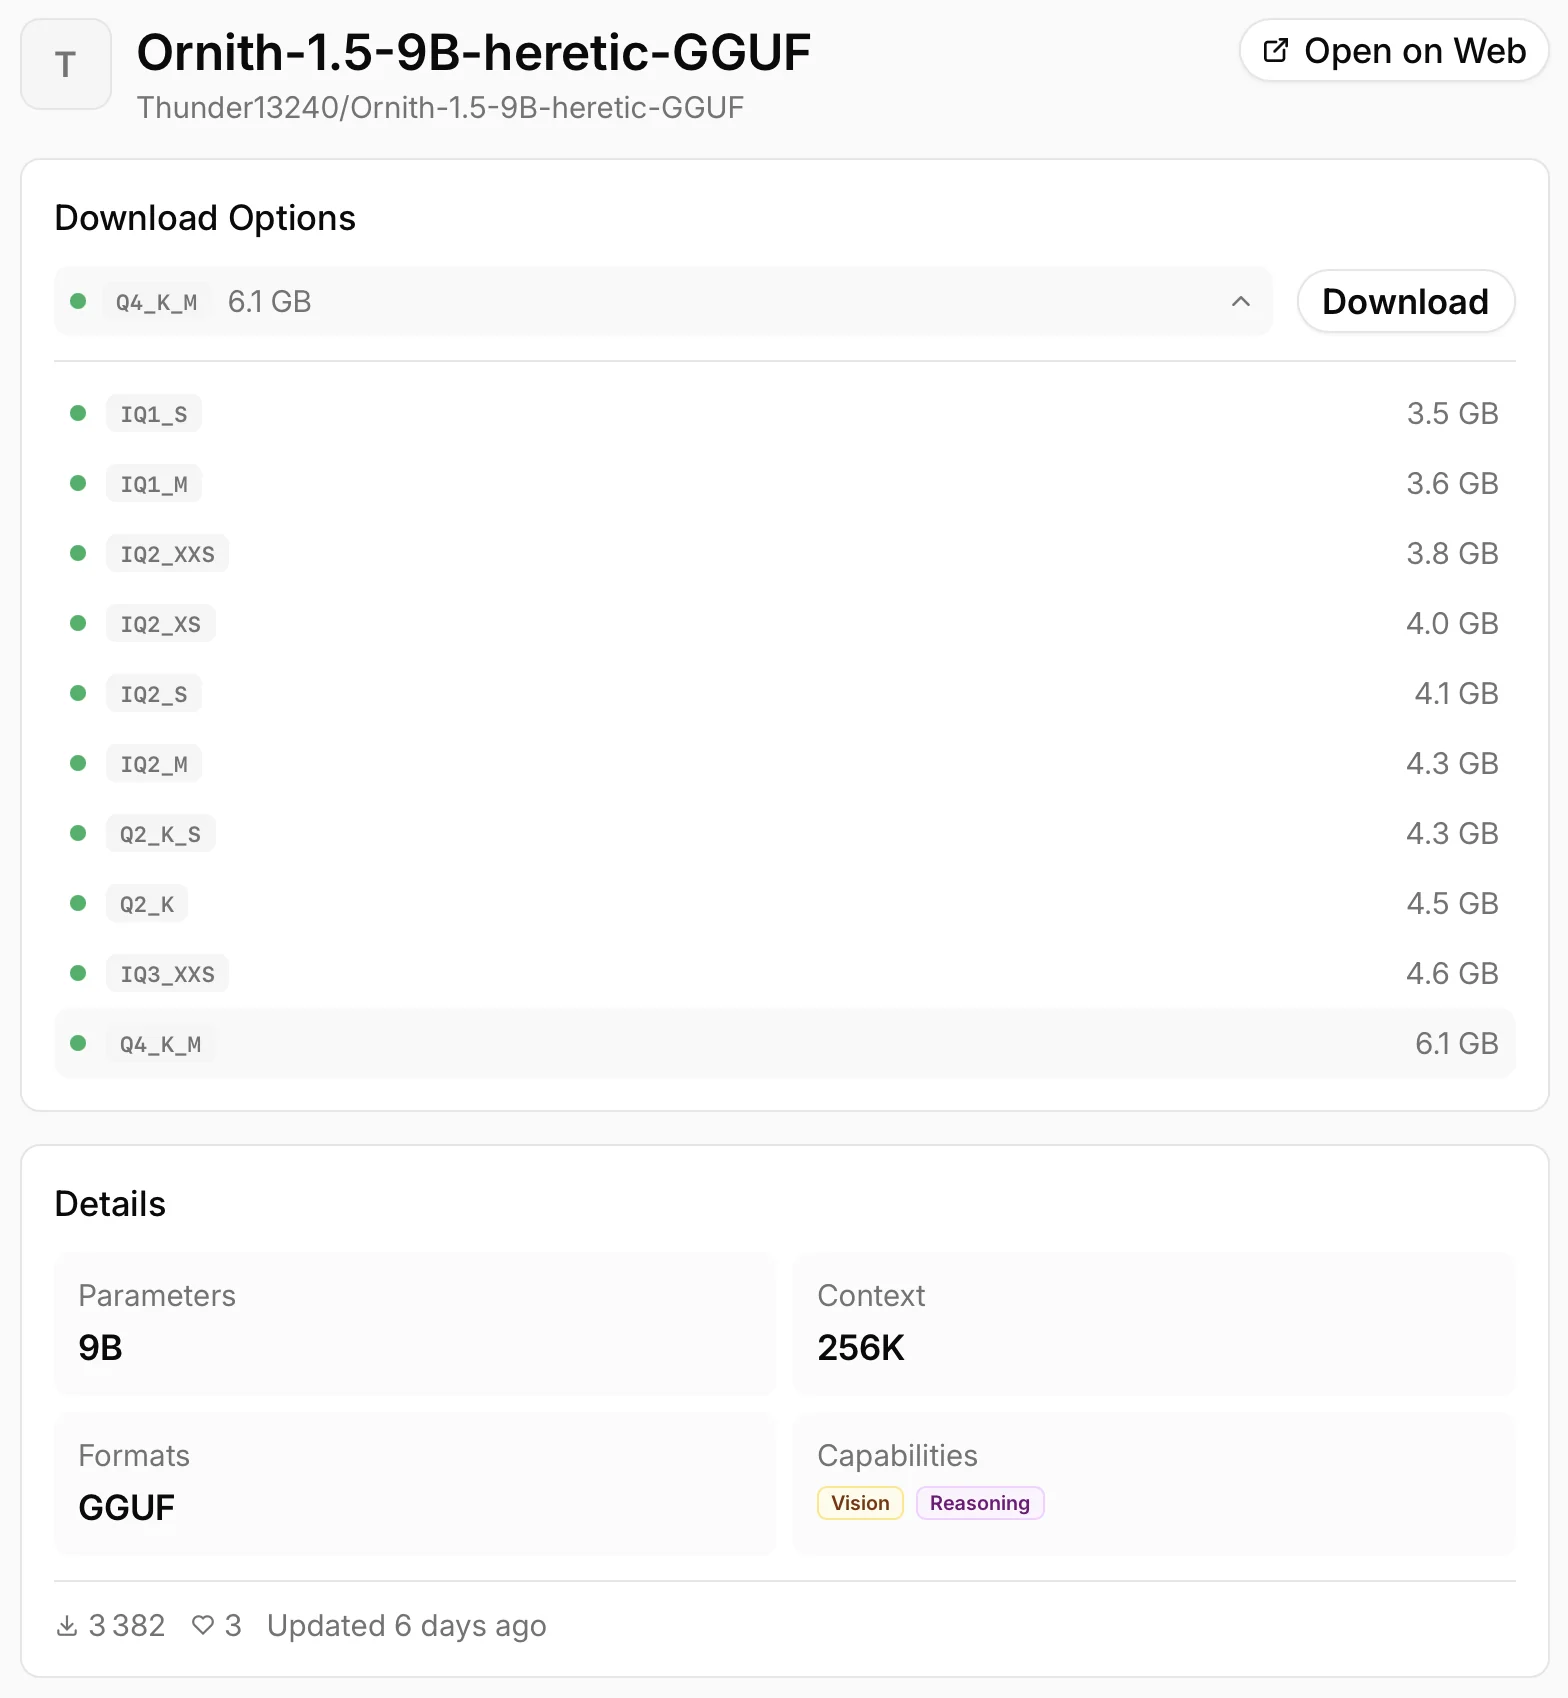
Modelsを開き、モデル名またはHugging Faceのリポジトリ名全体で検索します。スクリーンショットと同じ例を探す場合は、Thunder13240/Ornith-1.5-9B-heretic-GGUFと入力します。
ダウンロード前に、公開者とモデルカードを確認してください。ベースモデルとコミュニティ製の無検閲ビルドには、よく似た名前が付いていることがあります。この例のビルドの選び方と制約は、Ornith 1.5無検閲版のガイドで解説しています。
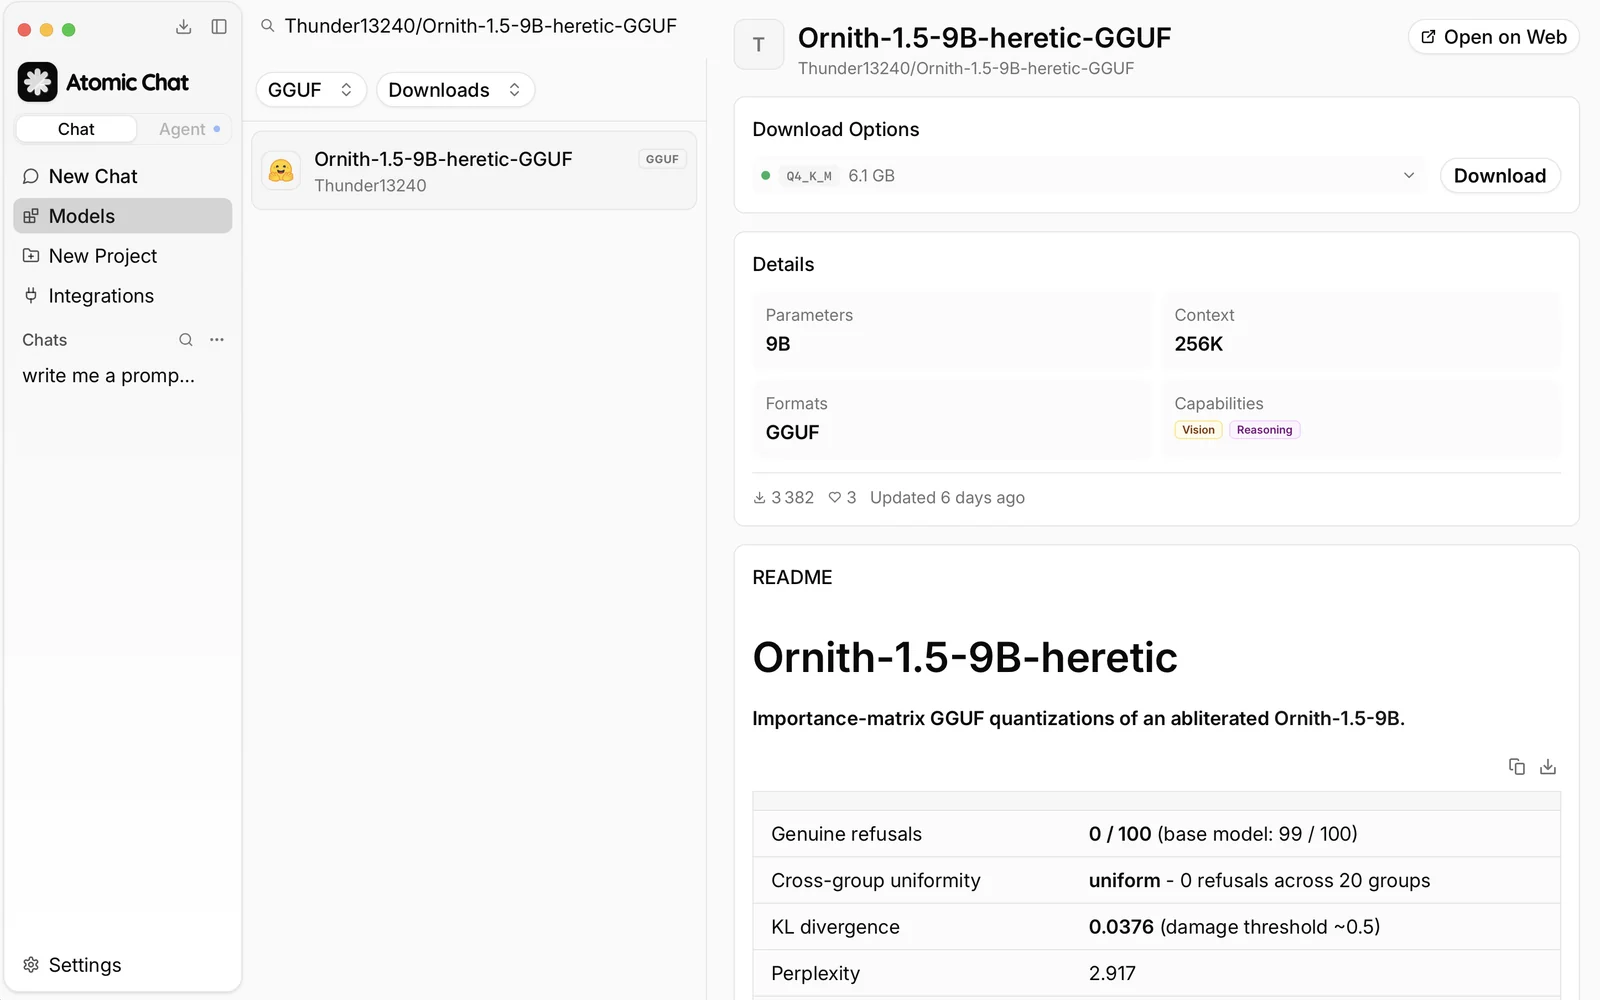
ステップ3:量子化版を選んでダウンロードする
Download Optionsを開き、自分のハードウェアに収まる量子化版を選びます。コンテキストと実行環境のためのメモリも残してください。重みファイルのダウンロードサイズは、実行時に必要なRAMやVRAMの総量とは異なります。この例の数値ではなく、選んだビルドの要件を確認します。
Downloadをクリックします。量子化のタグに馴染みがない場合は、GGUFのガイドで形式と量子化版の選び方を確認できます。
ステップ4:コンテキストの設定を確認する
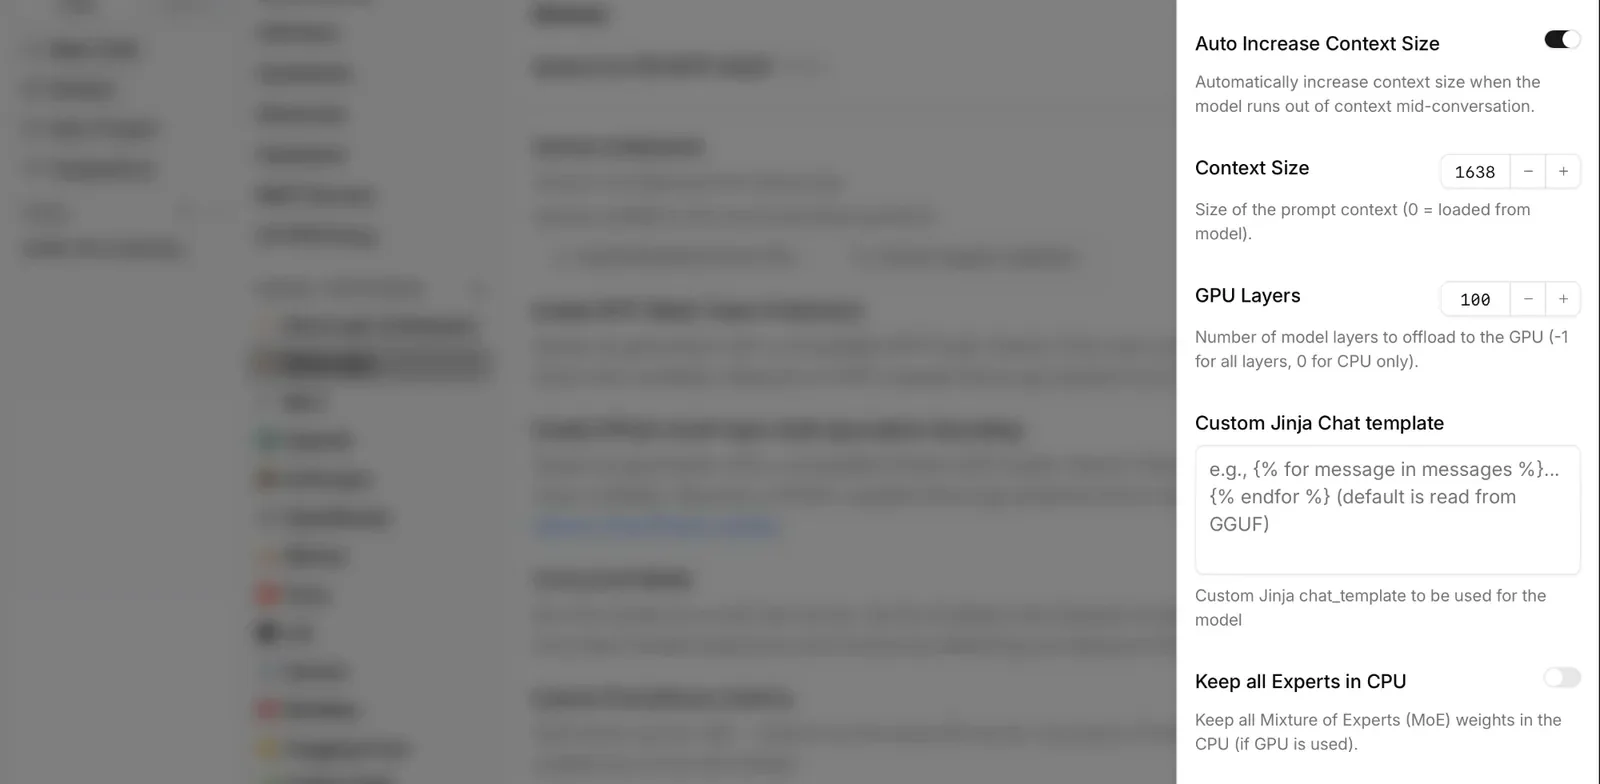
Settings → Model Providers → Llama.cppを開き、ダウンロードしたビルドの歯車アイコンをクリックします。用途と空きメモリに合わせてContext Sizeを設定してください。長いコンテキストほど多くのメモリを使うため、モデルだけでメモリの大半を使う場合は、最初から最大値に設定しないようにします。
メモリの上限に近い場合は、会話中にコンテキストが拡大しないようAuto Increase Context Sizeをオフにします。サンプリングや思考モードの設定は、選んだモデルのガイドに従ってください。すべてのモデルに同じ値が適しているわけではありません。
ステップ5:ローカルでチャットを始める
ダウンロードが完了したら、チャットでモデルを読み込み、最初のプロンプトを送る前にモデル名を確認します。自分で良し悪しを判断できる文章作成やコーディングの課題を試し、回答を見直してください。無検閲ビルドでも、事実やコードを間違えることがあります。ローカルモデルは、入力したプロンプトをデバイス上で処理します。
よくある質問
2026年におすすめの無検閲LLMは?
独自ベンチマークではGemma Abliterated 9Bが総合的に最も優れていました。すべてのプロンプトに回答し、ベースモデルの推論能力をほぼ保ちながら(MMLUは68.0、アラインメント済み版は68.4)、12 GBのGPUに収まります。コードにはDolphinCoderまたはQwen 3.6 Uncensored、創作やロールプレイにはNous Hermes 3が候補です。後者の文章は、チャットモデルより共同制作者に近い印象です。24 GB以上のGPUがあれば、測定した中で最も高い推論スコアを記録したDolphin-Mistral 24B(MMLU 75)が選べます。
Ollamaで使える無検閲モデルは?
Dolphin、Hermes、Gemma、Qwen、Mistralなどの人気のオープンウェイトモデルに加え、多くのLlama派生モデルやコミュニティのファインチューニング版をOllamaで実行できます。ダウンロード前に、使いたいモデルのOllama対応版があることを確認してください。
ノートPCで無検閲LLMを実行できますか?
はい。最近の7B・8Bモデルは、特に4ビット版なら多くのノートPCで快適に動作します。専用GPUがあるほうが高速で、Apple Silicon搭載Macはユニファイドメモリにより特に良好な性能を発揮します。専用GPUがなくても、小型モデルならCPUで実行できますが、速度は低下します。
無検閲モデルは精度が低いのですか?
アラインメントを弱めても、事実の正確さが自動的に上がったり下がったりするわけではありません。私たちのテストでは、無検閲版のMMLUスコアはアラインメント済みのベースモデルから1〜2ポイント以内でした。他のモデルと同様に誤った情報を生成する可能性があるため、モデルを問わず重要な出力は再確認してください。
コードに最も適した無検閲モデルは?
Dolphin 3.0、Qwen 3.6 Uncensored、DolphinCoderは、コード生成、デバッグ、リファクタリングなどのソフトウェア開発で、常に有力な候補に挙げられます。
無検閲LLMは合法ですか?
多くの国では、モデルのライセンスと現地の法律に従う限り、重みが公開されたモデルをローカルで実行することは合法です。
無検閲モデルをダウンロードしても安全ですか?
モデルの重みはプログラムではなくデータです。それでも、よく知られた配布元やメンテナーを選び、GGUFやMLXのような標準的な形式を優先し、推論ツールを最新に保つべきです。ローカル実行ではプロンプトとドキュメントは自分のマシンにとどまり、第三者のサーバーには送信されません。
まとめ
無検閲LLMは、基盤となる推論能力を維持しながら、ファインチューニングやabliterationによって拒否層を弱めるか取り除いた、重みが公開されているモデルです。検閲がないだけで正確さや能力が高まるわけではありません。正当なプロンプトを断らなくなることと、ローカル実行によりデータがマシンから出ないことが特徴です。独自ベンチマークでは、そのトレードオフが明確になりました。Abliterationは、能力への影響をほぼ抑えて過剰拒否を除去しますが、安全策の大部分も取り除きます。両者が重み内の同じ方向に依存しているからです。プライバシーと管理権を重視する場面で無検閲モデルを使い、VRAMに合ったサイズと量子化を選び、自分が唯一の安全策になると理解したうえで利用しましょう。




