

Qwenは、一般向けノートPCから複数GPUを搭載したワークステーションまで、幅広いハードウェアで動作するよう設計されたAlibaba Cloudのオープンウェイト大規模言語モデル(LLM)ファミリーです。すでにお持ちのハードウェアでQwenモデルをローカル実行できます。
このガイドでは、次の内容を解説します。
- ローカル推論エンジンをインストールする方法
- ハードウェアに合ったQwenモデルを選ぶ方法
- 互換性のあるGGUF形式のファイルをダウンロードする方法
- Atomic ChatでQwenモデルをローカル実行する方法
Qwenとは?
Qwenは、モデルの重みが一般公開されているAlibaba Cloudのオープンウェイト基盤モデルファミリーです。
以下の表は、現在のオープンウェイトQwenモデルのラインアップです。
| モデル | アーキテクチャ | 主な用途 |
|---|---|---|
| Qwen3.5 0.8B | 密 | 軽量アシスタント、モバイル端末 |
| Qwen3.5 2B | 密 | 汎用ローカルAI |
| Qwen3.5 4B | 密 | 一般向けハードウェアで日常的に使える高性能モデル |
| Qwen3.5 9B | 密 | コーディング、推論、より高品質なチャット |
| Qwen3.6 27B | 密 | 高度なコーディングと複雑な推論 |
| Qwen3.6 35B A3B | Mixture-of-Experts(MoE) | 効率を高めたハイエンドの推論 |
35B A3Bモデルは、Mixture-of-Experts(MoE)アーキテクチャを採用している点で特筆すべきモデルです。モデル全体には約350億個のパラメータがありますが、生成するトークンごとに有効になるのは約30億個のパラメータだけです。これにより、はるかに大きなモデルの能力の多くを維持しながら、推論時の計算コストを削減できます。
記事の後半では、各Qwenモデルの実行に必要なハードウェアを解説します。
現在のQwenオープンウェイトモデルはすべてマルチモーダルで、テキストと画像の両方を処理できます。Qwen3.6モデルは動画も処理できます。
Qwen 3.8世代には専用のガイドがあります。デンスモデルの27BについてはQwen 3.8 27Bをローカルで実行する方法を、Qwen4アーキテクチャを先行採用した125BのMoEについてはQwen3.8 Flash Nextをローカルで実行する方法をご覧ください。
コミュニティは、これらの重みを編集して回答を拒否する挙動を取り除いたバージョンも公開しています。Qwen 3.8 27Bのビルドについては、無検閲版Qwen 3.8 27Bをローカルで実行する方法のガイドをご覧ください。
Qwenをローカルで実行する方法
ローカル推論環境のセットアップについて説明します。
Qwenをローカルで実行するには、モデルファイルをダウンロードし、お使いのマシンで実行できるアプリケーションが必要です。つまり、Qwenをローカルにインストールするには、まず推論アプリをセットアップし、そのアプリからモデルの重みをダウンロードします。
このガイドでは、私たちが開発した無料のオープンソースのローカルAIアプリケーション、Atomic Chatを例に説明します。
Qwenの実行にはGGUFファイルを使います。これは、OllamaやLM Studioなど、広く使われている推論エンジンやアプリケーションが対応する標準形式です。そのため、このガイドの手順を進めるうえでAtomic Chatは必須ではありませんが、もちろん使っていただけます。
また、ローカルAIを使い始めたばかりの方は、LLMをローカルで実行する方法のガイドも参考になります。ローカル推論、モデル形式、推論エンジンの基本的な概念を解説しています。
1. Atomic Chatをインストールする
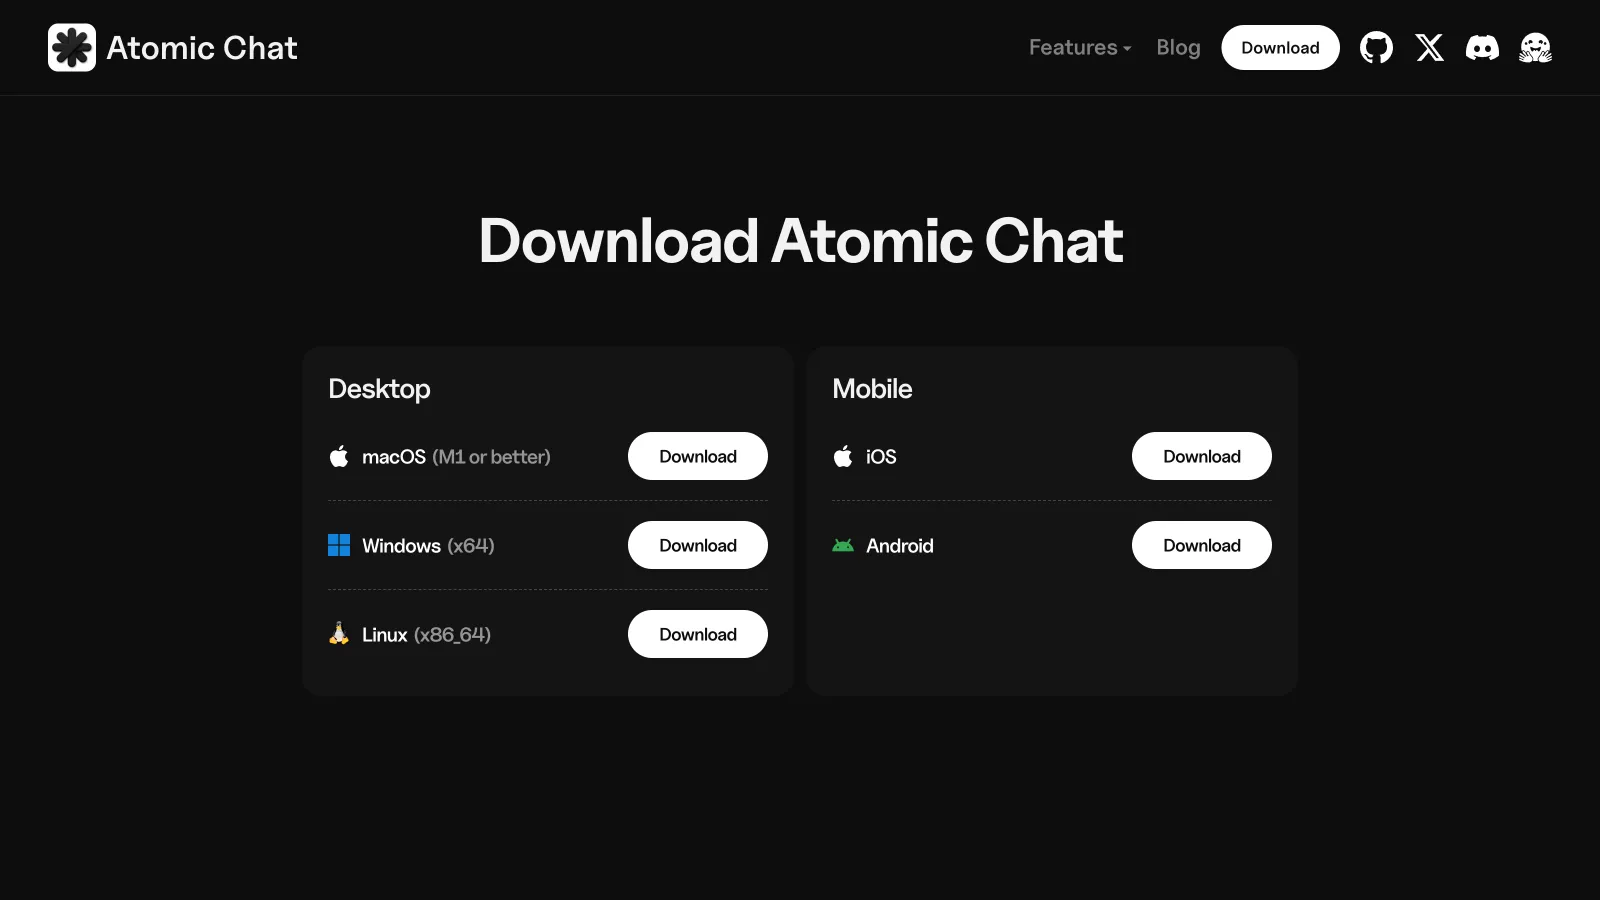
Atomic Chatを使って進める場合は、次の手順でインストールします。atomic.chatにアクセスし、お使いのプラットフォーム向けのビルドを選択してください。
- macOS:Apple Silicon(M1以降)向けのユニバーサル
.dmg。 - Windows:x64向けの
.exeインストーラー。 - Linux:root権限を必要としない、x86_64向けの自己完結型
.AppImage。 - iOS:App Storeから入手。
- Android:Google Playから入手。
Linuxでは、chmod +xでAppImageに実行権限を付与し、直接実行します。初回起動時にアプリからFUSEについての案内が表示された場合は、DebianまたはUbuntuではsudo apt install fuse libfuse2、Fedoraではsudo dnf install fuse fuse-libsでインストールしてください。
2. Qwenモデルを探す
Atomic Chatをインストールしたら、アプリケーションを開き、Modelsに進みます。Modelsカタログには、Hugging Faceで公開されている実行可能なオープンウェイトモデルがすべて表示され、ローカルLLMの閲覧、ダウンロード、管理を簡単に行えます。
Qwenを検索するには、検索ボックスをクリックし、qwenと入力します。利用可能なQwenモデルが表示されます。

モデルカードには次の情報が表示されます。
- パラメータ数:モデルの規模です。たとえば、Qwen3.6 27Bでは27Bです。
- コンテキスト長:モデルが対応する最大コンテキストウィンドウです。
- タグ:GGUF(モデル形式)やVision(マルチモーダル処理に対応しているかどうか)などのメタデータです。
- ダウンロードサイズ:選択したモデルファイルがディスク上で占める容量です。
デフォルトでは、結果はリリースの新しい順に並びます。Downloadedフィルターを有効にすると、すでにお使いのマシンで利用可能なモデルだけを表示することもできます。
3. Qwenモデルをダウンロードする
モデルの推奨バージョンをダウンロードするには、Downloadをクリックします。
特定の量子化版を選びたい場合は、Download Optionsを選択すると、利用可能なすべてのGGUFリリースを確認できます。

通常、1つのモデルには複数の量子化版が用意されています。たとえば、Qwen3.6 27Bには次のようなバリエーションがあります。
- IQ2_XXS
- Q3_K_M
- Q4_K_M
- Q8_0
これらは量子化レベルを表し、モデルの重みがどのように圧縮されたかを示しています。小さい量子化版(IQ2)は必要なストレージ容量とメモリが少なく、大きい量子化版は一般に元のモデルの精度をより多く維持します。詳しくは、GGUFとは何か、量子化はどのように機能するかをご覧ください。
記事の後半では、お使いのシステムに合った量子化版の選び方を解説します。
4. Qwenとのチャットを始める
ダウンロードが完了すると、Atomic Chatが自動的にモデルを読み込み、内蔵のチャット画面で開きます。
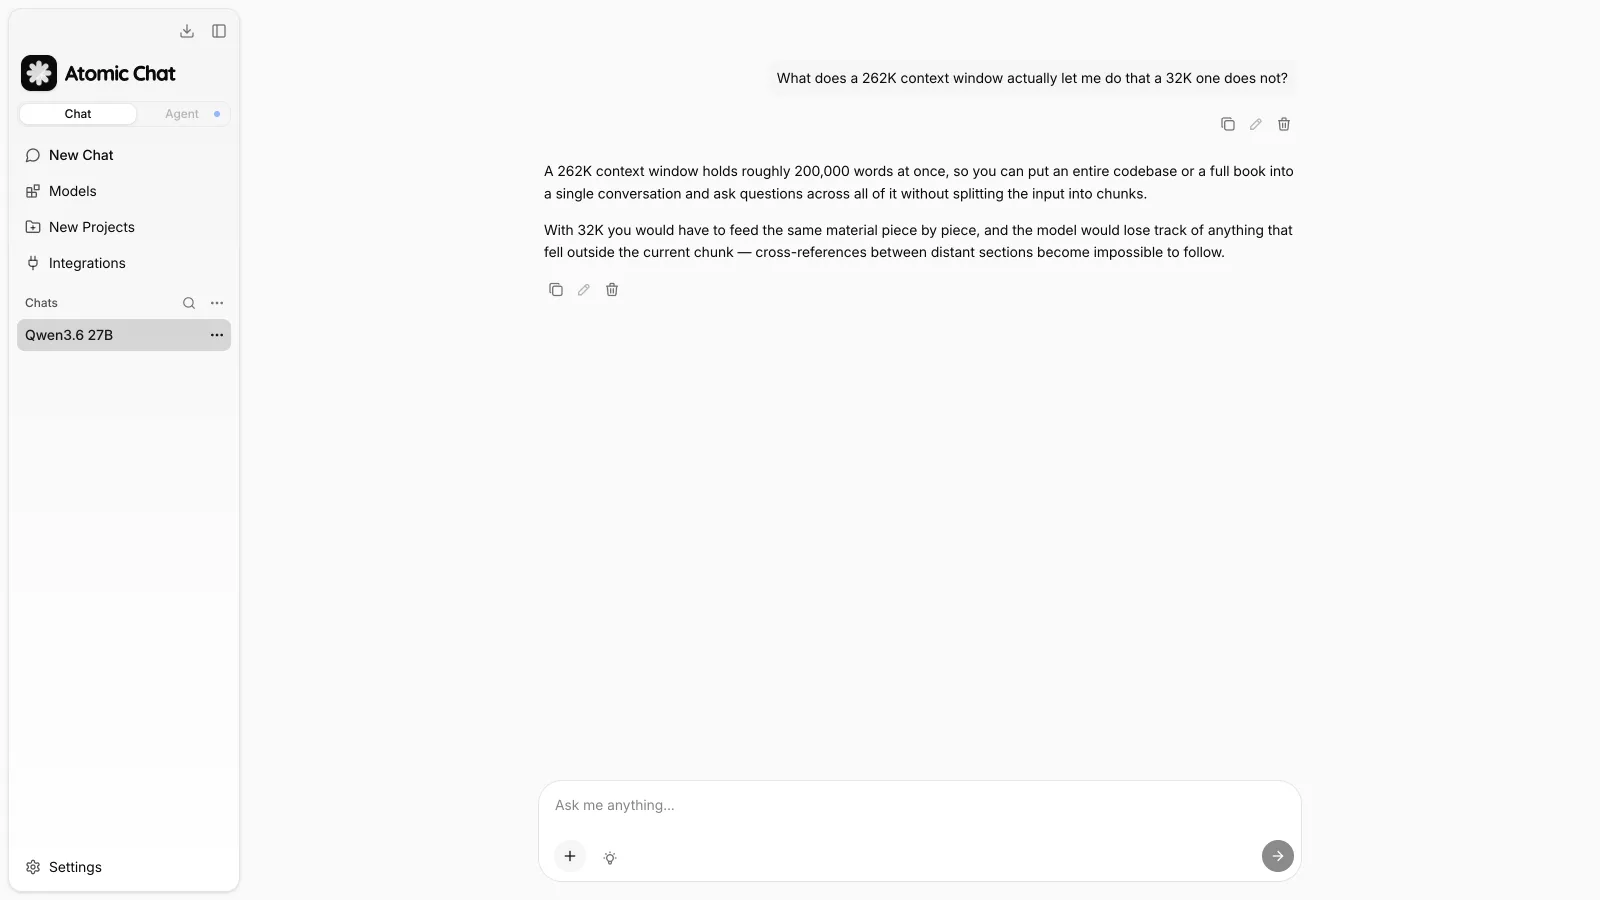
これで完了です!ここからすぐにQwenとのやり取りを始められます。
推論はすべて自分のマシン上で実行されるため、リモートサーバーにプロンプトを送信せずにQwenを使えます。会話はローカルに保存され、モデルはダウンロード後であればインターネット接続がなくても動作し続けます。また、ローカルでの実行に伴うAPIの利用制限やサブスクリプション料金はありません。
Qwenのハードウェア要件
Qwenのシステム要件は、ほぼメモリで決まります。以下の表は、各Qwenモデルを一般的な量子化レベルで読み込む際に必要なメモリの目安をまとめたものです。
| モデル | 3ビット | 4ビット | 8ビット | BF16 |
|---|---|---|---|---|
| Qwen3.5 0.8B~2B | 3 GB | 3.5 GB | 7.5 GB | 9 GB |
| Qwen3.5 4B | 4.5 GB | 5.5 GB | 10 GB | 14 GB |
| Qwen3.5 9B | 5.5 GB | 6.5 GB | 13 GB | 19 GB |
| Qwen3.6 27B | 14 GB | 17 GB | 30 GB | 54 GB |
| Qwen3.6 35B A3B | 17 GB | 22 GB | 38 GB | 70 GB |
これらの数値は、モデルの重みに必要なメモリだけを対象としています。実際には、推論エンジンがモデルの実行時に使うメモリも確保する必要があるため、推論中の総メモリ使用量はこれより多くなります。
追加で確保されるメモリのうち、最も大きいのがKV(キー・バリュー)キャッシュです。Attentionの中間データを保存し、モデルが会話内の過去のトークンを効率よく処理できるようにします。
KVキャッシュをどう見積もるか
モデルの重みとは異なり、KVキャッシュは動的で、コンテキストウィンドウが埋まるにつれて大きくなります。たとえば、モデルが128,000トークンのコンテキストを使い切ると、メモリ使用量が数ギガバイト増える場合があります。
Qwen3.6の利点の1つは、従来のデンス型Transformerよりもアーキテクチャのメモリ効率が大幅に高いことです。ハイブリッドなAttention設計とGrouped Query Attention(GQA)を組み合わせることで、推論中に保存する必要があるKVキャッシュの量を削減します。その結果、長いコンテキストを扱うワークロードでは、すべての層でフルAttentionを使う同規模のモデルに比べ、メモリ消費が大幅に少なくなります。
それでも、ハードウェアを検討する際にはキャッシュを考慮する必要があります。一般的な4ビット量子化でQwen3.6 27Bを実行する場合、追加で必要になるメモリの目安は次のとおりです。
| コンテキスト長 | 追加メモリ |
|---|---|
| 8K(通常のチャット) | <1 GB |
| 32K(長い文書) | 約1~2 GB |
| 128K(大規模なコードベース) | 約4~6 GB |
| 262K(ネイティブの最大コンテキスト) | 約8~12 GB |
ハードウェアに合ったQwenモデルを選ぶ
特に重要なのは、メモリをどう使うかを決めることです。精度の低い量子化を使った大きなモデルに割り当てるか、精度の高い小さなモデルに割り当てるかを選びます。
多くの場合、大きなモデルのほうが適しています。
たとえば、4ビット量子化と3ビット量子化の違いが出力品質に与える影響は、通常、270億パラメータのQwen3.6 27Bから90億パラメータのQwen3.5 9Bにモデルを小さくする場合よりも小さくなります。
したがって、目指すのは利用可能なメモリを使い切らずに収まる最大のモデルを実行することです。
以下の推奨構成は、一般的な量子化レベルを想定し、OSとモデルの実行時に必要なメモリのために十分な余裕を残しています。
| ハードウェア | 無理なく動作するモデル |
|---|---|
| MacBook Air M2/M3(16 GB) | Qwen3.5 9BのQ4版 |
| MacBook Pro M4 Pro(24 GB) | Qwen3.6 27BのQ3版、またはQwen3.5 9BのQ8版 |
| MacBook Pro M4/M5 Max(36~48 GB) | Qwen3.6 27BのQ4版、またはQwen3.6 35B A3BのQ4版 |
| Mac Studio M3 Ultra(96 GB以上) | Qwen3.6 27BのBF16版、またはQwen3.6 35B A3BのQ8版 |
| RTX 4060 Ti / RTX 5060 Ti(16 GB VRAM) | Qwen3.5 9BのQ8版、またはQwen3.6 27BのIQ2版 |
| RTX 4080 / RTX 5070 Ti(16 GB VRAM) | 同じモデルを、より高速に推論 |
| RTX 4090 / RTX 5090(24~32 GB VRAM) | Qwen3.6 27BのQ4版、またはQwen3.6 35B A3BのQ4版 |
| RTX 3090 / RTX 4090を2基(48 GB VRAM) | Qwen3.6 27BのQ8版 |
専用GPUを搭載したPCを使う場合、理想的な構成はモデル全体をGPUのVRAM内に収めることです。モデルが利用可能なVRAM容量を超える場合、多くの推論エンジンでは一部の層をシステムRAMにオフロードし、それらの層をCPUで実行できます。
これにより大きなモデルを実行できますが、生成速度が大幅に低下することがあります。その理由は、LLMの推論の仕組みにあります。
- トークン生成はメモリ帯域幅によって大きく制限されます。トークンを1つ生成するたびに、モデルの重みの大部分を繰り返し読み込む必要があります。一般的なシステムRAMの帯域幅は60~100 GB/s程度ですが、最新のGPUではVRAMを通じて数百GB/s以上の帯域幅を利用できます。
- 各トークンはすべての層を順番に通過します。一部の層をGPUで、残りをCPUで実行する場合、生成の各ステップで高速なGPU側の処理が低速なCPU側の処理を待つ必要があります。そのため、CPUへのオフロードが少量でも、応答性に大きな影響を与えることがあります。
このため、システムメモリを常に使わなければならない大きなモデルを実行するよりも、容量が少し小さく、全体がVRAMに収まる量子化版を選ぶほうが通常は適しています。
QwenのGGUF量子化版はどれをダウンロードすべき?
量子化モデルは、すべての重みをフル精度で保存する代わりに、値ごとのビット数を減らし、わずかな精度低下と引き換えにメモリ使用量を大幅に削減します。
一般的なGGUF量子化形式には、次のものがあります。
- Q4_K_M
- Q5_K_M
- Q6_K
- Q8_0
- BF16
Qwenモデルでは、できれば動的量子化を採用したビルドを探してください。UD-という接頭辞で見分けられ、たとえばUD-Q4_K_XLが該当します。動的量子化は、各層の重要度に応じて精度を調整します。モデルのうち精度の変化に敏感な部分には多くのビットを割り当て、重要度の低い部分はより強く圧縮します。これにより、動的量子化ビルドは同程度のファイルサイズで、元のモデルの品質をより多く維持できます。
Qwenのベンチマーク
以下の表は、共通の採点システムでさまざまなモデルを評価するArtificial AnalysisのIntelligence IndexにおけるQwenモデルのスコアを示しています。ここではGemini 3.6 Flashを比較基準として使用しています。
| モデル | Intelligence Index | 4ビットでのメモリ使用量 | ローカル実行 |
|---|---|---|---|
| Gemini 3.6 Flash | 50 | — | 不可、クラウドのみ |
| Qwen3.6 35B A3B | 32 | 22 GB | 可 |
| Gemma 4 31B | 29 | 17.5 GB | 可 |
| Qwen3.5 9B | 21 | 6.5 GB | 可 |
| Qwen3.5 4B | 20 | 5.5 GB | 可 |
現在のプロプライエタリなクラウドモデルと比べると、予想されるとおり、ローカルのQwenモデルは依然として能力面で一部を妥協する必要がありますが、一般向けハードウェア上でローカル実行できるという利点があります。
Qwen3.6モデルファミリーは公開されているベンチマークでより幅広く評価されているため、以下の表ではMMLU-Pro、SWE-bench Verified、AIME、GPQA Diamondでの性能も確認できます。
| ベンチマーク | Qwen3.6 27B | Qwen3.6 35B A3B | 評価対象 |
|---|---|---|---|
| MMLU-Pro | 86.2% | 85.2% | 幅広い学術分野における知識と推論 |
| SWE-bench Verified | 77.2% | 73.4% | 実際のソフトウェアエンジニアリングの課題を解決する能力 |
| AIME 2026 | 94.1% | 92.7% | 高度な数学的推論 |
| GPQA Diamond | — | 86.0% | 専門家レベルの科学の問題 |
よくある質問
Qwenのローカル実行について、特によくある質問に簡潔に答えます。
Qwenをローカルで実行するには、どれくらいのRAMまたはVRAMが必要ですか?
Qwenをローカルで実行するには、モデルと量子化レベルに応じて約3~22 GBのメモリが必要です。Qwen3.5 0.8Bや2Bなどの最小クラスのQwenモデルは、わずか数ギガバイトのメモリで動作しますが、大きなモデルでは大幅に多くのメモリが必要になります。
- Qwen3.5 9B:4ビット量子化で約6.5 GB
- Qwen3.6 27B:4ビット量子化で約17 GB
- Qwen3.6 35B A3B:4ビット量子化で約22 GB
これらの数値は、GPU推論に必要なVRAM容量でもあります。Apple Silicon搭載Macでは、ユニファイドメモリにも同じ数値が当てはまります。目安として、Qwen 3.6をローカルで実行するには少なくとも16 GBを用意したいところですが、Qwen 3.5モデルは8~16 GBのシステムで無理なく動作します。
どのQwenモデルを使うべきですか?
Qwen3.5 9Bは、優れた品質を備えながら、多くの一般向けマシンに収まる小ささを維持しているため、標準的な選択肢として適しています。お使いのハードウェアがより大きなモデルに対応できる場合は、Qwen3.6 27Bを選んでください。推論とコーディングで、より高い性能が得られます。
Qwenはオフラインで動作しますか?
はい、Qwenはモデルのダウンロード後、完全にオフラインで動作します。ローカル推論アプリケーションで使用する場合、プロンプトと応答はお使いの端末上で処理されます。通常の利用に、APIのサブスクリプション、クラウドサービス、インターネット接続は必要ありません。
QwenはAndroidやiPhoneで動作しますか?
はい、小型のQwenモデルはモバイル端末で動作します。Qwen3.5 0.8Bと2Bは必要なメモリが少ないため、スマートフォンで実行できます。Atomic Chatには両プラットフォーム向けのモバイルアプリがあります。iPhoneではApp Store、AndroidではGoogle Playからダウンロードすれば、スマートフォンでQwenを直接実行できます。
Qwenは商用利用も無料ですか?
はい、このガイドで紹介するQwenモデルは、Apache 2.0ライセンスのもとで無料で商用利用できます。このライセンスでは、商用利用、改変、再配布が認められています。モデルの重みはアクセス料金を支払わずにダウンロードでき、ローカルでの利用にAPI料金はかかりません。
Qwenはツール呼び出しに対応していますか?
はい、Qwenモデルはツール呼び出しに対応しており、アプリケーションからモデルを外部の関数やサービスに接続できます。Atomic ChatでQwenを実行している場合は、そのモデルを他のアプリケーションから利用できるようにすることもできます。Atomic Chatはhttp://localhost:1337/v1でローカルのOpenAI互換APIサーバーを公開し、リクエストは標準の/v1/chat/completionsルートに送信されます。OpenAI APIに対応するあらゆるツールや、Claude Code、Clineなどのコーディングエージェントで、クラウドモデルをローカルのQwenモデルにそのまま置き換えられます。
まとめ
Qwenはローカルで実行できるオープンウェイト言語モデルファミリーです。このガイドでは、Atomic Chatを推論エンジンの例として、Qwenをダウンロードし、ローカルで実行する方法を解説しました。
要点:
- ローカルで実行できるQwenモデルは、Qwen3.5 0.8B、2B、4B、9B、およびQwen3.6 27B、35B A3Bです。
- 現在のQwenモデルはすべて、262Kトークンのネイティブコンテキストウィンドウに対応しています。
- Qwenモデルは画像をネイティブに処理でき、Qwen3.6は動画にも対応しています。
- QwenのオープンウェイトモデルはApache 2.0ライセンスを採用しています。
- Atomic Chat、LM Studio、Ollamaなど、初心者にも使いやすいローカルAIアプリを使えば、Qwenモデルを簡単にローカルで実行できます。




