

DeepSeek V4 FlashはDeepSeekのV4シリーズの中では小さいモデルですが、それでも総パラメータ数は2,840億あります。そのため、私たちは利用可能な量子化ビルドの中でも特に小さく効率的なものを作成しました。このガイドでは、Atomic Chatまたはllama.cppを直接使ってDeepSeek V4 Flashをローカルで実行する方法を紹介し、Atomic Dynamic GGUFで実行する利点も説明します。
一般消費者向けノートPCで動作するDeepSeek R1の蒸留モデルをお探しの場合は、別記事のDeepSeekをローカルで実行するためのガイドをご覧ください。この記事ではDeepSeek V4 Flashのみを扱います。
DeepSeek V4 Flashとは?
DeepSeek V4 Flashは、DeepSeek V4プレビューの一部として公開された、重みが公開されているMixture-of-Experts言語モデルです。総パラメータ数は284Bで、そのうち13Bがトークンごとに有効化されます。このモデルは、コーディング、推論、エージェント型ワークフロー、非常に長い入力を扱うために設計されています。
| 仕様 | DeepSeek V4 Flash |
|---|---|
| 総パラメータ数 | 284B |
| トークンごとの有効パラメータ数 | 13B |
| アーキテクチャ | 混合エキスパート(Mixture of Experts) |
| 層数 | 43 |
| ルーティング対象エキスパート | 256個、トークンごとに6個が有効 |
| 共有エキスパート | 1 |
| コンテキスト長 | 1,048,576トークン |
| 語彙 | 129,280トークン |
| 公式の重み形式 | MXFP4のエキスパートとFP8/BF16のテンソル |
| 推論モード | Non-think、Think High、Think Max |
| ライセンス | MIT |
DeepSeekはV4ファミリーを32兆を超えるトークンで学習しました。詳しくはDeepSeekの技術レポートをご覧ください。
DeepSeek V4 Flashのベンチマーク
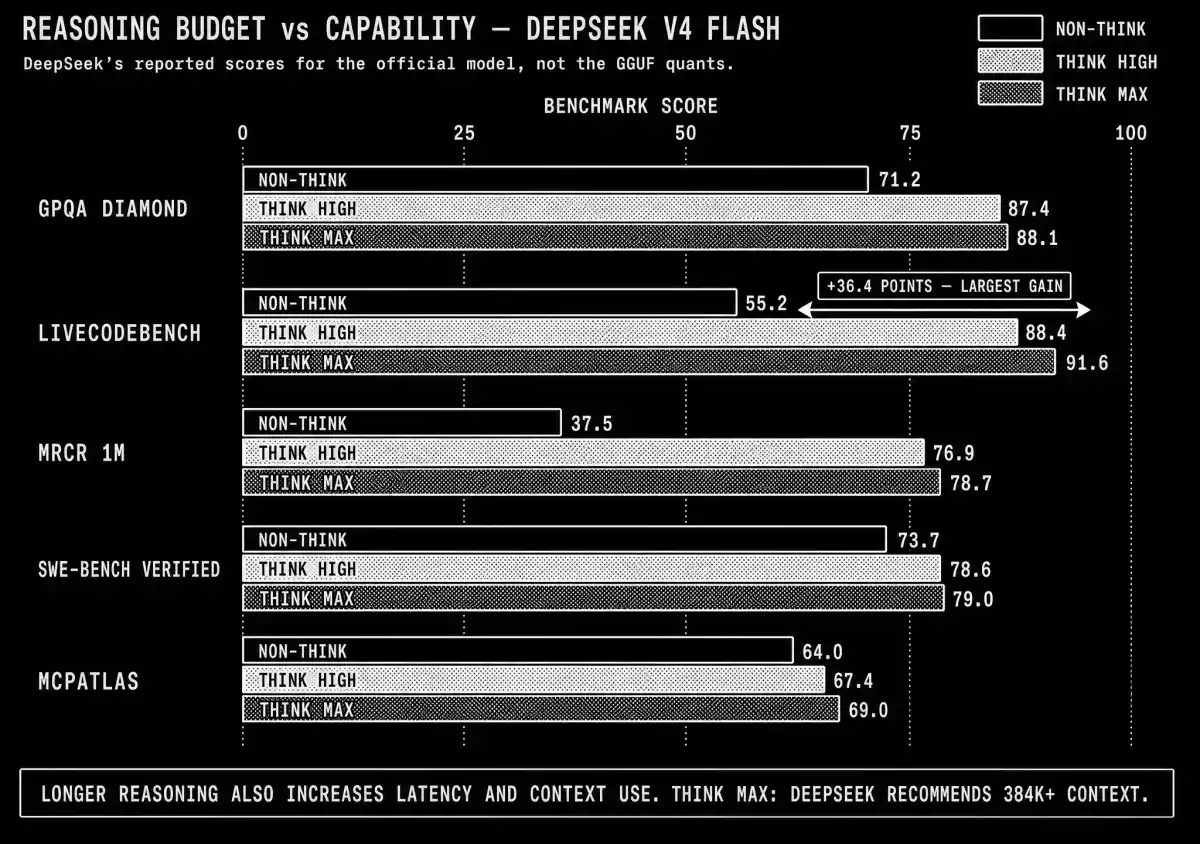
DeepSeekは指示追従モデル向けに3つの推論モードを公開しています。Non-thinkはレイテンシを優先し、Think High、Think Maxの順に、推論に割り当てる計算量が増えます。
| ベンチマーク | Non-think | Think High | Think Max |
|---|---|---|---|
| MMLU-Pro | 83.0 | 86.4 | 86.2 |
| GPQA Diamond | 71.2 | 87.4 | 88.1 |
| LiveCodeBench | 55.2 | 88.4 | 91.6 |
| MRCR 1M | 37.5 | 76.9 | 78.7 |
| SWE-bench Verified | 73.7 | 78.6 | 79.0 |
| BrowseComp | — | 53.5 | 73.2 |
| MCPAtlas | 64.0 | 67.4 | 69.0 |
注:これらはDeepSeekが報告した公式モデルのスコアであり、GGUFビルドのスコアではありません。
推論に割り当てる計算量の影響が最も大きいのはLiveCodeBenchで、Non-thinkモードの55.2からMaxの91.6に上昇します。SWE-bench Verifiedは73.7から79.0に上昇します。
特にローカル推論に関して、DeepSeek V4 Flashには3つの仕組みがあります。
- ハイブリッドアテンション:Compressed Sparse AttentionとHeavily Compressed Attentionが、長いコンテキストでの推論コストを削減します。
- Manifold-Constrained Hyper-Connections:mHCは従来の残差経路を置き換え、ネットワーク内の情報伝播をより制御された方法で行います。
- Muonによる最適化:DeepSeekはMuonオプティマイザを使用し、学習の安定性と収束性を改善しました。
MoEモデルであるDeepSeek V4 Flashは、各トークンの順伝播で13Bのパラメータのみを有効化します。ルーターは後続のトークンで別のエキスパートを選択できるため、284Bのパラメータすべてがモデルの一部として残ります。そのため、次のような特性があります。
- 生成トークンあたりの計算量は、はるかに小さいデンスモデルに近くなります。
- ストレージとメモリには、引き続き70~162 GBのGGUFを収める必要があります。
これにより、本来は対応できなかったハードウェアでも、DeepSeek V4 Flashをローカルで効率よく実行できます(ハードウェア要件については後述します)。特に、効率的な量子化ビルドを使う場合に当てはまります。
DeepSeek V4 Flashを独自に量子化しました
元のDeepSeekチェックポイントには、すでに量子化を考慮した学習が施されています。ルーティング対象のエキスパートがモデルの約96%を占め、重みあたり約4.25ビットのMXFP4で保存されています。残りのテンソルはFP8またはBF16を使用しています。
この重み構成には、モデル固有の量子化戦略が必要です。MXFP4のエキスパートをビット幅の広い型に変換しても、チェックポイントに存在しない情報は復元されず、ファイルサイズが増えるだけです。一方、エキスパートを3ビットより大幅に低く量子化すると、通常のBF16で学習したモデルよりも急速に誤差が増えます。
私たちは公式の重みからAtomicChat DeepSeek V4 Flash GGUFリポジトリを作成し、すべての量子化モデルを同じ評価ハーネスでキャリブレーションして測定しました。
変換プロセスでは、以下の手順を実施しました。
- 元のsafetensorsを遅延評価なしでGGUFに変換しました。このアーキテクチャでは、遅延変換によって
token_embd.weightにNaNが発生しました。 - FP8由来のテンソルを線形のQ8グリッドにマッピングするのではなく、必要な箇所ではBF16として保持しました。
- コード、長いコンテキストを持つ文書、ツール呼び出しのトレース、推論、構造化出力、幅広い語彙を網羅する1,868,626のキャリブレーショントークンから、重要度行列を作成しました。
- モデル全体に1種類の量子化を適用するのではなく、測定した活性化エネルギーに基づいて、テンソルと層ごとに精度を割り当てました。
- パープレキシティ、KLダイバージェンス、Top-1トークン一致率、確率のドリフトを使って、すべての結果をロスレスGGUF参照モデルと比較しました。
ファイル名の接頭辞ADは、Atomic Dynamicを意味します。AD-BF16は、モデル全体をBF16に展開したものではありません。元の混合形式のチェックポイントをGGUFコンテナに保持しており、ソースの重みとバイト単位で一致します。
Atomic Dynamic GGUFの品質とサイズの比較
| 量子化モデル | ファイルサイズ | エキスパートのビット数 | パープレキシティ | 平均KLD | Top-1一致率 |
|---|---|---|---|---|---|
AD-BF16 | 162.1 GB | 4.25 | 4.5289 | 0 | 100.000% |
AD-MXFP4 | 154.5 GB | 4.25 | 4.5446 | 0.1564 | 87.369% |
AD-IQ3_M_XL | 143.6 GB | 3.94 | 4.5490 | 0.1675 | 86.864% |
AD-IQ3_M | 135.8 GB | 3.71 | 4.5695 | 0.1798 | 86.317% |
AD-IQ3_S | 130.8 GB | 3.56 | 4.6016 | 0.1891 | 85.945% |
AD-IQ3_XS | 118.2 GB | 3.20 | 4.6657 | 0.2065 | 85.384% |
AD-IQ3_XXS | 108.1 GB | 2.91 | 4.8491 | 0.2495 | 83.761% |
AD-IQ2_M | 104.0 GB | 2.79 | 4.8822 | 0.2567 | 83.560% |
AD-IQ2_S_XL | 96.8 GB | 2.58 | 5.1406 | 0.3187 | 81.461% |
AD-IQ2_S | 93.4 GB | 2.48 | 5.2152 | 0.3343 | 81.031% |
AD-IQ2_XS | 85.1 GB | 2.25 | 5.4917 | 0.3947 | 79.240% |
AD-IQ2_XXS | 78.5 GB | 2.06 | 5.7878 | 0.4544 | 77.459% |
AD-IQ1_M_XL | 72.8 GB | 1.89 | 6.1786 | 0.5351 | 75.162% |
AD-IQ1_M | 70.2 GB | 1.81 | 6.3813 | 0.5641 | 74.547% |
表の見方:平均KLDは、量子化モデルの出力分布とロスレス参照モデルの出力分布との距離を測定します。値が低いほど良好です。Top-1一致率は、量子化モデルが参照モデルと同じ次のトークンを選択した位置の割合です。単一の総合指標としては、Top-1一致率を使用してください。
品質とサイズの関係を示す曲線の主な変曲点は、104~118 GBの間にあります。104 GBを下回ると、サイズをさらに削減するたびに、忠実度の低下幅が大きくなります。
70~79 GBのビルドは、より高い精度でV4 Flashを読み込めないシステム向けです。4ビットで学習したエキスパートに適した構成として優先されるものではありません。
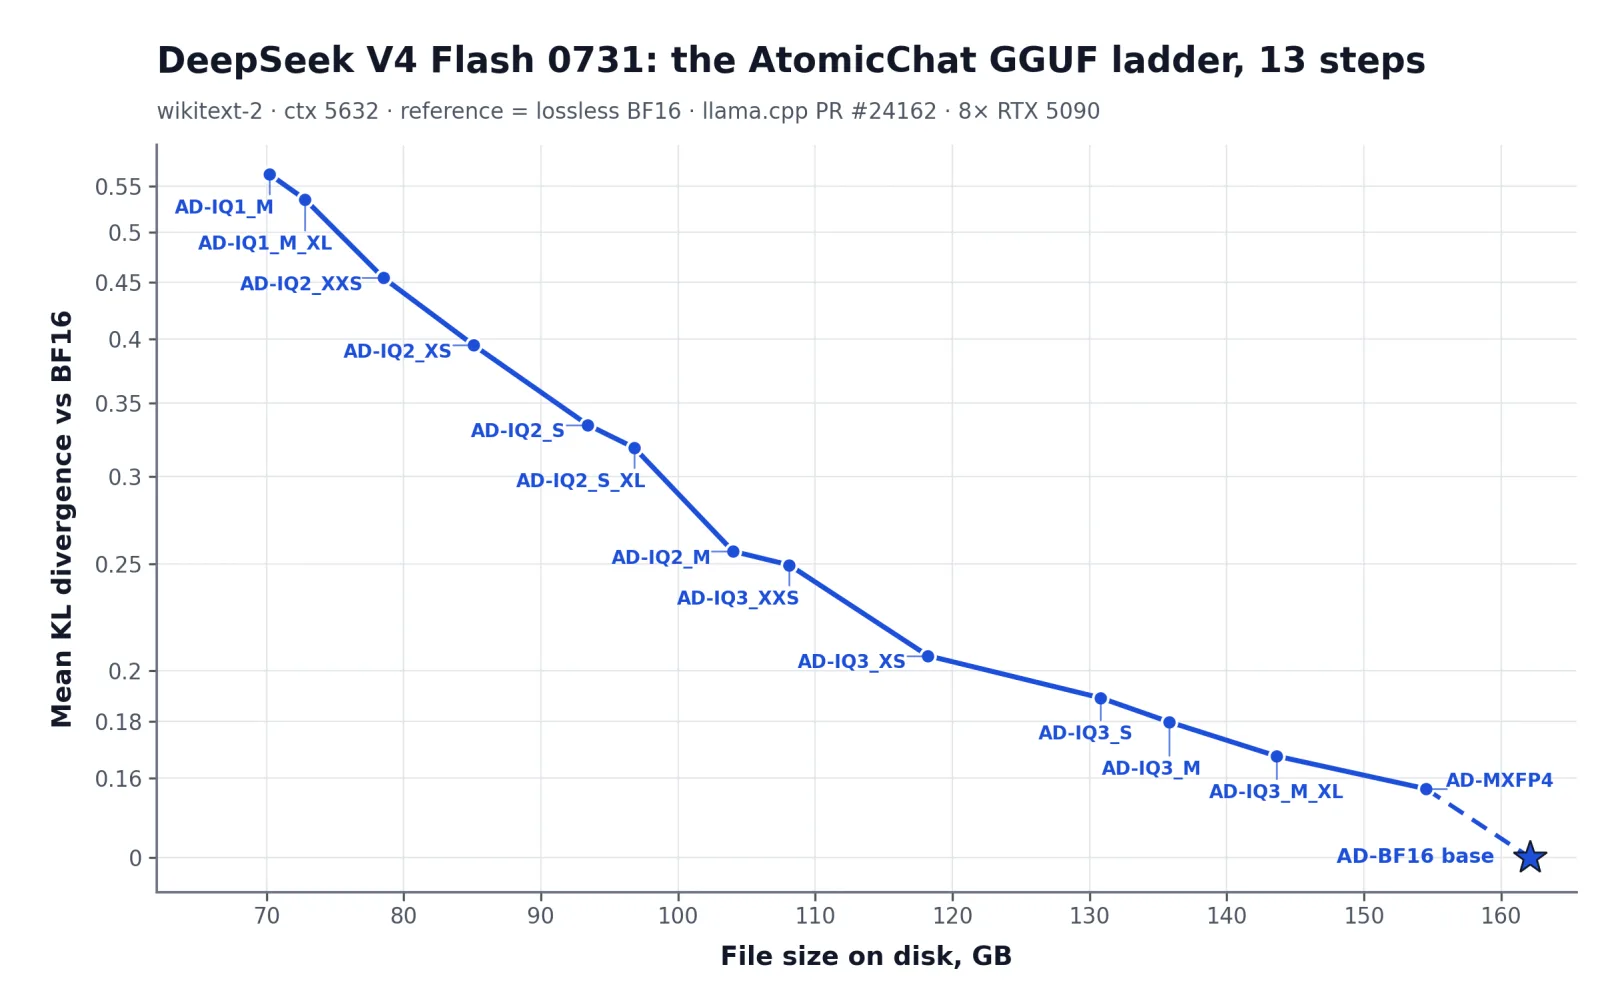
平均KLDは、5,632トークンのコンテキスト長でwikitext-2を使用し、ロスレスのAD-BF16参照モデルに対して測定しました。評価には8× RTX 5090と、PR #24162のllama.cppを使用しました。
同等サイズでの私たちのGGUFの比較
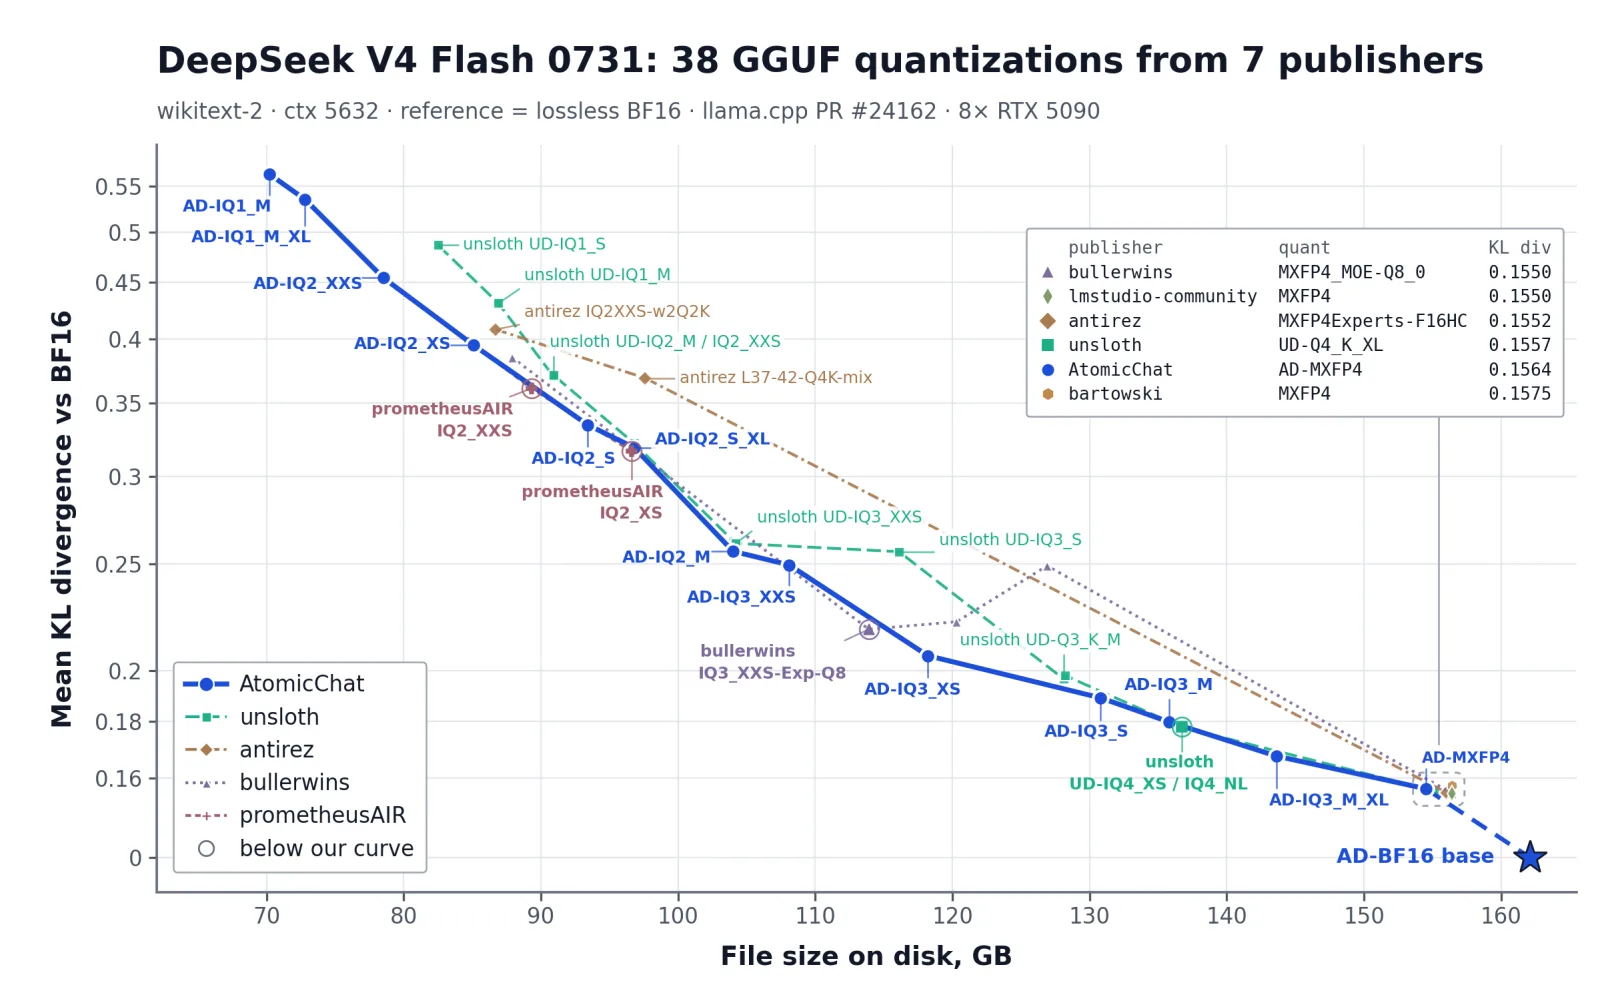
量子化の名称だけでは、サイズを正確に比較できません。エキスパートあたりのビット数がほぼ同じファイルでも、公開元によって異なるラベルが使われることがあります。そのため、すべてのビルドを1つの評価ハーネスで測定しました。
| テスト項目 | 値 |
|---|---|
| コーパス | wikitext-2 |
| コンテキスト長 | 5,632トークン |
| 参照モデル | AD-BF16。元の重みをロスレスで変換したもの |
| 推論用ビルド | llama.cpp、PR #24162 |
| ハードウェア | 8× RTX 5090 |
前のセクションにあるAtomic Dynamicの数値も、同じ構成で測定しました。
| おおよそのサイズ | AtomicChatの量子化モデル | AtomicのKLD | Unslothの量子化モデル | UnslothのKLD |
|---|---|---|---|---|
| 155 GB | AD-MXFP4 | 0.1564 | UD-Q4_K_XL | 0.1557 |
| 136 GB | AD-IQ3_M | 0.1798 | UD-IQ4_XS | 0.1779 |
| 128~131 GB | AD-IQ3_S | 0.1891 | UD-Q3_K_XL | 0.1981 |
| 116~118 GB | AD-IQ3_XS | 0.2065 | UD-IQ3_S | 0.2565 |
| 104 GB | AD-IQ2_M | 0.2567 | UD-IQ3_XXS | 0.2610 |
| 96.8 GB | AD-IQ2_S_XL | 0.3187 | UD-Q2_K_XL | 0.3216 |
約135 GBを超えると、差は測定誤差の範囲内に収まります。118 GBのAD-IQ3_XSは、UD-IQ3_Sより2ギガバイト多く使用しますが、参照分布に約19%近くなります。サイズが完全に一致する104 GBと96.8 GBの2つの比較では、AtomicChatのビルドのほうがKLDは低くなっています。
これらの結果は、同じ評価ハーネスで得られたものです。異なるハードウェアやテスト構成で測定された場合、公開元をまたいでパープレキシティやKLDの絶対値を比較すべきではありません。DeepSeek V4のネイティブMXFP4処理経路では、GPUの世代によって測定可能な結果の差が生じます。
DeepSeek V4 Flashのハードウェア要件
以下のメモリ欄は、使用可能なRAMとVRAMの合計、またはApple Siliconのユニファイドメモリを意味します。
| 使用可能なメモリ | 推奨GGUF | ファイルサイズ | 想定される動作 |
|---|---|---|---|
| 192 GB以上 | AD-BF16 | 162.1 GB | 元のモデルとビット単位で一致し、コンテキスト用の余裕も確保 |
| 160 GB | AD-MXFP4 | 154.5 GB | エキスパートは変更なし。コンテキスト用の余裕はわずか |
| 144 GB | AD-IQ3_M_XL | 143.6 GB | 参照モデルに近い品質。ただし144 GBのシステムでは実行時の余裕が不足 |
| 128 GB | AD-IQ2_M | 104.0 GB | 大型ワークステーションで実用上最もバランスのよい構成 |
| 112 GB | AD-IQ2_S_XL | 96.8 GB | Top-1一致率は引き続き81%超 |
| 96 GB | AD-IQ2_XS | 85.1 GB | 使用可能ですが、目立つドリフトがあります |
| 80 GB | AD-IQ1_M_XL | 72.8 GB | メモリに常駐させる構成として推奨する最小の選択肢 |
| 64 GB以下 | なし | — | 安全な余裕を確保してメモリに常駐できるビルドはありません |
注:メモリがちょうど144 GBのシステムでは、AD-IQ3_MまたはAD-IQ3_Sを使い、残りの容量をコンテキスト用に確保してください。モデルファイルが使用可能なメモリのほぼすべてを占める場合は、常に同じ原則を適用してください。
量子化モデルのサイズ別に測定したスループット
192 GBのHBM3を搭載したAMD MI300Xを1基使用し、5種類のAtomic Dynamicビルドをベンチマークしました。全体をGPUにオフロードし、テンソル並列化もCPUへのオフロードも使用していません。テストにはROCm 7.2.4と、融合V4カーネルを備えたllama.cppを使用しました。
| 量子化モデル | ファイルサイズ | プロンプト処理、512トークン | 生成、128トークン |
|---|---|---|---|
AD-IQ2_M | 96.85 GiB | 615.60 t/s | 37.16 t/s |
AD-IQ3_XXS | 100.70 GiB | 612.88 t/s | 36.92 t/s |
AD-IQ3_S | 121.77 GiB | 652.11 t/s | 37.31 t/s |
AD-IQ3_M | 126.46 GiB | 647.62 t/s | 37.19 t/s |
AD-IQ3_M_XL | 133.77 GiB | 665.47 t/s | 37.75 t/s |
ファイルサイズが1.4倍の範囲で変化しても、生成速度は毎秒36.92~37.75トークンに収まり、その差は実行ごとのばらつきの範囲内でした。このハードウェアでは、DeepSeek V4 Flashはメモリ帯域幅よりも、43層にわたるカーネル起動のオーバーヘッドによって強く制約されます。
DeepSeek V4 Flashを実行できるハードウェアは?
- 192 GBのアクセラレータまたは複数GPUを搭載したサーバー:
AD-BF16またはAD-MXFP4を完全に高速メモリ内で実行できます。 - 128 GBのユニファイドメモリを搭載したMacまたはワークステーション:適度なコンテキスト長で
AD-IQ2_Mを実行できます。 - 96 GBのGPU:
AD-IQ2_XSを実行できます。または、VRAMとシステムRAMを組み合わせれば、速度は低下しますが、より大きな量子化モデルを実行できます。 - 80 GBのアクセラレータ:メモリに常駐させるビルドとして推奨する最小の
AD-IQ1_M_XLを実行できます。これは互換性を確保するための選択肢であり、品質面で目標とする構成ではありません。 - 16~64 GBの一般消費者向けノートPC:DeepSeek V4 Flashはまったく実行できません。代わりに、より小さいモデルを使用してください。
Atomic ChatでDeepSeek V4 Flashをローカル実行する方法
Atomic Chatは、私たちが開発した無料のオープンソースのローカルAIアプリです。Hugging Faceのモデルブラウザを備え、分割GGUFのダウンロードを管理し、llama.cppを手動でビルドすることなくチャットインターフェースを利用できます。Atomic ChatはmacOS、Windows、Linuxで利用できます。
Atomic ChatでDeepSeek V4 Flashを実行する手順は次のとおりです。
ステップ1:最新のAtomic Chatビルドをインストールする
atomic.chatから現在のビルドをダウンロードし、お使いのプラットフォームにインストールしてください。
DeepSeek V4には、新しいビルドを使用してください。llama.cppの本家には、初期のV4実装の後に融合ハイパーコネクションカーネルとCUDA lightning indexerが追加されました。私たちのMI300Xでのテストでは、融合実装によって、同じモデルファイルで生成速度が毎秒16.34トークンから37.27トークンに向上しました。
ステップ2:私たちのDeepSeek V4 Flash GGUFを探す
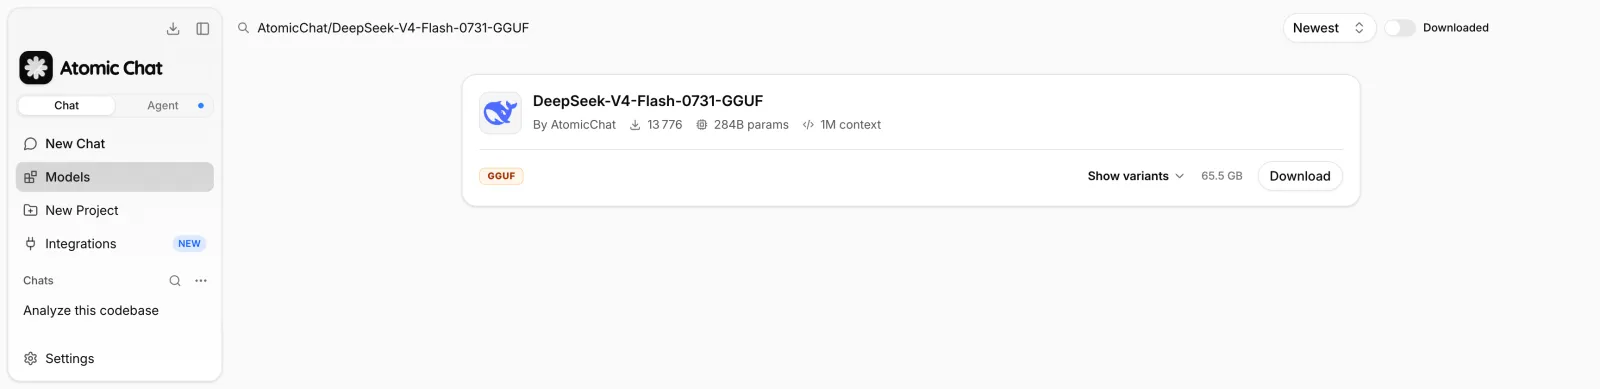
Modelsタブを開き、次を検索してください。
AtomicChat/DeepSeek-V4-Flash-0731-GGUF
AtomicChatが公開している検索結果を選び、Download Optionsを開きます。このリポジトリには、70.2 GBのAD-IQ1_Mビルドから162.1 GBのロスレス変換版まで、複数の分割GGUFが含まれています。
ステップ3:メモリ容量に合う量子化モデルを選ぶ
上記のハードウェア表を参照してください。実行可能な構成のうち、最も一般的なものは次のとおりです。
- 128 GB:
AD-IQ2_Mをダウンロードしてください。 - 112 GB:
AD-IQ2_S_XLをダウンロードしてください。 - 96 GB:
AD-IQ2_XSをダウンロードしてください。 - 192 GB以上:
AD-BF16をダウンロードしてください。
コンテキスト用の余裕を十分に確保したうえで収まる、最大の量子化モデルを選んでください。このモデルでは、104 GBを下回ると品質がより急速に低下します。
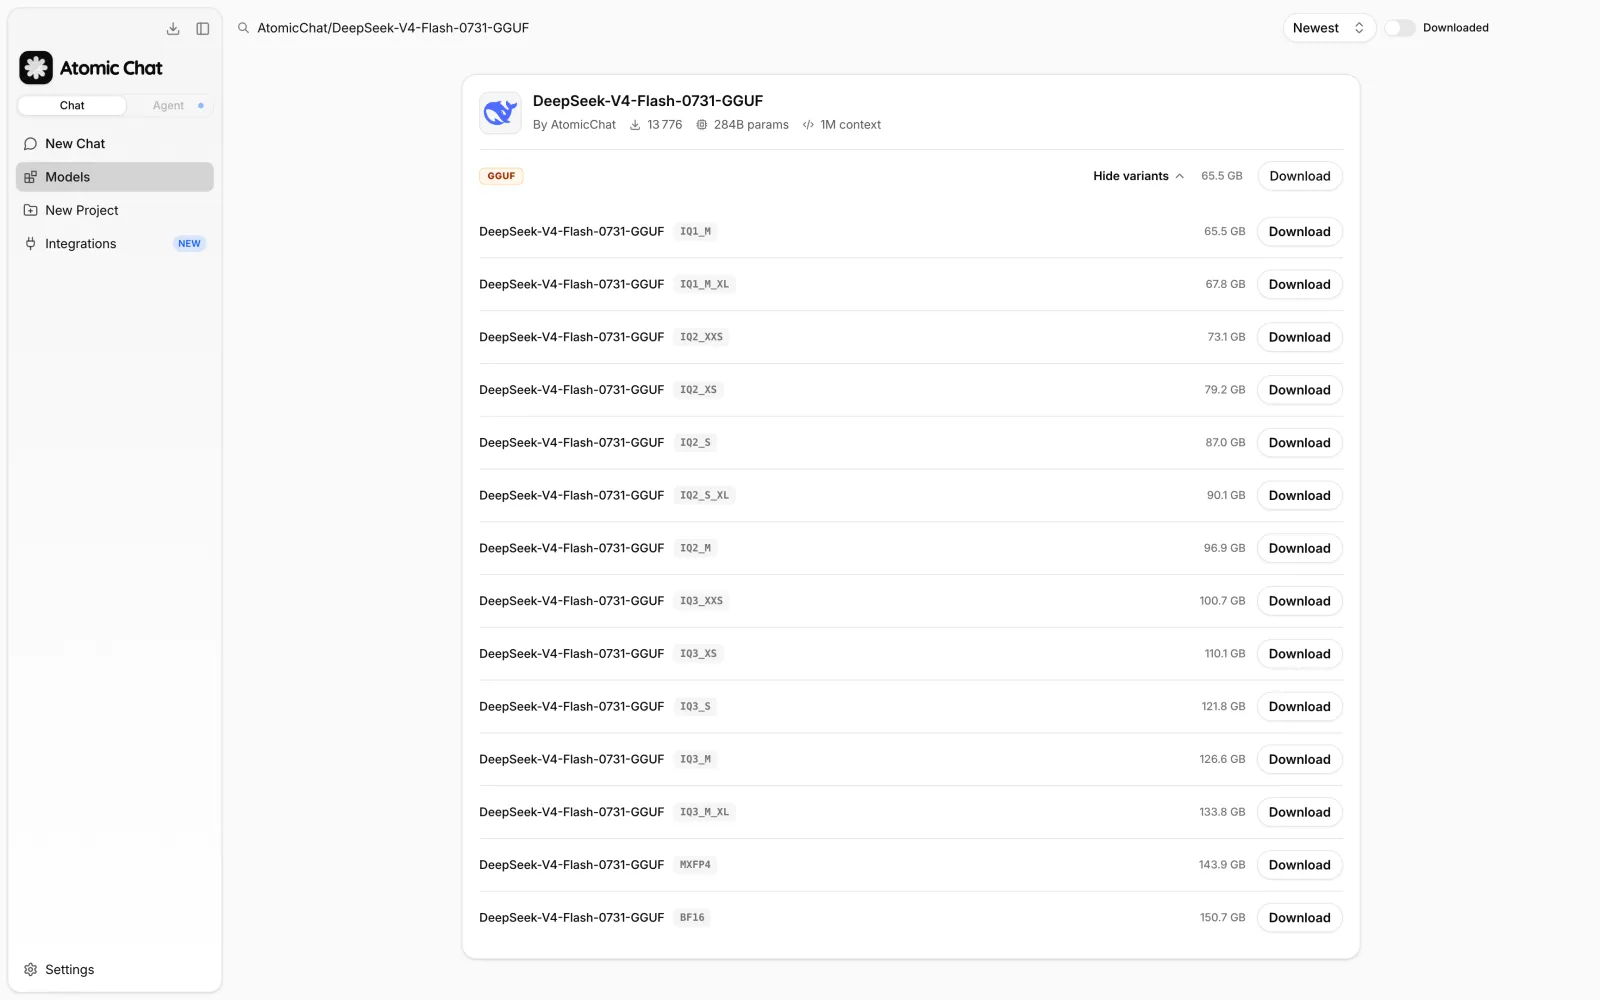
バリアント選択画面では、接頭辞AD-が省略され、サイズは2進法のギガバイトで表示されます。そのため、AD-IQ2_MはIQ2_Mとして96.9 GBと表示されます。これは、上の表で10進法のギガバイトによる104.0 GBと記載しているものと同じファイルです。
ステップ4:8Kまたは32Kのコンテキスト長から始める
モデルは1Mのコンテキスト長を宣言していますが、最大値を設定すると、それに応じて大きなKVキャッシュ領域が割り当てられます。チャットでは8,192トークン、コードや文書を扱う作業では32,768トークンから始めてください。上限を増やすのは、処理内容がそれを必要とし、メモリの測定によって十分な余裕が確認できた場合に限ってください。
コンテキスト長の設定は、チャットウィンドウではなくモデル自体の設定にあります。Settings → Model Providers → Llama.cpp Turboquantを開き、モデル一覧でDeepSeek-V4-Flash-0731-GGUF:AD-IQ2_Mを探して、その行の歯車アイコンをクリックしてください。
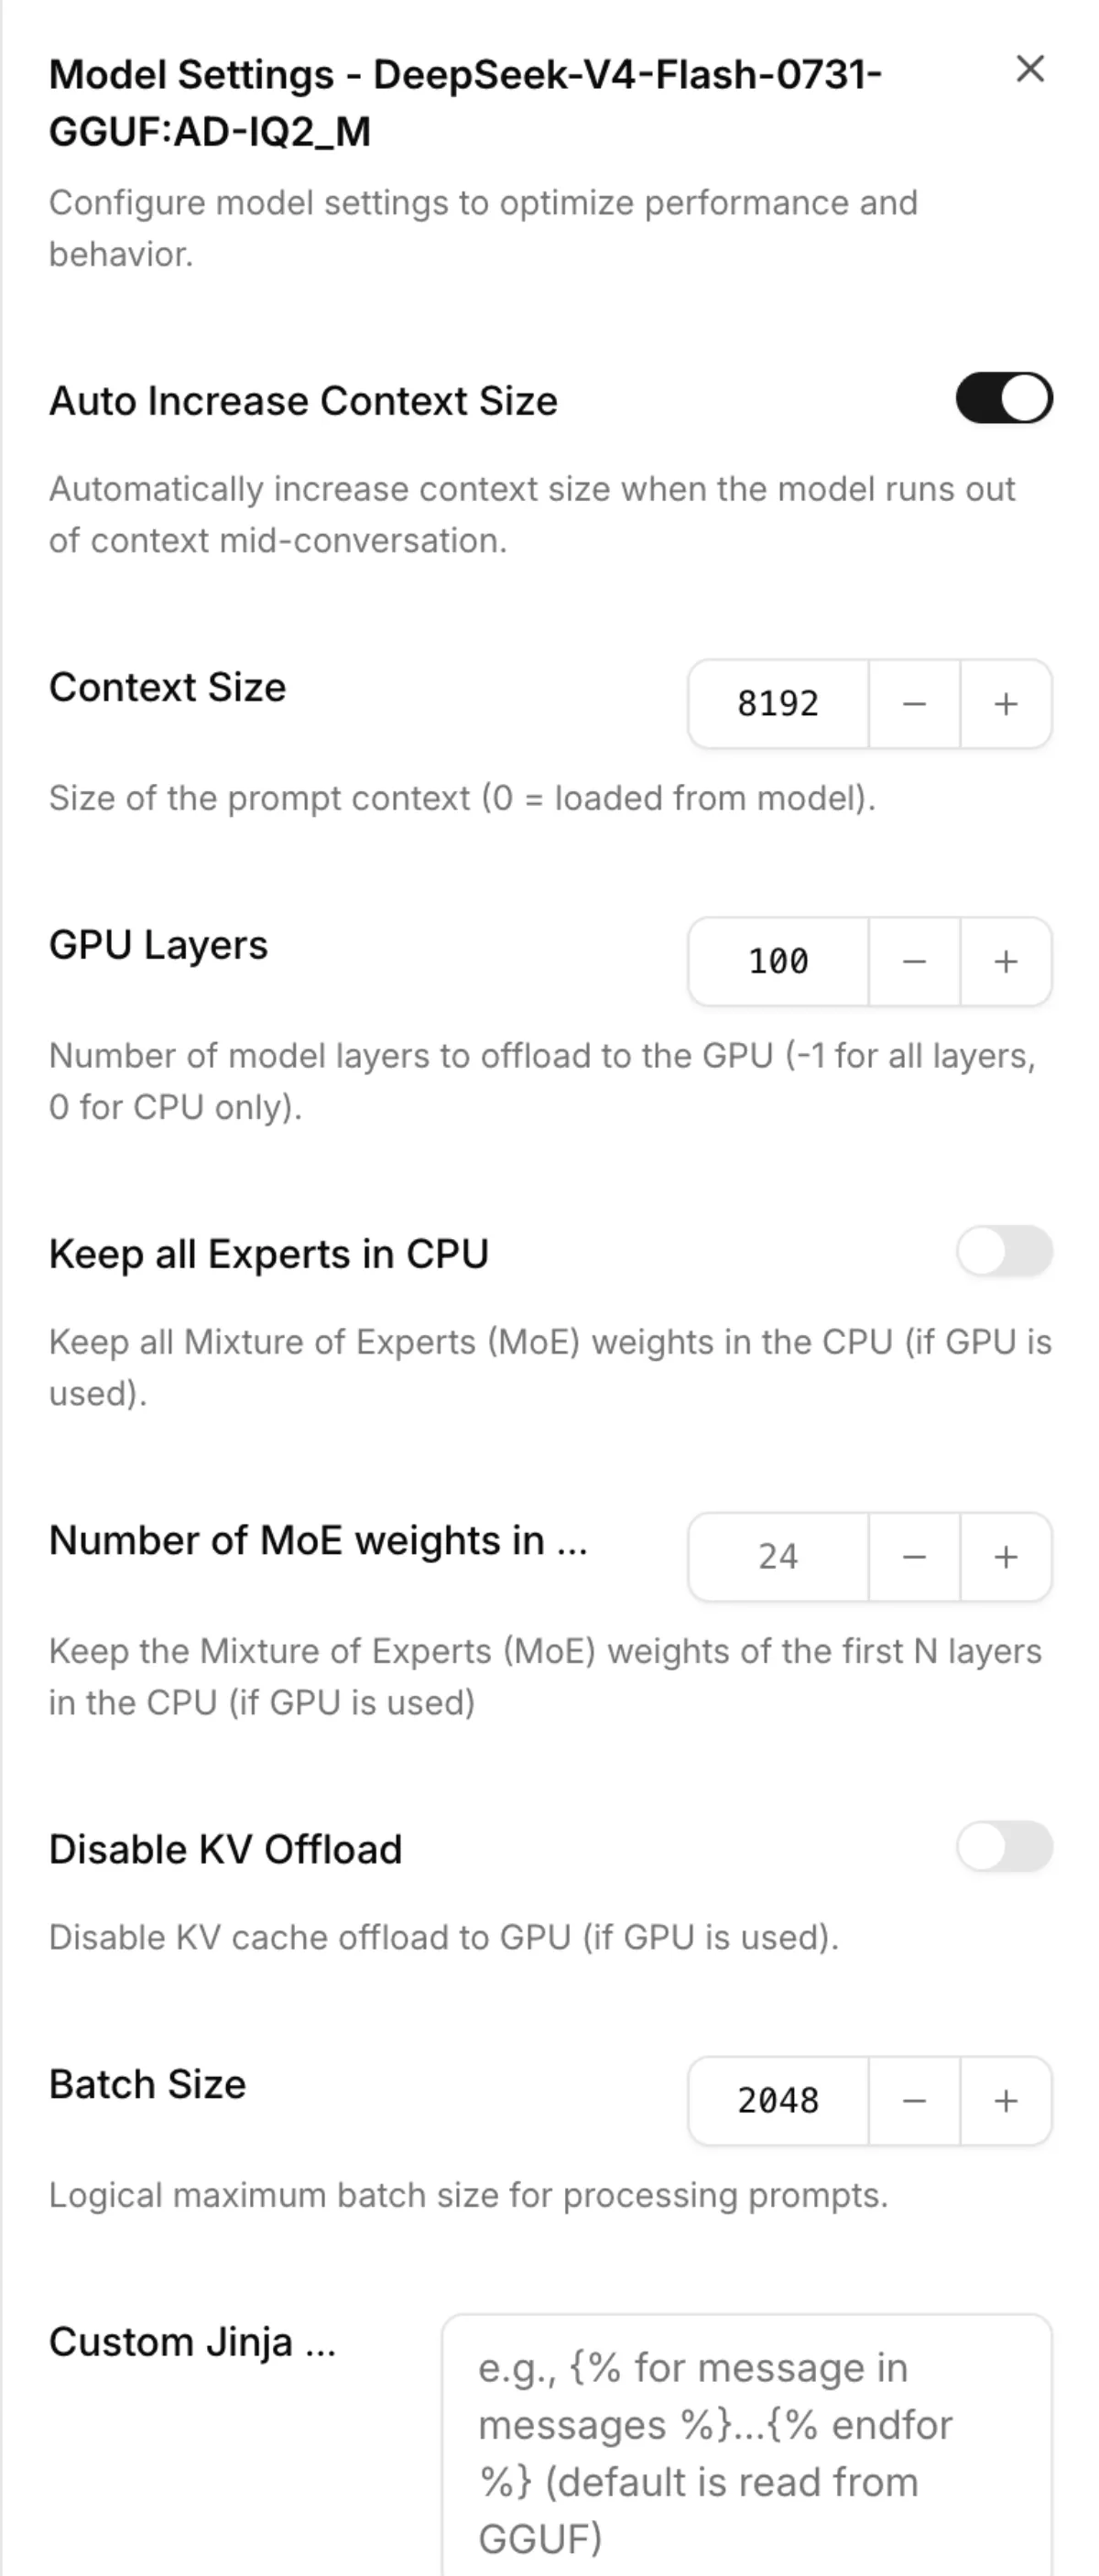
このパネルでは、V4 Flashにとって次の4つの設定項目が重要です。
- Context Size:
8192または32768に設定してください。0にするとGGUFから最大値を読み取るため、このモデルでは1Mのコンテキスト全体が対象になります。 - Auto Increase Context Size:デフォルトでオンになっています。会話がコンテキストに収まらなくなるとコンテキスト長を拡張するため、ぎりぎり収まっていたビルドがメモリ上限を超える可能性があります。メモリ上限に近い状態で作業する場合は、オフにしてください。
- Keep all Experts in CPUとNumber of MoE weights in the CPU:MoEのオフロード設定です。エキスパートの重みをGPUの外へ移すことで、VRAM容量を超える量子化モデルも読み込めるようにします。トークンごとに重みがバスを経由して転送されるため、生成速度は低下すると考えてください。
- GPU Layers:
-1ではすべての層をオフロードし、0ではモデルをCPU上に保持します。
これらの設定を変更するとモデルが再起動するため、長い会話を始める前に適用してください。
サンプリングパラメータは別の設定です。DeepSeekはローカル環境への導入にtemperature = 1.0とtop_p = 1.0を推奨しています。どちらも、チャット上部のモデル名の横にあるスライダーアイコンを開いた先のSamplingにあります。これらはモデルではなく、現在使用中のアシスタントに属する設定なので、読み込むすべてのモデルに引き継がれます。
複雑なコーディングや計画立案のタスクには、Think Highを使用してください。Think Maxは推論により多くの計算量を割り当て、DeepSeekはこのモードに少なくとも384Kのコンテキスト長を推奨しています。これにより、必要なメモリ容量は大幅に増えます。
ステップ5:ローカルでチャットする
ダウンロードが完了したら、モデルを読み込んでプロンプトを送信してください。重みとプロンプトはお使いのマシン内に保持されるため、ローカル推論にはトークン単位のAPI料金がかからず、オフラインで動作します。
llama.cppでAtomicChat GGUFを実行する方法
次のものが必要な場合は、llama.cppでモデルを直接実行する方法が適しているかもしれません。
- OpenAI互換のローカルエンドポイント。
- GPUオフロードの明示的な制御。
- 再現可能なサーバー構成。
本家のllama.cppはDeepSeek V4に対応しています。現在のmasterブランチをビルドしてください。古いリビジョンに基づくビルド済みパッケージには、融合V4カーネルが含まれていない場合があります。
ステップ1:現在のllama.cppをビルドする
NVIDIA CUDAの場合:
git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp
cmake -B build -DCMAKE_BUILD_TYPE=Release -DGGML_CUDA=ON
cmake --build build -j --target llama-cli llama-server
AMDの場合は、構成コマンドの行を次に置き換えてください。
cmake -B build -DCMAKE_BUILD_TYPE=Release \
  -DGGML_HIP=ON \
  -DGPU_TARGETS=<your-gfx-target>
Apple SiliconではMetalがデフォルトで有効ですが、明示的に指定することもできます。
cmake -B build -DCMAKE_BUILD_TYPE=Release -DGGML_METAL=ON
cmake --build build -j --target llama-cli llama-server
ステップ2:修正済みのチャットテンプレートをダウンロードする
現在のGGUFファイルには、古いチャットテンプレートが埋め込まれています。このテンプレートでは、ツールの結果の後にそれ以前の推論が欠落し、エージェントループ内でreasoning_effortがモデルに届かなくなることがあります。その際、明示的なエラーは出ません。リポジトリから修正済みのテンプレートをダウンロードしてください。
curl -sLO \
  https://huggingface.co/AtomicChat/DeepSeek-V4-Flash-0731-GGUF/resolve/main/chat_template.jinja
GGUFを再ダウンロードする必要はありません。Jinjaテンプレートは別ファイルです。
ステップ3:モデルを実行する
次のコマンドはHugging FaceからAD-IQ2_Mをダウンロードして実行し、対応するすべての層をGPUにオフロードし、修正済みテンプレートを適用して、コンテキスト長を8Kに制限します。
./build/bin/llama-cli \
  -hf AtomicChat/DeepSeek-V4-Flash-0731-GGUF:AD-IQ2_M \
  --jinja \
  --chat-template-file ./chat_template.jinja \
  --chat-template-kwargs '{"reasoning_effort":"high"}' \
  --reasoning-format deepseek \
  --temp 1.0 \
  --top-p 1.0 \
  -ngl 99 \
  -c 8192 \
-fa offお使いのシステムのメモリ容量が異なる場合は、AD-IQ2_Mを別の量子化モデル名に置き換えてください。
以下の実行時の制約を適用してください。
-fa offを維持してください:報告されているCUDAのフラッシュアテンションのバグにより、プロンプトが複数回の順伝播にまたがると、DeepSeek V4が<の文字を繰り返し出力することがあります。このフラグを削除する前に、llama.cppのissue #26509の状況を確認してください。- Kキャッシュはまだ量子化しないでください:量子化されたKキャッシュ型は、V4の出力を破損させる可能性があります。issue #25382が解決されるまでは、キャッシュをデフォルトの型のままにしてください。
ステップ4:ローカルでOpenAI互換APIを提供する
llama-cliをllama-serverに置き換えてください。
./build/bin/llama-server \
  -hf AtomicChat/DeepSeek-V4-Flash-0731-GGUF:AD-IQ2_M \
  --host 127.0.0.1 \
  --port 8080 \
  --alias deepseek-v4-flash \
  --jinja \
  --chat-template-file ./chat_template.jinja \
  --chat-template-kwargs '{"reasoning_effort":"high"}' \
  --reasoning-format deepseek \
  --temp 1.0 \
  --top-p 1.0 \
  -ngl 99 \
  -c 8192 \
  -fa off
次のコマンドでテストしてください。
curl http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-v4-flash",
    "messages": [
      {
        "role": "user",
        "content": "Write a migration plan for splitting a monolith into three services."
      }
    ]
}'他のマシンからのリモートアクセスが必要でない限り、サーバーを127.0.0.1にバインドしてください。
よくある質問
ローカルハードウェアでのDeepSeek V4 Flashの実行について、特によく寄せられる質問です。
ノートPCでDeepSeek V4 Flashを実行できますか?
いいえ。16~64 GBのメモリを搭載した一般消費者向けノートPCでは、実行時とコンテキスト用の余裕を十分に確保したうえでモデルを保持することはできません。最小のAtomic Dynamic GGUFでも、オーバーヘッドを含めずに70.2 GBあります。大容量メモリを搭載したワークステーションやサーバーが適しています。
ノートPCで使うモデルをお探しの場合は、DeepSeekのローカル実行に関する総合ガイドで紹介しているDeepSeek R1の蒸留モデルのいずれかを実行してください。
DeepSeek V4 FlashにはどれくらいのRAMが必要ですか?
実用上の最小構成は、AD-IQ1_M_XLを使う場合でRAMとVRAMの合計約80 GBです。AD-IQ2_Mには128 GBを推奨します。104 GBのファイルなら、コンテキスト用の実用的な余裕を残しつつ、ロスレス参照モデルとのTop-1一致率83.56%を維持できます。192 GB以上ある場合は、162.1 GBのロスレスGGUFを使用してください。
DeepSeek V4 Flashのどの量子化モデルをダウンロードすればよいですか?
128 GBの場合はAD-IQ2_Mをダウンロードしてください。112 GBの場合はAD-IQ2_S_XL、96 GBの場合はAD-IQ2_XSを使用してください。192 GBのシステムでは、AD-BF16を使用してください。どの場合も、ファイルサイズに加えて、OS、実行時バッファ、KVキャッシュ用のメモリを確保してください。
DeepSeek V4 Flashはローカルで100万トークンのコンテキストを使用できますか?
アーキテクチャは1,048,576トークンに対応していますが、KVキャッシュと実行時に割り当てられる領域もメモリ内に収める必要があります。初期設定に1Mを使用しないでください。短いコンテキスト長を明示的に設定し、必要な処理を行う場合に限って増やしてください。DeepSeekはThink Maxに少なくとも384Kを推奨しているため、Maxを実用的に運用するには、8Kのチャット構成より大幅に多くのメモリが必要です。
DeepSeek V4 FlashとDeepSeek R1の違いは何ですか?
V4 Flashは、総パラメータ数284B、有効パラメータ数13BのMoEモデルで、コーディング、エージェント処理、推論、長いコンテキストを扱う処理向けに設計されています。一般消費者向けハードウェアでよく使われるR1の蒸留モデルは、R1の推論を模倣するように学習された、1.5B~70Bの別のデンスモデルです。ハードウェア要件ははるかに低く、V4 Flashの派生モデルではありません。
DeepSeek V4 Flashは無料でローカル実行できますか?
はい。DeepSeekはモデルの重みをMITライセンスで公開しており、AtomicChatのGGUFは無料でダウンロードできます。ローカル推論にはトークン単位の料金はかかりませんが、ハードウェア、電力、ストレージの費用は必要です。
OllamaやLM Studioは使えますか?
OllamaやLM Studioを使うのは、インストール済みのビルドに本家の最近のDeepSeek V4対応が含まれ、修正済みのJinjaテンプレートと必要な実行時フラグを適用できる場合に限ってください。V4への対応がまだ変化している間は、Atomic Chatまたは現在のllama.cppビルドを使うほうが、動作を予測しやすい構成になります。
まとめ
DeepSeek V4 Flashは、コーディング、エージェント処理、推論、長いコンテキストを扱う処理向けに設計された、重みが公開されているモデルです。有効パラメータ数が13Bであることでトークンあたりの計算量は減りますが、総パラメータ数284Bのすべてがモデルの一部として残るため、ローカル実行には依然としてかなり高性能なマシンが必要です。実行時とコンテキストのオーバーヘッドを含めずに、70~162 GBを要します。
必要なハードウェアがあるなら、DeepSeek V4 Flashをローカルで実行する最も簡単な方法の1つは、私たちのDeepSeek V4 Flash GGUFリポジトリのビルドをAtomic Chatで使用することです。




