

このガイドでわかること:
- 無検閲版Qwen 3.8 27Bとは何か、アブリテレーションで何が変わったのか
- どのコミュニティビルドを使うべきか、それぞれに必要なハードウェア
- Atomic Chatまたはllama.cppで無検閲版Qwen 3.8 27Bをローカル実行する方法
この記事では無検閲版のビルドを扱います。AlibabaのオリジナルモデルについてはQwen 3.8 27Bをローカルで動かす方法のガイドを、ほかのラインアップについてはQwenモデルをローカルで動かす方法のガイドをご覧ください。
24 GB GPUでは、Hugging FaceにあるJonathanColettiのQ4_K_Mから始めてください。32 GB Macでは、orcarouterの4ビットMLXビルドを使用します。
Qwen 3.8 27B Uncensoredとは?
Qwen 3.8 27B Uncensoredは、Alibabaがリリースしたものではありません。Alibabaは2026年8月14日にQwen 3.8 27BをApache 2.0で公開しました。その数日後には、複数の人がモデルにリクエストを拒否させる重みの部分を編集し、その成果を再公開しました。ライセンス上、このような編集と再公開は認められています。このガイドで紹介するビルドはすべて、そうしたコミュニティによる編集版であり、それぞれ異なる人が異なる手法で作成しています。
基盤となるモデルは変わっていません:
| 仕様 | Qwen 3.8 27B Uncensored |
|---|---|
| 総パラメータ数 | 27B |
| アーキテクチャ | デンス型、ハイブリッドアテンション(Gated DeltaNet + Gated Attention) |
| 層数 | 64 |
| コンテキスト長 | 262,144トークン |
| モダリティ | テキスト、画像、動画の入力 |
| 推論 | 思考はデフォルトでオン、オフに切り替え可能 |
| 複数トークン予測 | アーキテクチャとして対応していますが、保持方法はビルドごとに異なります |
| ベースモデル | Qwen/Qwen3.8-27B、2026年8月14日リリース |
| ライセンス | Apache 2.0、ベースモデルから継承 |
アブリテレーションは重みを編集するもので、モデルを再学習するわけではありません。そのため、パラメータ数、層数、コンテキスト長、必要メモリの計算はすべてオリジナルと同じです。
アブリテレーションはビジョンタワーにも複数トークン予測ヘッドにも手を加えませんが、処理後に確実に残るのはビジョンタワーだけです。ここで紹介するすべてのビルドがビジョンタワーを保持しています。失われるのは予測ヘッドですが、編集自体が原因ではありません。Hugging Face transformersを経由して読み込みと書き出しを行うアブリテレーションのパイプラインでは、このヘッドが削除されます。そのため、公開者がその経路を避けるか、処理後にオリジナルのチェックポイントからヘッドを移植し直した場合に限り保持されます。以下の3つのビルドはそれぞれ異なる方法で対処しており、次のセクションの表でその方法を示します。
アブリテレーションはQwen 3.8 27Bに何をするのか
研究者らは、アライメント済みの多くのモデルでは、層から層へ渡される内部状態である残差ストリーム内の単一の方向が拒否を制御していることを発見しました。ArditiらはNeurIPS 2024で、重みが公開された13のチャットモデルにわたってこれを示しました。その1つの方向を消すとモデルは有害な指示を拒否しなくなり、戻すと無害な指示を拒否し始めます。
この方向を見つけるには、対応関係を持たせた有害なプロンプトと無害なプロンプトの集合をモデルに入力し、活性化を記録して、両者の平均の差を取ります。その後、その方向に対して重み行列を直交化し、モデルがその方向へ書き込む能力を恒久的に取り除きます。学習データも勾配降下法も使用しないため、アブリテレーション済みの27Bは、オリジナルの公開から数週間ではなく数日で登場します。
この論文にabliterationという単語は登場しません。著者らがdirectional ablationと呼んだ処理に対して、コミュニティが作った言葉です。
ここでは、アブリテレーション済みと無検閲版は同じファイルを指します。アブリテレーション済みは手法を表す名称で、このガイドのQwen 3.8 27Bビルドはすべてこの方法で作られています。無検閲版は結果を表す名称であり、追加の指示データによる学習で同様の結果を得たDolphinやHermesなどのモデルも含みます。モデルやツールチェーンを横断して手法自体を知りたい場合は、アブリテレーション済みモデルとは何かの解説を、より広いビルドの分類については、ローカルで動かすおすすめの無検閲LLMのまとめをご覧ください。
Qwen 3.8 27Bがアブリテレーションで失うもの
2人の公開者が、オリジナルの重みと比較して、編集による能力低下を測定しました。JonathanColettiは軽度の編集を行い、同じセッション内で同じ評価ハーネスを使って両モデルを採点しています:
| ベンチマーク | Qwen 3.8 27B | 無検閲版 | 変化 |
|---|---|---|---|
MMLU | 83.4 | 83.3 | -0.2 |
ARC-Challenge | 58.9 | 57.7 | -1.2 |
HellaSwag | 82.8 | 82.9 | +0.1 |
Winogrande | 76.1 | 75.3 | -0.8 |
これらの数値はlm-evaluation-harnessによる0-shotの結果なので、Alibabaが公開しているfew-shotのスコアとは比較できず、この表のモデル同士でのみ比較できます。これらの差はすべて、それぞれ報告された標準誤差の範囲内に収まっているため、この4つのタスクでは編集による測定可能なモデルの能力低下はありませんでした。モデルカードは、測定していないものについても同じように明記しています。数学、コード、多言語処理、画像認識はいずれも未測定で、生成に関する評価も一切行っていません。
編集を強めると、失われる能力も増えます。同じモデルのOBLITERATUSビルドは、5,700問でMMLUを実行し、オリジナルの84.46%に対して82.33%を報告しています。2.1ポイントの低下で、誤差範囲を大きく超えています。公開ログが参考になるのは、同じチームが同じ編集を3段階の強度で試した様子が示されているためです:
| 編集の強度 | 拒否 | オリジナルに対するMMLUの変化 |
|---|---|---|
| 弱め | 安全性に関する説教で、なお回答をかわす | -0.3 |
| 採用されたビルド | なし | -2.1 |
| 強め | なし | -6.0 |
能力低下は均等に生じるわけでもありません。カテゴリ別の内訳では、STEMが3.3ポイント低下する一方、人文科学の低下は1.0ポイントでした。これは、拒否方向が構造化された推論と重なっているという見方と整合します。元の論文も独自の能力低下を報告しており、直交化したモデルではTruthfulQAの正解率が一貫して低下しています。
この編集が何を取り除くかについて、異論はありません。過剰な拒否と安全上の拒否は、重みの中では同じ方向です。一方を取り除けば、もう一方も一緒に失われます。そのため、この分野のすべてのモデルカードには責任に関する条項が付いています。この時点で、処理の流れに残る唯一のガードレールはあなた自身です。
どの無検閲版Qwen 3.8 27Bビルドを使うべきか?
少なくとも7人がQwen 3.8 27Bのアブリテレーション済みビルドを公開し、さらにそれらを再パッケージ化した人もいます。ダウンロードする価値があるのは3つで、それぞれ理由が異なります。
| ビルド | 手法 | 提供される量子化版 | 画像認識 | MTP | Ollama |
|---|---|---|---|---|---|
| JonathanColetti | Heretic | IQ2_MからQ8_0までの6サイズに加え、対応するnoMTP版 | 別ファイルのf16プロジェクター | 移植し直し、ファイルごとに検証済み | 非対応 |
| huihui-ai | remove-refusals-with-transformers | Q2_KからQ8_0に加えてUDシリーズ、22ファイル | mmprojを同梱 | 変更なし | huihui_ai/Qwen3.8-abliterated |
| orcarouter | 方向アブレーション | MLXは2、4、6、8ビット、GGUFはQ2_KからQ8_0 | BF16で保持 | メインモデルから分離し、独立したドラフトモデルとして提供 | orcarouter/Qwen3.8-27B-Uncensored |
何を入手するのか把握したいなら、ダウンロードすべきなのはJonathanColettiのビルドです。これはHereticで作られており、2目的の最適化器でアブレーションのパラメータを探索します。一方の目的は拒否の数を数え、もう一方は編集後のモデルの出力分布がオリジナルからどれだけずれたかを測定します。200回の試行からパレートフロントが得られ、モデルカードには23個すべての非劣解が公開されているため、選ばれたトレードオフを正確に確認できます。公開ビルドの拒否は100件中12件で、KLダイバージェンスは0.1191です。MTPヘッドはマージ後にベースのチェックポイントからコピーし直され、その後、提供されるすべてのファイルで65ブロック中65ブロックが検査されました。
huihui-aiなら、1つのコマンドで実行を開始できます。アブリテレーションで最も実績のある名前です。手法はより古く、より単純です。モデルカードでは独自のツールを粗削りな概念実証の実装と説明しており、アブレーションの対象を18層目から51層目までに限定しています。カードによると、これはオリジナルの動作をより多く残すための意図的な選択です。ファイル名には注意してください。_Lビルドは、アブレーション対象のテンソルをQ8_0に引き上げるため、Q2_K_Lは17.2 GBとなり、通常のQ4_Kの16.8 GBより大きくなります。
Macユーザーはorcarouterから始めるとよいでしょう。MLXを提供する唯一の公開者で、2、4、6、8ビット版があり、ビジョンタワーと正規化層はBF16のまま保持し、言語モデルの重みだけを量子化しています。4ビットビルドはリポジトリのルートにもミラー配置されているため、LM Studioなど、1つのリポジトリを1つのモデルとして扱うツールから直接読み込めます。公開者自身の忠実度の表では、BF16のソースに対するコサイン類似度が4ビットで0.996、2ビットで0.92とされており、モデルカードには、この規模の2ビット版は反復ループや支離滅裂な出力に陥ると明記されています。なお、GGUFリポジトリはアクセス制限付きでHugging Faceへのログインが必要ですが、MLXリポジトリは公開されています。
拒否率の数値がそろわない理由
上記3つのビルドのうち2つが拒否率を公開しており、OBLITERATUSも公開しています。しかし、同じ方法で測定された数値は1組もありません。
| ビルド | 拒否率 | プロンプトセット | 条件 |
|---|---|---|---|
| JonathanColetti | 100件中98件から100件中12件へ | mlabonne/harmful_behaviors、100件のプロンプト | 思考オフ、bf16のマージ版で測定 |
| OBLITERATUS | 0%、婉曲な回答回避も0% | 独自の1,000件以上、手動監査済み | 思考オンとオフの両モード |
| orcarouter | 64から99%に対して0から6% | リリース投稿に記載なし | 公開者のFP8ビルドで測定 |
各行では、プロンプトセット、プロンプト数、誰または何が回答を拒否と判定するか、思考がオンだったかどうかが異なります。冒頭に警告を付け、その後に要求どおりの内容を返す回答は、ある公開者の判定では拒否に数えられ、別の公開者の判定では要求への応答に数えられます。OBLITERATUSはこれを失敗と数え、婉曲な回答回避と呼んでいますが、ほかの2者は測定していません。JonathanColettiの数値は、ダウンロードするファイルではなく、思考を無効にしたbf16のマージ版で測定されたものです。orcarouterはプロンプトセットを一切明示しておらず、その数値も提供されているGGUFやMLXではなく、FP8ビルドから得られたものです。
huihui-aiが表にないのは、拒否に関する数値を一切公開していないためで、それ自体が一種の答えでもあります。
拒否率が示すのは、ある公開者が自分のプロンプトと判定方法で行った独自テストの結果です。ビルドを頼りにする前に、自分のプロンプトで試してください。
別のモデルについては、公開者を横断した測定が1つあります。Hereticプロジェクトはgemma-3-12b-itで、自ら作成したモデルをhuihui-aiのものと比較評価し、どちらも拒否が100件中3件に達したと報告しています。KLはHereticが0.16、huihui-aiが0.45でした。要求に応じる割合は同じですが、Hereticのオリジナルからのずれは約3分の1です。これは別のモデルにおける2つの手法の結果なので、これらのファイルの測定結果としてではなく、より新しいツールを選ぶ理由として捉えてください。
無検閲版Qwen 3.8 27Bのハードウェア要件
確認すべきシステム要件はメモリです。以下の表は、必要な使用可能RAMとVRAMの合計を示しています。Apple Siliconでは、macOSがデフォルトでモデルに割り当てる上限である統合メモリの75パーセントと比較してください。3者の公開者が各段階で異なるファイルを提供しているため、サイズは範囲で示しています。一部のリポジトリには存在しない段階もあります。JonathanColettiのラインアップはIQ2_Mから始まり、3ビットを完全に省いています。
| 使用可能メモリ | 推奨量子化版 | 一般的なサイズ | 確保できる余裕 |
|---|---|---|---|
| 12 GB | 2ビット(IQ2_M、Q2_K) | 10.5から10.9 GB | 短いコンテキストのみ |
| 16 GB | 3ビット(huihui-aiのQ3_K、orcarouterのIQ3_M) | 12.8から13.5 GB | 約8Kのコンテキスト |
| 24 GB | 4ビット(IQ4_XS、Q4_K_M) | 15.3から16.8 GB | 約20Kのコンテキスト |
| 32 GB | 6ビット(Q6_K) | 22.4 GB | 約24Kのコンテキスト |
| 48 GB以上 | 8ビット(Q8_0) | 29.0 GB | 余裕を持って長いコンテキストを利用可能 |
注:隣り合う2段階のファイルで迷っていて、どちらもメモリに収まるなら、大きいほうを選んでください。必要容量は1、2 GB増えますが、誤ったトークンを選ぶ頻度が目に見えて減ります。特に、品質低下が最も速く進む14 GB未満では、この差が顕著です。
ここでの低ビットビルドには、オリジナルモデルにはないリスクがあります。JonathanColettiのモデルカードでは、低ビットのファイルではなくQ6_KかQ8_0でこのモデルの動作を評価するよう勧めています。アブリテレーション済みモデルで最も不安定なのは、以前の拒否境界付近の動作であり、2ビット化はまさにその不安定さを増幅するためです。これらのリポジトリには、2ビットでの拒否境界を測定したものは一切ありません。orcarouterは独自の2ビットMLXビルドについて、より率直にアーカイブ専用としています。ただし、その理由は拒否ではなく生成品質です。
コンテキスト長によってメモリはどれだけ増えるか?
上記の数値はモデルの重みだけを対象としています。エンジンはそれに加えてKVキャッシュを割り当てます。チャットが長くなるほど、モデルがメモリに保持するコンテキストが増え、必要なGB数も増えます。大きな文書やコードベースを会話に貼り付ける場合も同様です。
従来型のデンストランスフォーマーでは、64層すべてが各トークンのアテンションデータを保存します。このモデルでは64層のうち48層がGated DeltaNetを使用し、会話がどれだけ長くなってもメモリ使用量は変わりません。また、16層のゲート付きアテンションが使用するKVヘッドはわずか4つです。オリジナルの重みから作成した私たちのビルドで測定したところ、このモデルはトークンあたり256 KBのアテンションキャッシュを保持します:
| コンテキスト長 | アテンションキャッシュ |
|---|---|
| 8K(通常のチャット) | 約2 GB |
| 32K(長い文書) | 約8 GB |
| 128K(大規模なコードベース) | 約33 GB |
| 262K(ネイティブの最大コンテキスト長) | 約67 GB |
262Kのコンテキスト全体を使うには、サーバー向けハードウェアが必要です。キャッシュだけで約67 GBとなり、4ビットファイルの4倍に達するためです。
無検閲版Qwen 3.8 27Bを動かせるハードウェアは?
- RTX 3090 / RTX 4090(24 GB VRAM):4ビットビルドをすべてVRAMに載せて実行でき、約20Kのコンテキストを確保できます。
- RTX 5090(32 GB VRAM):Q6_KをすべてVRAMに載せ、約24Kのコンテキストで実行できます。この量子化段階では、編集による能力低下に加わる量子化由来の低下はほとんどありません。
- 16 GB GPU(RTX 4060 Ti、RTX 5060 Ti):3ビットビルドと約8Kのコンテキストが収まります。27Bはデンスモデルなので、4ビットビルドの一部をオフロードする際の性能低下は、Mixture-of-Expertsモデルより大きくなります。生成の各ステップで、GPUが低速なシステムRAM上の層を待つためです。通常は、すべてVRAMに収まる小さな量子化版のほうがよいトレードオフになります。
- MacBook Pro(24 GB統合メモリ):3ビットビルドを8Kのコンテキストで実行できます。macOSはデフォルトで、GPUからアドレス指定できるメモリを統合メモリの約75パーセントに制限するため、24 GB Macでモデルが使えるのは約18 GBです。
- MacBook Pro M4/M5 Max、Mac Studio(36-64 GB):Q5やQ6を余裕を持って実行でき、48 GB以上ならQ8_0も実行できます。この構成では、GGUFの代わりにorcarouterのMLXビルドを試す価値もあります。形式を選ぶ際は、GGUFとMLXの比較ガイドをご覧ください。
- スマートフォン:実行できません。スマートフォンで動くモデルについては、無検閲モデルのまとめで小型モデルをご覧ください。
Atomic Chatで無検閲版Qwen 3.8 27Bをローカル実行する方法
Atomic Chatは、私たちが開発した無料のオープンソースのローカルAIアプリです。Hugging Faceのモデルブラウザーと内蔵チャットを備えており、llama.cppを手動でビルドする必要はありません。
Atomic Chatで無検閲版Qwen 3.8 27Bを動かす手順は次のとおりです:
ステップ1:Atomic Chatをインストールする
atomic.chatからAtomic Chatをダウンロードし、使用するプラットフォーム向けのビルドをインストールします:
- macOS:ユニバーサル.dmg(IntelおよびApple Silicon)、macOS 13.6以降
- Windows:x64向けの.exeインストーラー
- Linux:root権限が不要な、x86_64向けの自己完結型.AppImage
- iOS:App Storeから入手
- Android:Google Playから入手
Linuxでは、chmod +xでAppImageに実行権限を付け、直接実行します。初回起動時にアプリからFUSEについて求められた場合は、DebianまたはUbuntuではsudo apt install fuse libfuse2、Fedoraではsudo dnf install fuse fuse-libsでインストールしてください。
ステップ2:無検閲版Qwen 3.8 27BのGGUFを探す
Modelsタブを開き、次を検索します:
JonathanColetti/Qwen3.8-27B-Uncensored-GGUF
カタログはHugging Faceを利用しているため、公式リポジトリと並んでコミュニティのリポジトリも表示されます。ダウンロード前に検索結果の公開者名を確認し、Download Optionsの選択メニューを展開して利用可能な量子化版を表示します。
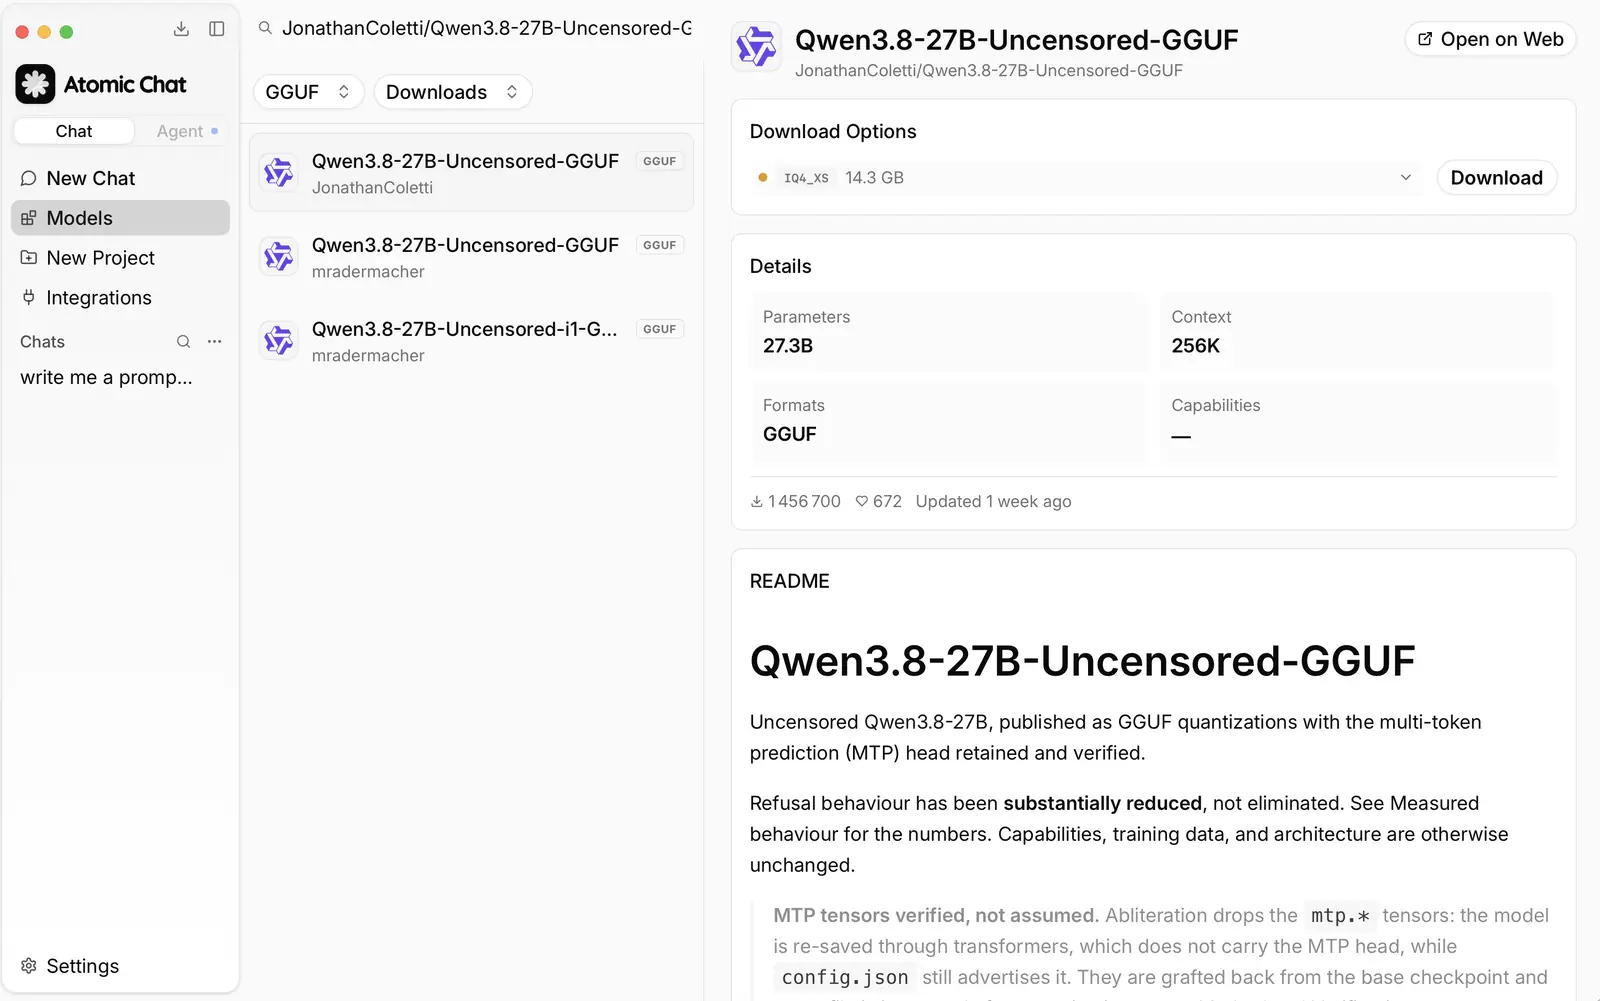
注:ほぼ同じ名前のリポジトリが複数あり、そのうち1つはアクセス制限付きです。ダウンロード前の確認事項は、トラブルシューティングのセクションをご覧ください。
ステップ3:メモリに合う量子化版を選ぶ
上記のハードウェア表を参照してください。特に一般的な構成では、次のとおりです:
- 24 GB GPU:16.8 GBのQ4_K_Mをダウンロードします。
- 32 GB:22.4 GBのQ6_Kをダウンロードします。
- 48 GB以上:29.0 GBのQ8_0をダウンロードします。
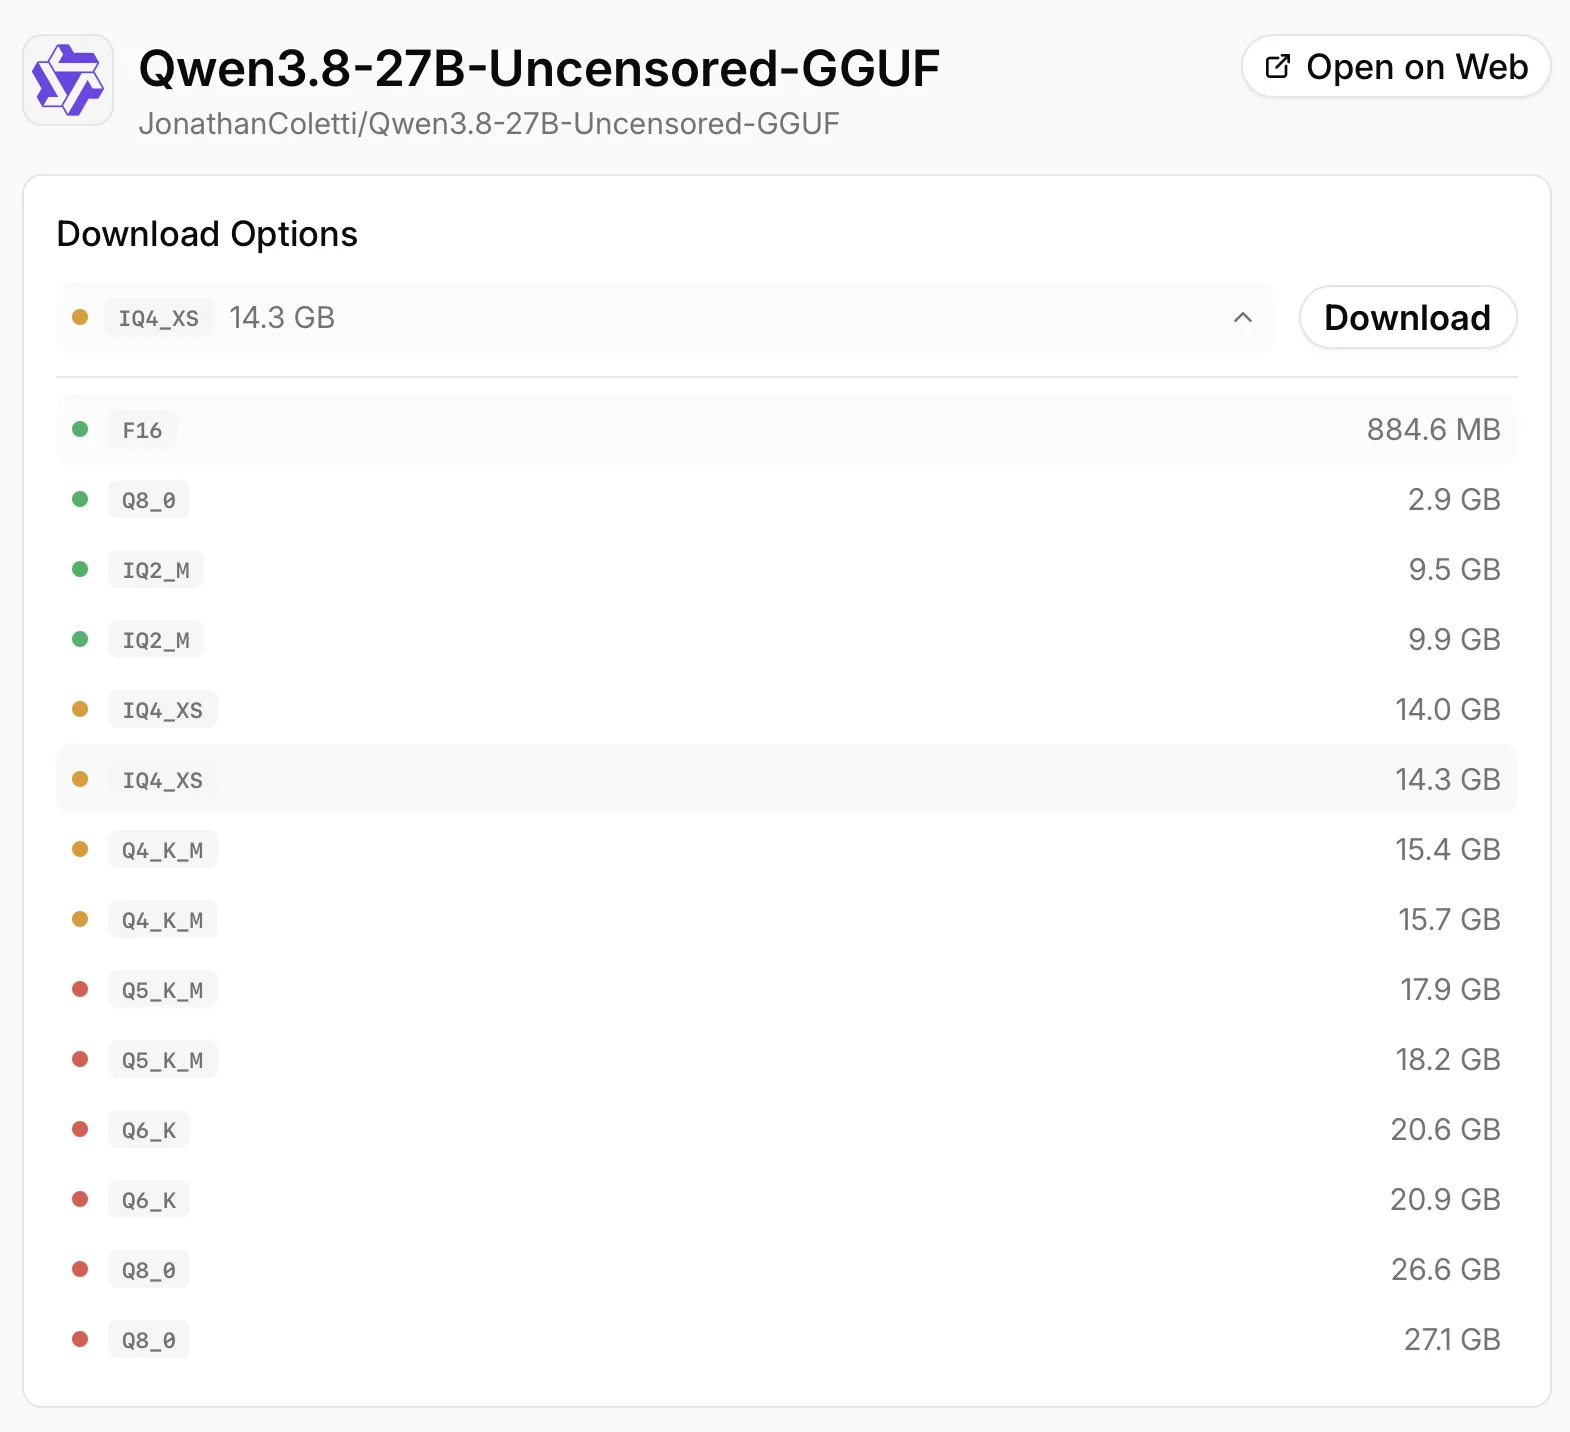
選択メニューでは各ビルドが短いタグで表示され、リポジトリ内のすべてのファイルが並ぶため、予想外の項目も出てきます。選択メニューはギビバイトで計算するため、サイズは上記の数値より約7パーセント小さく表示されます。各量子化版は、予測ヘッドを統合したものと統合していないものの2回表示されます。リスト上部にある小さな2項目、884.6 MBのF16と2.9 GBのQ8_0は、小型モデルではなく、ビジョンプロジェクターとドラフトヘッドです。サイズを目安にし、統合版が必要なら同じ名前の2行のうち大きいほうを選んでください。コンテキスト用の余裕を残して収まる、最大の量子化版を選択します。量子化名の意味がわからない場合は、GGUFとは何か、量子化はどう機能するかのガイドをご覧ください。
ステップ4:コンテキスト、思考、サンプリングを設定する
モデルは262Kのコンテキスト長を宣言していますが、最大値に設定するとKVキャッシュが事前に割り当てられます。チャットでは8,192トークン、コードや文書の作業では32,768トークンから始め、作業上必要な場合にのみ増やしてください。
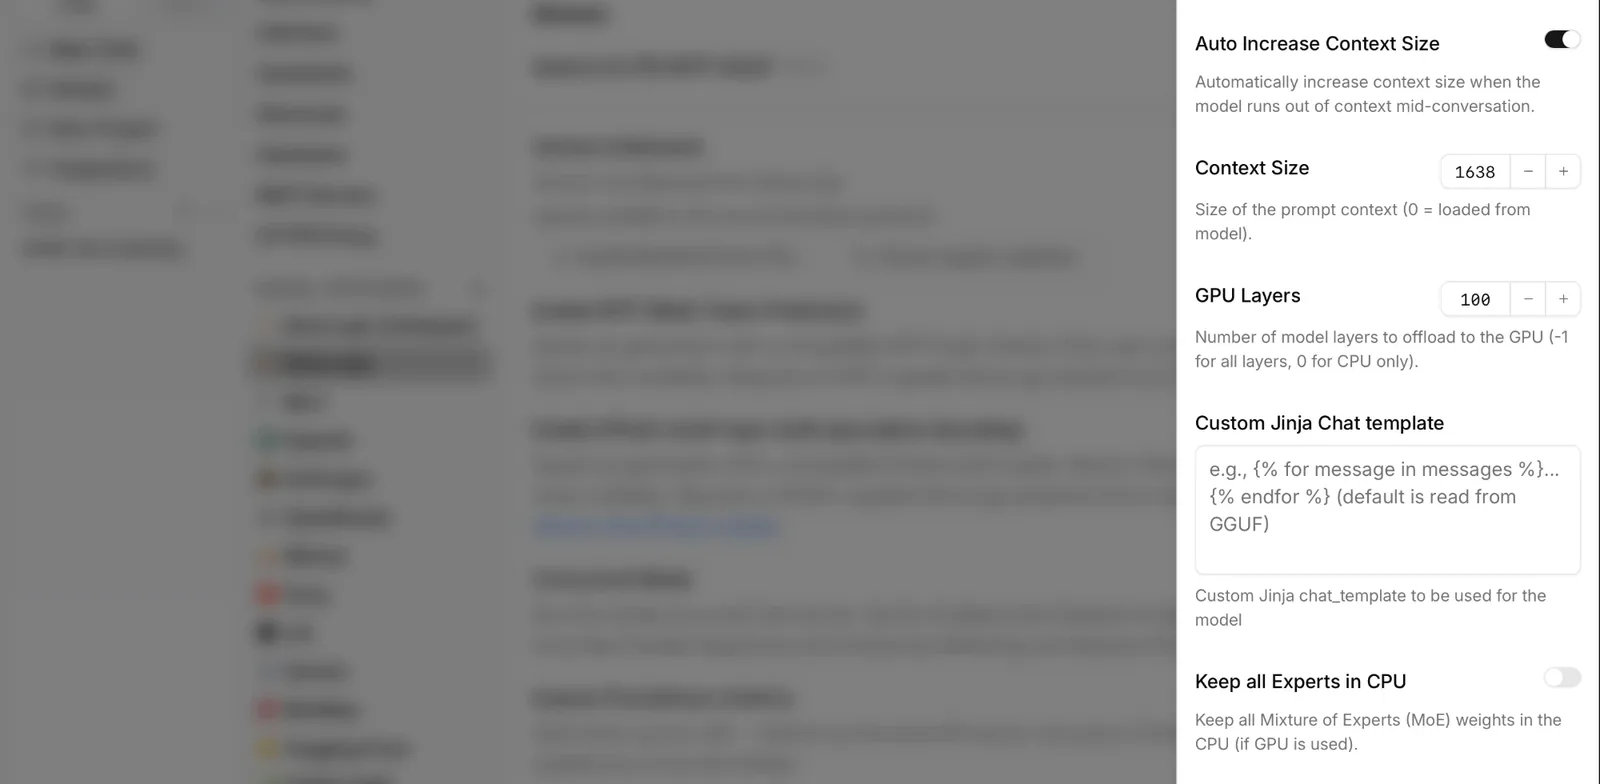
コンテキスト長はチャット画面ではなく、モデル自体の設定にあります。Settings → Model Providers → Llama.cppを開き、モデル一覧からビルドを見つけ、その行の歯車アイコンをクリックします。そこで次の3項目を設定します:
- Context Size:8192または32768に設定します。0にするとGGUFから最大値が読み込まれ、このモデルでは262Kのコンテキスト全体が設定されます。
- Auto Increase Context Size:デフォルトでオンです。会話がコンテキストに収まらなくなるとコンテキスト長を拡大するため、ぎりぎり収まっていたビルドがメモリ上限を超えることがあります。上限近くで使用する場合はオフにしてください。
- GPU Layers:-1ですべての層をオフロードします。VRAMに収まるデンスモデルでは、この設定を使用します。
Context SizeまたはGPU Layersを変更するとモデルが再起動するため、長い会話を始める前に設定してください。
思考はデフォルトでオンです。チャットの電球アイコンでオフにできます。
サンプリングは別のパネルで設定します。チャット上部のモデル名の横にあるスライダーアイコンをクリックしてください。Qwenの推奨設定はオリジナルの重みから引き継がれます。思考オンではtemperature 1.0、top_p 0.95、top_k 20、オフでは0.7と0.80です。これらの設定はモデルではなく、チャット用プロファイルであるアシスタントに保存されるため、モデルを切り替えても同じ設定が維持されます。
ステップ5:ローカルでチャットする
ダウンロードが完了すると、Atomic Chatがモデルを読み込み、内蔵チャットで開きます。オリジナルが拒否するプロンプトを送信し、ダウンロードしたビルドが編集版であることを確認してください。
27Bはネイティブの視覚言語モデルであり、アブリテレーション後もビジョンタワーが残るため、同じリポジトリの別ファイルであるプロジェクターを量子化ファイルと同じ場所に置けば、チャットに画像を添付して、その画像について質問できます。画像、重み、プロンプトは、いずれも使用中のマシン内にとどまります。
Atomic Chatは、http://localhost:1337/v1でOpenAI互換APIサーバーも提供します。Claude CodeやClineなどのコーディングエージェントを含め、OpenAI APIに対応するツールなら、クラウドモデルの差し替え先としてローカルモデルをそのまま使用できます。
llama.cppで無検閲版Qwen 3.8 27Bを動かす方法
次のような要件がある場合は、llama.cppから直接モデルを動かす方法が適しているかもしれません:
- ホストとポートをフラグで指定し、ヘッドレスで起動できるサーバー
- GPUオフロードの厳密な制御
- 再現可能なサーバー設定
これらのビルドは、オリジナルと同じGated DeltaNetのハイブリッドアーキテクチャを使用しています。llama.cppの本流は2026年2月からこれに対応しているため、現在のビルドならパッチなしで動作します。
ステップ1:最新のllama.cppをビルドする
NVIDIA CUDAの場合:
git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp
cmake -B build -DCMAKE_BUILD_TYPE=Release -DGGML_CUDA=ON
cmake --build build -j --target llama-cli llama-server llama-mtmd-cli
Apple Siliconでは、Metalがデフォルトで有効です:
cmake -B build -DCMAKE_BUILD_TYPE=Release
cmake --build build -j --target llama-cli llama-server llama-mtmd-cli
ステップ2:モデルを実行する
次のコマンドは、Hugging FaceからQ4_K_Mをダウンロードし、すべての層をGPUへオフロードし、Qwen推奨のサンプリング設定を適用し、コンテキスト長を8Kに制限します:
./build/bin/llama-cli \
  -hf JonathanColetti/Qwen3.8-27B-Uncensored-GGUF:Q4_K_M \
  --jinja \
  --temp 1.0 --top-p 0.95 --top-k 20 \
  -ngl 99 \
  -c 8192
システムのメモリ容量が異なる場合は、Q4_K_Mを別の量子化名に置き換えてください。
ステップ3:ローカルのOpenAI互換APIを提供する
llama-cliをllama-serverに置き換えます:
./build/bin/llama-server \
  -hf JonathanColetti/Qwen3.8-27B-Uncensored-GGUF:Q4_K_M \
  --alias qwen3.8-27b-uncensored \
  --jinja \
  --temp 1.0 --top-p 0.95 --top-k 20 \
  -ngl 99 \
  -c 8192 \
  --host 127.0.0.1 --port 8080
次のコマンドでテストします:
curl http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{ "model": "qwen3.8-27b-uncensored", "messages": [ { "role": "user", "content": "Summarize what Gated DeltaNet changes about attention." } ] }'
ネットワーク上のほかのマシンからアクセスする必要がない限り、サーバーは127.0.0.1にバインドしてください。
llama.cppで画像認識を実行する
画像入力には、追加でビジョンプロジェクターというファイルが1つ必要です。これはすべての量子化版で共通で、約930 MBです。同じリポジトリから一度ダウンロードし、選んだ量子化版と一緒に指定してください:
./build/bin/llama-mtmd-cli \
  -m Qwen3.8-27B-Uncensored-Q4_K_M.gguf \
  --mmproj Qwen3.8-27B-Uncensored-vision-f16.gguf \
  --image your-photo.jpg --image-min-tokens 1024 \
  -ngl 99 -c 8192 \
  -p "What is in this image?"
--image-min-tokens 1024はそのままにしてください。llama.cppは、このモデルファミリーには少なくともこの数の画像トークンが必要で、それ未満では位置に関する処理全般が不安定になると警告しています。プロジェクターファイルの名前はリポジトリごとに異なるため、上記のファイル名をコピーする前に、使用するリポジトリのファイル一覧を確認してください。
MTPヘッドによる投機的デコーディング
オリジナルのチェックポイントには、投機的デコーディングの仕組みを支える複数トークン予測ヘッドが含まれています。これを保持したビルドは、メインモデルに先行して次のトークンをドラフト生成できます。次のフラグを追加します:
./build/bin/llama-server \
  -m Qwen3.8-27B-Uncensored-Q4_K_M.gguf \
  --spec-type draft-mtp --spec-draft-n-max 1 \
  -ngl 99 -c 8192
MTP対応は、2026年5月にマージされたPR #22673でllama.cppに入りました。古いビルドでもこれらのファイルは読み込めますが、MTPテンソルを通知なしに無視するため、高速化が見られない場合は、まず更新してください。JonathanColettiはドラフト長ごとに速度向上を測定し、ドラフト長1で文章が1.19倍、コードが1.28倍になったと報告しています。それより長くするたびに効果は小さくなり、文章では3になると効果がなくなりました。ドラフトヘッドは未編集のモデルに合わせて学習されているため、アブリテレーション済みビルドでは受理率がやや低くなる可能性があります。それでもドラフト生成されたすべてのトークンはモデル自体が検証するため、出力品質に影響はありません。
OllamaまたはLM Studioで実行する
これらのビルドのうち2つにはOllamaタグがあります:
ollama run huihui_ai/Qwen3.8-abliterated
ollama run orcarouter/Qwen3.8-27B-Uncensored
どちらもダウンロード容量は17.7 GBで、16.8 GBの4ビットファイルと0.9 GBのビジョンプロジェクターが含まれます。追加のダウンロードなしで画像入力が動作します。どちらのタグにも、Ollama v0.32.12以降を使用してください。
LM Studioは、モデルカタログからJonathanColettiとhuihui-aiのGGUFリポジトリを読み込めます。JonathanColetti/Qwen3.8-27B-Uncensored-GGUFを検索し、24 GB GPUならQ4_K_Mを選択してください。
AtomicChatは、オリジナルのQwen3.8 27Bについて、Apple Silicon向けに5つのDynamic MLXビルドを公開しています。ファイルサイズは12.7から17.7 GBです。32 GB Macでは、AtomicChat/Qwen3.8-27B-MLX-AD-4.50bpw-DWQ-16.0GBを使用してください。
MLX形式の無検閲済みの重みを使うには、orcarouter/Qwen3.8-27B-Uncensored-MLXを検索してください。リポジトリのルートは4ビットビルドを指しており、ディスク上で約16 GBを使用し、32 GB Macに収まります。orcarouterのMLXリポジトリはアクセス制限付きです。Hugging Faceで利用条件に同意し、ダウンロード前にSettings > Integrations > Hugging Faceで読み取りトークンを追加してください。
トラブルシューティング
モデルがまだ拒否する
アブリテレーションは拒否を減らしますが、なくすわけではありません。ここで最も詳しく文書化されているビルドでも、独自のテストセットで100件中12件のプロンプトを拒否しています。次の3点を確認してください:
- 電球アイコンで思考をオフにしてください。JonathanColettiの数値はその状態で測定されており、orcarouterは使用したモードを明示していないため、思考はこの2者が未解決のまま残している変数です。
- Q6_KまたはQ8_0に引き上げてください。拒否境界はアブリテレーション済みモデルで最も不安定な部分であり、JonathanColettiのモデルカードも、この2つのサイズでのみ動作を判断するよう勧めています。
- 意図したビルドを読み込んだことを確認してください。アプリのカタログでは、オリジナルの重みと編集済みの重みが非常によく似た名前で並んでいます。
ダウンロードしたビルドの中身が説明と異なる
コミュニティによる再アップロードには公開者の保証がなく、名前が重複することもあります。知らないリポジトリからダウンロードする前に、モデルカードが存在して実際の手法を説明していること、ファイル一覧に妥当なサイズのGGUFシャードがあること、公開者の素性をたどれることを確認してください。4ビットの27Bモデルが400 MBに収まることはありません。ファイルを見るためにログインを求められる場合、そのリポジトリは壊れているのではなく、アクセス制限付きです。orcarouterのGGUFリポジトリはアクセス制限付きです。
画像を入力しても何も起こらない
ビジョンプロジェクターは別ファイルであり、ダウンロードした量子化ファイルには含まれていません。同じリポジトリからmmprojファイルを取得し、上記の画像認識セクションのように--mmprojで指定してください。
低ビットビルドが意味不明な出力をする
27Bモデルの2ビット版では、反復ループや支離滅裂な出力が起きることが予想され、orcarouterも自身のモデルカードでそう説明しています。量子化のビット数を1段階上げてください。3ビットビルドが収まらない場合は、まともに動かない27Bよりも小型の無検閲モデルのほうが役に立ちます。無検閲モデルのまとめでは、12 GB未満に収まる選択肢を紹介しています。
長いコンテキストでメモリ不足になる
重みは収まるのに、会話が長くなるとモデルがクラッシュします。これはKVキャッシュが空き容量を超えて増大するためです。Context Sizeを0ではなく具体的な値に設定し、上限に近い場合はAuto Increase Context Sizeをオフにしてください。さらに余裕が必要なら、量子化のビット数を1段階下げます。トークンあたりのキャッシュが256 KBなので、1 GB空けるごとに約4Kのコンテキストを追加できます。
よくある質問
手元のハードウェアで無検閲版Qwen 3.8 27Bを動かす際に、特によく寄せられる質問です。
アブリテレーション済みモデルと無検閲モデルの違いは?
アブリテレーション済みは、モデルをどう変更したかを表します。重みの中で拒否を制御する1つの方向を取り除いたという意味です。無検閲は結果を表し、重みの編集ではなくファインチューニングによって同じ結果を得たモデルも含みます。このガイドのQwen 3.8 27Bビルドはすべてアブリテレーション済みなので、ここでは両方の言葉が同じファイルを指します。
Qwen 3.8 27B UncensoredはAlibabaの公式リリースですか?
いいえ。AlibabaはQwen 3.8 27BをApache 2.0で公開しましたが、無検閲版は個々の公開者がその重みを編集したコミュニティ版です。Alibabaが作成したものでも、推奨したものでもありません。
無検閲版Qwen 3.8 27BにはどれくらいのVRAMが必要ですか?
4ビットファイルで約17 GBなので、コンテキスト用の余裕を考えると、24 GB GPUが実用上の最低ラインです。3ビットビルドは、約8Kのコンテキストとともに16 GBに収まります。Apple Siliconでは、macOSがGPUメモリを統合メモリの約75パーセントに制限するため、24 GB Macでは3ビットビルドを実行でき、32 GB以上ならコンテキスト用の余裕を残して4ビット版を実行できます。
16GB Macで無検閲版Qwen 3.8 27Bを実行できますか?
実用的には使えません。3ビットビルドは12.8から13.5 GBで、macOSが16 GBマシンでモデルに渡すのは約12 GBだけなので、収まりません。代わりに小型の無検閲モデルを使ってください。16GB MacにおすすめのローカルLLMのまとめでは、メモリに収まるモデルを紹介しています。
無検閲版Qwen 3.8 27Bでは、どのビルドが最適ですか?
ほかの2つにしかないものが必要でなければ、JonathanColettiのビルドです。3つの中で最も詳しく文書化されており、拒否件数と能力の表があり、いずれも同じ評価ハーネスでオリジナルの重みと比較測定されています。huihui-aiはOllamaの1つのコマンドで使え、orcarouterはApple Silicon向けMLXを提供する唯一の公開者です。
アブリテレーション済みモデルは賢さが落ちますか?
編集をどこまで強めたかによります。JonathanColettiはMMLU、ARC-Challenge、HellaSwag、Winograndeで自分のビルドをオリジナルと比較評価し、差はすべて誤差範囲内に収まりました。同じモデルのOBLITERATUSビルドでは、5,700問でMMLUが2.1ポイント低下し、STEMは3.3ポイント低下しました。また、独自のログでは強度を上げた処理で6ポイント低下したことが示されています。いずれのモデルについても、数学、多言語、画像認識の数値は誰も公開しておらず、コードに関する唯一の結果は、OBLITERATUS自身による20件のプロンプトの合格数です。信頼して使う前に、自分の作業でビルドをテストしてください。
無検閲版Qwen 3.8 27Bは無料で商用利用できますか?
はい。Qwen 3.8 27BはApache 2.0で提供されており、無検閲版のビルドもこれを継承します。商用利用、改変、再配布はいずれも認められています。モデルで生成する内容は利用者の責任であり、現地の法律も引き続き適用されます。
無検閲版Qwen 3.8 27Bのビルドは安全にダウンロードできますか?
ここでのリスクは、悪意のあるファイルよりも、違うファイルを入手してしまうことです。ほぼ同じ名前のリポジトリが複数あるため、モデルカードが実際の手法を説明していることと、ファイル一覧に妥当なサイズのGGUFシャードがあることを確認してください。そのうち1つはアクセス制限付きで、そこでログインを求められるのは、リポジトリが壊れているからではなく、アクセス制限があるためです。
無検閲版Qwen 3.8 27Bはローカルで画像認識に対応していますか?
はい。ビジョンタワーはアブリテレーションで編集される部分の外側にあり、このガイドのすべてのビルドが変更せずに保持しています。Atomic Chatではチャットに画像を添付し、llama.cppでは別ファイルのmmprojプロジェクターを--mmprojで指定します。
無検閲版Qwen 3.8 27BはOllamaやLM Studioで動作しますか?
はい。これらのビルドのうち2つには、huihui_ai/Qwen3.8-abliteratedとorcarouter/Qwen3.8-27B-UncensoredというOllamaタグがあります。どちらもデフォルトのダウンロード容量は17.7 GBで、画像入力機能も含まれます。Ollama v0.32.12以降を使用してください。LM StudioはJonathanColettiのGGUFを読み込めます。無検閲済みのMLXの重みには、orcarouterの4ビットビルドを使用してください。Hugging Face上のorcarouterのGGUFおよびMLXリポジトリはアクセス制限付きで、読み取りトークンが必要です。
Qwen 3.8 27B Uncensoredはどこでダウンロードできますか?
無検閲版のGGUFファイルは、JonathanColettiのHugging Faceリポジトリにあります。無検閲済みのMLXの重みは、orcarouterのリポジトリをダウンロードしてください。
まとめ
無検閲版Qwen 3.8 27Bを使いたくて、24 GBのグラフィックスカードがあるなら、JonathanColettiの16.8 GBのQ4_K_Mをダウンロードし、8Kのコンテキストから始めてください。3者の中で、この公開者は編集によって取り除いたものと失われた能力の両方を文書化しています。32 GB以上のMacでは、代わりにorcarouterの4ビットMLXビルドを選んでください。ファイルを選ぶこと自体を避けたいなら、ollama run huihui_ai/Qwen3.8-abliteratedで、動作する4ビットモデルを1つのコマンドで入手できます。そのビルドの拒否に関する数値は、誰も公開していません。
要点:
- 無検閲版Qwen 3.8 27Bのビルドは、AlibabaのApache 2.0の重みをコミュニティが編集したものです。Alibabaが公開したものではありません。
- アブリテレーションは再学習せずに重みから拒否方向を取り除くため、サイズと必要メモリの計算は変わりません。
- 能力低下は公開者が編集を強めた度合いに応じて大きくなり、ダウンロード可能なビルドでは、測定可能な低下なしからMMLUで2.1ポイントの低下まで幅があります。
- 公開者ごとの拒否率は異なるプロンプトセットで測定されています。数値を相互比較して順位を付けることはできません。
- 拒否は減りますが、なくなるわけではありません。低ビット量子化では、残る動作がさらに予測しにくくなります。




