

要点
ローカルAIエージェントの構成では、エージェントとそのモデルを自分のコンピューターで実行します。プロンプトとツールの結果は、クラウド推論APIではなく自分のモデルサーバーに送られ、トークン単位のAPI料金は発生しません。ただし、アプリは更新サーバー、分析サービス、メッセンジャー、リモートツールに接続する場合があります。
- AIエージェントはモデルそのものではありません。モデルの周囲で動くループです。モデルにツール(ファイルの読み取り、コードの編集、コマンドの実行)を渡し、モデルが選んだ操作を実行して、その結果を返す処理をタスクが完了するまで繰り返します。
- 8つすべてにローカルモデルを使う方法があります。多くはAtomic ChatやOllamaなどのOpenAI互換サーバーに対応しています。Claude Codeは代わりにOllamaのAnthropic互換エンドポイントを使います。
- "ローカル"には、実行、推論、保存、外向き通信という4つの異なる層があります。ローカルモデルを使っても、TelegramボットやリモートMCPサーバーのプライバシーが確保されるわけではありません。
- AiderとContinueには、2026年時点での注意点があります。Aiderで最後に掲載されているリリースは2025年8月のものです。Continueのリポジトリには、積極的なメンテナンスが終了したと記載されています。どちらも古いおすすめリストには今も登場します。
- ローカル優先の第一候補はAtomic Agentです。ループ、メモリ、承認機構がローカルでの動作を前提に作られています。Atomicのエコシステムに属する製品なので、これは編集部としての推奨であり、独立したベンチマークの結果ではありません。
ローカルAIエージェントとは?
AIエージェントは、言語モデルを実際に行動するものへと変えるソフトウェアです。エージェントはモデルに一連のツール(ファイルの読み取りと編集、ターミナルコマンドの実行、ブラウザーの操作)を渡し、モデルが選んだ操作を実行して結果を返す処理を、タスクが完了するまで繰り返します。チャットボットは質問に答えますが、エージェントはリポジトリを分析し、コードを編集し、テストを実行し、エラーを読んで再試行します。
ローカル構成では、モデルも自分のハードウェア上で動かす必要があります。たとえばClaude Codeは、通常の構成ではターミナルコマンドをローカルで実行しますが、モデルへのリクエストはクラウドプロバイダーに送信します。エージェントの接続先をlocalhostにすると推論の経路は変わりますが、分析、メッセンジャー、リモートMCPツールが無効になるわけではありません。
AIエージェントをローカルモデルで動かす理由
実感しやすい順に、4つの理由を挙げます。
- コスト。ツールを使うたびに、指示、ソースファイル、それまでの出力が再送信されることがあります。従量課金のAPIでは、その料金がすぐに積み上がります。ローカル推論ならトークン単位の料金はなくなりますが、ハードウェアと電気代は引き続きかかります。
- プライバシー。コーディングエージェントは、ソースファイル、
.envファイル、コマンド出力を読み取れます。ローカルモデルなら、推論は自分のマシン内で完結します。ただし、エージェントに与える権限や、その他のネットワーク接続にも引き続き注意が必要です。 - オフライン。モデルをダウンロードすれば、ネットワーク接続が不可欠なツールを除き、機内やネットワークから隔離されたマシンでもループが動作します。
- 制御。ホスト型モデルの利用上限に従う代わりに、重み、量子化、コンテキストに割り当てる容量を自分で選べます。制約になるのは、RAM、VRAM、そして待てる時間です。
選定方法と、"ローカル"の本当の意味
この分野のまとめ記事では、利用できるエージェント、エージェントを作るためのフレームワーク、ツールメニュー付きのチャットアプリという3つの異なるものが混同されがちです。このリストは、今すぐインストールしてタスクを任せられる、実際に動くエージェントに限定しました。SDKやウェイトリストへの登録が必要なものは含めていません。
ローカル性を判断する4つの境界を比較しました。
| 境界 | 確認する問い |
|---|---|
| 実行 | エージェントのループとツールは自分のマシンで動くか? |
| モデル | ローカルで提供するモデルを使えるか、その方法はどの程度正式に対応しているか? |
| 保存 | セッション、メモリ、設定はどこに保存されるか? |
| テレメトリ | デフォルトで提供元に情報を送信するか、それを無効にできるか? |
以下のほぼすべてのエージェントは、ファイルがある場所でツールを実行します。実際の違いは、モデルへのリクエストの送信先、セッションの保存先、そして有効になっているその他の接続にあります。"ローカルで動く"ことと"オフラインのまま動く"ことは、同じ意味ではありません。
選んだ製品はすべて、ローカルモデルを使う方法が文書化されており、単なるSDKではなく、インストール可能なエージェントを備えています。これは2026年9月16日時点のワークフローと文書化されたデフォルト設定を編集部が比較したものであり、8つのエージェントに同じタスクを実行させたベンチマークではありません。
2026年のおすすめローカルAIエージェント8選
1. Atomic Agent:ローカル優先の構成に最適
Atomic Agentは、ループ、永続メモリ、承認機構を自分のマシン上に置きます。初期構成ではローカルのllama.cppモデルサーバーを使い、設定すればクラウドプロバイダーも利用できます。Atomic Chatと同じAtomicのエコシステムに属しており、私たちがこの製品をよく知っているのはその関係があるためです。この推奨を判断する際には、その点も考慮してください。
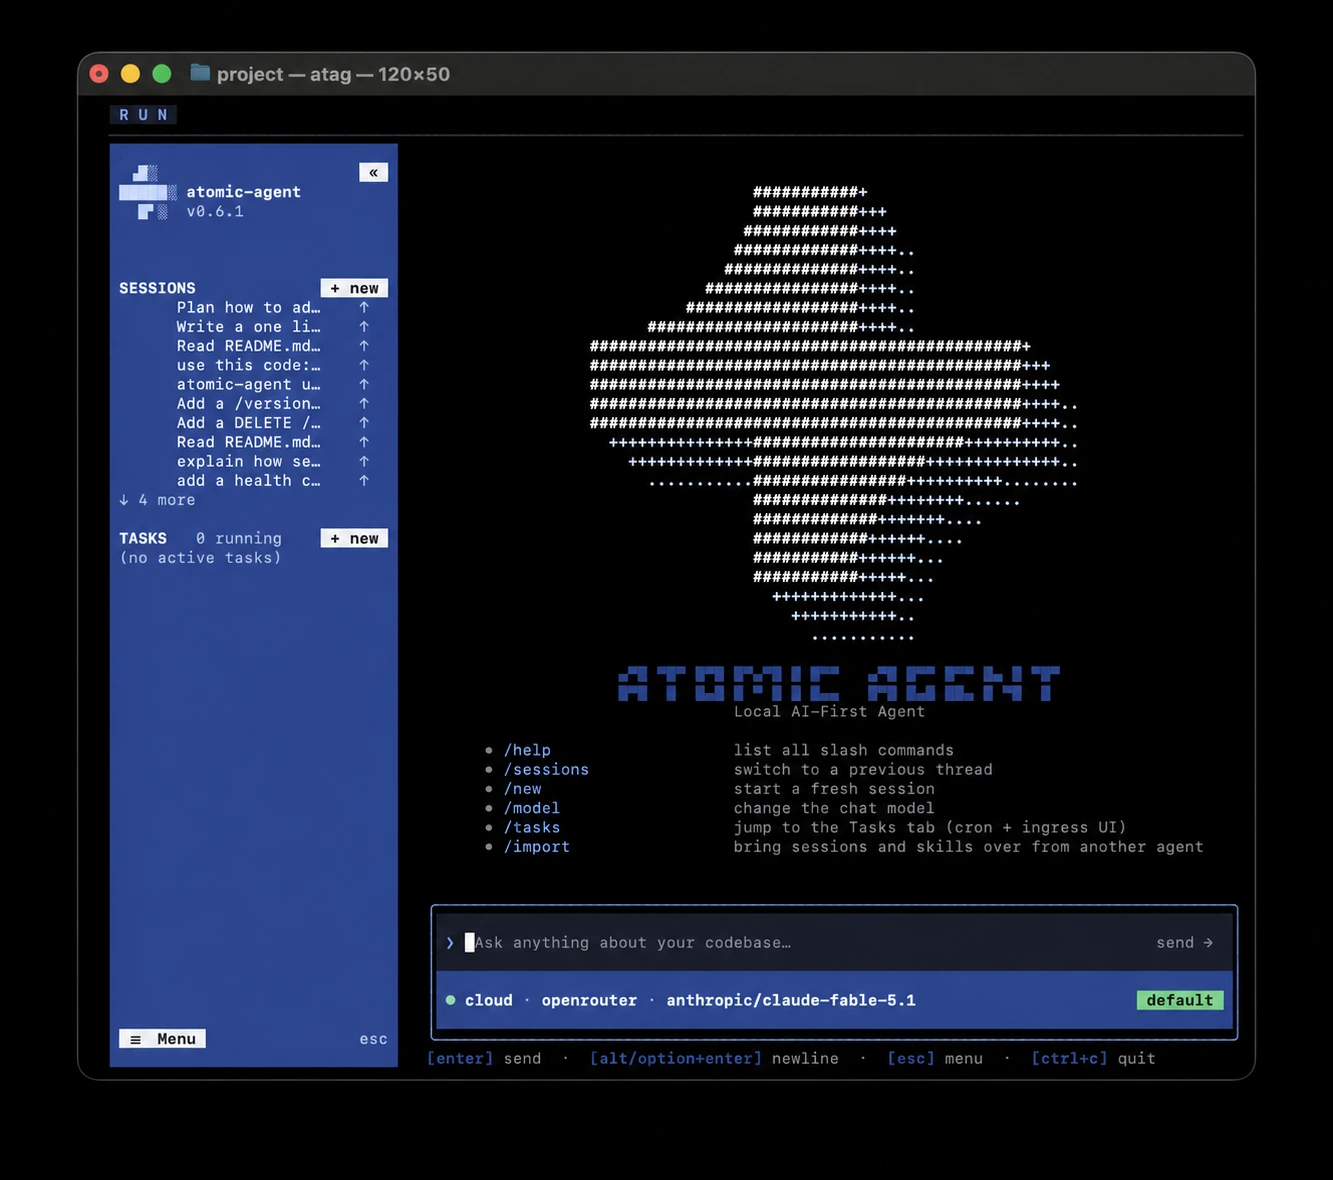
READMEには役割分担が示されています。モデルは操作を提案し、ランタイムが検証、承認、状態、停止のタイミングを制御します。
具体的には、次のような仕組みです。
- 規律あるループ。モデルはツール呼び出しを構造化JSONとして返し、何かを実行する前に文法に照らして検証されます。不正な形式の呼び出しは実行されず、拒否されます。こうした不正な呼び出しこそ、他のエージェントで小型ローカルモデルの処理が行き詰まる原因です。組み込みのループ検出機能が、"同じことを5回試す"ような繰り返しを止めます。
- 実務のためのツール。ファイル、git、シェル、ブラウザー、文書、タスク、MCPサーバーに対応しています。ブラウザーは、各ステップでスクリーンショットを必要とする代わりに、コンパクトなアクセシビリティ状態を読み取ります。画像認識は任意です。
- 持続するメモリ。ローカルのSQLiteデータベースに5つの層(事実、検索可能なノート、リンクグラフ、要約された教訓、再利用可能な手順)を持つため、クラウド同期なしでセッションをまたいでプロジェクトを記憶できます。
- デフォルトで有効な承認機構。シェルコマンド、ファイルへの書き込み、HTTPリクエストはユーザーの確認を待ち、明らかに破壊的なコマンドはそのままブロックされます。
- スキル。現在のREADMEには、17個の初期スキルが記載されています。Markdown形式の手順書は編集可能です。
Atomic AgentはMITライセンスで提供されており、Apple Silicon、Linux x64/arm64、Windows x64向けのビルドがあります。他のエージェントから移行する場合、インポートコマンドで選択したデータを移行前にプレビューできます。まだ開発者プレビュー段階なので、連携機能は変更されることを想定してください。詳しくはatomicagent.ioをご覧ください。
プライバシー上の注意点:匿名の分析とクラッシュレポートはデフォルトで有効です。オプトアウトできます。更新確認、Webツール、メッセージング、クラウドモデル、リモートMCPサーバーは、それぞれ独自のネットワーク経路を持ちます。
向いている人:最初からローカルモデルを中心に設計されたエージェントを求める人。
2. Kilo Code:Atomic Chatと使うIDE・CLIの第一候補
Kilo Codeは、VS Code、JetBrains、ターミナルをまたいで使えます。さまざまなコーディング作業向けのモードを備え、OllamaやLM Studioに加えて、専用のAtomic Chatプロバイダーもあります。エディターを切り替えながら、エージェントの設定は1つに統一したい場合に、より適しています。
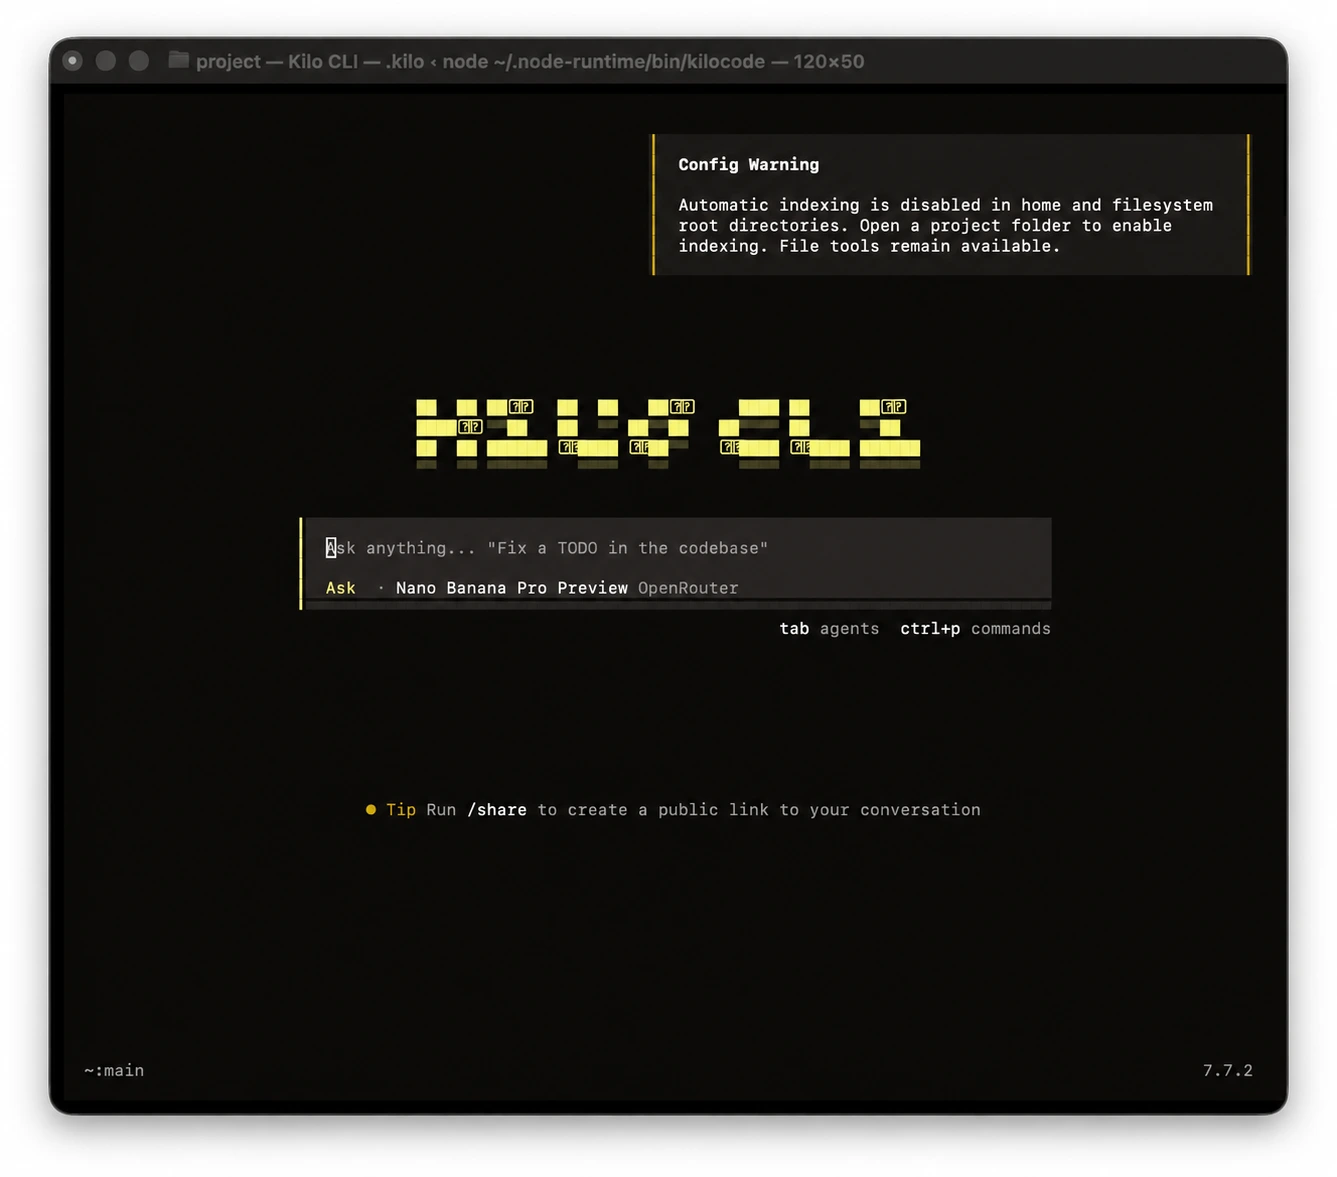
ローカルモデルでのコーディングには、Kilo Codeが私たちの第一候補です。リポジトリの検索、ファイルの編集、テストの実行、変更差分の表示ができます。編集やコマンドに承認を必須とすることや、チェックポイントでタスクをロールバックすることも可能です。これにより、エージェントの変更を確認して元に戻せるコーディングワークフローを構築できます。
atomic-chat/...を選択するか、provider.atomic-chatを設定して、Atomic ChatのローカルAPIに接続します。ドキュメントによると、そのプロバイダーを選ぶまでKiloはlocalhostを探索しません。通常のエンドポイントは127.0.0.1:1337/v1です。ローカルモデルを使う場合、推論にホスト型サービスのトークン料金はかかりません。Kiloのオプションのクラウドサービスを使うかどうかは、別途選択します。
1つのエージェントでコーディングワークフローをカバーします。Planで機能の範囲を定め、Codeでリポジトリを編集し、Debugで失敗するテストの原因を追跡します。Kiloはエージェントごとに選択したモデルを記憶するため、タスクが変わっても、エディターやターミナルでローカルモデルを使い続けられます。
向いている用途:IDEとターミナルをまたいだ、ローカルモデルによる日常的なコーディング。
3. OpenClaw:チャット内で使うアシスタントに最適
OpenClawは、普段会話している場所で動きます。WhatsApp、Telegram、Discord、Slack、iMessageに対応しています。ゲートウェイは自分のマシン上で動きますが、モデルがlocalhostで動いていても、メッセージはこれらのサービスを経由します。これは常時稼働するアシスタント向けのエージェントであり、ネットワークから隔離したコーディング用マシン向けではありません。
Ollamaは文書化された対応プロバイダーです。そのため、ゲートウェイを置き換えずに、クラウド推論をローカルモデルに切り替えられます。更新確認では、バージョンとプラットフォームの情報が送信されます。機能の利用統計はオプトインです。リリース履歴には、2026年9月11日付でv2026.9.4が掲載されています。
リスクになるのはゲートウェイです。セキュリティ研究者は、インターネットに公開された数万件のOpenClawインスタンスを発見しました。自分のゲートウェイはインターネットに公開せず、利用できるアカウントとツールを制限してください。私たちのOpenClawのローカルセットアップガイドでは、モデルへの接続方法を説明しています。
向いている用途:メッセンジャー内で常時稼働するパーソナルアシスタント。
4. Hermes:永続メモリとスキルに最適
Nous ResearchのHermesは、メモリを製品の中心に据えています。会話と再利用可能なスキルをセッション間で保持し、作業中にスキルを修正することもできます。学習した手順で機密性の高いプロジェクトを操作させる前に、その修正内容を確認してください。
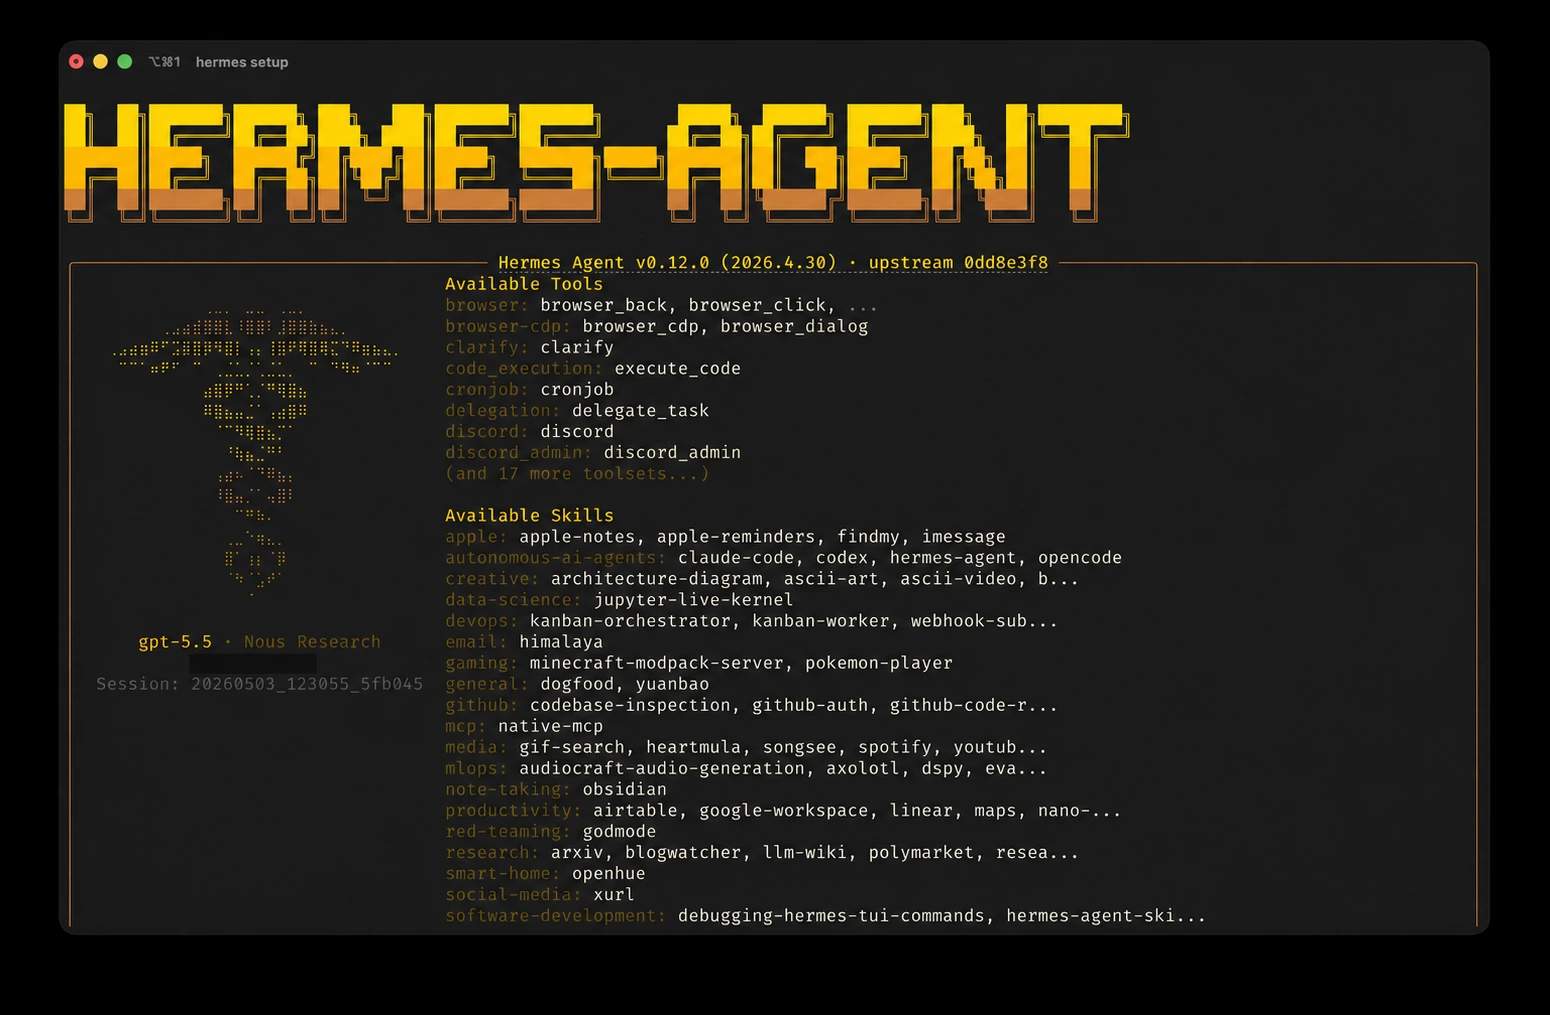
Hermesは、今回の比較でテレメトリに関する方針も最も優れています。公式FAQには、テレメトリ、利用データ、分析データを一切収集せず、すべて(会話、メモリ、スキル)をローカルの~/.hermes/ディレクトリに保存すると記載されています。あらゆるOpenAI互換サーバーが正式なプロバイダーとして扱われます。Ollama、llama.cpp、vLLM、LocalAIの利用方法が文書化されており、ローカルエンドポイントは自動検出されます。
ハードウェア面での注意点はコンテキスト長です。セットアップFAQでは最低64Kが必要とされ、Ollamaユーザーにはサーバーの実効コンテキスト長をそれに合わせて設定するよう注意を促しています。メモリとスキルの説明も、そのコンテキストを使用します。GPUのメモリに余裕がない場合は、量子化を選ぶ前にKVキャッシュに必要な容量を見込んでください。私たちのHermesのローカルセットアップガイドで、接続手順を説明しています。
向いている用途:モデルサーバーが64Kのコンテキストを維持できる場合に、作業内容を記憶する日常的なアシスタントとして使うこと。
5. Claude Code:ローカルにも対応するクラウド優先のコーディングエージェントの第一候補
Claude CodeはAnthropicのターミナル用コーディングエージェントで、難しい複数ステップのリポジトリ作業に有力な選択肢です。通常は自分のマシンでコマンドを実行し、モデルへのリクエストをAnthropicまたは対応するクラウドプロバイダーに送信します。ローカルモデルの利用には設定の上書きが必要であり、製品のデフォルトではありません。
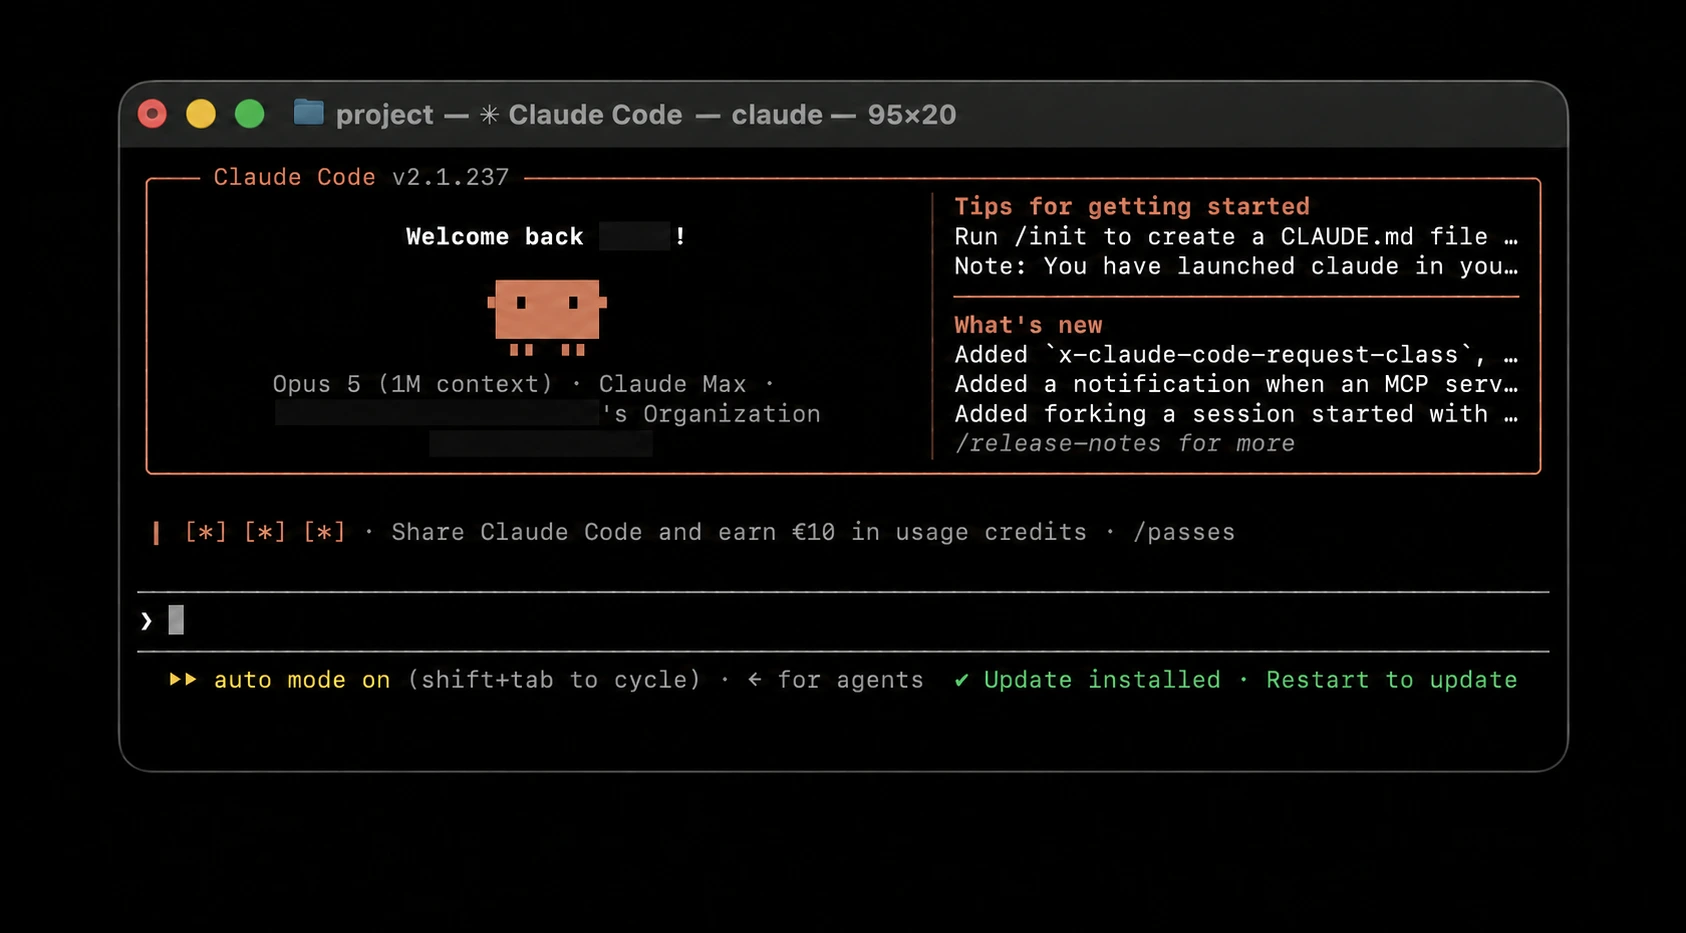
CLIはプロプライエタリです。ローカルで実行しても、デフォルトの推論のプライバシーが確保されるわけではありません。Anthropicはデータとテレメトリの設定を文書化しています。また、機密性の高いコードを扱う際は、ローカルに保存されるセッションの会話記録も考慮する必要があります。
ローカルで使う場合は、OllamaのAnthropic互換エンドポイントを経由します。ANTHROPIC_BASE_URLをlocalhostに設定し、Ollamaの:cloudモデルではなく、ダウンロード済みのモデルを選択してください。Ollamaがこの連携方法を文書化していますが、Anthropicが標準でサポートするモデルの利用方法ではありません。手順は私たちのClaude Codeのローカルセットアップガイドで紹介しています。
向いている人:Claude Codeのコーディングワークフローを使いたく、ローカルバックエンドを別途設定することをいとわない開発者。
6. Cline:IDE内で監督しながら使うコーディングエージェントに最適
Clineは、VS Code内でコードの隣に配置されます。タスクを計画し、ファイルの編集やコマンドを提案し、エディター内で操作を承認できます。エージェントがリポジトリに手を加える前に各ステップを確認したいなら、このワークフローが魅力になります。
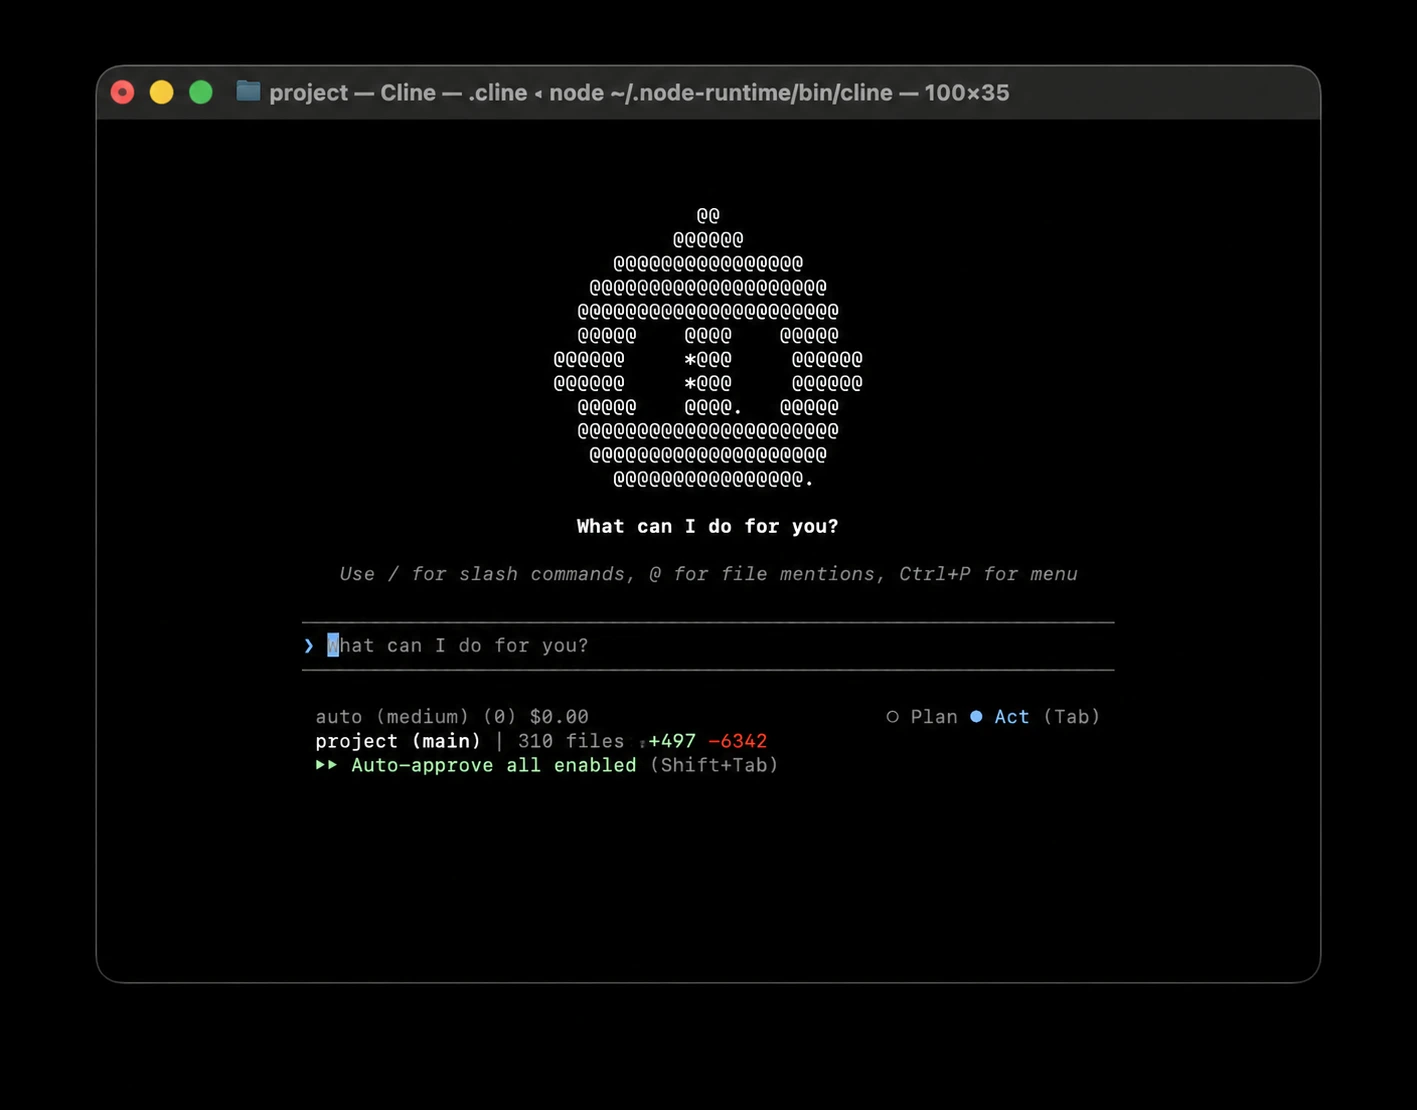
OllamaとLM Studioは組み込みのローカルプロバイダーです。互換エンドポイントも利用できます。注意点はエージェントのループです。小型モデルは、Clineのツールと増え続ける会話を同時に理解する必要があります。ツールを使えるコーディングモデルと、タスクに十分なコンテキスト長を用意してください。
ClineはApache-2.0ライセンスで提供されています。ローカルモデルを使うだけでは、分析やその他の外向き通信の設定は決まりません。インストールするバージョンで、それらの設定を確認してください。
注:エージェントのループでは大量のコンテキストが再送信されるため、クラウドAPIでは料金が急速に増えます。それこそが、接続先をローカルモデルにする理由です。
向いている用途:IDEを離れず、監督しながらエージェントにコーディングを任せること。
7. Goose:MCPワークフロー向けのデスクトップエージェントに最適
GooseはBlockで生まれ、現在はLinux FoundationのAgentic AI Foundationに所属しています。デスクトップアプリとCLIを備え、Apache-2.0ライセンスで提供されており、コードエディターの範囲を超えた作業にも対応できます。そのガバナンスは選ぶ理由の1つですが、タスクのデータがどこに送られるかは、依然としてプロバイダーと拡張機能によって決まります。
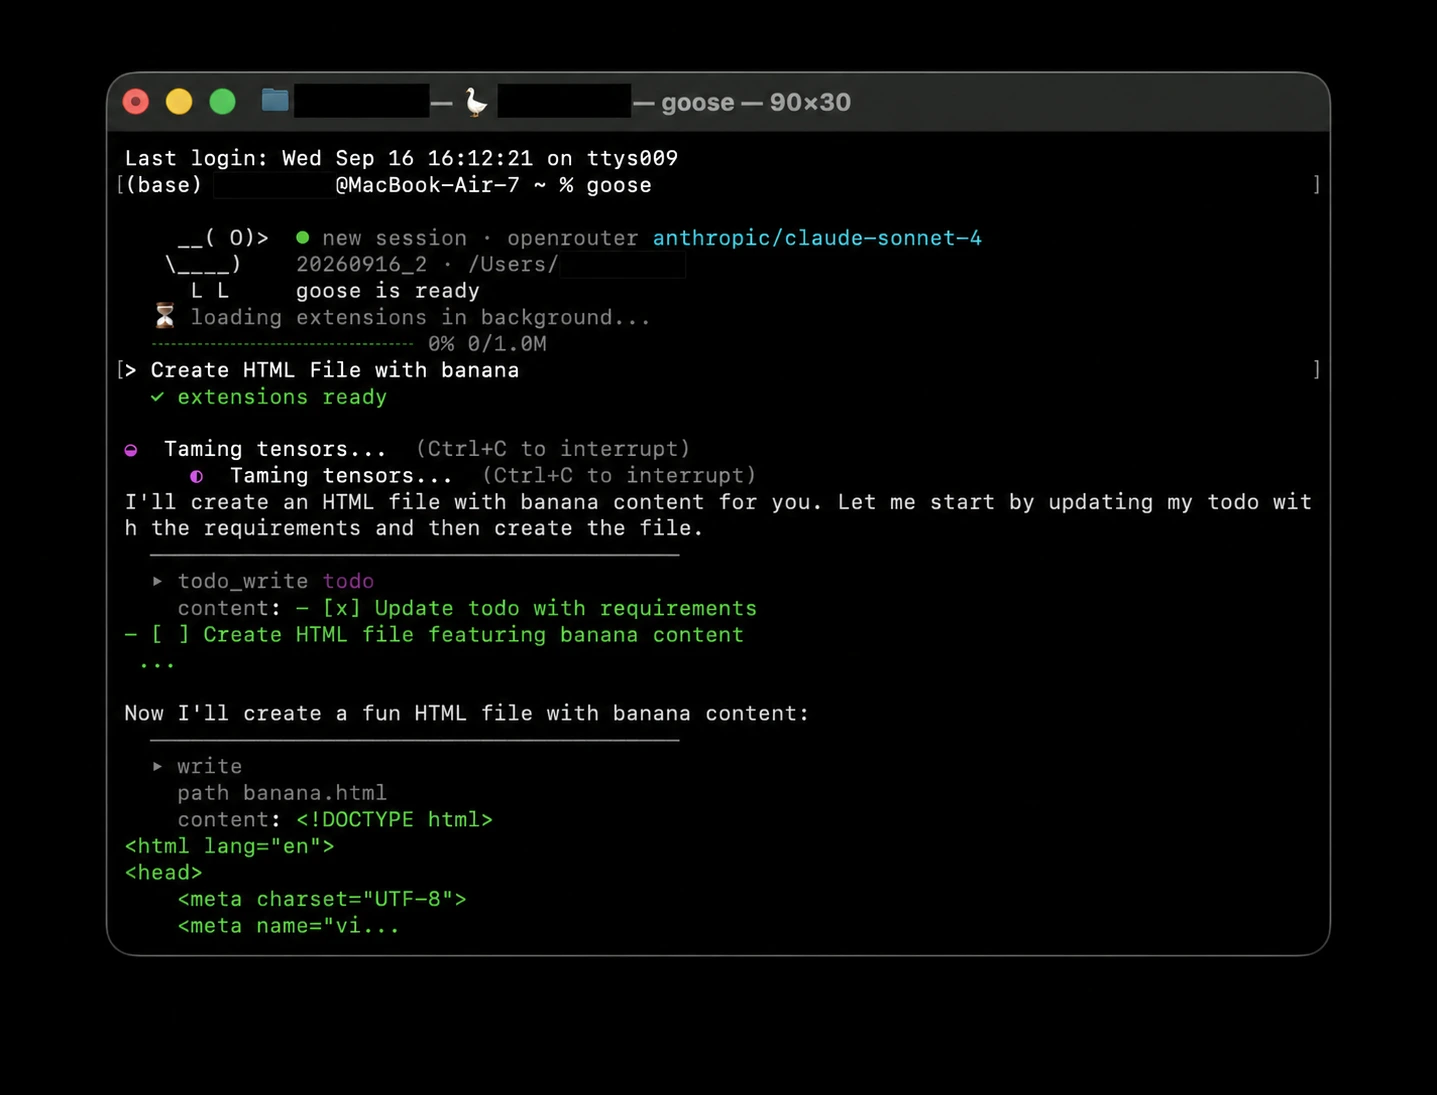
中心となるのは拡張機能です。リポジトリ、データソース、その他のワークフロー用のMCPツールを接続し、ローカル推論にはOllamaを使います。リモートMCPサービスには、エージェントがそのツールに送る内容が引き続き渡されます。インストールできるコネクターをすべて入れるのではなく、タスクに必要な少数の拡張機能から始めてください。
トレードオフ:拡張機能が増えるほど、プロンプト内のツールの説明が増え、小型ローカルモデルが選択を誤る機会も増えます。
向いている用途:中立的なガバナンスの下で行う、コーディングの範囲を超えた汎用的な自動化。
8. pool:Poolsideのオープンウェイトモデルとの組み合わせに最適
poolは、Poolsideのターミナル用コーディングエージェントです。注目の組み合わせはLaguna XS 2.1です。総パラメーター数33B、アクティブパラメーター数3Bのオープンウェイトのコーディングモデルで、OpenMDW-1.1ライセンスで提供されています。Poolsideは、自社で提供するAPIで256Kのコンテキスト長をうたっています。ただし、ローカルで量子化モデルを実行する場合は、重みとKVキャッシュのためのメモリが必要なので、24GBのGPUでその全長を使えるとは考えないでください。
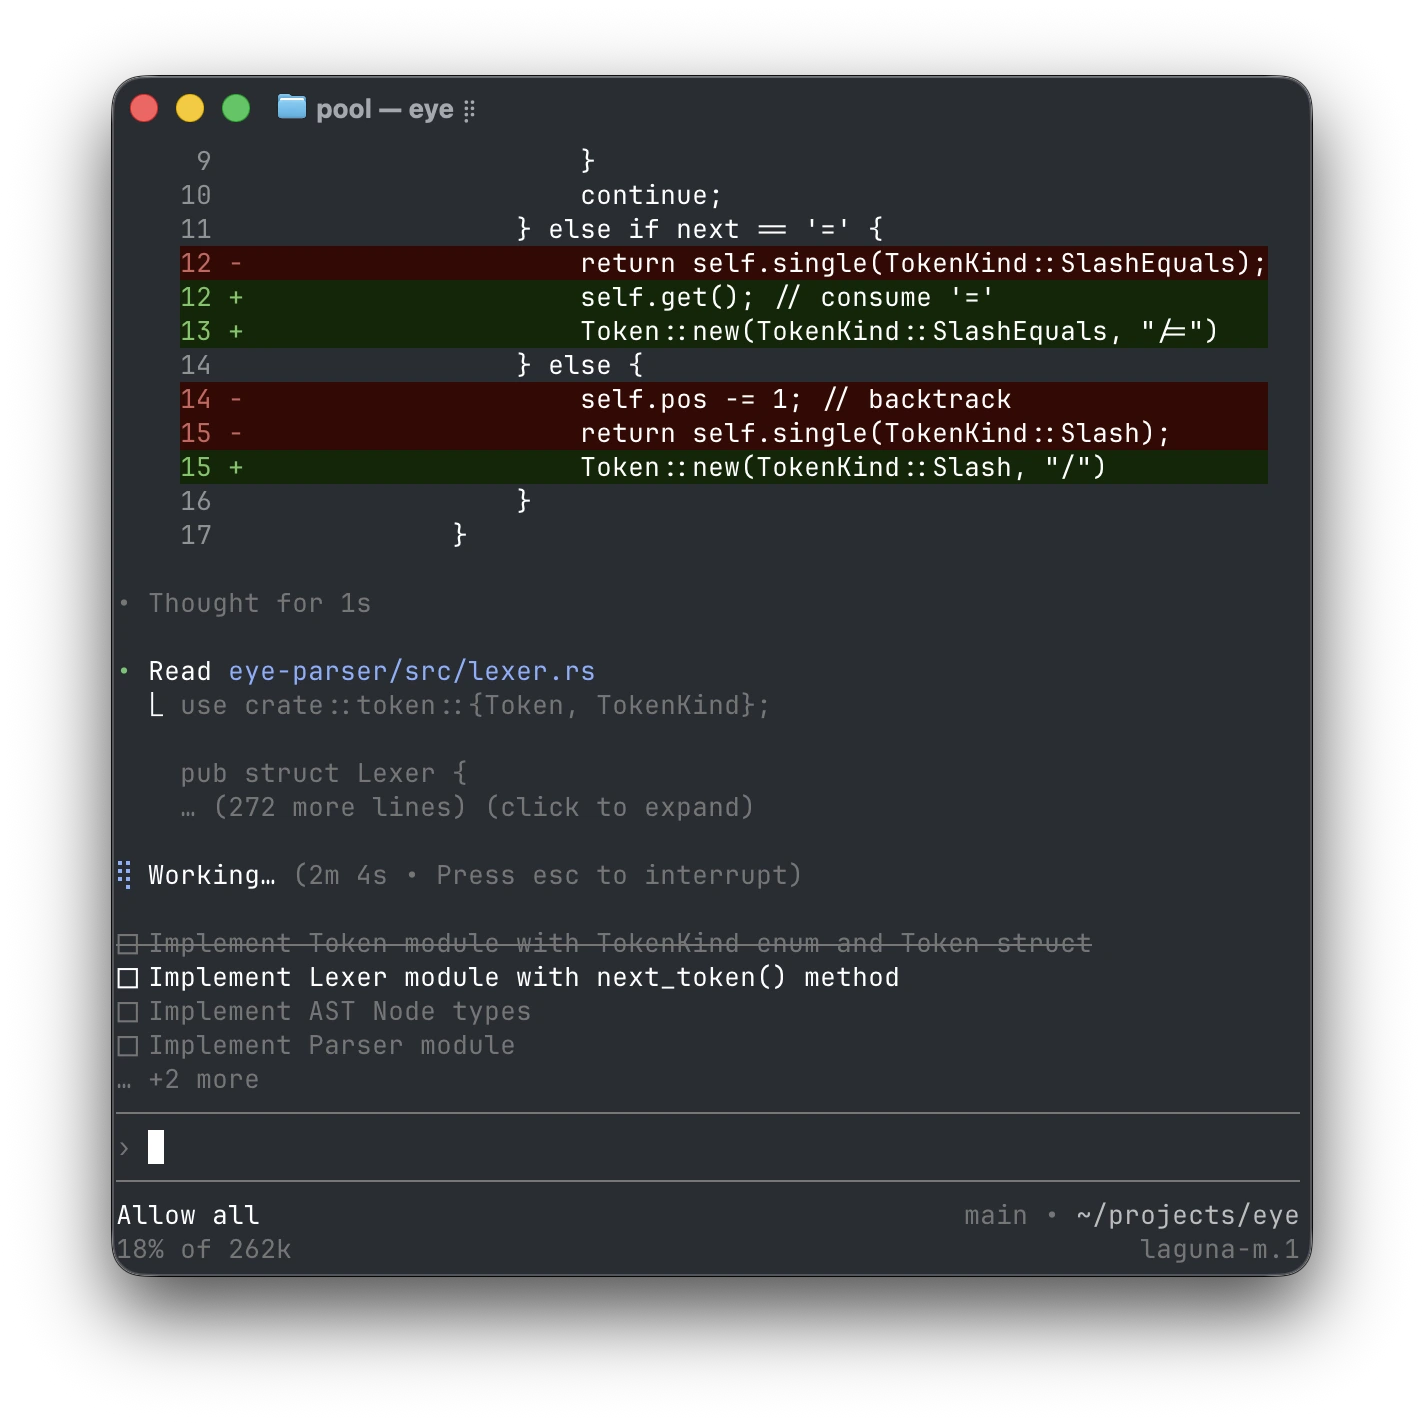
poolのREADMEには、ターミナルUI、ACPによるエディター連携、Ollama、設定可能なOpenAI互換エンドポイントが記載されています。Poolsideのホスト型推論の代わりに、このローカルの利用方法を選べます。
ライセンス上の注意点:poolのエージェントのバイナリはプロプライエタリです。モデルがオープンウェイトでも、エージェントがオープンソースとは限りません。また、LagunaのライセンスはApache 2.0ではありません。
向いている用途:そのエージェント向けに作られたオープンウェイトモデルでエージェントを動かすこと。
選外となった2つの有名エージェント
古いまとめ記事では、今も両方が推奨されています。しかし、現在のリポジトリの状態を踏まえると、推奨は変わります。
- Aiderは、ターミナルでのペアプログラミングの形を作る一翼を担いました。GitHubに掲載されている最新リリースは2025年8月9日のv0.86.0です。今も動作する可能性はありますが、これを中心に新しいワークフローを構築する前に、現在のモデルとの互換性と未解決のIssueを確認してください。
- ContinueはローカルでのIDE支援を先駆けましたが、リポジトリは読み取り専用となり、積極的なメンテナンスも終了しています。最終リリースの2.0.0では、匿名テレメトリと認証が削除されました。既存のインストールを使い続けることと、新しいチームのためにアーカイブ済みのプロジェクトを選ぶことは別です。
まとめ記事が上記に触れずにこの2つのどちらかを勧めている場合は、その記事がいつ書かれたかを確認してください。
ローカルAIエージェントの比較
モデルだけでなく、エージェントも比較してください。モデルとエージェントのライセンスは異なる場合があり、ローカル推論であることから、メッセージングの通信や更新確認については何も判断できません。ここに示すのは文書化された利用方法と注意点であり、ネットワークキャプチャによるテスト結果ではありません。
| エージェント | インターフェース | ローカルモデルの利用方法 | エージェントのライセンス | ネットワーク上の注意点 |
|---|---|---|---|---|
| Atomic Agent | CLI + TUI | デフォルトでローカルのllama.cppサーバーを使用 | MIT | 分析とクラッシュレポートがデフォルトで有効。更新確認あり |
| Kilo Code | IDE + CLI | Atomic Chat、Ollama、LM Studio | オープンソースのコンポーネント | 分析とオプションのクラウドサービスを確認 |
| OpenClaw | ゲートウェイ + メッセンジャー | Ollamaプロバイダー | オープンソース | メッセンジャーの通信と更新確認 |
| Hermes | TUI + メッセージング | OpenAI互換のローカルエンドポイント | MIT | メッセージング、または設定したリモートツールやプロバイダー |
| Claude Code | CLI + IDE | OllamaのAnthropic互換API | プロプライエタリ | Anthropic関連の機能とアカウント設定の確認が必要 |
| Cline | IDE + CLI | Ollama、LM Studio、互換エンドポイント | Apache-2.0 | 現在のテレメトリ設定とツールを確認 |
| Goose | デスクトップ + CLI | Ollamaプロバイダー | Apache-2.0 | リモートMCP拡張機能とプロバイダーの選択 |
| pool | CLI + ACP対応エディター | OllamaまたはOpenAI互換エンドポイント | プロプライエタリのエージェント | ホスト型モデルは別の利用経路 |
これらのエージェントをローカルモデルで動かす方法
構成はエージェント、ローカルモデルサーバー、ツールを使えるモデルの3つから成ります。ここで紹介したエージェントの多くは、OpenAI互換APIで通信します。Claude CodeをOllama経由で使う場合は、代わりにAnthropic互換APIを使います。エージェントのデバッグを始める前に、ベースURLとモデル名を正しく設定してください。
私たちが開発の軸にしているのは、Atomic Chatを使う方法です。モデルを読み込み、http://localhost:1337/v1でAPIを有効にして、Claude Code、Cline、Goose、OpenHands、Codex CLI、OpenCode、Droid、Copilot CLI、Kilo Code、Zed向けのIntegrationsのランチャーを使います。OpenClaw、Hermes、poolには、それぞれ独自のプロバイダー設定があります。すでにOllamaやLM Studioでモデルを提供しているなら、それらも代替手段になります。
コーディングでは、適切な量子化モデルとコンテキストをハードウェアのメモリに収められるなら、まずQwen3-Coder 30B-A3Bを試してください。モデルカードにはネイティブのコンテキスト長が256Kと記載されていますが、256K分のKVキャッシュと重みが24GBのVRAMに収まるという保証ではありません。まず実際に使うコンテキスト長を小さめに設定し、エージェントで実際のタスクを実行してから、メモリに余裕があれば増やしてください。gpt-oss-20bも候補です。詳しくはエージェントのセットアップガイドとコーディングモデルの比較をご覧ください。
どのローカルAIエージェントを選ぶべきか?
ローカル優先のエージェントを1つ選ぶなら、Atomic Agentから始めてください。私たちは同じエコシステムの一員です。また、求めていない外向き通信を一切発生させたくない場合は、デフォルトで有効な分析をオプトアウトする必要があります。他のワークフローでは、次のように選べます。
- VS Code、JetBrains、CLIをまたいで作業する:Kilo Code。提案された操作を1つずつVS Code内で確認したい場合は、Clineを選んでください。
- グループチャットでアシスタントを使いたい:OpenClaw。
- 自分のことを記憶するエージェントが欲しい:高性能なハードウェアで動かすHermes。
- 最難関のコーディングタスクを優先し、ローカル性は二の次:Claude Code。
- エージェント向けに作られたオープンウェイトモデルを使いたい:pool。
- 中立的なガバナンスと、あらゆるもののMCP連携を重視する:Goose。
よくある質問
最もおすすめのローカルAIエージェントは?
ローカル優先のランタイムとして私たちが推すのはAtomic Agentです。文法チェック付きのツール呼び出し、永続的なローカル状態、承認機構を備えています。このサイトと同じAtomicのエコシステムに属しています。IDEでのコーディングにはKilo CodeかCline、メッセージングにはOpenClaw、スキルを保持するアシスタントにはHermesを選んでください。これはワークフローに基づく推奨であり、1つのエージェントがすべてのベンチマークで勝つという主張ではありません。
AIエージェントは完全にオフラインで動かせますか?
はい。エージェントとモデルの両方がローカルにインストールされていれば可能です。Web検索、リモートMCPツール、メッセージング、更新、クラウドでの埋め込み生成、分析は、それぞれ別の接続です。それらを無効にし、ネットワークを切断した状態でテストしてから、その構成がネットワークから隔離されていると判断してください。
AIエージェントをローカルで動かすには、どのようなハードウェアが必要ですか?
実際に使うコンテキスト長を制限した量子化済みの20-30Bクラスのコーディングモデルには、24GBのGPUまたは32GBのMacが出発点として役立ちます。小型モデルなら少ないメモリでも動きますが、長いタスクでのツール使用の性能が低下する可能性があります。重み、ランタイム、KVキャッシュのすべてに容量が必要です。モデルがうたう最大コンテキスト長だけでは、自分のマシンに何が収まるかは分かりません。
Claude Codeはローカルモデルを使えますか?
はい。OllamaのAnthropic互換エンドポイントを経由して使えます。ANTHROPIC_BASE_URLをlocalhostに設定し、ダウンロード済みのモデルを選択してください。これはOllamaが文書化した連携方法であり、Claude CodeがデフォルトでAnthropicのモデルを使う経路とは異なります。任意のアカウント機能は、引き続きネットワークに接続する場合があります。手順は私たちのClaude Codeガイドに掲載しています。
ローカルAIエージェントはプライバシーを守れますか?
アプリ全体がオフラインでなくても、推論のプライバシーは確保できます。モデルは自分のハードウェア上でプロンプトを処理しますが、エージェントは引き続き、分析、更新確認、メッセンジャー、Web閲覧、リモートMCPサーバー、クラウドツールを利用する場合があります。秘密情報や機密性の高いリポジトリを渡す前に、これらの接続を確認してください。
エージェントを動かすのに最もおすすめのローカルモデルは?
量子化モデルと実際に使うコンテキストをメモリに収められるなら、Qwen3-Coder 30B-A3Bはコーディング向けの有力候補です。モデルカードにある256Kという数値は対応能力を示すものであり、ハードウェアでの動作保証ではありません。Devstral Smallとgpt-oss-20bも試す候補です。採用を決める前に、選んだエージェントで同じ実際のタスクを実行してください。
ローカルAIエージェントはMCPに対応していますか?
はい。Atomic Agent、Hermes、Claude Code、Cline、Kilo Code、Goose、poolはMCPツールに対応しています。モデルがローカルで動いていても、リモートMCPサーバーはエージェントからデータを受け取ることがあります。私たちのMCPサーバーガイドで、この接続の仕組みを説明しています。
オープンソースのAIエージェントは安全に実行できますか?
より安全に監査できますが、それは安全に実行できることと同じではありません。オープンソースなら、シェルへのアクセス権を与える前にエージェントの動作をコードで確認できます。ただし、コマンドを実行するエージェントはどれも何かを壊す可能性があり、今年行われた、インターネットに公開されたエージェントのゲートウェイのスキャンでは、基本的な対策を怠る人がいかに多いかが示されました。承認機構とコマンドの保護機能を備えたエージェントを優先し、ゲートウェイをインターネットに公開せず、エージェントには操作を誤っても許容できるディレクトリへのアクセス権を与えてください。
ローカルAIエージェントとローカルLLMアプリの違いは何ですか?
ローカルLLMアプリ(Atomic Chat、LM Studio)はモデルを動かし、チャット画面を提供します。ローカルAIエージェントは、そこに行動のための層を加えます。具体的には、ツール、ループ、複数ステップのタスクを完了するための自律性です。両者は組み合わせて使えます。アプリがモデルを提供し、エージェントがそれを利用します。私たちのローカルLLMアプリのまとめでは、その構成の前半を取り上げています。
結論
選ぶ際に重要なのは、万能の勝者を探すことより、エージェントにどのような仕事を任せたいかです。Atomic Agentはローカルのループを中心に構築されています。ClineとKilo Codeはコードの隣で動きます。OpenClawはチャット内で動き、GooseはMCPツールで機能を広げます。Claude Codeとpoolにはローカルバックエンドがありますが、どちらも同じようなローカル優先のワークフローをデフォルトにはしていません。
ローカル優先の設計が合うなら、Atomic Agentから始めてください。そうでなければ、実際に使うインターフェースを選び、Atomic Chatまたは他のローカルサーバーでツールを使えるモデルを提供し、機密ファイルやアカウントを接続する前に、実際のタスクを1つ実行してください。




