

このガイドでは、gpt-ossをローカルで実行する方法、システムに応じたOpenAIのローカルモデルの選び方、ワンクリックでオフラインAIをセットアップする方法を解説します。
要点
ChatGPTにはGPT 5.6などのクローズドソースモデルが使われていますが、OpenAIはローカルで実行できる2つのモデルも公開しています。gpt-oss-20b(パラメータ数21B、ダウンロード容量約14 GB)とgpt-oss-120b(パラメータ数117B、ダウンロード容量約65 GB)です。どちらもコンテキスト長は128Kで、Apache 2.0で公開されています。また、どちらのgpt-ossモデルも、Atomic Chat、Ollama、LM Studio、llama.cppなどのオフラインAIアプリを使ってローカルで実行できます。
gpt-ossとは、具体的にどのようなモデルですか?
gpt-ossは、OpenAIのオープンウェイトモデルファミリーです。gpt-ossの各オープンソースモデルは2025年8月に公開され、重みが公開されているほか、Apache 2.0ライセンスの下で商用利用が全面的に認められています。
このファミリーには2つのモデルがあります。
- gpt-oss-20b:総パラメータ数21B、アクティブパラメータ数3.6B、エキスパート数32。
- gpt-oss-120b:総パラメータ数117B、アクティブパラメータ数5.1B、エキスパート数128。
すべてのgpt-ossモデルはMixture of Experts(MoE)設計を採用しており、各トークンの処理時にパラメータの一部だけを有効にすることで、高速な動作を維持します。
また、どちらのgpt-ossモデルも128Kトークンのコンテキスト長に対応し、推論の強度を低から高まで調整できます。
ベンチマークについては、OpenAIの報告によると、20bはo3-miniとほぼ同等、120bモデルはおおむねo4-miniと同水準の性能を示しています。
仕様上の両モデルの比較は次のとおりです。
| gpt-oss-20b | gpt-oss-120b | |
|---|---|---|
| 総パラメータ数 | 21B | 117B |
| アクティブパラメータ数 | 3.6B | 5.1B |
| エキスパート数(MoE) | 32 | 128 |
| コンテキスト長 | 128Kトークン | 128Kトークン |
| 量子化 | MXFP4(4ビット) | MXFP4(4ビット) |
| ダウンロード容量 | 約14 GB | 約65 GB |
| モダリティ | テキストのみ | テキストのみ |
| ライセンス | Apache 2.0 | Apache 2.0 |
確かに、最新世代のモデルは同じパラメータ数でも性能が大幅に向上しているため、2026年にはコーディングにより適したローカルLLMがあります。それでもgpt-ossでは、GPT-4oのような以前のGPTモデルで特に多くの人に好まれていた、OpenAIの事前学習による特性を得られます。
gpt-oss-20bとgpt-oss-120b:どちらを実行すべきですか?
どのgpt-ossモデルを実行すべきかは、主にハードウェアによって決まります。PCのハードウェア要件は次の表のとおりです。
| 要件 | gpt-oss-20b | gpt-oss-120b |
|---|---|---|
| 最小RAM容量 | 約16 GB | 約80 GB |
| 推奨GPU | RTX 4070 / 4080(VRAM 12〜16 GB) | H100 / A100(80 GB)、または48 GBのカード2枚 |
| CPUのみで実行できますか? | はい。ただし低速です | 実用的ではありません |
| 高性能GPUでの速度 | 約30〜50以上のトークン/秒 | 約10〜20トークン/秒 |
| CPUのみでの速度 | 約5〜10トークン/秒 | 1桁台 |
| ノートPCで実行できますか? | はい | いいえ |
Macでgpt-ossを実行するためのハードウェア要件は、次の表のとおりです。
| Mac | gpt-oss-20b | gpt-oss-120b |
|---|---|---|
| M1 / M2(16 GB) | 余裕はありませんが、動作可能です | 実行できません |
| M2 / M3 Pro(32 GB) | 余裕を持って動作、約20〜40トークン/秒 | 実行できません |
| M3 / M4 Max(64 GB) | 高速 | 動作可能かどうかの境界域 |
| M3 Ultra(96〜192 GB) | 高速 | 実行可能、約15〜30トークン/秒 |
まとめると、マシンに16〜32 GBのVRAMまたはユニファイドメモリがあれば、gpt-oss-20bを実行できます。
マシンに96 GBのVRAMまたはユニファイドメモリがあれば、gpt-oss-120bを実行できます。
gpt-ossをローカルで実行するために必要なハードウェアは、どう算出するのでしょうか?
どのローカルモデルにも使える最も簡単な目安は、ファイルサイズの約2倍の空きメモリを確保することです。
これは、ランタイムが重み自体に加え、コンテキストウィンドウとキーバリューキャッシュのための余裕を必要とするためです。
また、「空き」はマシンの総メモリ容量を意味しません。通常の使用時には、その多くがほかのシステムプロセスによって使われているためです。
PCでは、モデル全体をVRAMに収めるのが理想です。収まりきらずシステムRAMにはみ出すと、速度が大幅に低下するためです。
Apple SiliconではCPUとGPUがユニファイドメモリを共有するため、この問題はありません。そのため、32 GBのユニファイドメモリを搭載したMacなら、20bモデルを余裕を持ってメモリに収められます。
gpt-ossの性能はどの程度ですか?
gpt-oss-120bモデルはOpenAIのo3-miniを上回り、ほとんどのベンチマーク(以下に掲載)でおおむねo4-miniと同水準の性能を示します。一方、gpt-oss-20bはo3-miniクラスに近い性能です。
| ベンチマーク | gpt-oss-120b | gpt-oss-20b |
|---|---|---|
| AIME 2024(数学) | 96.6% | 96.0% |
| AIME 2025(数学) | 97.9% | 98.7% |
| GPQA Diamond(博士課程レベルの科学) | 80.9% | 74.2% |
| MMLU(一般知識) | 90.0% | 85.3% |
| Codeforces(コーディングのEloレーティング) | 2622 | 2516 |
ローカルモデルが発揮できる最高峰の性能ではありませんが、実用面では依然として非常に高性能なモデルです。例えば、数学コンテストのスコアでは、両モデルともAIMEで96%を超えています。把握しておくべき重要な制限が2つあります。
- GPQAベンチマークのスコアが示すように、gpt-oss-20bが最も苦手とするのは、豊富な知識を必要とするタスクです。
- すべてのgpt-ossモデルはテキストのみに対応しています。
つまり、gpt-ossはチャット、推論、コード、ツール利用、関数呼び出しに適していますが、画像入力には対応していません。
gpt-ossをローカルで実行する方法
gpt-ossを実行する一般的な方法は、ワンクリックで使えるアプリからコマンドラインまで5つあります。それぞれの方法でgpt-ossをローカル実行する手順を、簡単なものから紹介します。
1. Atomic Chatでgpt-ossを実行する(最も簡単)
gpt-ossをローカルで実行する最も簡単な方法は、Atomic Chatを使うことです。Atomic Chatは、ローカルAIを手軽に使い始められるように設計された、無料のオープンソースアプリです。Atomic Chatでgpt-ossモデルを実行する手順は次のとおりです。
- atomic.chatからAtomic Chatをダウンロードし、ほかのアプリと同じようにインストールします。推論エンジンは自動でセットアップされます。
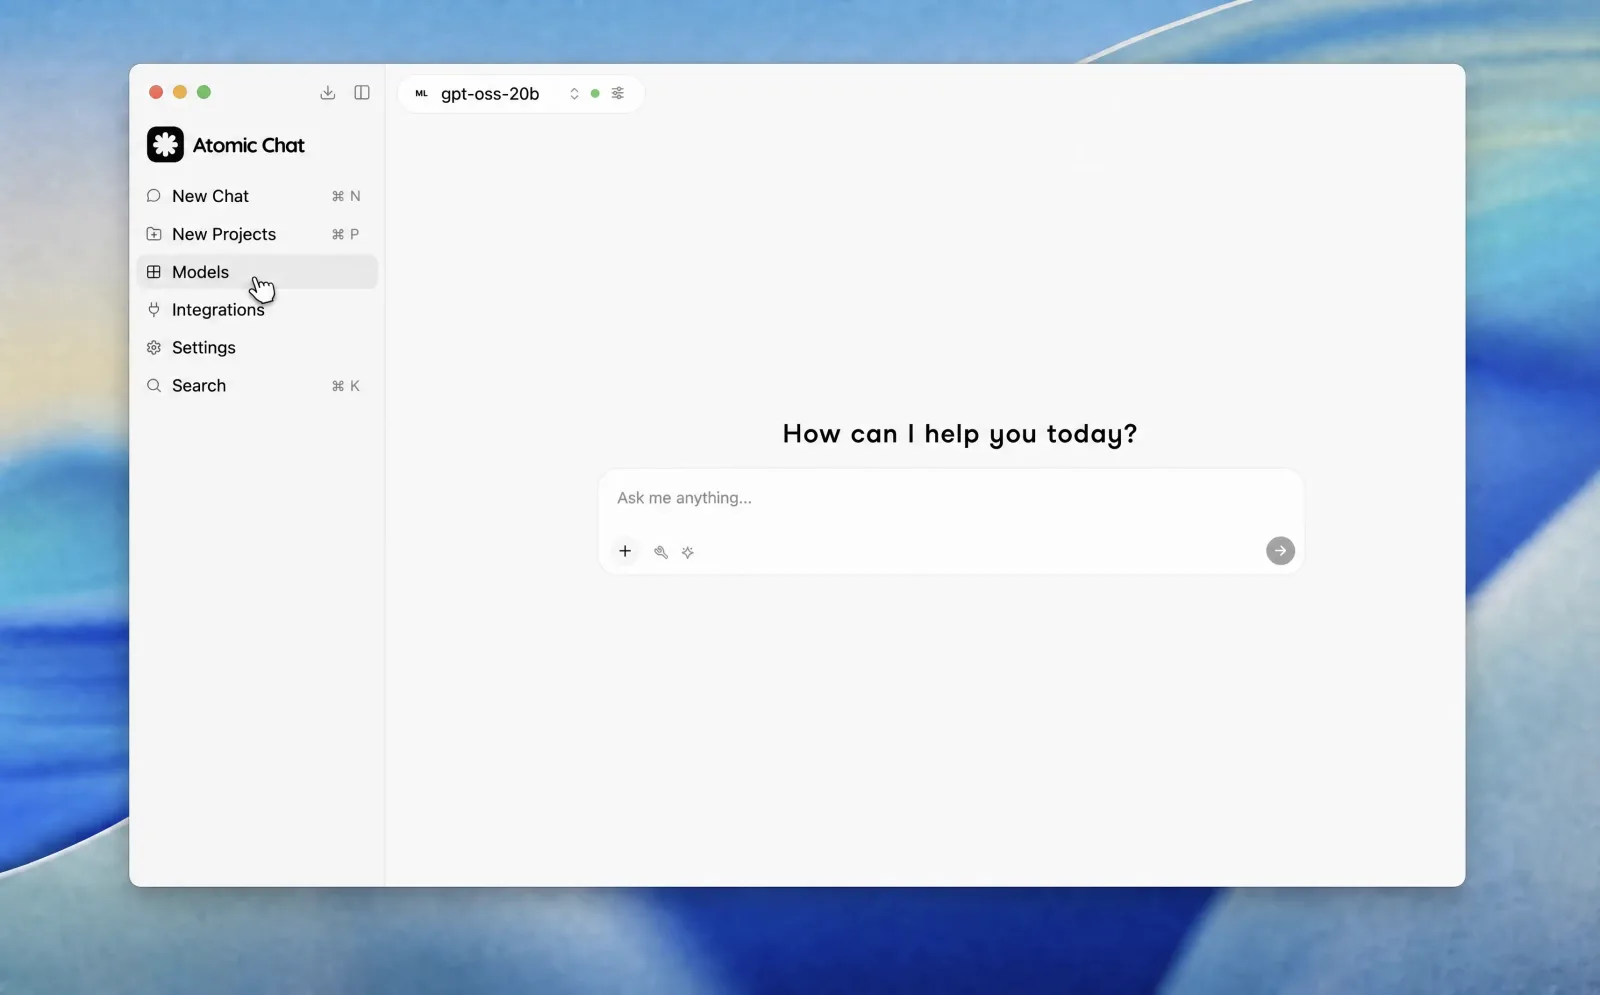
- 左サイドバーでModelsを開きます。ここでは、アプリ内からHugging Faceのライブラリを閲覧・検索できます。
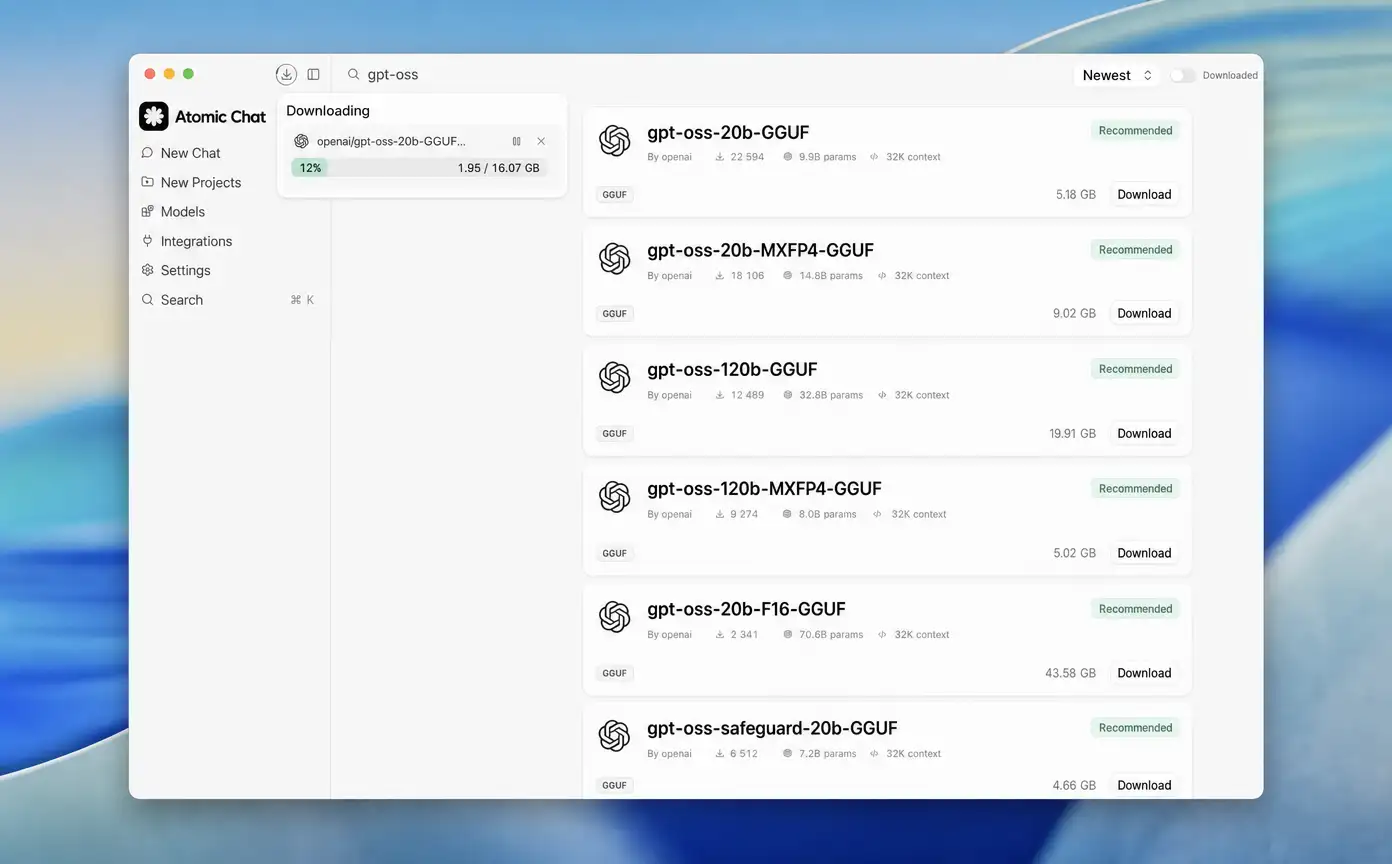
- 「gpt-oss」を検索し、サイズを選んでダウンロードします。Atomic Chatには、gpt-ossの各バージョンがサイズとともに表示され、Downloadボタンをワンクリックするだけでダウンロードできます。メモリに収まるものを選ぶと、アプリがHugging Faceから重みを取得します。迷った場合はgpt-oss-20bから始めてください。
- チャットを始めます。ダウンロードが完了するとモデルが読み込まれ、通常のチャットウィンドウでgpt-ossと完全オフラインで会話できます。
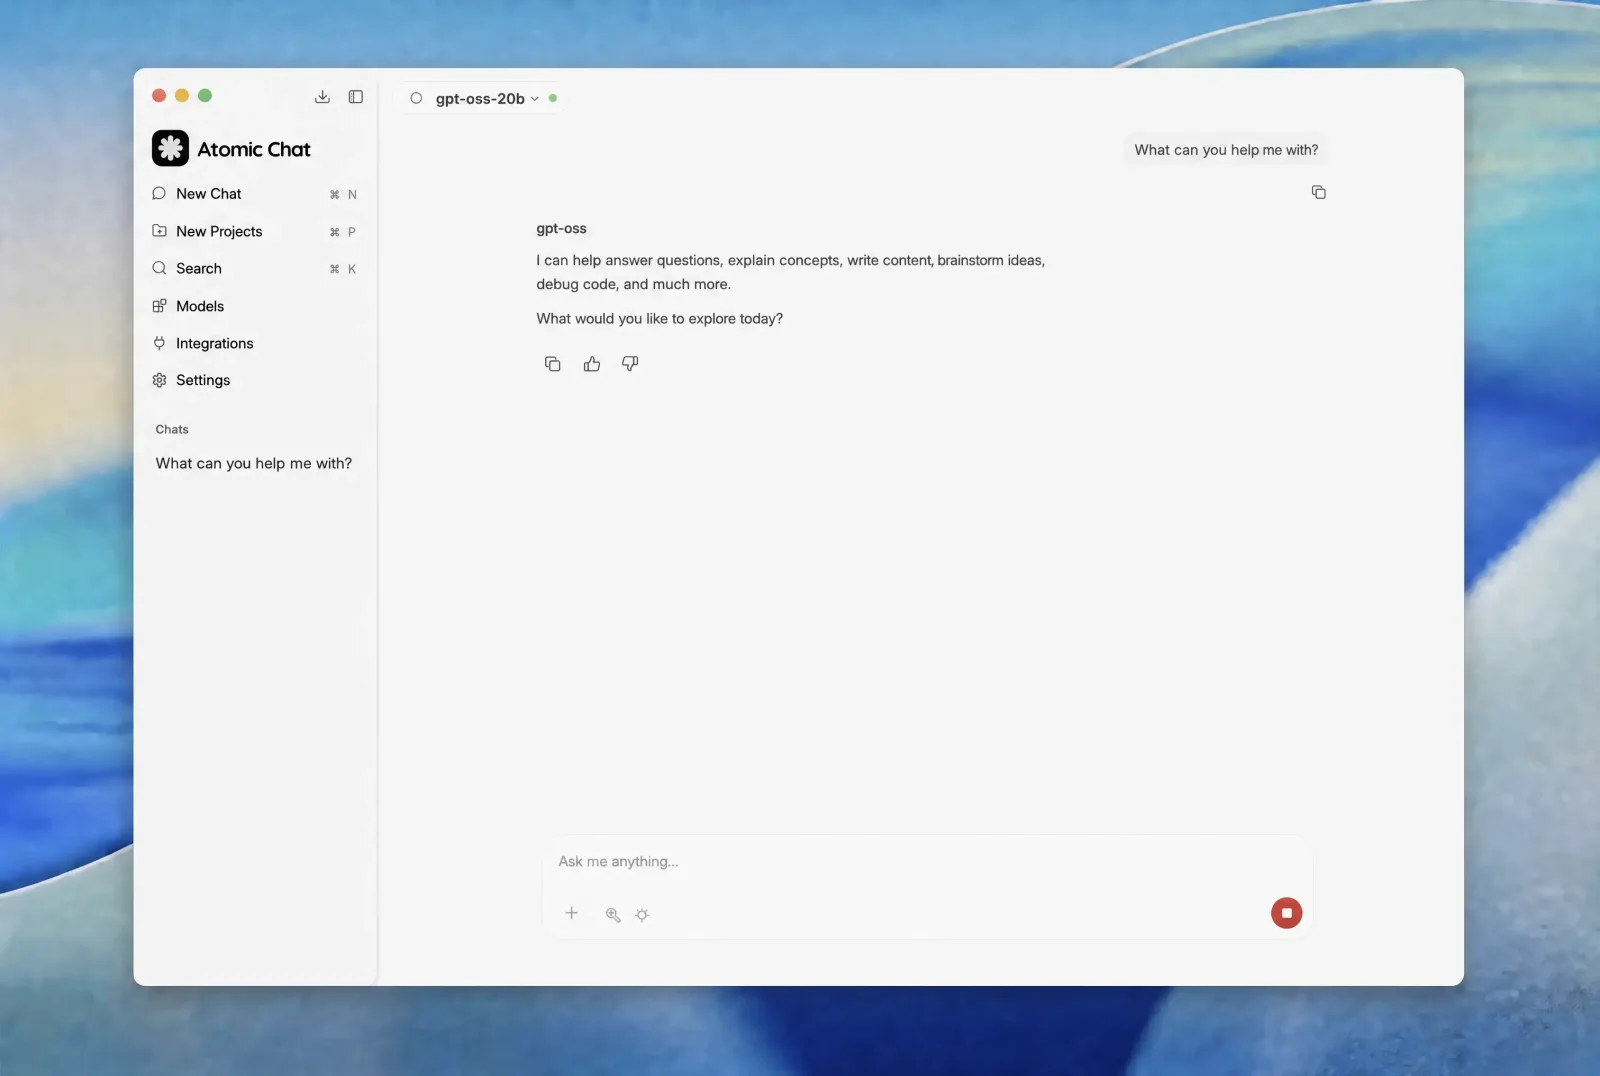
Atomic Chatは、マシンに適した量子化を自動で選択し、Multi-Token Predictionを搭載したTurboQuant推論エンジンによって、標準的な構成より30〜70%高速に動作します。また、http://localhost:1337/v1でOpenAI互換APIを提供し、エージェント用ツールのためのMCPにも対応しているため、追加のセットアップなしで、ほかのアプリの接続先をローカルのgpt-ossに設定できます。
2. Ollamaでgpt-ossを実行する
Ollamaは、macOS、Windows、Linuxでgpt-ossなどのモデルをローカル実行するための、無料のオープンソースツールです。Ollamaでgpt-ossを実行する方法は、デスクトップアプリとターミナルの2つです。
Ollamaアプリを使う
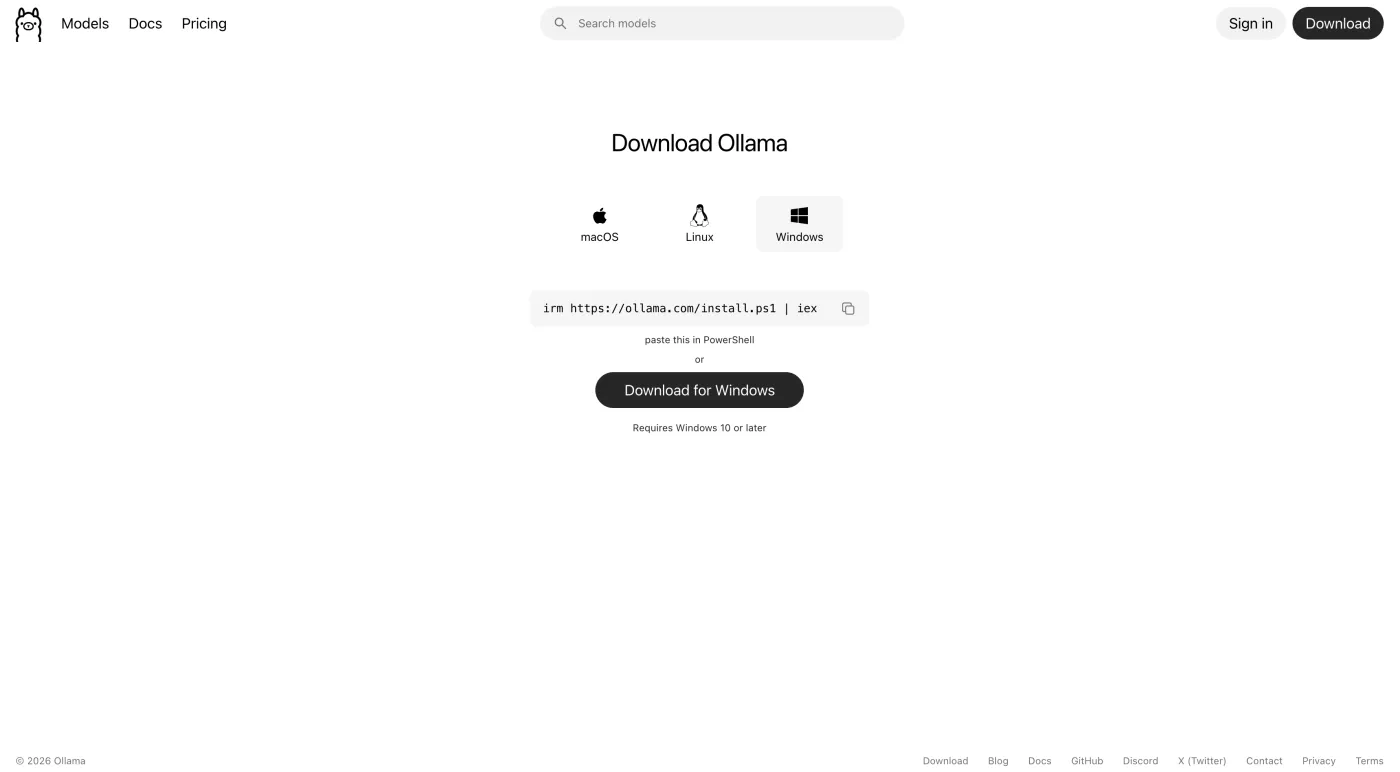
- Ollamaをインストールします。Ollamaの公式サイトからインストーラーをダウンロードして実行します。Ollamaはデスクトップアプリをインストールし、バックグラウンドで動作します。メニューバー(Mac)またはシステムトレイ(Windows)のアイコンをクリックして、チャットウィンドウを開きます。
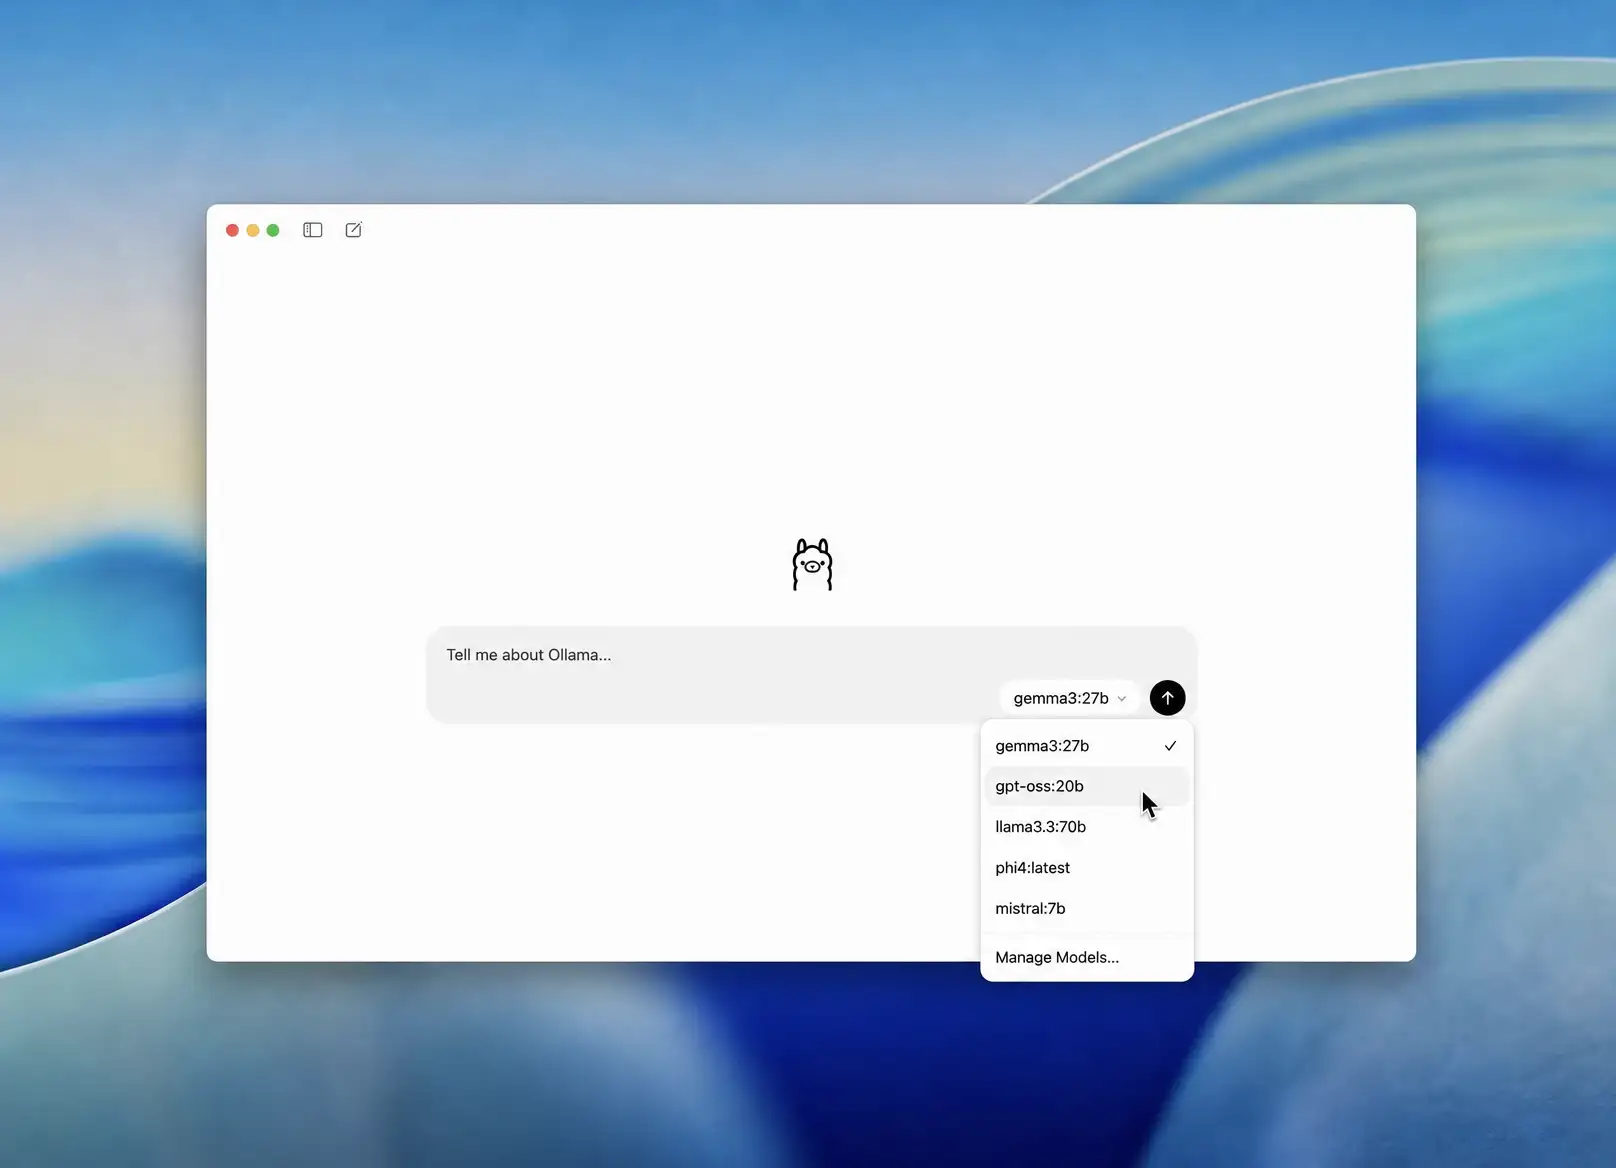
- モデルのドロップダウンからgpt-ossを選びます。メッセージ入力欄の横にあるモデル選択メニューを開き、gpt-ossのサイズを選びます。まだ持っていないモデルを選択すると、自動でダウンロードされます。
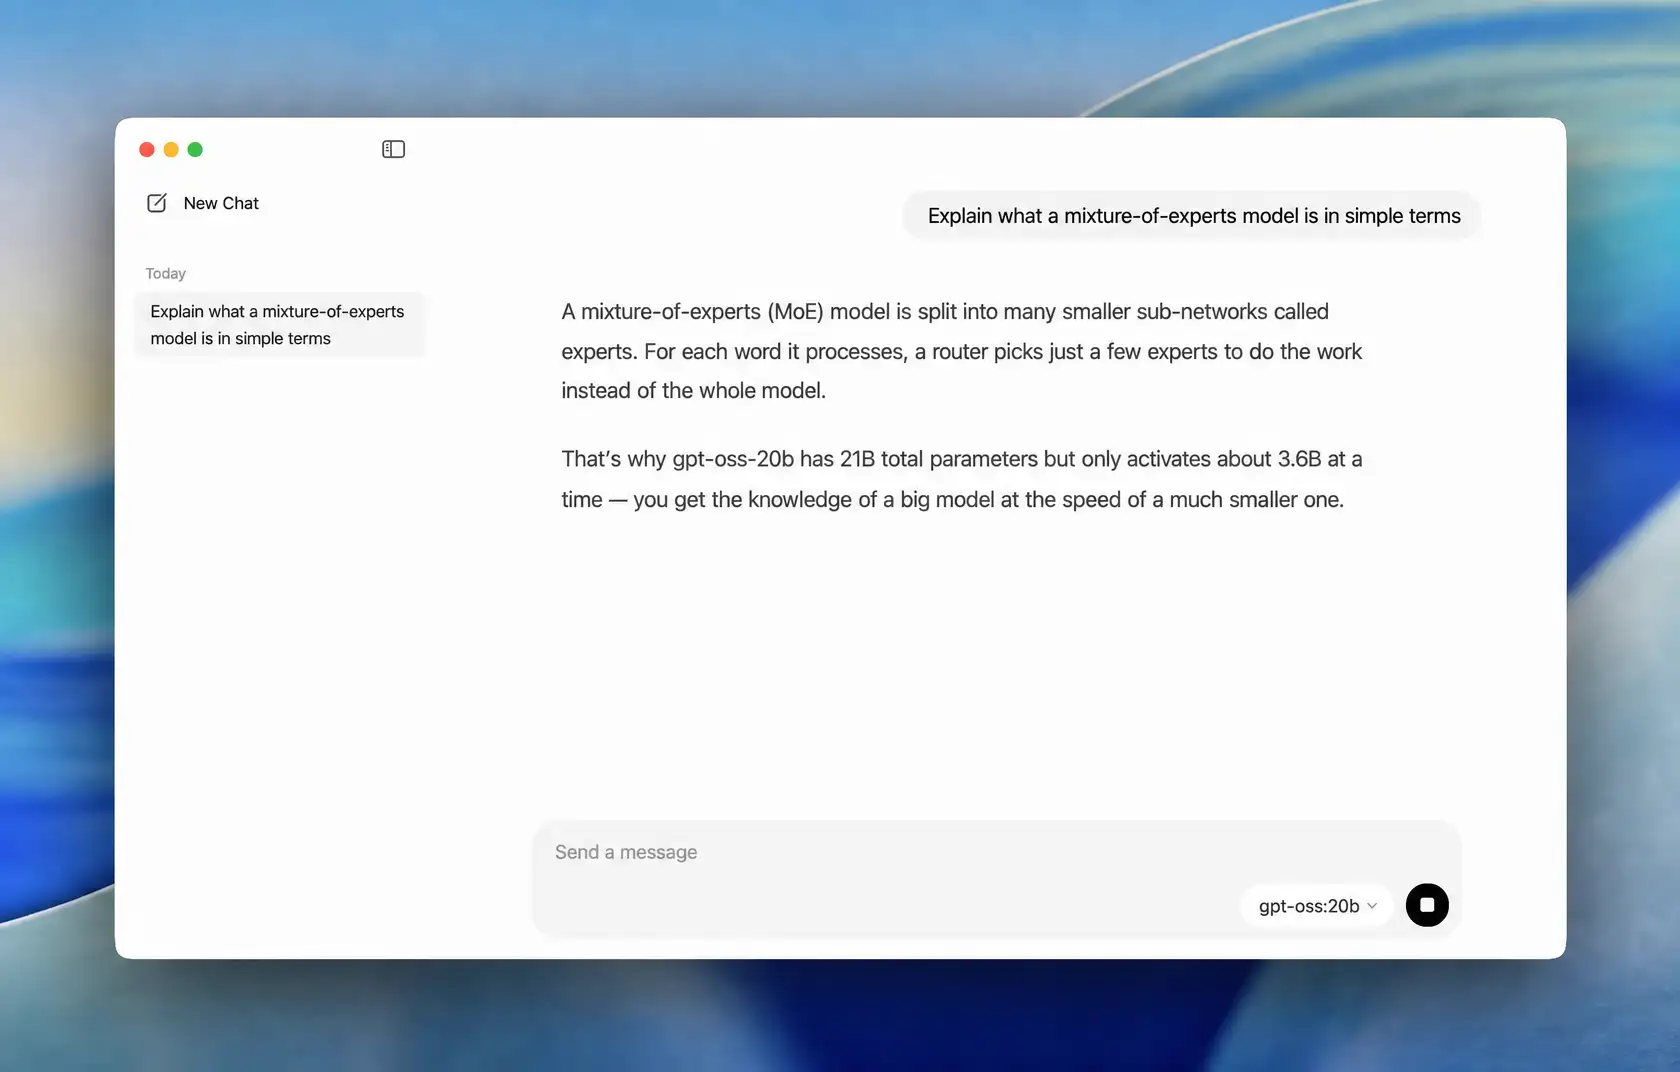
- メッセージを送信します。ダウンロードが完了したら、プロンプトを入力してEnterキーを押します。gpt-ossはそのチャットウィンドウ内で応答し、ここから先はすべてオフラインで動作します。
ターミナルを使う
コマンドラインを使いたい場合は、ollama.comからOllamaをインストールし(macOS/Windowsではインストーラー、Linuxではcurl -fsSL https://ollama.com/install.sh | shを使用)、次を実行します。
ollama run gpt-oss:20b     # 21B model, ≈14 GB
ollama run gpt-oss:120b    # 117B model, ≈65 GB
初回実行時に重みを取得し、以降はキャッシュからすぐに起動します。Ollamaはhttp://localhost:11434/v1でOpenAI互換APIを提供します(APIキーにはollamaを使用してください)。
curl http://localhost:11434/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-oss:20b",
    "messages": [{"role": "user", "content": "Hello"}]
}'Ollamaとほかの選択肢との比較については、OllamaとLM Studioの比較記事をご覧ください。
3. LM Studioでgpt-ossを実行する
LM Studioでは、GUIまたはlms CLIを通じてgpt-ossを実行できます。バージョン0.3.21以降にアップデートしてから、ターミナルでダウンロードしてチャットを始めます。
lms get openai/gpt-oss-20b      # download the 20B model
lms get openai/gpt-oss-120b     # download the 120B model
lms load openai/gpt-oss-20b     # load it into memory
lms chat openai/gpt-oss-20b     # start an interactive chat
アプリでも同じ操作ができます。Modelsタブを開き、gpt-ossを検索してMXFP4のダウンロードを選び、上部のバーでそのモデルを選択します。LM StudioのOpenAI互換サーバーはhttp://localhost:1234/v1で動作します。
4. llama.cppでgpt-ossを実行する
llama.cppは、ほかのツールの基盤となっているC/C++エンジンです。最も細かく制御したい場合は、このエンジンでgpt-ossを直接実行します。brew install llama.cppでインストールするか、ソースからビルドし、その後サーバーを起動します。初回実行時にはHugging FaceからGGUFがダウンロードされます。
# Default
llama-server -hf ggml-org/gpt-oss-20b-GGUF -c 0 --jinja

# NVIDIA GPU, 16 GB VRAM
llama-server -hf ggml-org/gpt-oss-20b-GGUF --ctx-size 32768 --jinja -ub 4096 -b 4096

# 120B model
llama-server -hf ggml-org/gpt-oss-120b-GGUF -c 0 --jinja
これにより、http://localhost:8080でWebUIとOpenAI互換APIが提供されます。主なフラグは、Hugging Faceから取得する-hf、チャットテンプレートを有効にする--jinja、コンテキスト長を設定する--ctx-size/-c、VRAMに余裕がない場合にN個のエキスパート層をCPUへオフロードする--n-cpu-moe Nです。
推論の強度を設定する方法(low / medium / high)
gpt-ossでは推論の強度を調整できます。回答前の推論に使うトークン数を増減させる設定です。3つのレベルがあります。
- Low:最も高速で、簡単なQ&Aや下書きに適しています。
- Medium:ほとんどのチャットに適した、バランスのよいデフォルト設定です。
- High:最も深く推論し、数学、コード、複数のステップを要する問題に適しています。
API呼び出しのreasoning_effortパラメータ、またはシステムメッセージの1行、Reasoning: highで設定します。OpenAI互換エンドポイントを使う場合は、次のように指定します。
curl http://localhost:11434/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-oss:20b",
    "reasoning_effort": "high",
    "messages": [{"role": "user", "content": "Prove that sqrt(2) is irrational."}]
  }'
チャットアプリでは、システムプロンプトの1行として設定します。まずmediumから始め、タスクで必要な場合にのみhighへ上げてください。推論の強度をhighにすると動作が遅くなり、コンテキストウィンドウをより多く消費します。
gpt-ossのローカル実行でよくある問題
gpt-ossをローカルで実行する際にユーザーがよく遭遇する問題と、その対処方法をまとめました。
メモリ不足エラー。これは最もよくある問題で、通常はシステムのVRAMまたはRAMが足りない状態で120bモデルを実行しようとしたときに発生します。最も現実的な対処方法は、20bモデルに切り替える、コンテキスト長を短くする、またはモデルを読み込む前にメモリ消費の多いアプリを閉じることです。
120bモデルを読み込めない。メモリが約80 GB未満の場合、実用的な速度で動作するようにモデルをメモリに収めることはできません。これは設定の調整で回避できる問題ではなく、ハードウェアの制約です。20bモデルを選ぶのが適切です。
チャットを続けるほど応答が遅くなる。会話が128Kのコンテキストウィンドウを埋めていくにつれ、キーバリューキャッシュが増大し、新しいトークンごとに必要なメモリと時間が少しずつ増えます。長いセッションで動作が極端に遅くなってきたら、新しいチャットを始めるか、コンテキストを減らしてください。
ディスクの空き容量が不足している。gpt-oss-20bの重みファイルをダウンロードするだけで約14 GB、120bモデルでは約65 GBが必要です。比較のために複数のモデルを取得すると、使用容量はすぐに増えます。使っていないモデルは忘れずに削除してください。
よくある質問
gpt-ossとは何ですか?
gpt-ossは、OpenAIがGPT-2以来初めて公開したオープンウェイト(オープンソース)モデルファミリーで、2025年8月にApache 2.0ライセンスでリリースされました。パラメータ数21Bと117Bの2つのサイズがあり、ダウンロードして自分のハードウェアで、オフラインかつ無料で実行できます。
gpt-oss-120bはローカルで実行できますか?
はい。複数GPU構成、80 GBのデータセンター向けカード、ハイエンドのApple Siliconマシンなど、約80 GBのメモリがあれば実行できます。一般的な消費者向けハードウェアでは、代わりにgpt-oss-20bを実行してください。
gpt-ossの実行にはどのくらいのRAMが必要ですか?
gpt-oss-20bでは、少なくとも16 GBの空きメモリを確保してください。24〜32 GBあれば、長いセッションもよりスムーズに動作します。120bモデルには約80 GBが必要です。
gpt-ossは無料ですか?
はい。gpt-ossはApache 2.0で公開されているため、ダウンロード、ローカル実行、商用利用は無料です。費用がかかるのは、すでに所有しているハードウェアだけです。
gpt-ossはコーディングに適していますか?
20bと120bはどちらも、そのサイズに対してコードを扱う能力が高く、複数のステップを要する問題で優れた推論能力を発揮します。コーディングが主な用途なら、コーディングにおすすめのローカルLLMの記事をご覧ください。
gpt-ossはほかのローカルモデルと比べてどうですか?
自宅で実行できるオープンウェイトモデルの中でも、特に推論において最も高性能な選択肢の1つです。ほかにどのような選択肢があるかを幅広く知りたい場合は、おすすめのローカルLLMアプリ一覧をご覧ください。
gpt-ossをローカルで実行する最も簡単な方法
ターミナルを使わずに今日からgpt-ossを動かしたいなら、ワンクリックで使えるアプリが最短の方法です。インストールしてgpt-oss-20bを選べば、数分でオフラインのチャットを始められます。コマンドラインに慣れているなら、Ollamaでは1つのコマンドで実行でき、llama.cppではその基盤まで全面的に制御できます。
どちらの方法でも、要点は同じです。gpt-ossは日常的に使うハードウェアで実際に実行でき、20bモデルならo3-miniクラスの推論を、すべて自分のマシン上で実行できます。




