

AIエージェントにできることは、質問に答えるだけではありません。ファイルの読み取りや編集、コマンドの実行、リポジトリの検索、テストの実行に加え、最小限の監督で複数のステップからなるタスクを進められます。ただし、クラウドAPI経由でこうしたエージェントを実行すると費用がかさむ可能性があり、ソースコードなどの機密データを外部のモデルプロバイダーに送信する方法は、すべてのワークフローに適しているとは限りません。
AIエージェントをローカルで実行することは、この2つの問題に対処する方法の1つです。クラウドモデルにリクエストを送る代わりに、自分のハードウェアでモデルを実行します。これにより、すでに所有しているハードウェアでAIエージェントを無料で実行でき、プロンプト、コード、モデルの応答を自分のマシン内に保てます。
このガイドでは、以下の内容を含め、ローカルAIコーディングエージェントを実行する方法を紹介します。
- ローカルAIエージェントの実行に必要なハードウェア
- エージェント型コーディングに最適なローカルモデル
- ローカルモデルの実行に使えるソフトウェア
- ローカルモデルをAIエージェントに接続する方法
- よくある問題とその対処方法
- クラウドモデルよりローカルAIの利用が適している場面
要点
AIエージェントをローカルで実行するのは、思うほど複雑ではありません。通常、必要なのはエージェント、ローカルモデルサーバー、ツール呼び出しに対応できるモデルの3つです。
- AIエージェント。AIエージェントは、モデルにツールを提供し、AIモデルとそのツールのやり取りを管理する層を加えるソフトウェアの一種です。これにより、モデル単体が自律的なアシスタントに変わります。よく使われるAIエージェントには、OpenClaw、Hermes、Cline、Roo Code、Kilo Code、Continue、Aider、OpenHandsがあります。
- ローカルモデルサーバー。モデルを読み込み、エージェントが通信に使えるAPIを提供します。Atomic Chat、Ollama、LM StudioなどのローカルAIアプリは、モデルをダウンロードして実行し、ローカルホスト上にOpenAI互換APIを提供することで、そのローカルモデルをエージェントから利用できるようにします。
- ローカルAIモデル。エージェント自体はモデルではなく、モデルと、MCPサーバー、Zapierコネクター、その他のAPIなどの利用ツールとのやり取りを仲介する層です。そのため、エージェントはモデルなしでは機能しません。エージェントを使う作業でよく使われるモデルには、Qwen3-Coder 30BやDevstral 24Bがあります。(初めての方は、LLMをローカルで実行する方法のガイドからご覧ください。)
エージェントをローカルで実行する理由
AIチャットを使う場合、AIは受動的に動作します。質問やタスクを待ち、応答した後、次の入力を待ちます。AIエージェントは能動的に動作します。目標を与えられると、アクセスできるあらゆるツールを使い、何らかの完了基準を満たすまでループで実行を続けます。
コーディングの例で考えてみましょう。タスクは、リポジトリ内のバグを修正することです。
- チャットボットはコードを読み、バグの場所を推論し、新しいコードを書いて、チャットウィンドウ内でユーザーに渡します。
- エージェントは、まずリポジトリ全体を分析し、コードを編集し、テストを実行して出力ログを確認し、エラーを読み取って自ら修正し、既存のgitflowに従ってGitHubにプッシュして、自分の作業を報告します。この過程で、ファイル編集、ターミナルアクセス、Playwrightによるブラウザー自動化などのツールを使います。
AIエージェントをローカルで実行するとは、このエージェント型ワークフローのすべてをローカルAIモデルで動かすことを意味します(エージェントは、クラウドとローカルのどちらのAIモデルとも同じように通信できます)。では、なぜエージェントを動かすためにローカルAIモデルを使うのでしょうか。主な理由は4つあります。
- コスト削減。クラウドエージェントは、通常、トークン数やクレジットに基づいてモデルの使用料を請求します。エージェント型コーディングでは、モデルが指示、コード、ツールの結果、過去のコンテキストを繰り返し受け取るため、大量のトークンを消費することがあります。ローカル推論では、こうしたトークン単位のAPI料金がかからないため、ハードウェアを用意すれば、セルフホストのAIエージェントを無料で実行できます。
- プライバシー。コーディングエージェントは、タスクを完了するためにソースコード、設定ファイル、ドキュメント、コマンド出力を読み取る必要がある場合があるため、この点は特に役立ちます。クラウドモデルでは、その情報をプロバイダーに送信する必要があります。ローカルモデルでは推論がデバイス内で行われるため、ローカルエージェントは非公開の専有コードや、データの取り扱いに厳しい要件がある作業に、より適しています。
- オフラインでの利用。モデルと必要なソフトウェアをインストールすれば、ローカル環境はインターネット接続なしでも動作を続けられます。ただし、当然ながら、オフライン中はエージェントからリモートAPIにアクセスできません。
- より大きな制御の自由。ローカルモデルなら、プロバイダーのAPIの可用性、使用制限、料金、モデルのエイリアスに縛られません。
エージェント型AIに最適なローカルAIモデル
エージェント型のユースケースでは、次の3つの領域で高い性能を持つモデルを選びましょう。
- ツール呼び出し。エージェントは、ファイルの読み取り、コードの編集、リポジトリの検索、ターミナルコマンドの実行などのツール一式をモデルに提供し、適切なツールを選び、エージェントが想定する形式で引数を返すことをモデルに求めます。モデルが無効な呼び出しを生成したり、誤ったツールを選んだり、必要なときにツールを呼び出さなかったりすると、エージェントは行き詰まることがあります。そのため、ツール使用の正確さは、エージェント型AIにとって最も重要な特性の1つです。
- コンテキスト長。モデルは、ユーザーの指示、リポジトリ構造、ソースファイル、それまでの編集内容、テスト結果、コンパイラーエラー、過去のツール呼び出しを把握し続ける必要がある場合があります。これにより、利用できるコンテキストが急速に消費されます。32Kが最低限ですが、理想的には128Kを超える長さが望まれます。
- 長期にわたる作業の信頼性。長期にわたる作業では、AIが長い時間をかけて一連の判断を下す必要があります。一部のモデルは、関連するタスクが長く連続する間も品質を維持し、ハルシネーションを最小限に抑えることに重点を置いて、コーディングエージェント向けに特別に学習されています。たとえばDevstralは、コーディングエージェントの実行基盤で動作することを明確な目的として開発されました。
これらを踏まえ、自分のハードウェアでローカルAIコーディングエージェントを実行したい場合に、検討する価値のあるモデルを紹介します。
| モデル | 規模 | 推奨理由 |
|---|---|---|
| Qwen3-Coder 30B-A3B | 30B MoE、アクティブパラメーターは約3B | ローカルエージェント用モデルとして、当社が標準的に推奨するモデルです。ツール呼び出しに優れ、24GBのグラフィックスカードで動作します。 |
| Devstral Small | 24B | コーディングエージェントを動かすために、Mistral AIがAll Hands AIと共同で開発しました。RTX 4090 1枚、または32GBのMacに収まります。 |
| gpt-oss-20b | 20B | OpenAIの重み公開モデルです。ツール呼び出しに対応し、一般消費者向けGPUでも扱いやすいモデルです。 |
これから始める方で、実行に必要なハードウェアがあるなら、まずQwen3-Coder 30B-A3Bモデルを試すことをおすすめします。総パラメーター数は30.5Bですが、トークンごとにアクティブになるのは約3.3Bのみで、ネイティブで256Kのコンテキストに対応し、エージェント型コーディングとツール使用に特化して学習されています。たとえばKilo Codeは現在、このモデルをローカルモデルの第一候補として推奨しています。
少し動かしやすいモデルがgpt-oss-20bです。汎用推論モデルですが、パラメーター数は21B(アクティブパラメーターは3.6B)、コンテキストウィンドウは128Kで、性能がかなり低いハードウェアでも実行できます。このモデルもOpenAIが開発と学習を行っており、オフライン版ChatGPTに最も近い体験を提供します。(gpt-ossをローカルで実行する手順を解説したガイドもご覧ください。)
規模とハードウェア別のコーディングモデルの詳しい比較については、コーディングに最適なローカルLLMのガイドをご覧ください。
ローカルAIエージェントを実行するためのハードウェア要件
目安として、パラメーター数が多いほど、モデルの実行に必要なストレージとメモリも増えます。
| モデル規模 | メモリ | 期待できる性能 |
|---|---|---|
| 7~8B | 8GBのGPU、または16GBのMac | 自動補完と簡単な編集。 |
| 14B | 12~16GBのGPU | 範囲を限定したエージェントタスクには使えますが、依然としてエラーが起きやすいです。 |
| 24~32B | 24GBのGPU、または32GB以上のMac | ローカルAIエージェントの実行に最もバランスのよい規模です。 |
| 32B以上 | ワークステーション、複数GPU構成、または128GB以上のMac | クラウドの最上位モデルに近い推論品質と信頼性。 |
エージェント型AIのタスクは通常、より高い処理能力を必要とするため、上の表には最低要件のみを記載しています。実際には、KVキャッシュの要件が高くなる分に対応するため、追加の容量が必要です。現実的には、本番レベルのタスクを処理できるエージェントを実行するには、少なくとも24 GBのVRAMを搭載したGPU、または32 GBのユニファイドメモリを搭載したMacが必要です。
Atomic ChatでAIエージェントをローカル実行する方法
Atomic Chatは、Hugging Faceの重み公開AIモデルを簡単にダウンロード、設定、実行できるよう、当社が開発したローカルAIアプリケーションです。前述のとおり、エージェントを実行するには、エージェントのランタイムを提供し、モデルの推論を処理するソフトウェアが必要です。
Atomic Chatを使う必要はなく、OllamaやLM Studioなどのツールも使えます。ワークフローはおおむね同じで、モデルを選び、ランタイムを設定し、エージェントの推論バックエンドとして使用します。この手順ではAtomic Chatを使います。
1. Atomic Chatをインストールします。atomic.chatからダウンロードして起動します。Atomic ChatはWindows、macOS、Linuxで動作します。
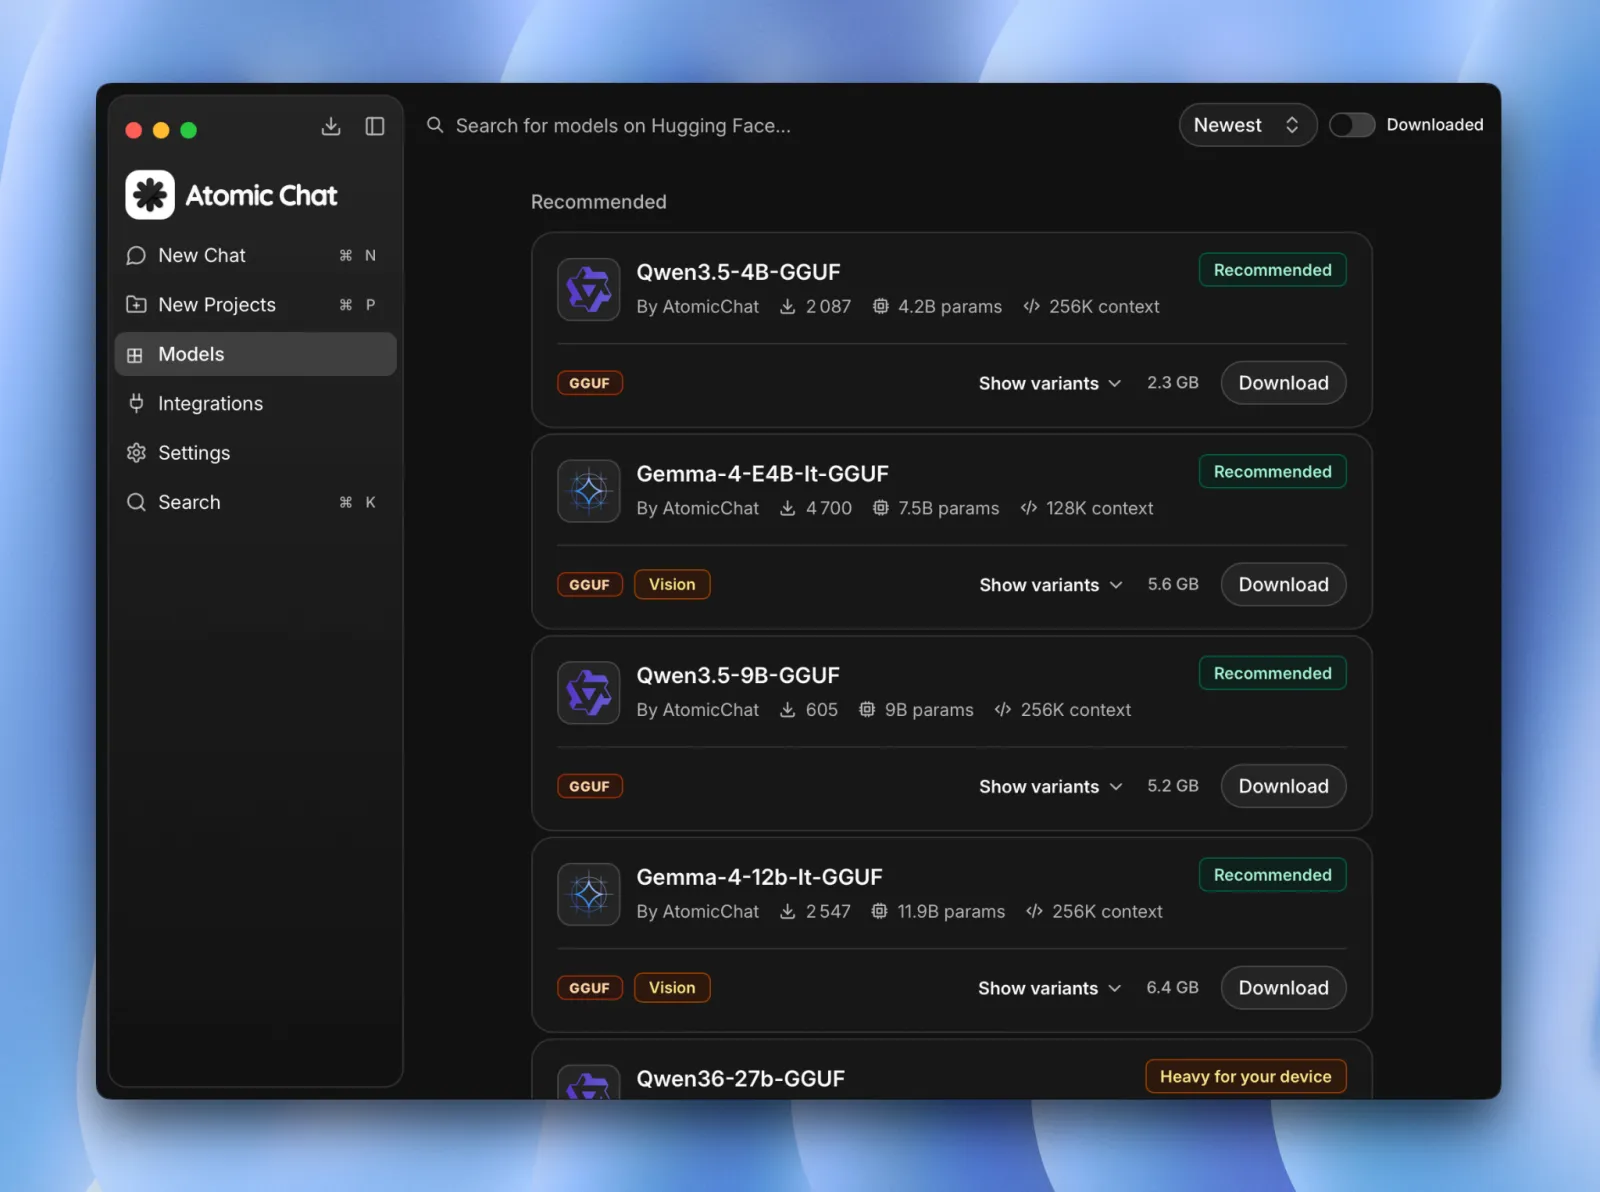
2. モデルをダウンロードします。Modelsタブを開き、モデルを検索します。まずはQwen3-Coder 30BかDevstral Small 24Bをおすすめします。Atomic Chatは、使用しているハードウェアに最適な量子化を自動的に表示します。
3. ローカルAPIサーバーを有効にします。Atomic Chatは、http://localhost:1337/v1でOpenAI互換APIを提供します。デフォルトでは、サーバーはループバックインターフェースにバインドされているため、自分のマシンからのみアクセスでき、外部デバイスからはアクセスできません。エージェントはこのエンドポイントを使ってモデルと通信します。
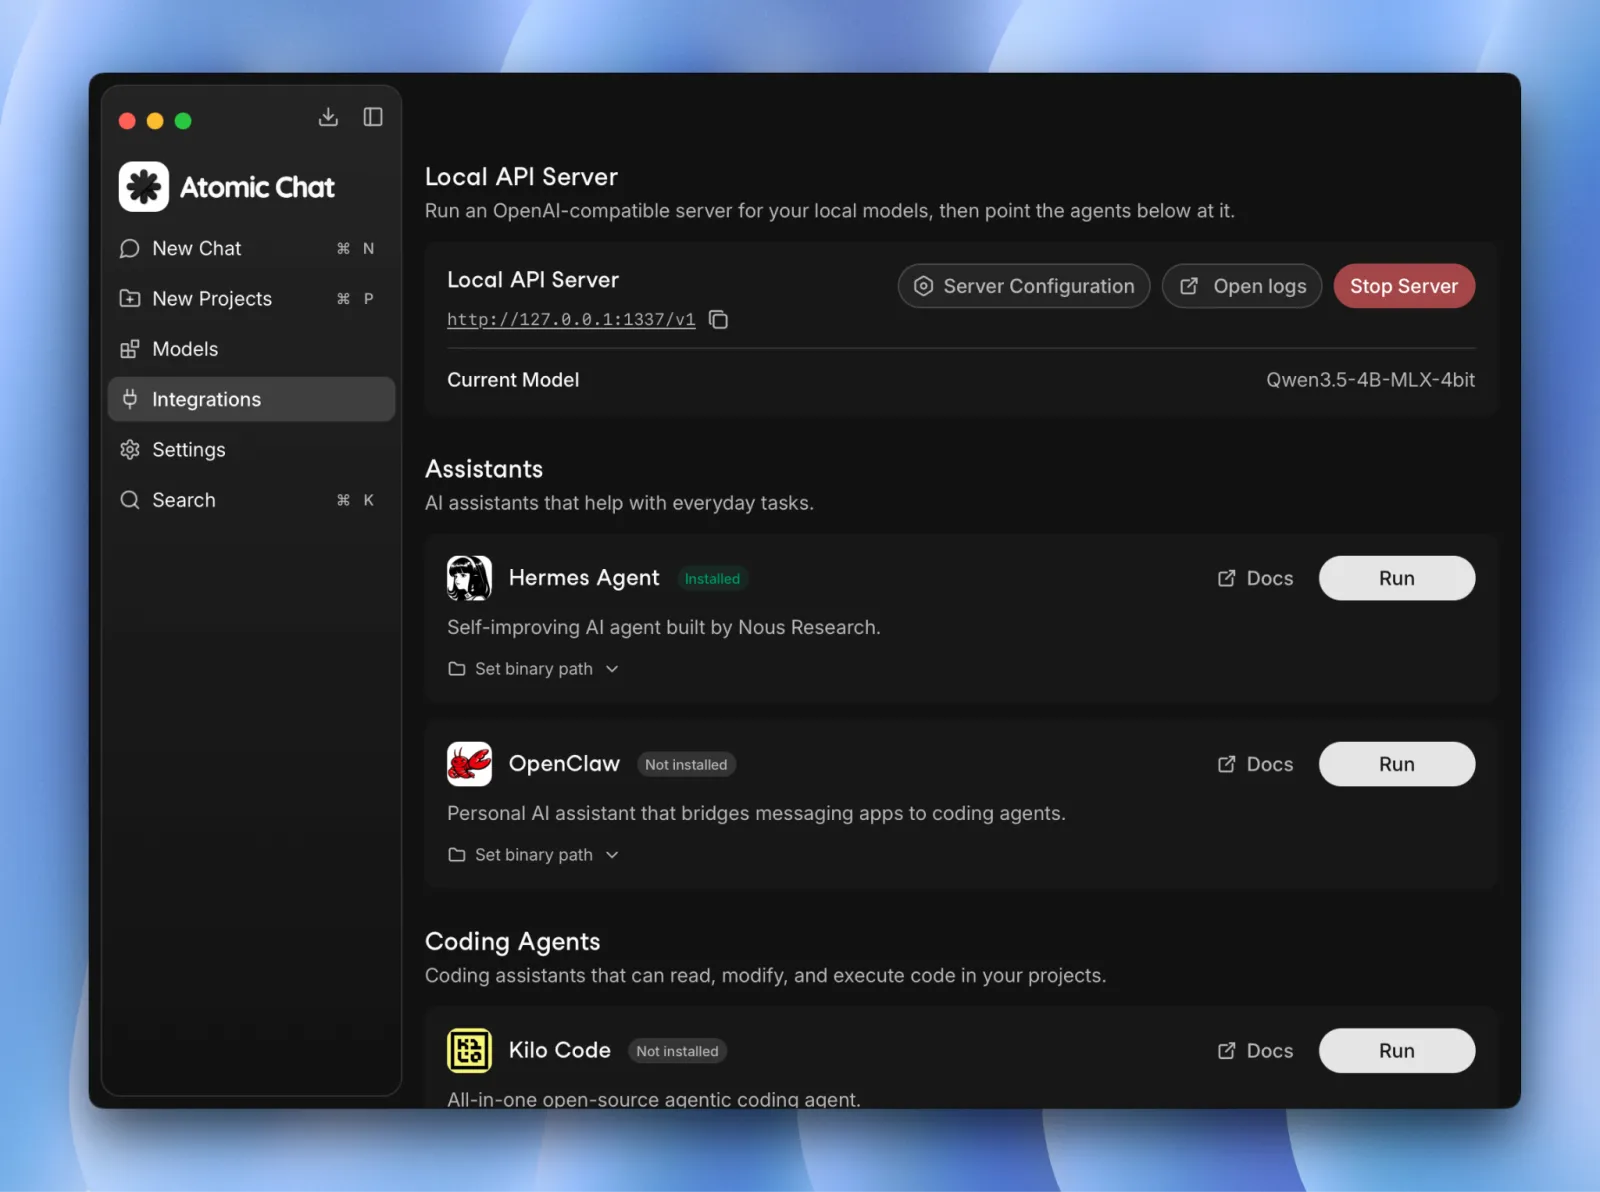
4. エージェントを起動します。Atomic ChatのIntegrationsタブには、Claude Code、Codex CLI、Cline、OpenCode、Droid、Goose、OpenHands、Copilot CLI、Kilo Code、Zedをワンクリックで起動できるランチャーがあります。使いたいエージェントを選ぶと、Atomic Chatがlocalhost:1337への接続を設定済みの状態で起動します。
5. タスクを与えます。これで準備は完了です。ローカルAIエージェントを使って、実際のタスクに取り組めます。
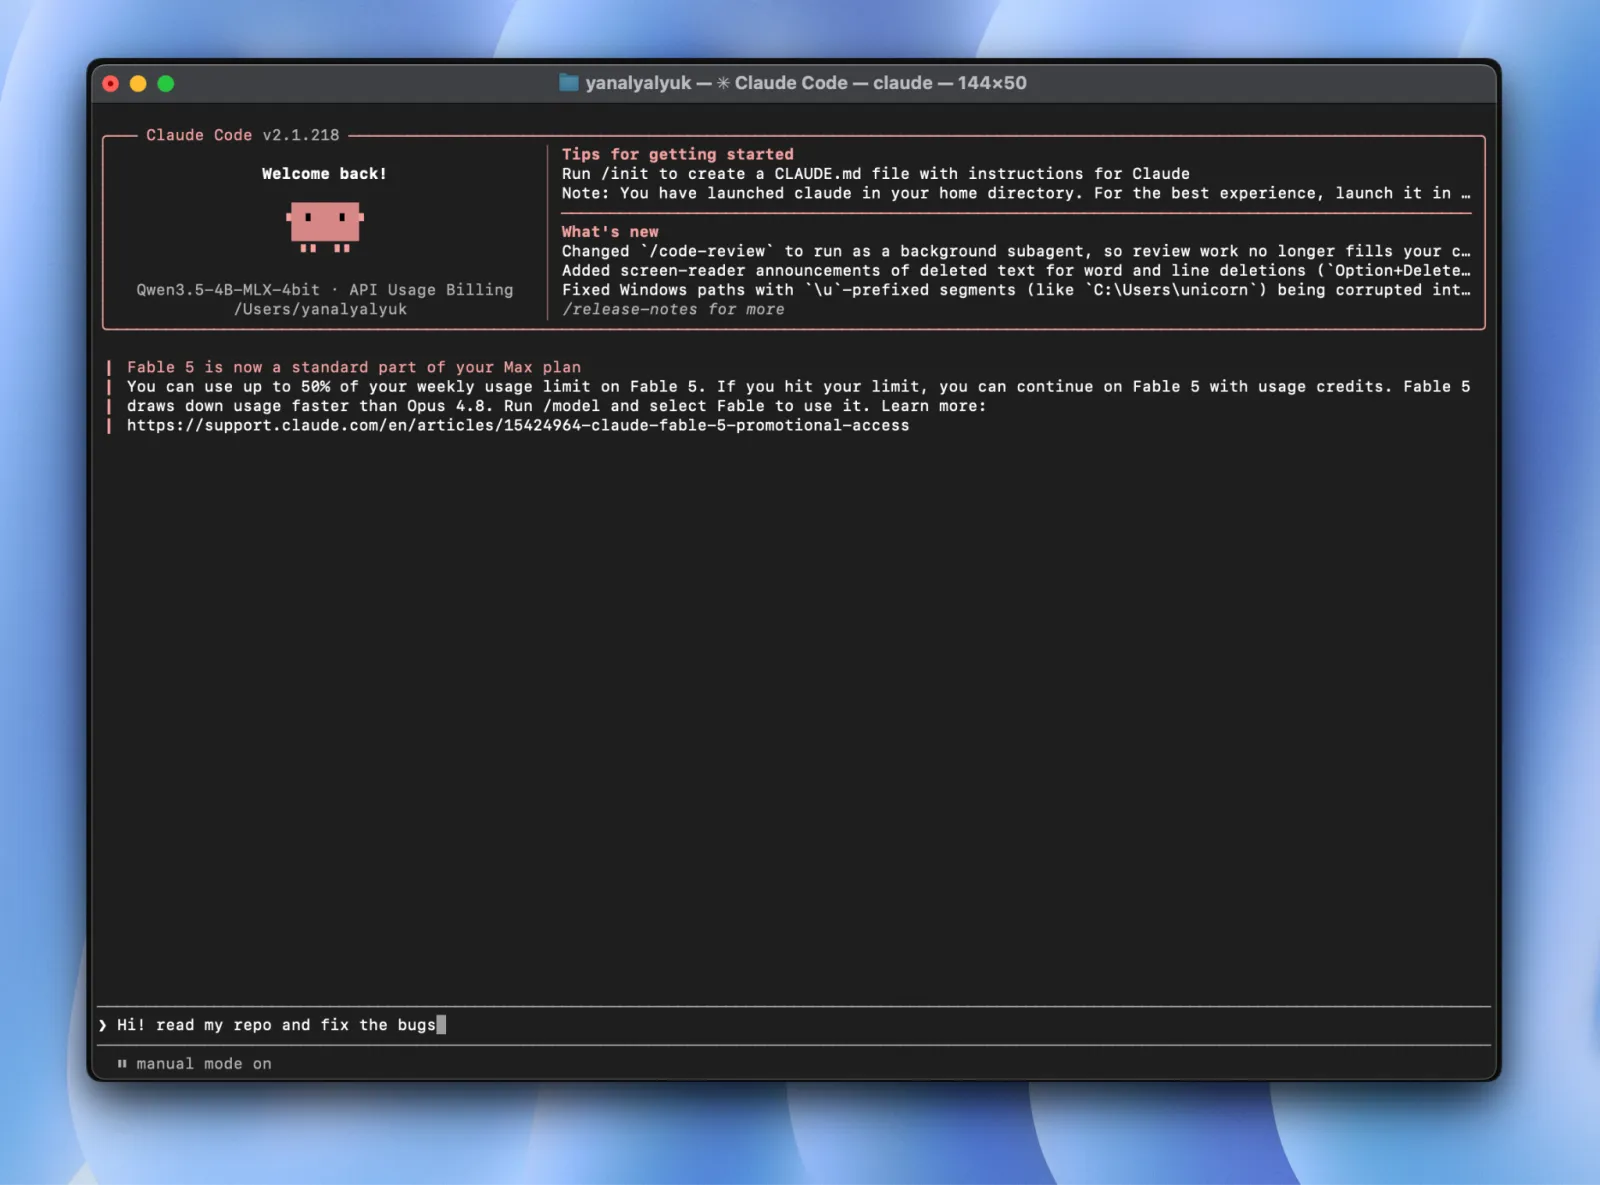
エージェントを手動で設定したい場合は、手順4~5を省略し、エージェントのベースURLにhttp://localhost:1337/v1を入力します。APIキーは空欄にして、モデルを選択します。
ローカルAIエージェントとMCPサーバー
ローカルエージェントが動くようになったら、追加のツールやサービスに接続して、できることを増やせます。ここで役立つのがModel Context Protocol (MCP)です。
ほとんどのコーディングエージェントは、ファイルの読み取りや編集、ターミナルコマンドの実行といった基本ツールをすでに利用できます。MCPを使うと、専用のMCPサーバーを介してエージェントを外部ツールに接続し、さらに機能を広げられます。たとえば、MCPサーバーを通じて、エージェントがデータベース、ウェブ検索、ファイルシステム、内部API、その他のサービスにアクセスできるようになります。
たとえば、非公開リポジトリを対象にローカルコーディングエージェントを動かし、データベース用のMCPサーバーに接続できます。するとモデルは、同じタスクの中でコードを調べ、変更を加え、テストを実行し、データベースにクエリを送れるようになります。これらの機能をモデル自体に組み込む必要はありません。
1つのエージェントについて、最初から最後まで詳しい手順を知りたい場合は、OpenClawエージェントをローカルで実行する方法のガイドをご覧ください。
このガイドで取り上げたエージェントの大半はMCPに対応しており、以下も含まれます。
- Hermes
- OpenClaw
- Cline
- Roo Code
- Kilo Code
- Continue
- Goose
- OpenHands
基本的なローカル環境ではMCPは必須ではありませんが、単純なコーディングタスクを超えて、開発環境のほかの部分ともエージェントを連携させたくなるほど、役立つ場面が増えます。
ローカルAIエージェントでよくある問題と対処方法
ローカルエージェントの失敗には、予測できるいくつかのパターンがあります。よくある問題と、その対処方法を紹介します。
エージェントがタスクの途中で停止する、またはループする
考えられる原因:ツール呼び出しが失敗しています。小規模なモデル、強く量子化されたモデル、ツール呼び出しへの対応が十分でないモデルは、形式が不正な呼び出しを生成したり、同じツールを繰り返し呼び出したりすることがあります。
試すこと:実際には、通常、モデルの能力が制約要因になります。ツール呼び出しとエージェント型ワークフローに明確に対応したモデルを使っているか確認してください。より大きなモデルを試すか、量子化の度合いを抑えたものを使ってみてください。
エージェントが自分の作業を「忘れる」
考えられる原因:コンテキスト長が不足しています。エージェントはタスクの実行中に大量のコンテキストを蓄積します。それが設定されたコンテキストウィンドウを超えると、推論サーバーが古いコンテキストを切り捨て、エージェントがタスクの状況を見失うことがあります。
試すこと:推論サーバーのコンテキスト長を増やしてください。エージェントを使う作業では、32Kトークンが開始時の目安になりますが、適切な値はモデル、タスク、利用可能なメモリによって異なります。コンテキストウィンドウを大きくするとメモリ使用量も増えるため、この設定は試しながら調整する必要があることを覚えておいてください。
リクエストがタイムアウトする
考えられる原因:大規模なローカルモデルは、特にGPUメモリの少ないハードウェアや、モデルの一部または全部をCPUで実行している場合、クラウドAPIより生成が大幅に遅くなることがあり、エージェントのタイムアウトにつながります。
試すこと:モデルが生成中なのか、それとも生成開始前にリクエストが失敗しているのかを確認してください。単に生成が遅い場合は、エージェントのリクエストのタイムアウト時間を延ばすか、より小さなモデルや量子化の度合いを高めたものを試して、生成速度を改善してください。
接続が拒否される
考えられる原因:エージェントに誤ったホストまたはポートが設定されている可能性があります。
試すこと:ローカルAPIサーバーが稼働していることを確認してください。次に、エージェントのベースURLを確認します。Atomic Chatのエンドポイントはhttp://localhost:1337/v1です。エージェントの設定で、ホスト、ポート、/v1パスが一致していることを確認してください。
よくある質問
AIエージェントをローカルで無料で実行できますか?
はい。エージェントのソフトウェアとモデルの両方を自分のコンピューターで実行する場合、ローカルエージェントはAPI料金やサブスクリプション料金なしで動かせます。リクエストごとに推論の料金をプロバイダーに支払う代わりに、自分のマシンが計算を行います。
ノートパソコンでAIエージェントを実行できますか?
はい。ただし、モデルの規模と速度は、ノートパソコンのメモリとプロセッサーに左右されます。小規模なモデルはCPUで実行できますが、20B~30Bのモデルは、大容量のGPU VRAMまたはApple Siliconのユニファイドメモリがあると、はるかに実用的になります。
エージェントに最適なローカルAIモデルは何ですか?
Qwen3-Coder 30BとDevstral 24Bは、エージェントに最適なローカルAIモデルの候補です。
ローカルAIエージェントはクラウドAIエージェントと同じくらい優れていますか?
大規模なクラウドモデルは、はるかに大きなモデルと大幅に多くの計算資源を使えるため、難しい推論、複雑なリファクタリング、長時間にわたるソフトウェアエンジニアリングのタスクでは、依然として優位性があります。それでも、ローカルモデルは日常的なコーディングや自動化をこなせますし、コストの低さや自分のハードウェア上で推論を行えることが、能力の差を上回る利点になる場合があります。
ローカルAIエージェントではプライバシーが守られますか?
はい。モデルに関わるワークフロー全体がローカルにとどまることが条件です。自分のコンピューターで稼働する推論サーバーにエージェントがリクエストを送る場合、プロンプト、ソースコード、モデルの応答をモデルプロバイダーに送信する必要はありません。たとえばAtomic Chatでは、ダウンロード済みのモデルとローカル推論を完全にオフラインで動作させながら、ローカルAPIでそのマシン自身からのリクエストを処理できます。
インターネット接続なしでローカルAIエージェントを使えますか?
はい。モデルのダウンロードと必要なソフトウェアのインストールが済めば、タスクが外部サービスに依存しない限り、ローカルエージェントはオフラインで動作できます。インターネット接続が必要なのは、モデルのダウンロード、更新の確認、オンラインサービスの利用時のみです。
ローカルAIエージェントはVS Codeで使えますか?
はい。Kilo CodeやClineなどのコーディングエージェントは、Atomic Chat、Ollama、LM Studioを通じてローカルでホストされたモデルを使いながら、VS Codeのワークフロー内で動作できます。
ローカルAIエージェントはファイルの編集やターミナルコマンドの実行ができますか?
はい。モデルがツール呼び出しを要求し、エージェントがそれを実行します。一般的なコーディングエージェントは、ファイルの読み取り、編集の適用、リポジトリの検索、シェルコマンドの実行用ツールをモデルに提供し、その結果をモデルに返して、次の行動を判断させることができます。
ローカルAIエージェントにGPUは必要ですか?
GPUは必須ではありません。エージェントはCPUでも実行できますが、非常に遅くなります。小規模なモデルではCPU推論も使えますが、信頼性の高いエージェント型AIモデルには、通常、高性能なGPUが必要です。Apple Silicon搭載Macも選択肢になります。CPUとGPUが大容量のユニファイドメモリプールを共有しているためです。一般的に、エージェント型AIモデルの実行には、24 GB以上のGPU VRAM、または32 GB以上のユニファイドメモリが推奨されます。
ローカルAIエージェントには、どれくらいのRAMやVRAMが必要ですか?
20B~30Bのコーディングモデルでは、32 GBのシステムメモリまたはユニファイドメモリが開始時の目安になり、専用GPUを搭載したシステムでは、24 GBのGPU VRAMが実用的な目標になります。
ローカルAIエージェントはクラウドAIエージェントより安く使えますか?
大量に使う場合は、安くなることがよくあります。クラウドエージェントは、トークン、クレジット、サブスクリプション、またはこれらの組み合わせで推論料金を請求しますが、ローカルモデルはハードウェアとソフトウェアを用意すれば、リクエストごとの推論料金はかかりません。適切なハードウェアをすでに所有しているなら、ローカルAIエージェントの実行にかかる費用は電気代だけです。
ローカルAIエージェントにはどのような制約がありますか?
クラウドAIエージェントと比較した場合、ローカルAIエージェントの主な制約は、小規模なモデルの能力が低いこと、推論速度が遅いこと、高いハードウェア要件があることです。ローカルハードウェアによって実行できるモデルの規模が制限され、小規模なローカルモデルは一般的に、複雑で複数のステップからなるタスクでは、最大規模のクラウドモデルより信頼性が低くなります。
ローカルとクラウドのどちらのAIエージェントを使うべきですか?
ローカルAIとクラウドAIは併用できます。ローカルモデルは、日常的なコーディング、非公開リポジトリ、オフライン作業、トークン単位のクラウド料金がすぐにかさむ大量のタスクに適しています。一方、より大きなモデルのほうが信頼できる最も難しいタスクには、クラウドモデルを使えます。
まとめ
ローカルAIエージェントは、あらゆる状況でクラウドモデルを置き換えられるわけではありませんが、非公開リポジトリでの作業、オフライン作業、日常的なコーディングや大量のタスクにかかるAPIコストの削減が必要な場合に、特に役立ちます。要点は以下のとおりです。
- ローカルAIエージェントは、オフラインのAIモデルを使って動作します。
- ローカルAIエージェントを実行するには、エージェントまたはハーネス(KiloやClineなど)、ローカルモデルサーバー(Atomic ChatやOllamaなど)、ローカルモデルの3つの構成要素が必要です。
- エージェントを使う作業に最適化された高性能なモデルをローカルで実行するには、理想的には、少なくとも24 GBのGPU VRAM、または32 GBのユニファイドメモリが望まれます。
- ローカル推論では、モデルへのリクエストをクラウドプロバイダーに送る必要がないため、コストを削減し、プライバシーを高められます。
- モデルとソフトウェアをインストールすれば、タスクが外部サービスを必要としない限り、ローカルエージェントはオフラインで動作できます。
- ローカルモデルにも制約はあります。難しい推論では、最大規模のクラウドモデルのほうが高い能力を発揮します。(主要なクラウドモデルとオープンソースのコーディングモデルの比較については、コーディングに最適なLLMの比較解説をご覧ください。)
- ほとんどのワークフローでは、日常的なタスクにローカルAIエージェントを使い、プライバシー、オフライン機能、コストの低さを活用するのがよい方法です。より高い推論能力が必要なタスクに直面したら、プライバシー要件が許すことを前提に、クラウドモデルへ切り替えられます。




