

このガイドでは、次の内容を解説します。
- Qwen 3.8 27Bとは何か、Qwen 3.8 Maxとどう違うか
- 実行に必要なハードウェア
- Atomic Chatまたはllama.cppでQwen 3.8 27Bをローカル実行する方法
0.8Bから始まるQwen全体のラインアップについては、Qwenモデルをローカル実行するガイドをご覧ください。この記事ではQwen 3.8 27Bのみを扱います。
Qwen 3.8 27Bとは?
Qwen 3.8 27Bは、AlibabaのQwenチームが開発したオープンウェイトのデンス型言語モデルで、Qwen 3.8 Maxより小型のモデルです。Alibabaは2026年8月3日にMaxを発表し、両モデルの重みを公開すると告知しました。2.4TパラメータのMaxの重みは8月12日、27Bの重みは8月14日に公開されました。
その後、回答の拒否動作を取り除いた重みの改変版が複数公開されています。これらのビルドについては、Qwen 3.8 27Bの無検閲版をローカル実行するガイドをご覧ください。
Qwen 3.8 27Bの主な仕様:
| 仕様 | Qwen 3.8 27B |
|---|---|
| 総パラメータ数 | 27B |
| アーキテクチャ | デンス型、ハイブリッドアテンション(Gated DeltaNet + Gated Attention) |
| 層数 | 64 |
| コンテキストウィンドウ | ネイティブ262,144トークン、1Mまで拡張可能 |
| モダリティ | テキスト、画像、動画の入力 |
| 推論 | デフォルトでxhighの思考が有効。mediumとlowも選択でき、無効化も可能 |
| 複数トークン予測(Multi-Token Prediction) | 対応。予測ヘッドをチェックポイントに同梱 |
| リリース日 | 2026年8月14日 |
| ライセンス | Apache 2.0 |
27Bはマルチモーダルモデルであり、テキストとともに画像や動画を処理できます。また、Qwen3.6 27Bのハイブリッドアテンション設計を継承しています。64層のうち48層では、会話がどれだけ長くなってもメモリ使用量が一定のGated DeltaNetを使います。通常はトークンごとに増えるKVキャッシュを保持するのは、残りの16層だけです。そのため、一般的な27Bモデルよりも、長いチャットや大きな文書に必要なメモリを大幅に抑えられます。3.8のconfig.jsonからも、この構成が変わらず引き継がれていることを確認できます。具体的な数値はハードウェアの節で紹介します。
複数トークン予測の学習も行われており、1回の順伝播で複数のトークン候補を生成できます。これは投機的デコーディングと同じ仕組みです。予測ヘッドはチェックポイントに含まれ、llama.cppでは--spec-type draft-mtpで実行します。
Qwen 3.8のリリースには、混同しやすい三つの異なるモデルがあります。
- Qwen 3.8 Maxは、総パラメータ2.4T、アクティブパラメータ95BのMoEフラッグシップモデルです。Alibaba Cloud APIで提供され、現在、Artificial AnalysisのIntelligence Indexでオープンウェイトモデルの首位にあります。
- Qwen3.8-2.4T-A95Bは、8月12日に公開されたMaxのダウンロード可能な版です。テキスト専用で、すべてのリクエストで推論します。パラメータ数は2.4兆で、提供には複数GPUを備えたデータセンターのクラスターが必要です。Kimi K3と同じクラスのハードウェアです。
- Qwen 3.8 27Bは、このガイドで扱うデンス型の視覚言語モデルです。三つの中で唯一、24 GBのGPUを搭載したデスクトップや、32 GBのユニファイドメモリを搭載したMacBookといった一般的なマシンで動きます。
Qwen 3.8 27Bのベンチマーク
Alibabaがモデルカードで公開したリリース時の数値では、27BをQwen3.6 27B、Muse Glimmer 30B、Claude Opus 4.6 Maxと比較しています。
| Qwen 3.8 27B | Qwen3.6 27B | Muse Glimmer 30B | Claude Opus 4.6 Max | |
|---|---|---|---|---|
Terminal Bench 2.1 エージェントによるターミナル操作タスク | 73.0 | 63.4 | 51.7 | 78.2 |
SWE-bench Pro 実際のソフトウェア開発、難度の高い問題群 | 61.7 | 53.5 | 51.2 | 53.4 |
LiveCodeBench v6 競技プログラミング | 90.3 | 83.9 | - | 88.8 |
GPQA Diamond 専門家レベルの科学の問題 | 89.2 | 87.8 | 83.5 | 91.3 |
Humanity's Last Exam あらゆる分野の専門家レベルの問題 | 30.8 | 24.0 | 22.0 | 40.0 |
OSWorld-Verified エージェントによるコンピューター操作タスク | 84.3 | 63.9 | 65.9 | 72.7 |
SWE-MM マルチモーダルのソフトウェア開発 | 38.6 | 25.7 | - | 27.1 |
27Bは七つのベンチマークのうち四つでClaude Opus 4.6 Maxを上回ります。Opusレベルのモデルが、24 GBのカード1枚で動くようになりました。
同じクラスのローカルモデルについて、それぞれのベンダーが測定したスコアを示します。
| Qwen 3.8 27B | Muse Glimmer 30B | Nemotron 3.5 Lightning | Qwen3.6 35B A3B | Gemma 4 31B | |
|---|---|---|---|---|---|
パラメータ数 | 27B デンス型 | 30B デンス型 | 30B MoE (A3B) | 35B MoE (A3B) | 31B デンス型 |
4ビットGGUFのサイズ | 約17 GB | <20 GB | 約18 GB | 約20 GB | 約18 GB |
MMLU-Pro 学術分野全般の知識と推論 | - | - | 81.9 | 85.2 | 85.2 |
GPQA Diamond 専門家レベルの科学の問題 | 89.2 | 83.5 | 75.4 | 86.0 | 84.3 |
AIME 2026 高度な数学的推論 | - | 94.7 | - | 92.7 | 89.2 |
SWE-bench Verified 実際のソフトウェア開発タスク | - | 76.0 | 51.6 | 73.4 | - |
Humanity's Last Exam あらゆる分野の専門家レベルの問題 | 30.8 | 22.0 | 11.7 | 21.4 | 19.5 |
この二つ目の表のスコアはすべて、各ベンダーのモデルカードやリリース記事から引用しています。各組織の評価環境は異なるため、列間の小さな差には大きな意味はありません。ハイフンは、その数値がベンダーから公開されていないことを示します。また、Qwen3.6 35Bのカードでは、GPQA Diamondではなく単にGPQAと記載されています。
直接の競合はMuse Glimmer 30Bです。Metaがオープンウェイトに復帰した際のモデルで、同じ週に公開され、サイズもほぼ同じデンス型の視覚言語モデルです。リリース時の数値では、27BがGPQA Diamond(89.2対83.5)とHumanity's Last Exam(30.8対22.0)で上回る一方、上の表で公開されているSWE-bench Verifiedの最高スコアはGlimmerです。
27Bを判断する上で、より参考になるのは直接の前世代モデルです。Qwenが公開した結果では、Qwen3.6 27BはMMLU-Proで86.2%、SWE-bench Verifiedで77.2%を記録しています。4月のリリース以来、24 GBのカードに収まるローカルコーディング向けデンス型モデルの中でも、特に高性能なモデルの一つでした。3.8はパラメータ数と各次元を変えずに置き換えるため、ハードウェアの必要量も同じです。
Qwen 3.8 27B GGUF:当社で量子化しました
当社はQwenの元のBF16重みからAtomicChat Qwen 3.8 27B GGUFリポジトリを作成し、各ビルドを量子化前の基準モデルと比較測定しました。リポジトリには8.5-28.9 GBの16ビルドと、すべてのビルドで共有する別ファイルの画像プロジェクターがあります。複数トークン予測ヘッドは各ファイルに含まれているため、追加のダウンロードは不要です。ADはAtomic Dynamicの略で、AD-Q5_K_M-Q4_K_Mのように二つの名前がある場合は、大きい二つのテンソル群に適用した量子化を示します。両者が同じなら、名前は一つにまとめられます。
| ファイル | サイズ | KLダイバージェンス | Top-1一致率 |
|---|---|---|---|
| Q8_0 | 28.9 GB | 0.00064 | 98.92% |
| AD-Q6_K | 25.0 GB | 0.00107 | 98.67% |
| AD-Q6_K-Q5_K | 23.1 GB | 0.00252 | 97.94% |
| AD-Q5_K_M | 20.2 GB | 0.00419 | 97.34% |
| AD-Q5_K_M-Q4_K_M | 18.6 GB | 0.00730 | 96.43% |
| AD-Q4_K_M | 17.1 GB | 0.01126 | 95.59% |
| AD-IQ4_XS | 16.5 GB | 0.01248 | 95.39% |
| AD-IQ4_XS-IQ3_S | 14.4 GB | 0.02660 | 93.15% |
| AD-IQ3_S | 13.8 GB | 0.03247 | 92.41% |
| AD-IQ3_S-IQ3_XXS | 13.0 GB | 0.04337 | 91.33% |
| AD-IQ3_XXS | 12.1 GB | 0.06972 | 89.13% |
| AD-IQ2_S | 11.1 GB | 0.09832 | 87.18% |
| AD-IQ2_S-IQ2_XS | 10.2 GB | 0.13807 | 84.77% |
| AD-IQ2_XS | 9.9 GB | 0.16170 | 83.48% |
| AD-IQ2_XXS | 9.0 GB | 0.25663 | 79.44% |
| AD-IQ1_M | 8.5 GB | 0.34212 | 76.34% |
表の読み方:KLダイバージェンスは、量子化版と元の重みの出力分布の差を表します。低いほどよく、ゼロなら同一です。Top-1一致率は、量子化版が基準モデルと同じ次のトークンを選ぶ位置の割合です。一つの指標で全体を見たい場合は、Top-1一致率を使ってください。次の節では、どのファイルがハードウェアに合うかを説明します。
表の数値はすべて当社で測定しました。基準は元のBF16重みで、キャリブレーション用コーパスも公開しています。生のログは測定結果のリポジトリにあるため、どの数値も確認できます。手順の全体はモデルカードに掲載しています。
同じサイズで比較した当社GGUFの性能
unsloth、ggml-org、lmstudio-communityのビルドをダウンロードし、当社のビルドと同じ測定環境、同じBF16の基準モデルで評価しました。
| サイズ | 当社のビルド | 同サイズで最良の他社ビルド |
|---|---|---|
| 20.2 GB | AD-Q5_K_M, 0.00419 | unsloth UD-Q5_K_XL, 0.00437 |
| 25.0対25.9 GB | AD-Q6_K, 0.00107 | unsloth UD-Q6_K_XL、0.00110(0.9 GB大きい) |
| 16.5対16.1 GB | AD-IQ4_XS, 0.01248 | unsloth Q4_K_S, 0.01707 |
| 12.1対11.9 GB | AD-IQ3_XXS, 0.06972 | unsloth UD-IQ3_XXS, 0.07330 |
表のすべてのサイズで、AtomicChatのビルドのほうがKLダイバージェンスは低くなっています。
このモデルでは三つの配布元がQ4_K_Mというファイルを提供していますが、同じファイルではありません。
| 配布元 | サイズ | KLダイバージェンス |
|---|---|---|
| lmstudio-community | 16.8 GB | 0.02094 |
| ggml-org | 19.0 GB | 0.01470 |
| AtomicChat AD-Q4_K_M | 17.1 GB | 0.01126 |
量子化名が示すのは、配布元が指定した量子化の方式だけです。同じラベルでも各配布元が独自に構成を選ぶため、一つの名前に三つの異なるサイズが存在します。ビルドを選ぶ際は、ファイルサイズと測定された品質を基準にしてください。
Qwen 3.8 27Bのハードウェア要件
Qwen 3.8 27Bで確認すべきシステム要件はメモリです。下の表は、使用可能なRAMとVRAMの合計、またはApple Siliconのユニファイドメモリとして必要な容量を示しています。
| 使用可能なメモリ | 推奨GGUF量子化版 | ファイルサイズ | 確保できる余裕 |
|---|---|---|---|
| 12 GB | AD-IQ2_S | 11.1 GB | 短いコンテキストのみ。または一部の層をCPUに移す |
| 16 GB | AD-IQ3_S | 13.8 GB | 約8Kのコンテキスト |
| 24 GB | AD-Q5_K_M-Q4_K_M | 18.6 GB | 約16Kのコンテキスト |
| 32 GB | AD-Q6_K | 25.0 GB | 約24Kのコンテキスト |
| 48 GB以上 | Q8_0 | 28.9 GB | コンテキスト長はKVキャッシュに使える残りのメモリ次第 |
注意:隣り合う二つのファイルで迷ったら、大きいほうを選んでください。1-2GB多く使いますが、誤ったトークンを選ぶ頻度が明らかに減ります。特に品質が急激に落ちる14 GB未満では、その差が大きくなります。
コンテキストウィンドウでメモリはどれだけ増えるか?
上の数値はモデルの重みだけを対象としています。その上に、エンジンがKVキャッシュを確保します。チャットが長くなるほどモデルがメモリに保持するコンテキストも増え、必要な容量も増えます。大きな文書やコードベースを会話に貼り付ける場合も同じです。
通常のデンス型Transformerでは、64層すべてが各トークンのアテンションデータを保存します。このモデルでは、64層中48層が固定サイズの状態を持つGated DeltaNetを使い、16層のGated AttentionもKVヘッドは4個だけです。当社ビルドでの測定では、1トークン当たり256 KBのアテンションキャッシュを保持します。同じ構成の標準的なTransformerの約4分の1です。
| コンテキスト長 | アテンションキャッシュ |
|---|---|
| 8K(一般的なチャット) | 約2 GB |
| 32K(長い文書) | 約8 GB |
| 128K(大規模なコードベース) | 約33 GB |
| 262K(ネイティブの最大コンテキスト) | 約67 GB |
262Kのウィンドウ全体を使うにはサーバー向けハードウェアが必要です。キャッシュだけで約67 GBとなり、モデルファイルの2倍を超えるためです。
Qwen 3.8 27Bを実行できるハードウェアは?
- RTX 3090 / RTX 4090(VRAM 24 GB):AD-Q5_K_M-Q4_K_MをすべてVRAMに載せ、約16Kのコンテキスト用の余裕を残せます。
- RTX 5090(VRAM 32 GB):AD-Q6_KをすべてVRAMに載せ、約24Kのコンテキストで実行できます。この量子化では、モデルの動作は元のモデルに近くなります。
- 16 GBのGPU(RTX 4060 Ti、RTX 5060 Ti):AD-IQ3_Sと約8Kのコンテキストが収まります。または、4ビット版の数層をシステムRAMに移して実行できます。27Bはデンス型なので、最近紹介したMoEモデルよりもオフロードの負担が大きくなります。生成の各ステップで、GPUが低速なシステムRAM上の層の処理を待つためです。VRAMに完全に収まる小さな量子化版のほうが、通常はよい選択です。
- MacBook Pro(ユニファイドメモリ24 GB):AD-IQ3_Sを8Kのコンテキストで実行できます。macOSはデフォルトでGPUから使えるメモリをユニファイドメモリの約75%に制限するため、24 GBのMacでモデルが使えるのは約18 GBです。
- MacBook Pro M4/M5 Max、Mac Studio(36-64 GB):Q5やQ6を余裕を持って実行でき、48 GB以上ならQ8_0も使えます。Apple SiliconではGGUFビルドはMetalを通じてネイティブに動作します。形式を選ぶ場合は、GGUFとMLXの比較をご覧ください。
- スマートフォン:実行できません。スマートフォンで動くモデルが必要なら、Qwenガイドで紹介しているQwenファミリーの小型モデルを使ってください。
実測スループット
2枚のRTX 5090にすべての層を載せ、AD-Q4_K_Mを測定しました。
| コンテキスト | プロンプト処理 | 生成 |
|---|---|---|
| 8K | 363 t/s | 77 t/s |
| 32K | 5,244 t/s | 72 t/s |
コンテキストが8Kから32Kに増えても、生成速度は毎秒72-77トークンを維持します。24 GBのカード1枚では、これより低い数値になります。
Atomic ChatでQwen 3.8 27Bをローカル実行する方法
Atomic Chatは、私たちが開発した無料のオープンソースのローカルAIアプリです。Hugging Faceのモデルブラウザーを備え、分割GGUFのダウンロードを管理し、llama.cppを手動でビルドすることなくチャット画面を利用できます。
Atomic ChatでQwen 3.8 27Bを実行する手順は次のとおりです。
ステップ1:Atomic Chatをインストールする
atomic.chatからAtomic Chatをダウンロードし、プラットフォームに合うビルドをインストールします。
- macOS:ユニバーサル.dmg(IntelとApple Silicon)、macOS 13.6以降
- Windows:x64向け.exeインストーラー
- Linux:root権限が不要なx86_64向け単体.AppImage
- iOS:App Storeから入手
- Android:Google Playから入手
Linuxでは、chmod +xでAppImageに実行権限を付け、直接実行します。初回起動時にFUSEが必要と表示された場合は、DebianやUbuntuではsudo apt install fuse libfuse2、Fedoraではsudo dnf install fuse fuse-libsでインストールしてください。
ステップ2:当社のQwen 3.8 27B GGUFを探す
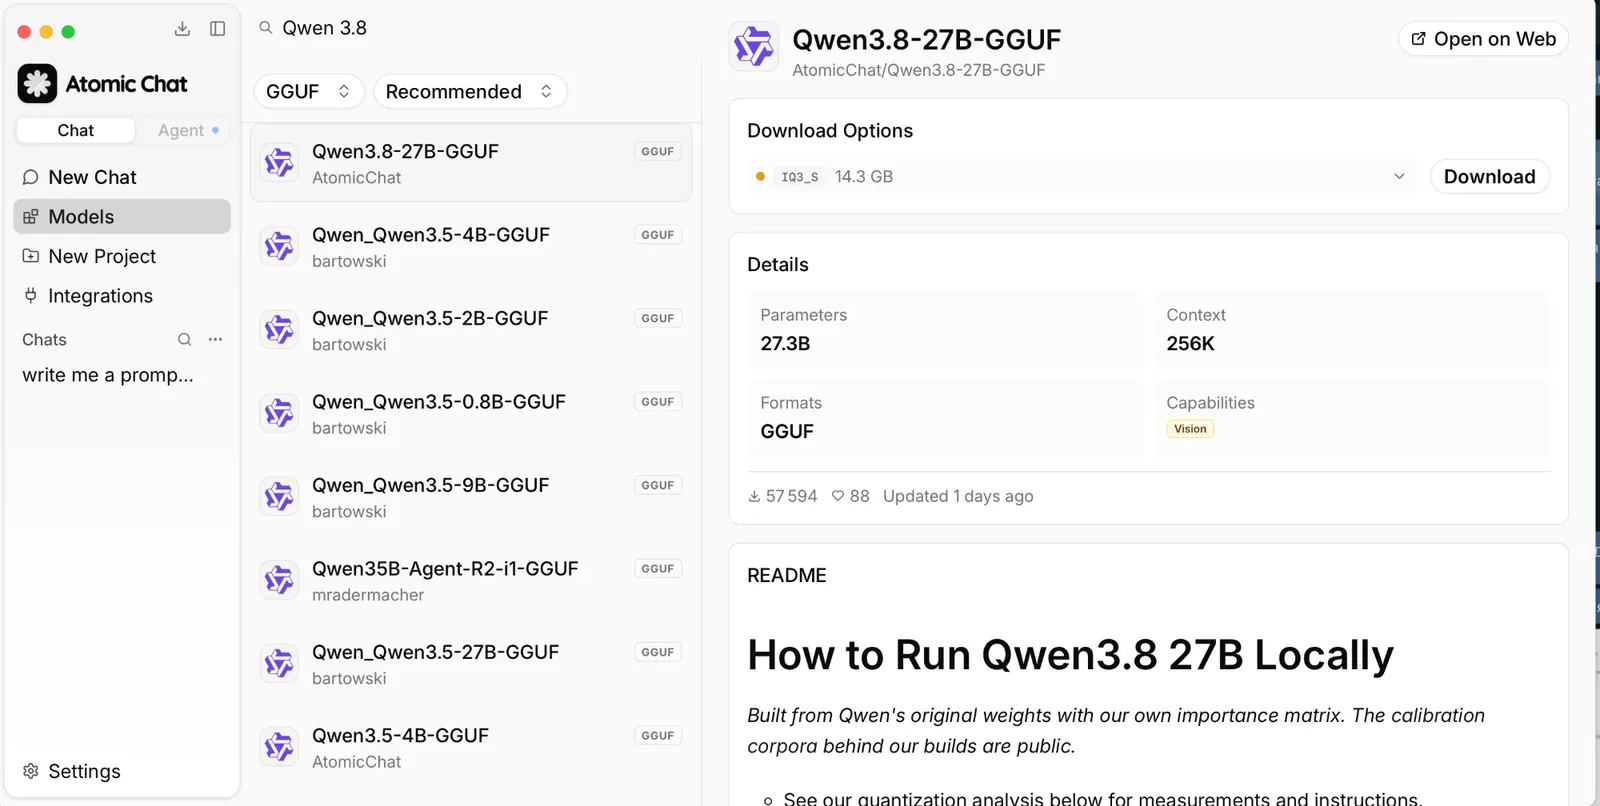
Modelsタブを開き、次を検索します。
AtomicChat/Qwen3.8-27B-GGUF
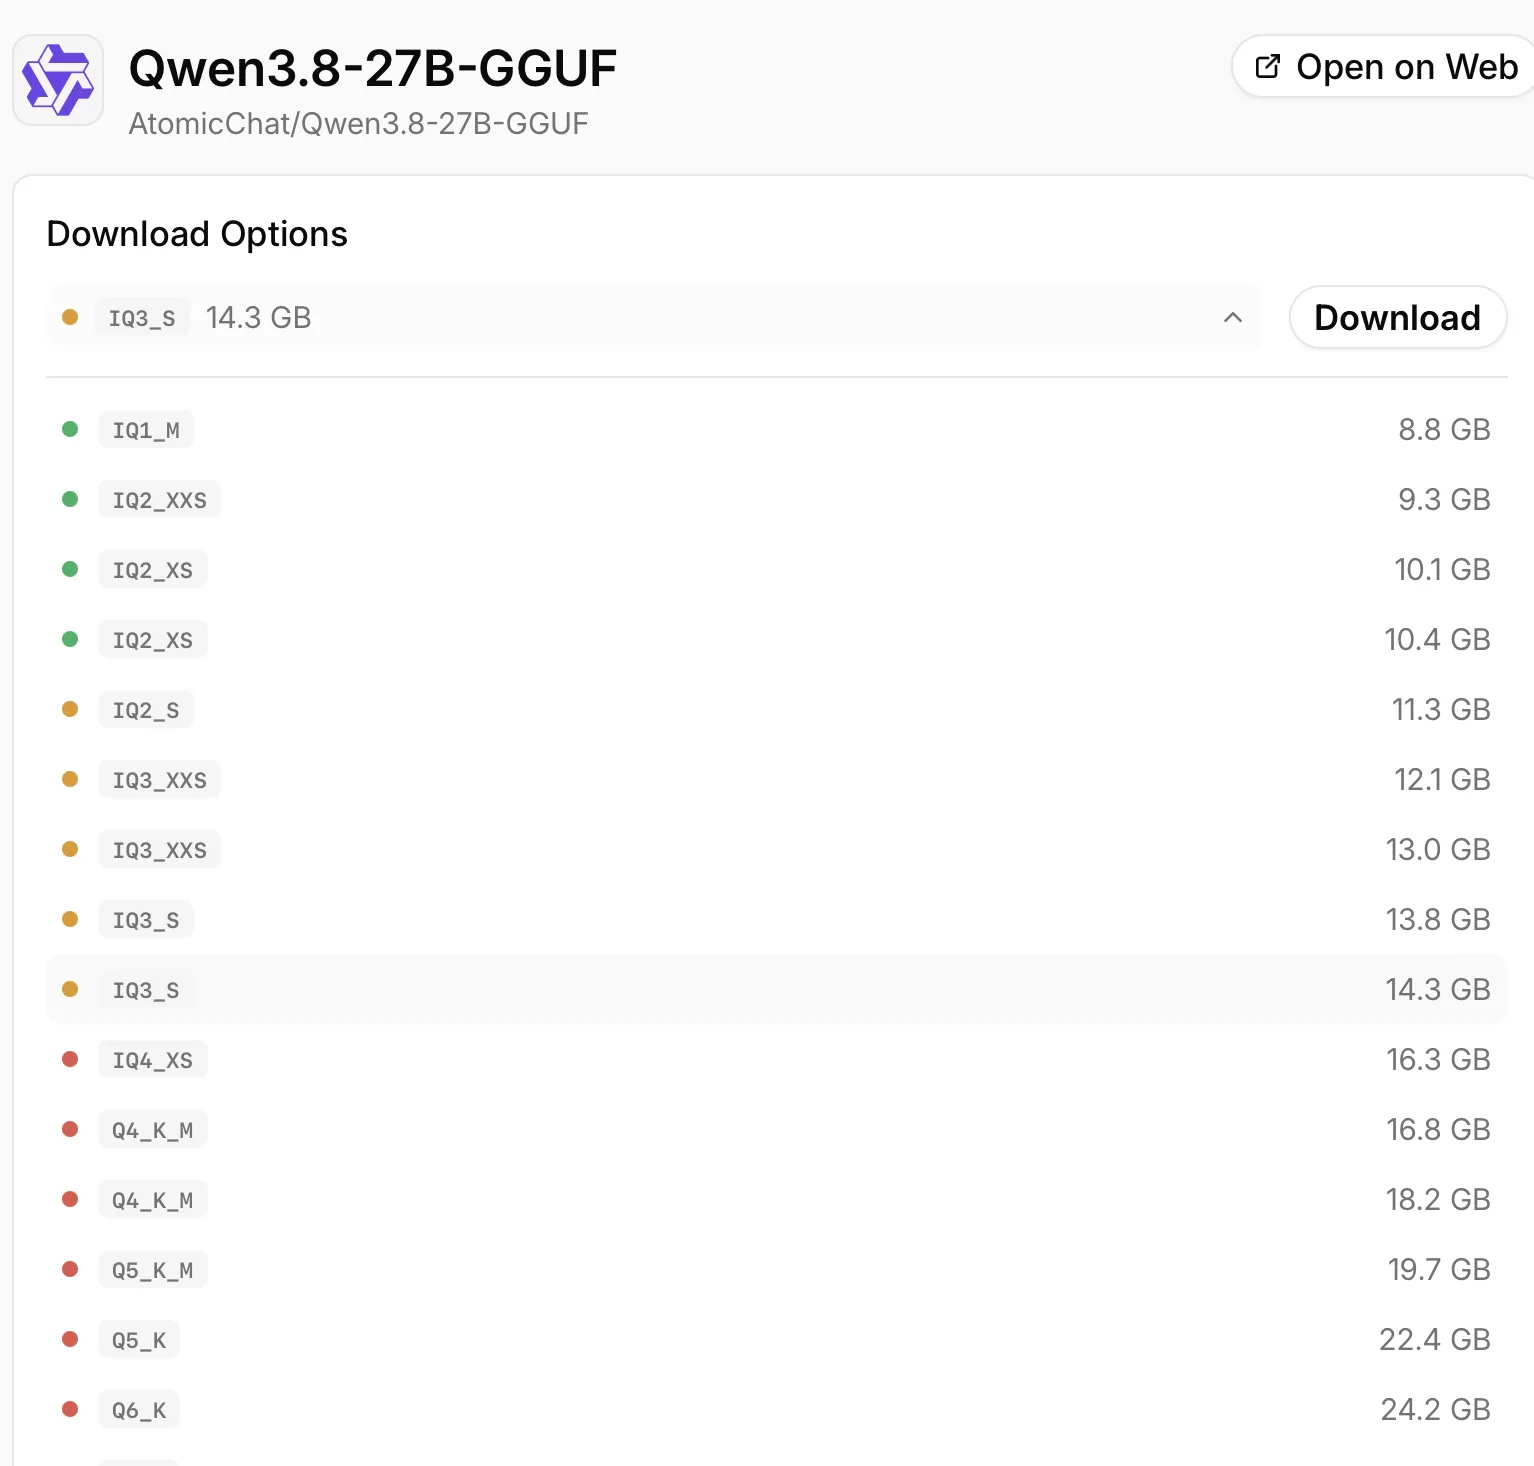
カタログはHugging Faceと連携しているため、ほかの配布元のビルドも公開されると表示されます。AtomicChatが公開した結果を選び、Download Optionsを開いて、利用できる量子化版を表示します。
注意:重みが公開される前から、Hugging Faceには偽のQwen3.8-27Bリポジトリが存在していました。アプリのカタログ以外からダウンロードする場合は、「トラブルシューティング」でファイルの確認方法を参照してください。
ステップ3:メモリに合う量子化版を選ぶ
上のハードウェア表を使ってください。一般的な構成では、次を選びます。
- 24 GBのGPU:AD-Q5_K_M-Q4_K_Mをダウンロードします。
- 32 GB:AD-Q6_Kをダウンロードします。
- 48 GB以上:Q8_0をダウンロードします。
選択欄では、各ビルドはAD接頭辞なしの短いタグで表示されます。AD-Q5_K_M-Q4_K_Mのように二つの名前がある場合は、小さいほうのタグで表示されます。24 GBのカードなら、18.2 GBのQ4_K_Mの行を選びます。選択欄のサイズは、表に記載したファイルサイズと少し異なります。同じ名前の行が二つある場合は、サイズを基準にしてください。コンテキスト用の余裕を残して収まる中で、最も大きい量子化版を選びます。量子化名の意味が分からない場合は、GGUFと量子化の仕組みを説明するガイドをご覧ください。
ステップ4:コンテキスト、思考、サンプリングを設定する
モデルのコンテキストウィンドウは262Kですが、最大値に設定するとKVキャッシュが最初に確保されます。チャットでは8,192トークン、コードや文書の作業では32,768トークンから始め、作業に必要な場合だけ増やしてください。
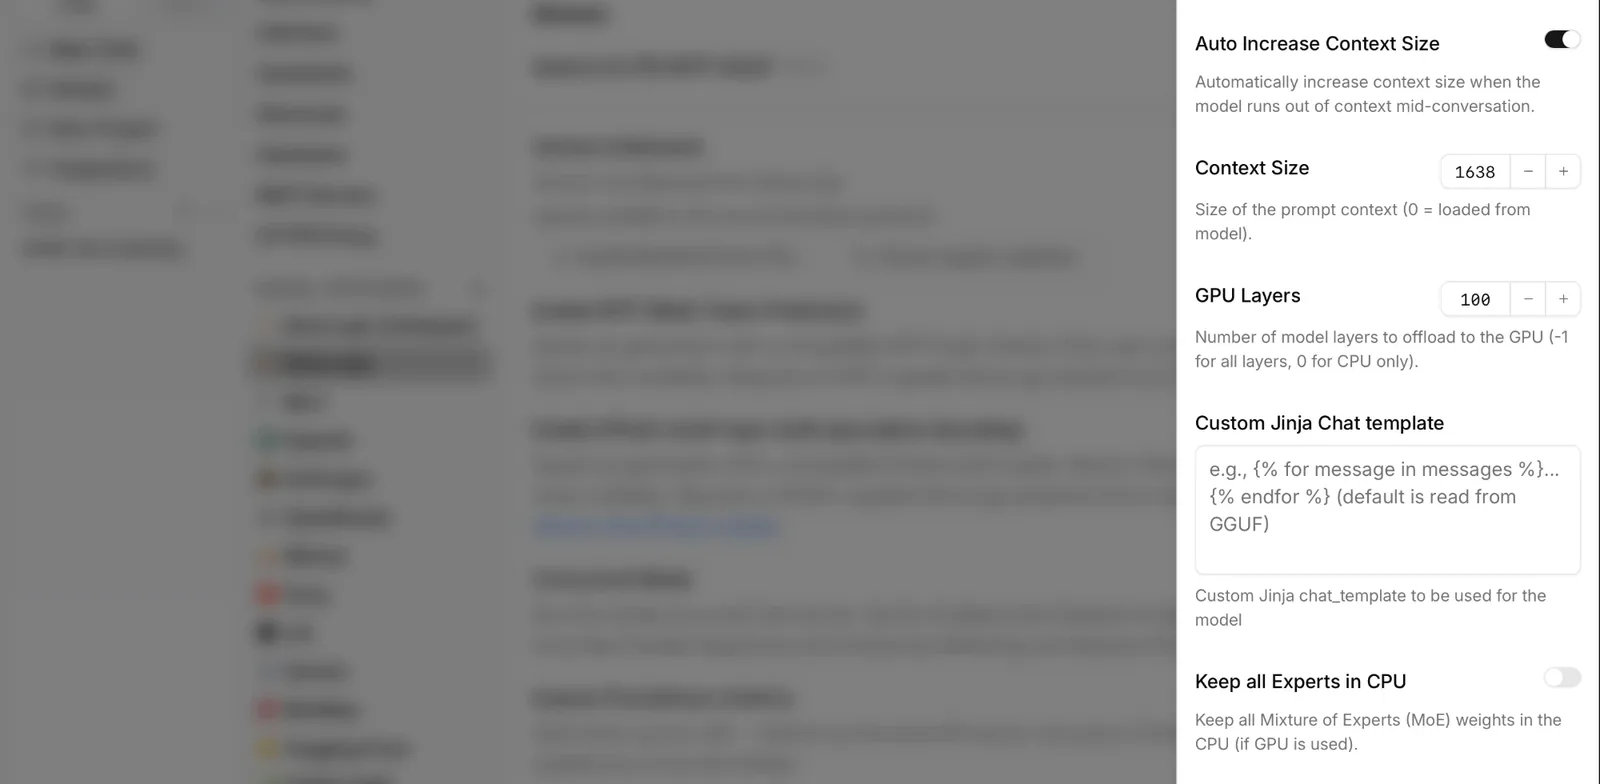
コンテキストサイズはチャット画面ではなく、モデル自体の設定にあります。Settings → Model Providers → Llama.cppを開き、モデル一覧でQwen 3.8のビルドを探して、その行の歯車アイコンをクリックします。次の三つを設定してください。
- Context Size:8192または32768に設定します。0にするとGGUFから最大値が読み込まれ、このモデルでは262Kのウィンドウ全体が使われます。
- Auto Increase Context Size:デフォルトで有効です。会話の余裕がなくなるとコンテキストを拡張するため、ぎりぎり収まっていたビルドがメモリ上限を超えることがあります。上限近くで使う場合は無効にしてください。
- GPU Layers:-1ですべての層をGPUに載せます。VRAMに収まるデンス型モデルでは、この設定が適しています。
Context SizeやGPU Layersを変更するとモデルが再起動するため、長い会話を始める前に設定してください。
思考はデフォルトでxhighが有効で、mediumやlowも使えます。完全に無効化することもでき、チャット内の電球アイコンで切り替えます。Atomic Chatでは、推論の出力を表示するか隠すかも選べます。
サンプリングは別のパネルにあります。チャット上部のモデル名の横にあるスライダーアイコンをクリックしてください。思考モードでは、Qwenはtemperature 1.0、top_p 0.95、top_k 20を推奨しています。思考を無効にした場合は0.7と0.80です。これらの設定はモデルではなくアシスタント、つまりチャットのプロファイルに保存されるため、モデルを切り替えても変わりません。
ステップ5:ローカルでチャットする
ダウンロードが完了すると、Atomic Chatがモデルを読み込み、内蔵チャットで開きます。
27Bはネイティブの視覚言語モデルなので、チャットに画像を添付して質問できます。画像、重み、プロンプトは自分のマシン内にとどまります。
Atomic Chatは、http://localhost:1337/v1でOpenAI互換APIサーバーも提供します。Claude CodeやClineなどのコーディングエージェントを含め、OpenAI APIに対応するツールなら、クラウドモデルの代わりにローカルモデルをそのまま使えます。
llama.cppでQwen 3.8 27Bを実行する方法
次のような要件がある場合は、llama.cppから直接モデルを実行する方法が向いています。
- フラグを明示して設定するOpenAI互換ローカルエンドポイント
- GPUオフロードの厳密な制御
- 再現可能なサーバー構成
27BはQwen3.6と同じGated DeltaNetのハイブリッド設計を使っています。上流のllama.cppは2026年2月からこれに対応しているため、リリース当日のGGUFも、最新ビルドならパッチなしで動作します。
ステップ1:最新のllama.cppをビルドする
NVIDIA CUDAの場合:
git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp
cmake -B build -DCMAKE_BUILD_TYPE=Release -DGGML_CUDA=ON
cmake --build build -j --target llama-cli llama-server
Apple Siliconでは、Metalがデフォルトで有効です。
cmake -B build -DCMAKE_BUILD_TYPE=Release
cmake --build build -j --target llama-cli llama-server
ステップ2:モデルを実行する
次のコマンドは、Hugging FaceからAD-Q4_K_Mをダウンロードし、すべての層をGPUに載せ、Qwenが推奨するサンプリングを適用して、コンテキストを8Kに制限します。
./build/bin/llama-cli \
  -hf AtomicChat/Qwen3.8-27B-GGUF:AD-Q4_K_M \
  --jinja \
  --temp 1.0 --top-p 0.95 --top-k 20 \
  -ngl 99 \
  -c 8192
システムのメモリ容量が異なる場合は、AD-Q4_K_Mを別の量子化名に置き換えてください。
ステップ3:ローカルのOpenAI互換APIを公開する
llama-cliをllama-serverに置き換えます。
./build/bin/llama-server \
  -hf AtomicChat/Qwen3.8-27B-GGUF:AD-Q4_K_M \
  --alias qwen3.8-27b \
  --jinja \
  --temp 1.0 --top-p 0.95 --top-k 20 \
  -ngl 99 \
  -c 8192 \
  --host 127.0.0.1 --port 8080
次でテストします。
curl http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{ "model": "qwen3.8-27b", "messages": [ { "role": "user", "content": "Summarize what Gated DeltaNet changes about attention." } ] }'
ネットワーク内のほかのマシンからアクセスする必要がなければ、サーバーは127.0.0.1にバインドしてください。
llama.cppで画像入力を使う
画像入力には、すべての量子化版で共有する画像プロジェクターという追加ファイルが一つ必要です。リポジトリからmmproj-Qwen3.8-27B-F16.ggufを一度ダウンロードし、選んだ量子化版と一緒に指定してください。
llama-mtmd-cli \
  -m Qwen3.8-27B-AD-Q4_K_M.gguf \
  --mmproj mmproj-Qwen3.8-27B-F16.gguf \
  --image your-photo.jpg --image-min-tokens 1024 \
  -ngl 99 -c 8192 \
  -p "What is in this image?"
--image-min-tokens 1024は維持してください。llama.cppは、このファミリーには少なくともこの数の画像トークンが必要だと警告します。下回ると、位置に関する処理が不安定になります。画像理解は量子化してもよく保たれています。AD-IQ3_S以上のすべてのファイルは、当社の手書き文字テストを改行まで含めて正確に書き起こしました。
OllamaやLM Studioで実行する
どちらのアプリも内部でllama.cppを使っており、リリース当日から対応しています。ollama pull qwen3.8:27bが動作し、LM StudioのカタログにはGGUFとMLXのビルドが掲載されています。AtomicChatのGGUFビルドも両アプリで読み込めます。
トラブルシューティング
ダウンロードしたGGUFが本物のモデルではない
重みが公開される前から、Hugging FaceにはQwen3.8-27Bを名乗るプレースホルダーのリポジトリがありました。知らないリポジトリからダウンロードする前に、配布元が公式のQwen組織か、知っている量子化の提供者であること、モデルカードがあること、ファイル一覧に妥当なサイズのGGUF分割ファイルが実際に存在することを確認してください。4ビットの27Bモデルが400 MBに収まることはありません。
思考モードをオフにできない
モデルはenable_thinking: falseによる思考の無効化に対応していますが、チャットテンプレートがこの設定を渡さないと機能しません。新しいQwenのリリースで、このテンプレート処理が動かなくなったことは一度ではありません。思考をオフにしてもモデルが推論を続ける場合は、まずllama.cppを更新し、リポジトリのREADMEを確認してください。動作するフラグをそこで説明しています。
画像のエンコード中にllama.cppが警告を表示する
find_slot: non-consecutive token positionや、未使用のblk.64テンソルについての行が出るのは想定内です。前者は、このファミリーが画像パッチの位置を、単一の連番ではなく多次元の位置エンコーディングで表すためです。後者は、通常の順伝播では実行しない予測ヘッドです。
長いコンテキストでメモリが不足する
重みは収まっていても、会話が長くなるとモデルがクラッシュすることがあります。KVキャッシュが空きメモリを超えて増えたためです。Context Sizeは0ではなく明示的な値にし、上限近くではAuto Increase Context Sizeを無効にしてください。さらに余裕が必要なら、量子化版を一段小さいものにします。キャッシュは1トークン当たり256 KBなので、1GB空けるごとに約4Kのコンテキストを追加できます。
よくある質問
Qwen 3.8 27Bを自分のハードウェアで実行する際によくある質問です。
Qwen 3.8 27BにはどのくらいのVRAMが必要ですか?
4ビットのファイルは約17 GBです。一般的な量子化版でコンテキスト用の余裕を確保するには、24 GBのGPUが実用上の最小構成になります。Apple Siliconでは、macOSがGPUメモリをユニファイドメモリの約75%に制限するため、24 GBのMacでは3ビット版を使います。32 GB以上なら、コンテキスト用の余裕を残して4ビット版を実行できます。
VRAM 16GBでQwen 3.8 27Bを実行できますか?
はい。ただし、トレードオフがあります。AD-IQ3_S(13.8 GB)は16 GBに約8Kのコンテキストとともに収まり、元のモデルに対するTop-1一致率は92.41%です。4ビット版では一部をCPU側に移す必要があり、デンス型モデルではトークンごとに速度が低下します。12 GBでは、AD-IQ2_Sを短いコンテキストに限って実行できます。
MacでQwen 3.8 27Bを実行できますか?
はい。ユニファイドメモリ24 GBのMacならAD-IQ3_Sを8Kのコンテキストで実行でき、36-64 GBのMacならQ5やQ6をMetal経由でネイティブに実行できます。48 GB以上ならQ8_0も使えます。16 GBのMacでは実用的なコンテキスト用の容量が足りません。そのハードウェアについては、16GBのMacにおすすめのローカルLLMをご覧ください。
Qwen 3.8 27Bはもうリリースされていますか?
はい。Qwen 3.8 27Bのリリース日は2026年8月14日です。Alibabaは8月3日にファミリーを発表し、Hugging Faceの公式Qwen組織で重みを公開しました。当社のGGUFビルドはAtomicChat/Qwen3.8-27B-GGUFリポジトリとAtomic Chatのカタログにあります。
Qwen 3.8 27BとQwen 3.8 Maxの違いは何ですか?
違いはサイズとモダリティです。Qwen 3.8 Maxは2.4TパラメータのMoEモデルで、公開された重みはテキスト専用かつ常に推論します。2.4兆パラメータを提供するにはデータセンター向けハードウェアが必要です。Qwen 3.8 27Bは画像や動画を入力できるデンス型の視覚言語モデルで、24 GBのGPU1枚に収まります。
Qwen 3.8 27BはQwen3.6 27Bより高性能ですか?
Alibabaのリリース時の数値では、はい。SWE-bench Proは53.5から61.7、Terminal Bench 2.1は63.4から73.0、OSWorld-Verifiedは63.9から84.3に上がっています。両モデルのサイズと各次元は同じため、ハードウェアの必要量もそのまま引き継がれます。現在Qwen3.6 27Bが動いているマシンには、3.8のビルドも収まります。
Qwen 3.8 27BはMuse Glimmer 30Bと比べてどうですか?
現在のローカルモデルでは、最も近い組み合わせです。同じ週に公開された約30Bのデンス型視覚言語モデルで、どちらも4ビットなら24 GBのカードに収まります。27BはGPQA Diamond(89.2対83.5)とHumanity's Last Exam(30.8対22.0)で上回ります。Glimmerの公開値で特に高いのはSWE-bench Verifiedの76.0で、Qwenのカードにはこのベンチマークの結果がありません。どちらもApache 2.0で提供されています。
Qwen 3.8 27Bはローカルで画像理解に対応していますか?
はい。Qwen 3.8 27Bは、画像と動画の入力に対応したネイティブの視覚言語モデルです。Atomic Chatではチャットに画像を添付して質問でき、データはマシンの外に出ません。llama.cppでもリリース初日から画像入力が使え、すべてのGGUF配布元が量子化版とともにmmprojファイルを提供しています。llama.cppでは動画入力には対応していません。
Qwen 3.8 27BはOllamaやLM Studioで動きますか?
はい。リリース当日から、Ollamaではollama pull qwen3.8:27bが使え、LM StudioではGGUFとMLXのビルドがカタログにあります。両アプリとも、AtomicChatリポジトリを指定すれば当社のファイルも利用できます。
思考モードをオフにできますか?
はい。思考はデフォルトでxhighで動作し、mediumとlowも選べます。enable_thinking: falseで完全に無効化できます。思考を無効にした場合、Qwenはtemperature 0.7とtop_p 0.80を推奨しています。Atomic Chatでは、チャットの電球アイコンで切り替えます。
Qwen 3.8 27Bは無料で商用利用できますか?
はい。Qwen 3.8 27BはApache 2.0ライセンスで提供され、商用利用、改変、再配布が認められています。商用利用にしきい値を設けた独自のQwenライセンスが適用されるのはQwen 3.8 Maxの公開重みだけで、27Bには適用されません。
まとめ
24 GBのGPUまたは32 GBのユニファイドメモリがあるなら、Qwen 3.8ファミリーでローカル実行に選ぶモデルはQwen 3.8 27Bです。Atomic ChatからAD-Q5_K_M-Q4_K_Mをダウンロードし、8Kのコンテキストから始めて、作業に応じて増やしてください。llama.cppでも同じファイルを使い、ローカルのOpenAI互換APIとして提供できます。
要点:
- Qwen 3.8 27Bは、ハイブリッドアテンション、ネイティブ262Kのコンテキストウィンドウ、複数トークン予測を備えた27Bのデンス型マルチモーダルモデルです。
- Alibabaは2026年8月3日にQwen 3.8ファミリーを発表しました。27Bの重みは8月14日にApache 2.0で公開されました。
- 当社のGGUFビルドは8.5-28.9 GBです。24 GBのカードにはAD-Q5_K_M-Q4_K_Mを選んでください。
- 長いコンテキストには、ファイルに加えてメモリが必要です。8Kで約2 GB、32Kで約8 GBが増えます。
- 隣り合う量子化版では、追加の1GBを使っても大きいほうを選ぶ価値があります。14 GBを下回ると誤差が特に速く増えます。




