

セルフホスト型LLMは、デバイス上でローカルに動くAIモデルです。このガイドでは、設定方法を手順に沿って説明します。
この用途のために私たちが開発した、Mac、Windows、Linux向けの無料オープンソースデスクトップアプリAtomic Chatを使います。Ollama、LM Studio、好みのほかの推論プロバイダーでも構いません。次の方法を解説します。
- モデルを選ぶ。
- ターミナルのコマンドを使わずにGGUFをダウンロードする。
- プライベートなローカルチャットを使う。
- 対応モデルファミリーを高速化する。
- OpenAI互換APIを公開し、コーディングツールに接続する。
さっそく始めましょう。
セルフホスト型LLMとは?
簡単に言えば、セルフホスト型LLMは、自分が所有するハードウェア、またはプライベートサーバーとして借りたハードウェアで動く言語モデルです。
セルフホストの構成では、モデルをインストールしたハードウェア上でプロンプトを処理するため、モデルを開発・配布した企業に送信する必要がありません。たとえば、OpenAIが開発したGPT-OSSをセルフホストすれば、プロンプトはOpenAIのサーバーには送られません。
セルフホスト型LLMはオープンソースやオープンウェイトのモデルと混同されることがありますが、必ずしも同じ意味ではありません。ダウンロードしてローカル実行できるモデルが、自動的にオープンソースになるわけではありません。また、ダウンロードできるモデルにも、改変、再配布、商用利用について異なる制約がある場合があります。
ただし、実際にはセルフホストを想定したLLMの多くは、オープンウェイトとして配布されています。
Atomic ChatでLLMをセルフホストする方法
Atomic Chatは、私たちが開発したローカルモデル実行用のオープンソースデスクトップアプリです。ここでは推論プロバイダーとして使い、セルフホスト型LLMを設定する方法を紹介します。
例としてQwen3.6 27BのQ4_K_M量子化版を使いますが、Hugging Faceにある1000以上のAIモデルから選べます。
1. Atomic Chatをインストールしてバックエンドを選ぶ
まず、次の手順を行います。
- atomic.chatからOSに合うAtomic Chatをダウンロードしてインストールし、アプリを開きます。
- 開始用モデルの画面では、ダウンロードをスキップします。後で手動でモデルを探してダウンロードします。
- “Optimize the Turboquant backend?”ダイアログが表示されたら、下の表を参考にバックエンドを選びます。
- Atomic Chatのホーム画面が開くまで待ちます。
| 選択肢 | Atomic Chatの動作 |
|---|---|
| Find optimal backend | コンピューターに対応するCUDAまたはVulkanバックエンドを検出し、ダウンロードする |
| Skip | 同梱のCPU対応バックエンドで続行する |
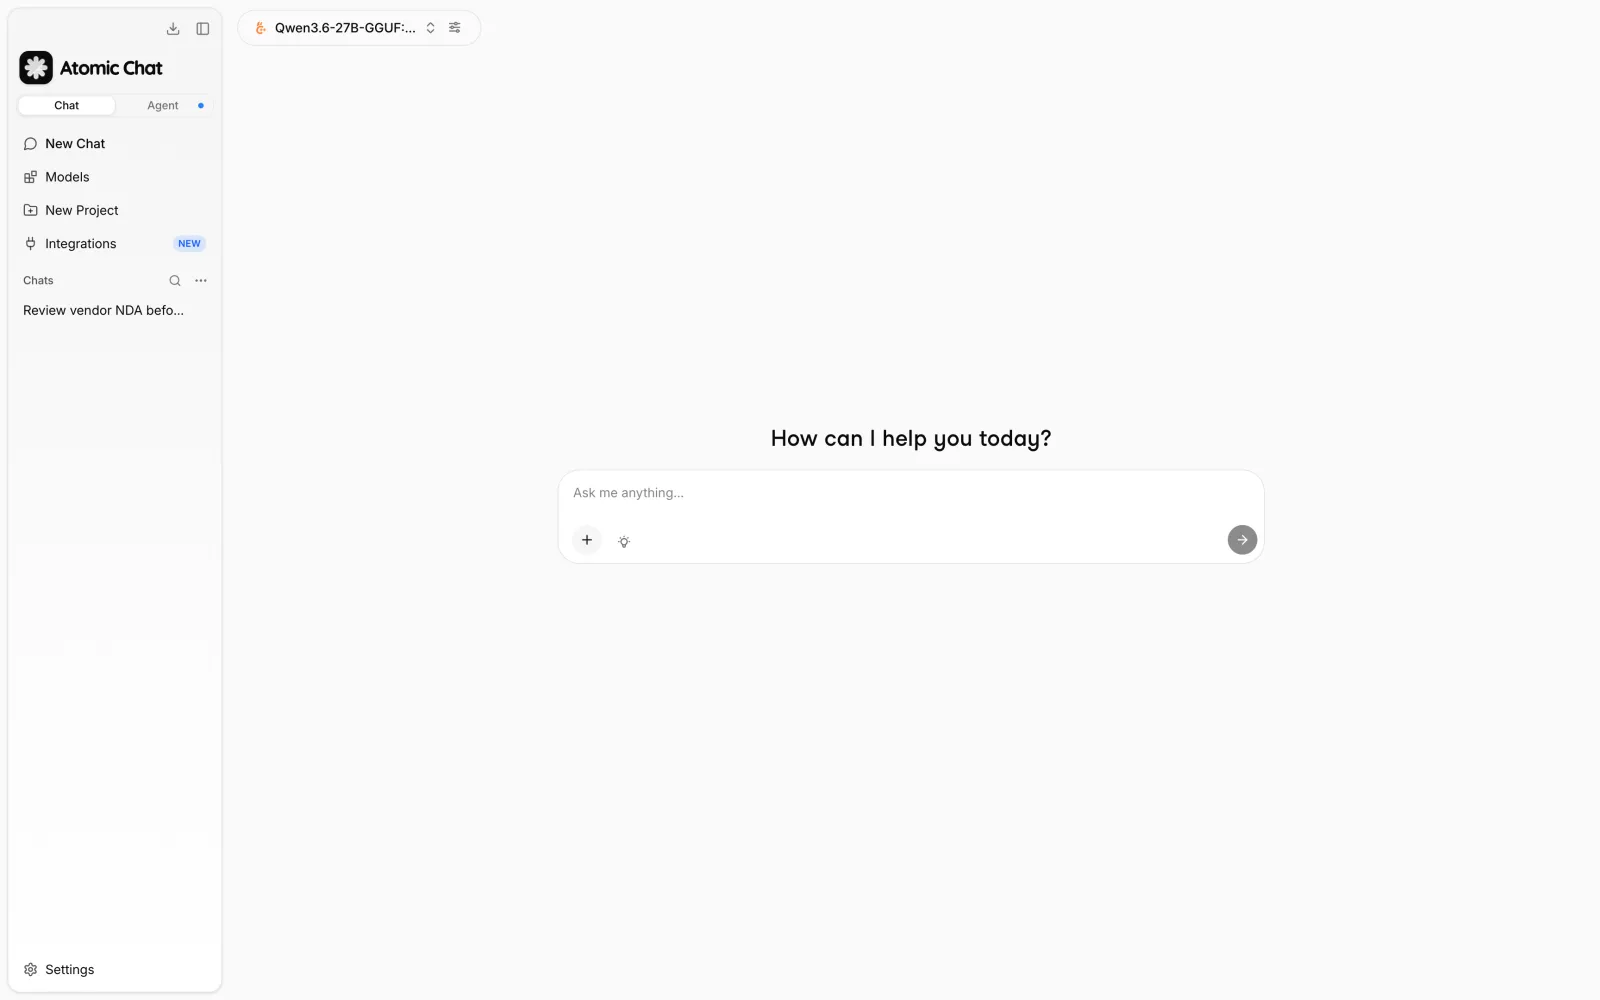
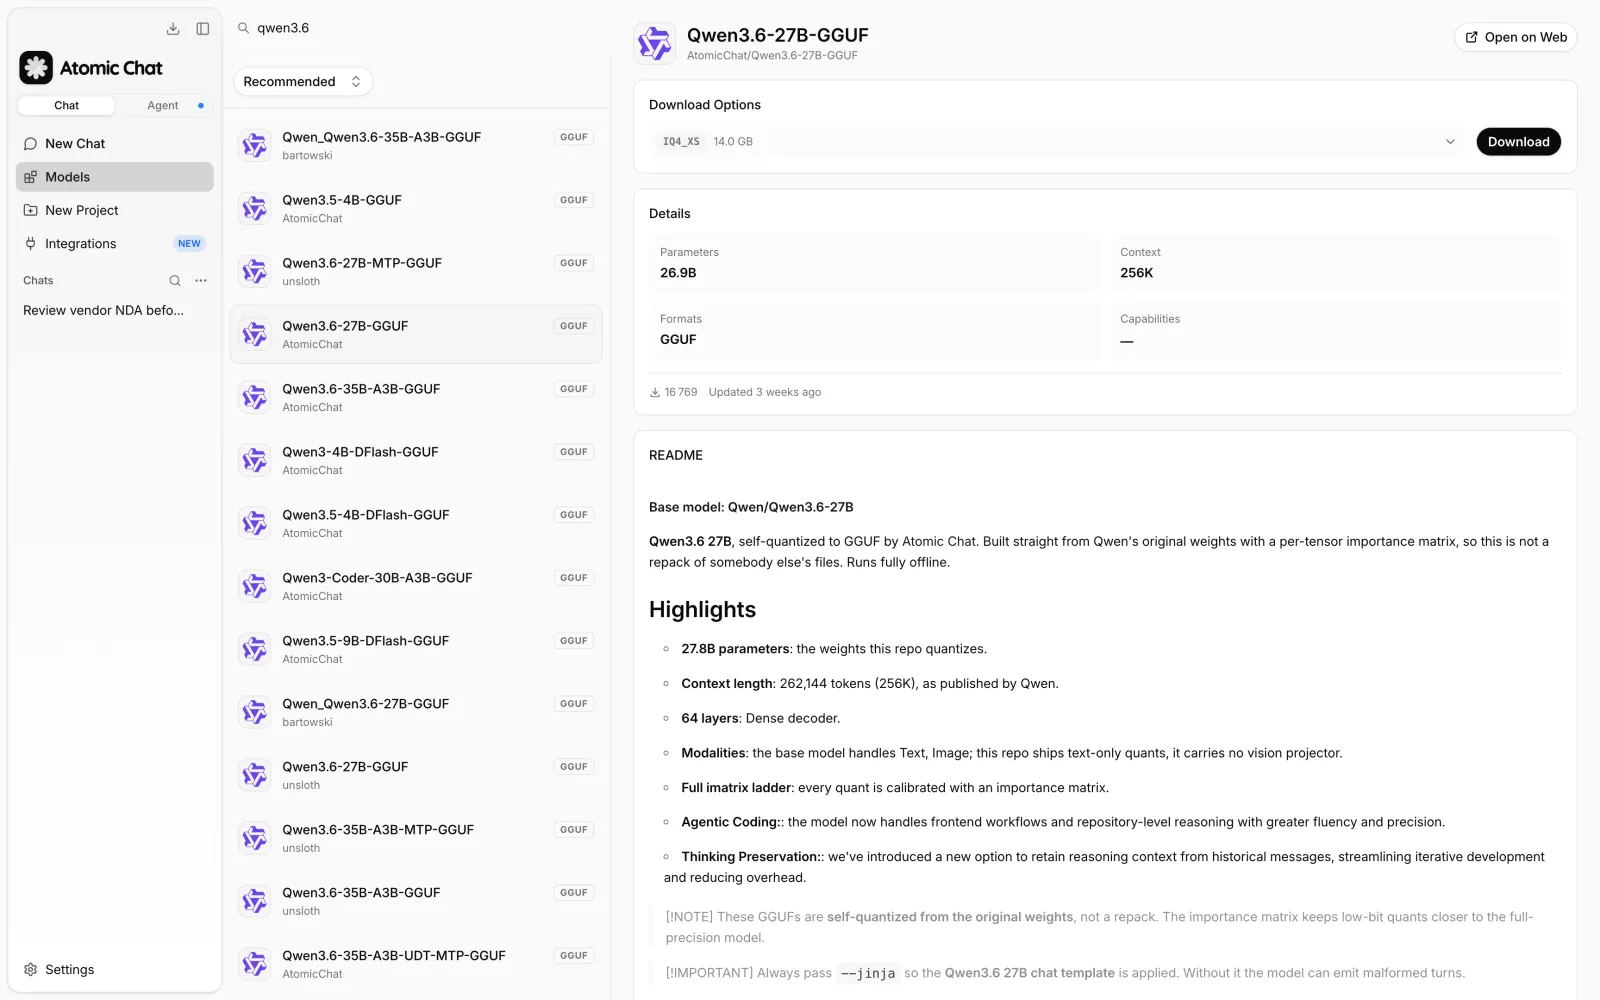
2. モデルのページを開く
- サイドバーでModelsを選びます。
- この例では、“Search for models on Hugging Face...”に
AtomicChat/Qwen3.6-27B-GGUFと入力します。 - モデルのページを開きます。
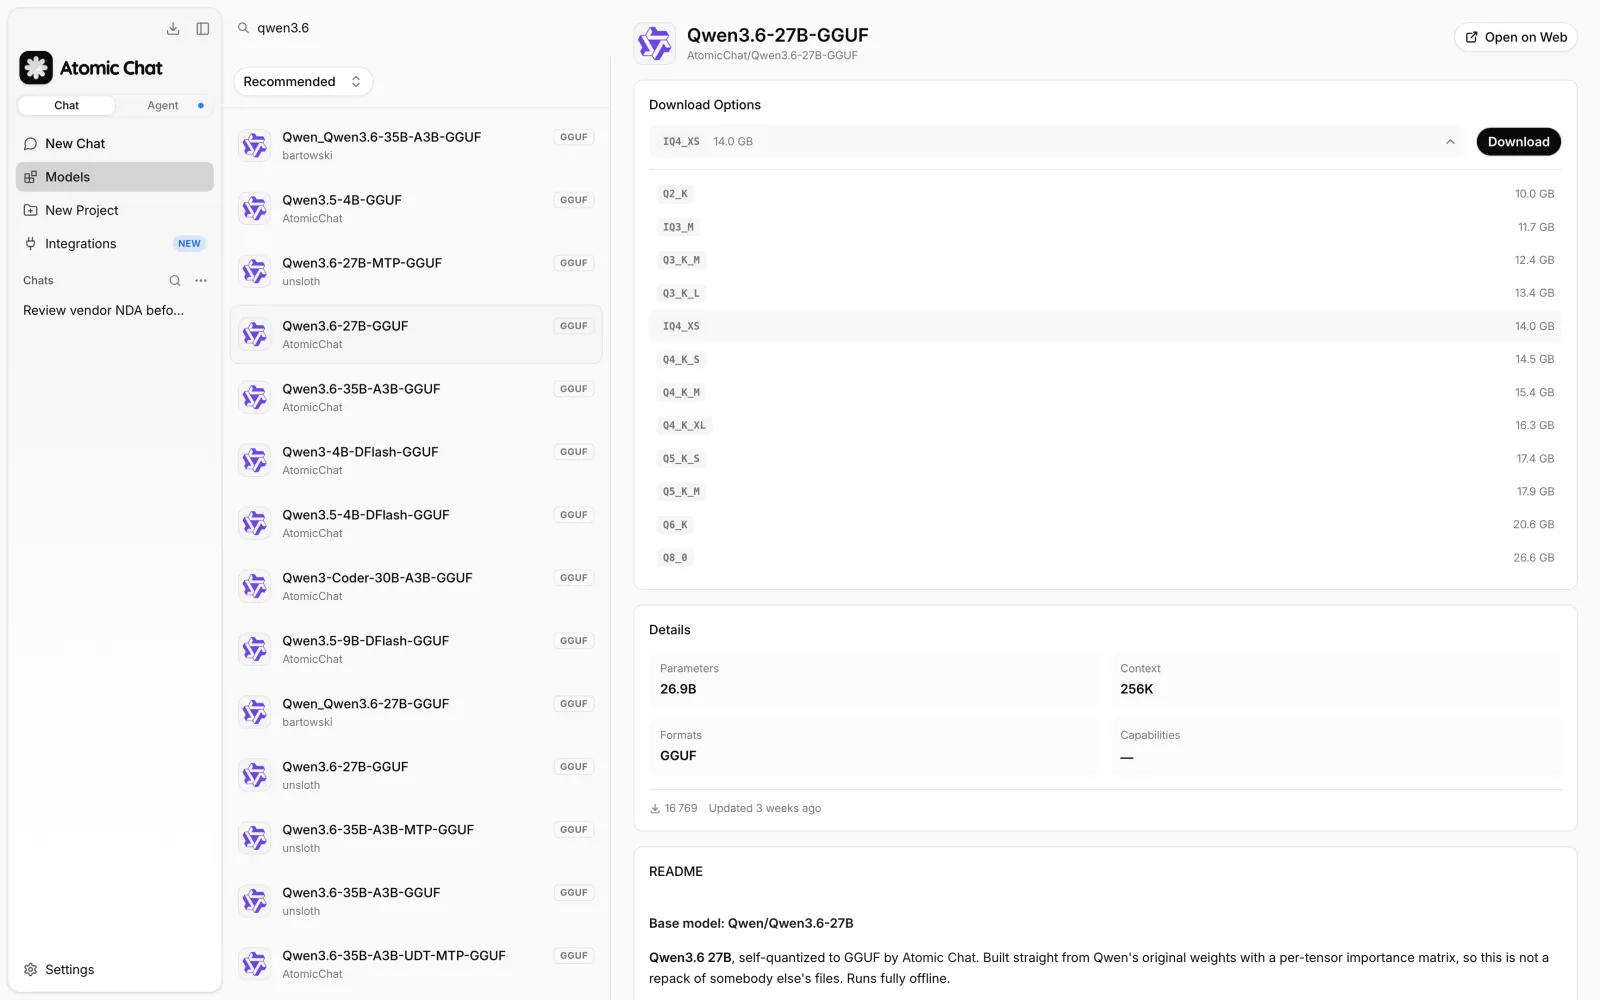
3. モデルの量子化版をダウンロードする
- Download Optionsを開きます。
- この例では、量子化メニューから
Q4_K_Mを選びます。 - Downloadをクリックし、モデルファイルのダウンロードが終わるまで待ちます。
- Use this modelをクリックします。
手元のモデルファイルを使いたい場合は、既存のGGUFをインポートします。
- Settings → Model Providers → llama.cppを開きます。
- Importを選びます。
- コンピューターに保存済みのGGUFファイルを選びます。
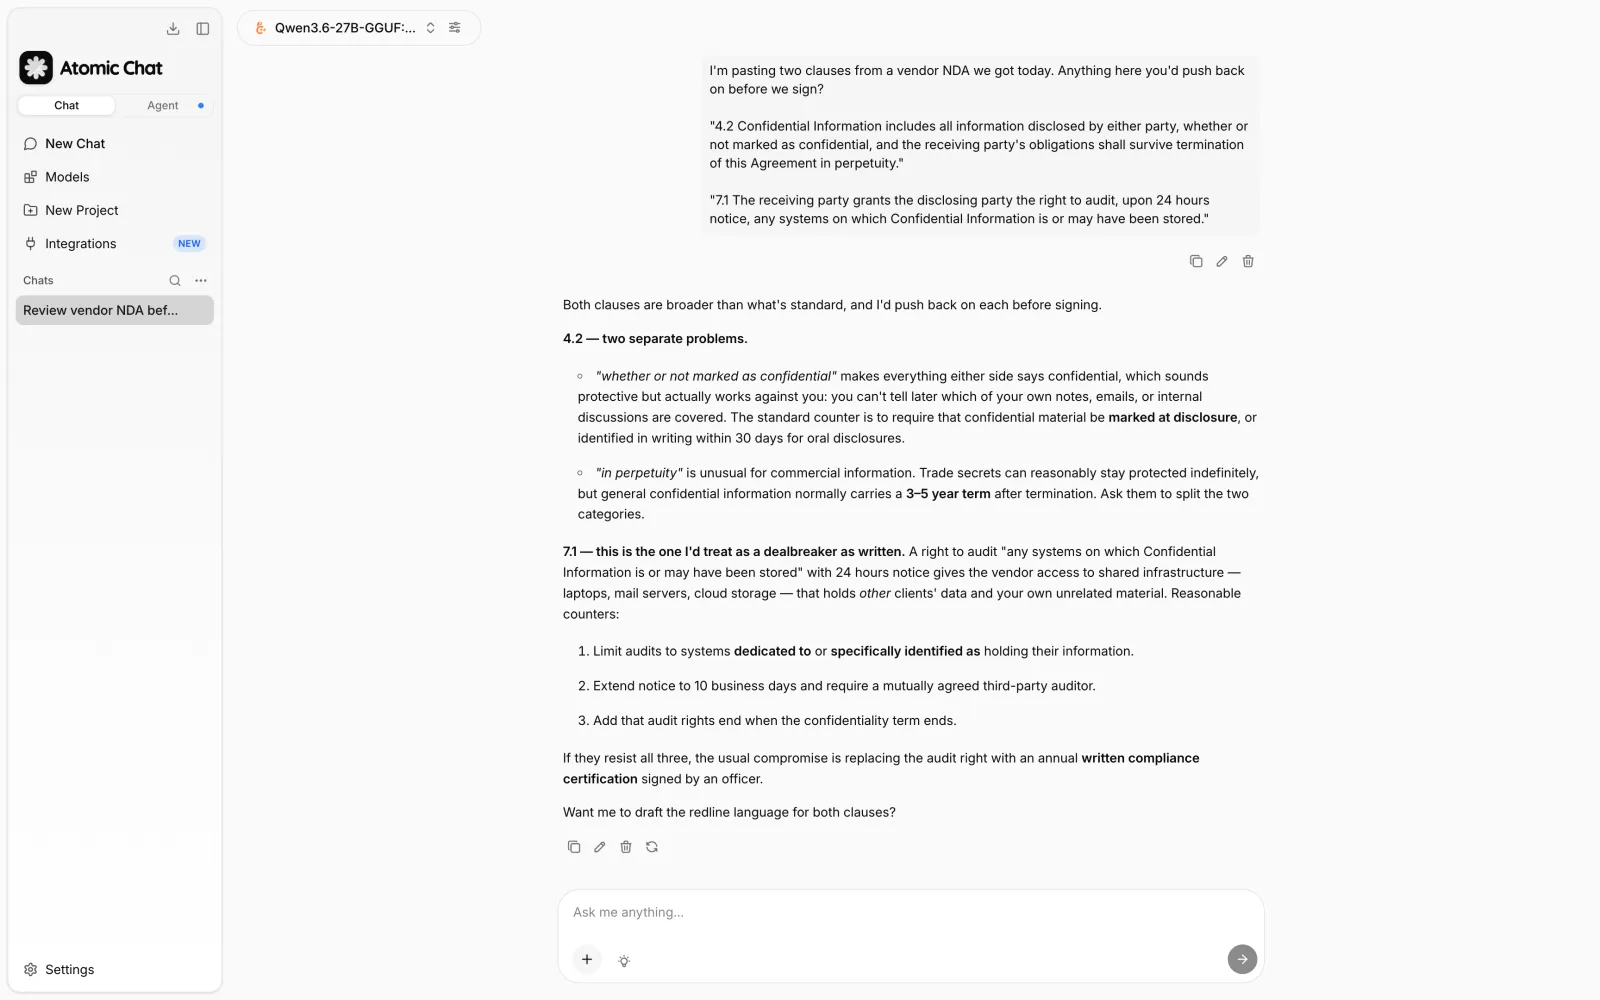
4. 最初のプロンプトを送る
- New Chatを選びます。
- 入力欄の上にあるモデル選択欄がQwen3.6 27Bになっていることを確認します。
- “Ask me anything...”にプロンプトを入力して送信します。
これで、Qwen3.6 27Bのモデル選択欄の下、同じスレッドにモデルの応答が表示されます。
5. 対応する高速化機能を有効にする
これは任意ですが、ハードウェアが対応していれば、特に長いコンテキストでの推論が速くなります。
インストール中に、Atomic Chatでランタイムを選ぶ選択肢が表示されました。
| 選択肢 | 使われるランタイム |
|---|---|
| Find optimal backend | Atomic Chatがダウンロードした、互換性のあるCUDAまたはVulkanバックエンド |
| Skip | 同梱のCPU対応バックエンド |
ランタイムを設定したら、投機的デコーディングを有効にして生成を高速化できます。小さなドラフト用コンポーネントが数トークン先まで予測し、メインモデルがそれを確認する仕組みです。使える方式は、読み込んだモデルによって変わります。
| 方式 | 要件 | Atomic Chatが行う処理 |
|---|---|---|
| DFlash | 対応するターゲットモデル、組み合わせるドラフトGGUF、--spec-type draft-dflashを備えたバックエンド | ドラフトをダウンロードし、Draft quantizationを提供。Atomic ChatのQ8_0を初期選択 |
| MTP | mlx-community/gemma-4の対応するbf16 Gemma 4ターゲット | Gemma 4 31Bまたは26B-A4Bに対応するドラフトヘッドをダウンロード |
| EAGLE-3 | 対応するGemma 4ターゲットと、組み合わせるスペキュレーター | Gemma 4 31Bまたは26B-A4Bに合うスペキュレーターを利用可能にする |
高速化が動くか、次の手順で確認できます。
- 投機的デコーディングなしで、ターゲットモデルがプロンプトに答えることを確認します。
- Atomic Chatが読み込み済みモデルに対応すると表示する方式を一つ有効にします。
- 必要なドラフト用コンポーネントのダウンロードが表示されたら、完了を待ちます。
- 同じプロンプトをもう一度送り、モデルの読み込みエラーなしで生成が完了することを確認します。
6. ローカルのOpenAI互換APIを公開する
Hermes、Cline、OpenClawなど、ほかのツールやAIエージェントをセルフホスト型LLMサーバーにつなぐには、ローカルAPIエンドポイントを使えます。
- Settings → Local API Serverを開きます。
- Default Model Local API Serverで、サーバー起動時に読み込むモデルを選びます。
- ローカル専用の構成では、Server Hostを
127.0.0.1、Server Portを1337のままにします。 - Start Serverをクリックします。
- Server Logsを開き、エラーなしでサーバーが起動したことを確認します。
- 同じコンピューターで、以下のコマンドを使ってデフォルトのベースURL、
http://127.0.0.1:1337/v1を確認します。
curl http://127.0.0.1:1337/v1/models
ローカルサーバーから利用できるモデルを列挙したJSON応答が表示されれば、エンドポイントは動いています。
ほかのエンドポイントを確認したい場合や、リクエストを手書きせずにテストしたい場合は、API Documentation (Swagger UI)を開き、Open Docsをクリックします。現在動作しているサーバーの対話型リファレンスがAtomic Chatから開きます。
別のデバイスからAPIに接続する
デフォルトの127.0.0.1は、Atomic Chatが動くコンピューターからの接続だけを受け付けます。クライアントとAtomic Chatが同じマシンにあるなら、これで十分です。ローカルネットワーク上の別のデバイスから接続したい場合は、次の設定を行います。
- Server Hostをループバックアドレスから、LANの通信を受け付けるホストアドレスに変更します。
- サーバーのLAN IPアドレスまたはホスト名をTrusted Hostsに追加します。
- サーバーを起動する前にAPI Keyを設定します。
- OSのファイアウォールで、選んだポートの通信を許可します。
- ブラウザーベースのクライアントで必要な場合だけ、CORSを有効にします。
これで、上で設定したサーバーアドレス、ポート、APIキーを使って別のデバイスから接続できます。
Trusted Hostsに入るのは、Atomic Chatサーバーにアクセスする際のアドレスやホスト名です。接続を許可するクライアントデバイスの一覧ではありません。意図的にすべてのホスト値を受け付けたい場合を除き、*は使わないでください。
APIキーはエンドポイントへのアクセスを制御しますが、HTTP接続を暗号化するものではありません。別途安全な通信経路を設定していない場合、機密情報の通信は同じコンピューター内か、信頼できるローカルネットワーク内にとどめてください。
起動、タイムアウト、同時実行を設定する
| 設定 | 用途 |
|---|---|
| Auto start | Atomic Chatの起動時にローカルAPIを起動する |
| API Prefix | OpenAI互換ルートの前に付くパスを変更する |
| Request timeout | サーバーがリクエストを終了するまでに、長いモデル応答を許容する |
| Verbose Server Logs | リクエスト失敗の原因を調べるときに、追加の詳細を記録する |
複数のクライアントが同時にモデルを使う場合は、同時実行モードも有効にできます。Atomic Chatはctx_sizeを使用可能なリクエスト枠に分割するため、枠を増やすと各リクエストのコンテキストは減ります。コーディングエージェント一つだけがサーバーを使うなら、枠は一つにして最大のコンテキストウィンドウを確保してください。
7. コーディングエージェント、アシスタント、エディターを接続する
モデルが動いたら、Integrationsからコーディングエージェント、アシスタント、エディターに接続できます。先にチャットでモデルを読み込んでおいてください。そうでなければ、Atomic Chatに“Load a model in a chat first.”と表示されます。
- サイドバーでIntegrationsを開きます。
- 接続したいコーディングエージェント、アシスタント、エディターを選びます。
- クライアントがまだインストールされていない場合は、利用できる選択肢に応じてInstallまたはInstall & Runをクリックします。
- すでにインストールされている場合は、Copy settingsをクリックするか、Manual setupを開き、表示されたローカルサーバー設定をクライアントに追加します。
- 接続したクライアントからテスト用のプロンプトを送ります。
クライアントに応答が表示されれば接続は成功です。Atomic ChatのServer Logsを開いて、リクエストがローカルサーバーを通ったことも確認できます。
Atomic Chatは、対応アプリのうちどれがコンピューターにインストールされているかを確認します。Windowsでは、WSL内のインストールも検出できます。現在の連携先には次のものがあります。
| カテゴリ | 例 |
|---|---|
| コーディングエージェント | Claude Code; Codex CLI |
| アシスタント | Hermes Agent; OpenClaw |
| エディター | VS Code; Zed |
Hermes Agentガイドでは、アシスタントの設定を一通り説明しています。ローカルLLMアプリのガイドでは、Atomic Chatとほかのデスクトップランタイムを比較しています。
セルフホスト型LLMのハードウェア要件
モデルをダウンロードする前に、実行中にコンピューターでどのくらいのメモリを確保できるか確認してください。モデルの重み、推論ランタイム、コンテキストキャッシュが同時に使うため、重みだけで使用可能なメモリをすべて消費するモデルは選ばないでください。
独立GPUを備えたWindowsやLinux PCでは、VRAMがモデルのどの程度をGPUに載せられるかを決めます。Atomic Chatは残りの層をシステムRAMに移せますが、生成は遅くなります。Apple SiliconではCPUとGPUがユニファイドメモリを共有するため、確認するのはMacの総メモリ容量です。
下の表を出発点にしてください。正確な要件はモデル、量子化、コンテキスト長によって変わるため、ある容量に記載されたモデル規模が、すべての構成で必ず収まるわけではありません。
| 総メモリ | 実用的なモデル規模 | 例 |
|---|---|---|
| 8 GB | 2B-4B | Gemma 4 E4B; Qwen3.5 4B |
| 16 GB | 9B-20B | Qwen3.5 9B; Gemma 4 12B; GPT-OSS 20B |
| 32 GB | 27B-35B | Qwen3.6 27B; Gemma 4 31B; Qwen3.6 35B A3B |
| 64 GB | 約120BのMoEの低ビット量子化版 | Ling 3.0 Flash AD-IQ2_M |
| 128 GB以上 | 中規模の最先端MoE | DeepSeek V4 Flash |
この例のQwen3.6 27Bを見ると、量子化でハードウェア要件がどれほど変わるか分かります。278億パラメータのBF16重みには、ランタイムの追加メモリを除いても約55.6 GBが必要です。ダウンロードしたQ4_K_M GGUFは16.5 GBなので、この版なら使用可能なメモリが24-32 GBのシステムで実用的に使えます。
Mixture-of-Expertsモデルには総パラメータ数とアクティブパラメータ数があるため、少し説明が必要です。GPT-OSS 20Bは209億パラメータを含みますが、各トークンで使うのは36億です。Qwen3.6 35B A3Bは、256個のルーティング対象エキスパートのうち8個と、共有エキスパート1個を使います。モデル全体は引き続きメモリに収めるかRAMに移す必要がありますが、アクティブな部分が小さいため生成が速くなります。
コンテキスト長も、KVキャッシュを通じてメモリを使います。256Kや100万トークンに対応するモデルでも、そのウィンドウ全体を有効にする必要はありません。タスクに必要な最小のコンテキストから始め、より長さが必要な場合だけ増やしてください。
2026年におすすめのセルフホスト型LLM
このガイドでは、2026年の主なローカル構成をカバーする六つのセルフホスト型LLMを選びました。16 GBのシステム向けの小型モデル、27Bと31Bのデンスモデル、トークンごとに重みの一部だけを有効にするスパースMoE、大容量メモリのコンピューター向けのLing 3.0 Flashを含みます。
取り上げるのは、Qwen3.6 27Bと35B A3B、Gemma 4 31Bと12B、GPT-OSS 20B、Ling 3.0 Flashです。下の表に基本仕様を示し、続く節で各モデルに向く用途と、開発元が公開したベンチマーク結果を説明します。
| モデル | アーキテクチャ | コンテキスト | 入力モダリティ |
|---|---|---|---|
| Qwen3.6 27B | 27.8B デンス型 | 256K | 公式にはテキスト、画像、動画。このガイドで使うGGUFはテキストのみ |
| Qwen3.6 35B A3B | 総数35B、アクティブ3BのMoE | 256K | テキスト、画像、動画 |
| Gemma 4 31B | 30.7B デンス型 | 256K | テキストと画像 |
| Gemma 4 12B | 11.95B デンス型 | 256K | テキスト、画像、音声、動画 |
| GPT-OSS 20B | 総数20.9B、アクティブ3.6BのMoE | 128K | テキスト |
| Ling 3.0 Flash | 総数124B、アクティブ5.1Bのハイブリッド線形MoE | 256K | テキスト |
Qwen3.6 27B
Qwen3.6 27Bは、64層、262,144トークンのコンテキストウィンドウを持つ27.8Bのデンスモデルです。コーディング、エージェントのワークフロー、長い文書向けに設計されています。公式モデルはテキスト、画像、動画を処理できます。
上の手順では、AtomicChat Qwen3.6 27B GGUFのQ4_K_M量子化版を使います。ダウンロードは16.5 GBで、24-32 GBのシステムでAtomic Chatやコンテキストキャッシュ用のメモリを残せます。このGGUFは、画像や動画に必要な画像プロジェクターがリポジトリに含まれていないため、テキスト専用です。
Qwen3.6 27Bのベンチマーク
以下はQwen3.6 27Bの完全版で測定した結果です。ローカルのQ4_K_M版では、結果が少し異なる場合があります。
| ベンチマーク | スコア |
|---|---|
| SWE-bench Verified | 77.2 |
| SWE-bench Pro | 53.5 |
| Terminal-Bench 2.0 | 59.3 |
| MMLU-Pro | 86.2 |
| GPQA Diamond | 87.8 |
| LiveCodeBench v6 | 83.9 |
Qwen3.6 35B A3B
Qwen3.6 35B A3Bは、総パラメータ数35B、各トークンで有効になるパラメータ数3BのMixture-of-Expertsモデルです。ルーティング対象のエキスパートは256個あり、応答の生成中はそのうち8個と共有エキスパート1個を使います。トークンごとに35Bすべてを実行することなく、大きなパラメータ群を利用できます。
モデルはテキスト、画像、動画を入力できます。ネイティブのコンテキストウィンドウは262,144トークンで、1,010,000トークンまで拡張できます。長いコンテキストほどメモリを使うため、短いウィンドウから始め、非常に長い文書や会話履歴が必要なタスクだけで拡張してください。
Qwen3.6 35B A3Bは、コーディング、マルチモーダルのプロンプト、長いコンテキストのタスクに向いています。ローカルファイルのサイズは配布元や量子化によって異なるため、ハードウェアに合わせて選ぶ前に、Atomic Chatで正確なダウンロードサイズを確認してください。
Qwen3.6 35B A3Bのベンチマーク
| ベンチマーク | スコア |
|---|---|
| SWE-bench Verified | 73.4 |
| SWE-bench Pro | 49.5 |
| Terminal-Bench 2.0 | 51.5 |
| MMLU-Pro | 85.2 |
| GPQA Diamond | 86.0 |
| LiveCodeBench v6 | 80.4 |
Gemma 4 31B
Gemma 4 31Bは、GoogleのGemma 4で最大のデンスモデルです。30.7Bパラメータ、256Kのコンテキストウィンドウ、画像入力用の独立した画像エンコーダーを備えています。テキストと画像を入力し、テキストを生成します。
Gemma 4 31Bは、文書分析、画像理解、コーディング、一般的なチャットに役立ちます。31Bのデンスモデルなので、ランタイムとコンテキストキャッシュ用のメモリを十分に残せる量子化版を選んでください。対応ビルドでは、ステップ5で説明したDFlash、MTP、EAGLE-3による高速化も使えます。
Gemma 4 31Bのベンチマーク
| ベンチマーク | スコア |
|---|---|
| MMLU-Pro | 85.2% |
| AIME 2026、ツールなし | 89.2% |
| LiveCodeBench v6 | 80.0% |
| Codeforces Elo | 2150 |
| GPQA Diamond | 84.3% |
Gemma 4 12B
Gemma 4 12Bは、256Kのコンテキストウィンドウを持つ11.95Bモデルです。テキスト、画像、音声、動画を入力し、テキストを生成します。Gemma 4 31Bと異なり、12B版は独立したモダリティエンコーダーを使わずにこれらを処理します。
サイズが小さいため、マルチモーダル入力が必要な16 GBクラスのコンピューターでは、Gemma 4 12Bが第一候補としてより適しています。画像や文書の分析、音声の文字起こし、動画理解、一般的なテキスト処理に使えます。使いたい入力形式に必要な付属ファイルが、ローカルビルドに含まれていることを確認してください。
Gemmaのローカル実行ガイドでは、ダウンロードするファイルとAtomic Chatへの読み込み方を説明しています。
Gemma 4 12Bのベンチマーク
| ベンチマーク | スコア |
|---|---|
| MMLU-Pro | 77.2% |
| AIME 2026、ツールなし | 77.5% |
| LiveCodeBench v6 | 72.0% |
| Codeforces Elo | 1659 |
| GPQA Diamond | 78.8% |
GPT-OSS 20B
GPT-OSS 20Bは、OpenAIの小さいほうのオープンウェイト推論モデルです。総パラメータ数は20.9B、各トークンでアクティブになるのは3.6Bで、128Kのコンテキストウィンドウに対応します。テキスト専用で、ネイティブのMXFP4重みを使います。
OpenAIはメモリ16 GBで動くように設計しており、この一覧では推論、コーディング、ツール使用向けに比較的導入しやすい選択肢です。回答にどのくらい時間をかけるかに応じて、推論強度をlow、medium、highから選べます。
推論強度は結果に明確な影響を与えます。OpenAIが報告したSWE-bench Verifiedのスコアは、lowで37.4、mediumで53.2、highで60.7です。Atomic Chatでの設定は、GPT-OSSのローカル実行ガイドで説明しています。
GPT-OSS 20Bのベンチマーク
以下はOpenAIのGPT-OSSモデルカードの表3から引用した、推論強度highの結果です。
| ベンチマーク | 公式スコア、推論強度high |
|---|---|
| AIME 2024、ツールなし | 92.1 |
| AIME 2025、ツールなし | 91.7 |
| GPQA Diamond、ツールなし | 71.5 |
| HLE、ツールなし | 10.9 |
| MMLU | 85.3 |
| SWE-bench Verified | 60.7 |
| Aider Polyglot | 34.2 |
| MMMLU平均 | 75.7 |
推論強度を下げると応答は速くなりますが、この表のスコアには届きません。
Ling 3.0 Flash
Ling 3.0 Flashは、各トークンで5.1Bパラメータを有効にする124BのMixture-of-Expertsモデルです。ルーティング対象のエキスパートは512個あり、そのうち8個と共有エキスパート1個を使います。コンテキストウィンドウは最大256Kトークンです。コーディング、数学的推論、長いコンテキストのタスク向けに作られています。
AtomicChatのLing 3.0 Flash GGUFにはTurboQuantが必要です。64 GBのシステムでは、49.1 GBのAD-IQ2_Mが実用的な選択肢ですが、この圧縮レベルでは品質が下がり始めます。AD-IQ3_Mは品質が上がるものの62.2 GBあるため、ファイル本体に加えて、Atomic Chatとコンテキストキャッシュ用のメモリが必要です。
Lingは、このガイドのほかのモデルより多くのメモリと設定が必要ですが、トークン当たり5.1Bパラメータだけを有効にしながら、はるかに大きなモデルを利用できます。
Ling 3.0 Flashのベンチマーク
これらはLing 3.0 Flashの完全版を測定した結果です。
| ベンチマーク | 公式スコア |
|---|---|
| SWE-bench Pro | 56.6 |
| SWE-bench Multilingual | 72.4 |
| Terminal-Bench 2.1 | 57.0 |
| LiveCodeBench、2024-08から2025-05 | 82.8 |
| AIME 2026 | 93.2 |
| HLE | 22.7 |
| MRCR 128K | 90.8 |
| MRCR 256K | 81.1 |
よくある質問
セルフホスト型LLMの実行について、よくある質問に簡潔に回答します。
最適なセルフホスト型LLMはどれですか?
24-32 GBのコンピューターなら、Qwen3.6 27BのQ4_K_M量子化版が、コーディングや一般的なテキスト処理の出発点として適しています。GPT-OSS 20Bは16 GBのシステムでのテキスト推論向けで、Gemma 4 12Bには画像、音声、動画の入力もあります。Ling 3.0 Flashは、49.1 GBの量子化版を読み込んでも、ランタイム用に十分なメモリが残る大容量システム向けの選択肢です。
自分のコンピューターでLLMを実行できますか?
はい。8 GBのコンピューターでは、小型の2B-4B量子化モデルを実行できます。16 GBなら9B-20Bまで広げられ、24-32 GBあればこのガイドで使ったQwen3.6 27BのQ4_K_M版に十分です。OS、Atomic Chat、コンテキストキャッシュ用に空きメモリを残してください。
セルフホスト型LLMにはどのくらいのRAMが必要ですか?
モデルの重み、推論ランタイム、コンテキストキャッシュを同時に保持できるメモリを確保してください。大まかな目安は、2B-4Bモデルで8 GB、9B-20Bモデルで16 GB、Qwen3.6 27BのQ4_K_Mなど、量子化した27Bモデルで24-32 GBです。コンテキストを長くすると、追加のメモリが必要になります。
セルフホスト型LLMはプライベートですか?
モデルとランタイムの両方がコンピューター内にとどまるなら、はい。モデルのダウンロード後、Atomic Chatは通常のチャットを、モデル開発元にプロンプトを送らず処理できます。ただし、次を使う場合はデータがコンピューターの外に出ることがあります。
- リモートのモデルプロバイダー。
- ウェブ検索。
- MCPツールや拡張機能。
- 外部サービスを呼び出すよう設定されたAPIクライアント。
機密データを使う前に、接続する各ツールのネットワーク動作を確認してください。Atomic ChatのAPIを127.0.0.1の外に公開する場合は、API KeyとOSのファイアウォールで保護してください。
コーディングに最適なセルフホスト型LLMはどれですか?
24-32 GBのシステムでは、Qwen3.6 27Bがコーディングやエージェントのワークフローに適しています。このガイドのQ4_K_M量子化版は16.5 GBで、Atomic Chatを通じてCodex CLI、Claude Code、VS Code、Zedに接続できます。16 GBのシステムには、より小型のGPT-OSS 20Bという選択肢があります。
ローカルLLMとセルフホスト型LLMの違いは何ですか?
ローカルLLMは、使っているコンピューター上で直接動きます。セルフホスト型LLMは自分が管理するハードウェアで動き、それは自分のコンピューター、LAN上のワークステーション、プライベートサーバーのいずれでも構いません。ノートPC上のモデルはローカルでもセルフホストでもあります。自分のリモートサーバーで動くモデルはセルフホストですが、使用中のデバイスに対してローカルではありません。
セルフホスト型LLMにはGPUが必要ですか?
いいえ。Atomic Chatは同梱のCPU対応バックエンドでもモデルを動かせますが、生成は遅くなります。対応するNVIDIAやAMDのGPU、またはVulkan対応のほかのGPUがあれば、モデルのより多くの部分をGPUで処理し、生成速度を上げられます。Apple SiliconではCPUとGPUが同じユニファイドメモリを使います。
まとめ
Atomic Chatでは、モデルのダウンロード、ローカル実行、ほかのアプリへの接続を一か所で行えます。このガイドでは、メモリ24-32 GBのコンピューターで動くQwen3.6 27BのQ4_K_M量子化版を使いました。ハードウェアが異なる場合は、上のハードウェア表とモデル別の節を参考に、小さいモデルや大きいモデルを選んでください。その上で、必要に応じて高速化、ローカルAPI、連携を有効にします。




