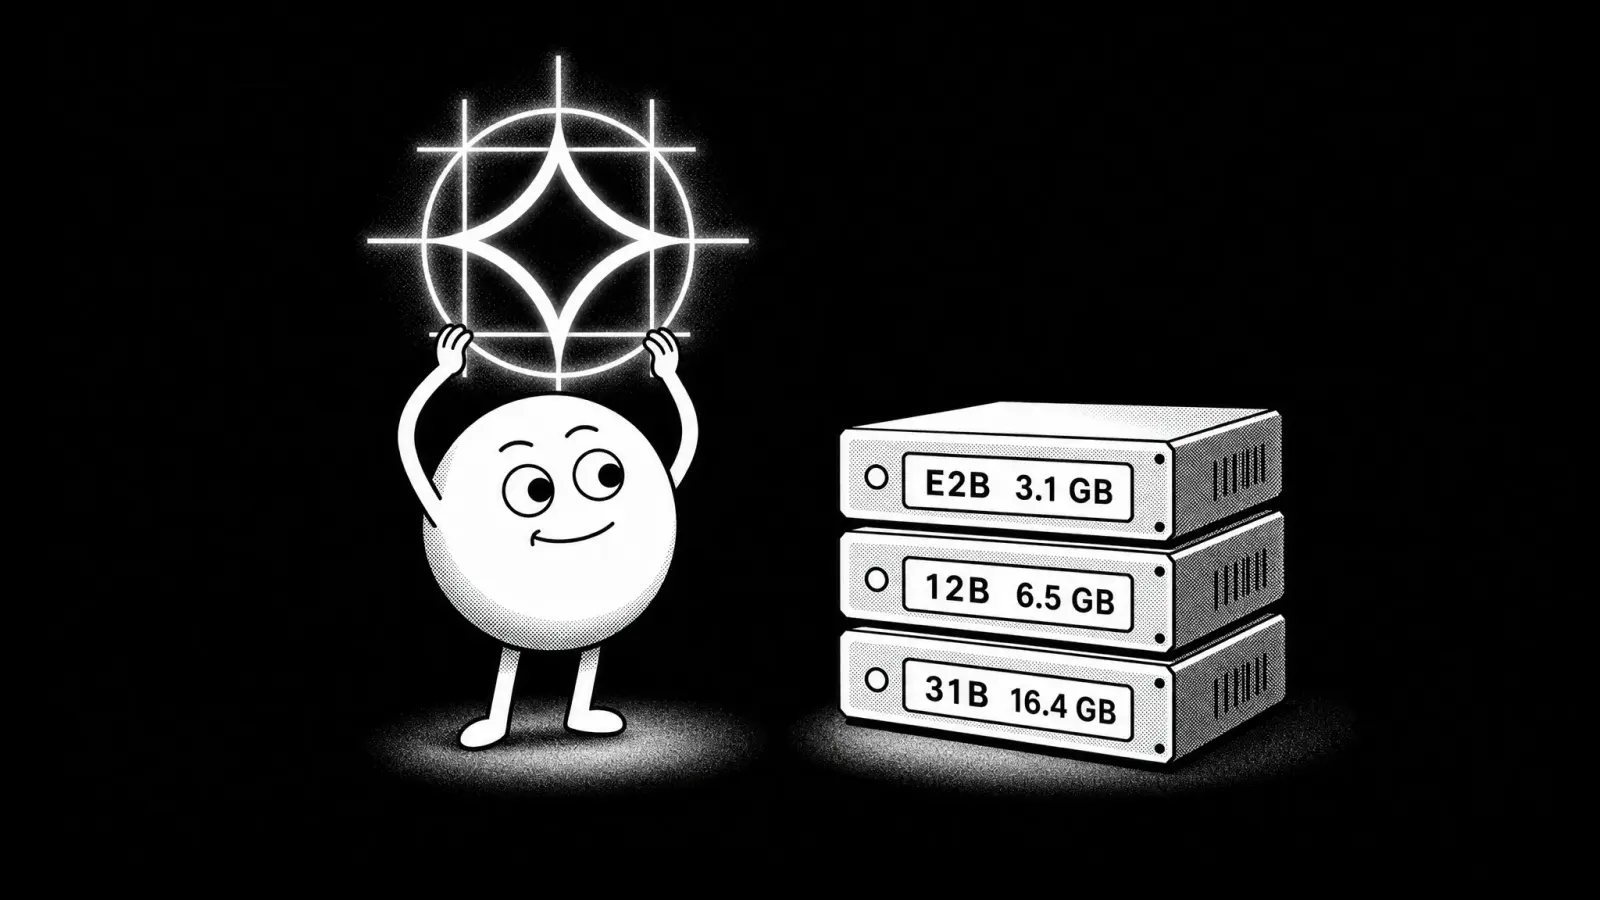


Gemma 4は、ダウンロードして自分のマシンで実行できる、GoogleのオープンウェイトAIモデルファミリーです。さらに、Gemmaには、個人のマシンへのローカル導入に適した、最適化済みのモデルが複数あります。
モデルのローカル実行が初めてなら、この記事は入門に適しています。次の方法を学べるためです。
- ローカルモデルを実行できる推論エンジンをインストールする
- Hugging FaceでGemma 4モデルを探してダウンロードする
- ハードウェアに合ったGemmaモデルを選ぶ
- どのGGUF量子化をダウンロードすべきかを理解する
- Gemmaとのチャットをローカルで始める
Gemma 4とは?
Gemma 4は、2026年3月にリリースされたGoogle DeepMindのオープンモデルファミリーです。Gemma 4モデルには、次のサイズがあります。
- E2B
- E4B
- 12B
- 26B A4B
- 31B
2から31までの数字は、10億単位のパラメータ数を表しています。すべてのGemmaモデルはネイティブにマルチモーダルに対応しており、テキストと画像を処理できます。E2B、E4B、12Bは音声と動画の入力も処理できるため、録音した音声を入力として送ったり、質問を音声で伝えてGemmaに回答してもらったりできます。
E2BとE4Bの「E」は、実効パラメータを意味するeffectiveの略です。これらのモデルはPer-Layer Embeddingsを使い、各パラメータからより多くの能力を引き出しているためです。26B A4Bの「A4B」は、トークンごとに40億のパラメータだけを有効化するMixture-of-Expertsモデルであることを示しています。ただし、260億のパラメータすべてをメモリに読み込む必要があります。
Gemma E2BとE4Bのコンテキスト長は128Kで、12B、26B A4B、31Bのコンテキスト長は256Kです。
Gemmaをローカルで実行する方法
Gemmaとは何か、どのようなモデルがあるかを大まかに把握できたところで、セットアップの手順を見ていきましょう。
Gemmaを実行するには、ローカルAIアプリが必要です。これは、モデルをダウンロードし、ローカルで実行するための推論エンジンを提供するソフトウェアです。このチュートリアルでは、私たちが開発した無料のオープンソースのローカルAIアプリ、Atomic Chatを使いますが、Ollama、Jan、LM StudioでもGemmaを実行できます。
OllamaやLM StudioでGemmaを実行したい場合は、OllamaとLM Studioの比較をお読みください。
ステップ1:Atomic Chatをインストールする
atomic.chatにアクセスし、お使いのプラットフォーム向けのビルドを選びます。
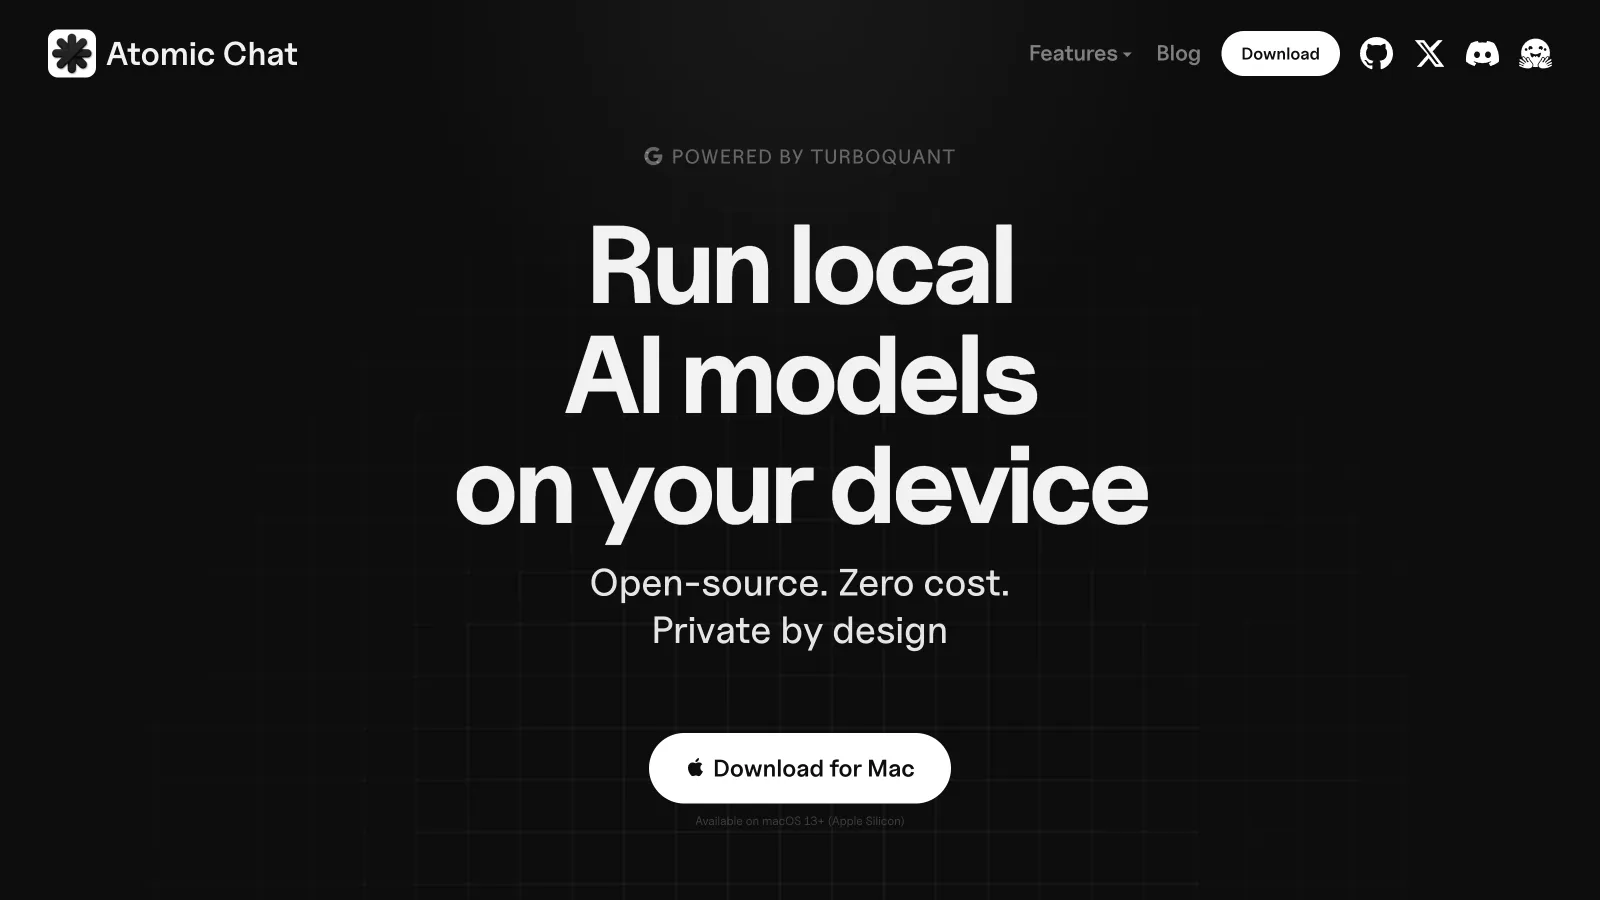
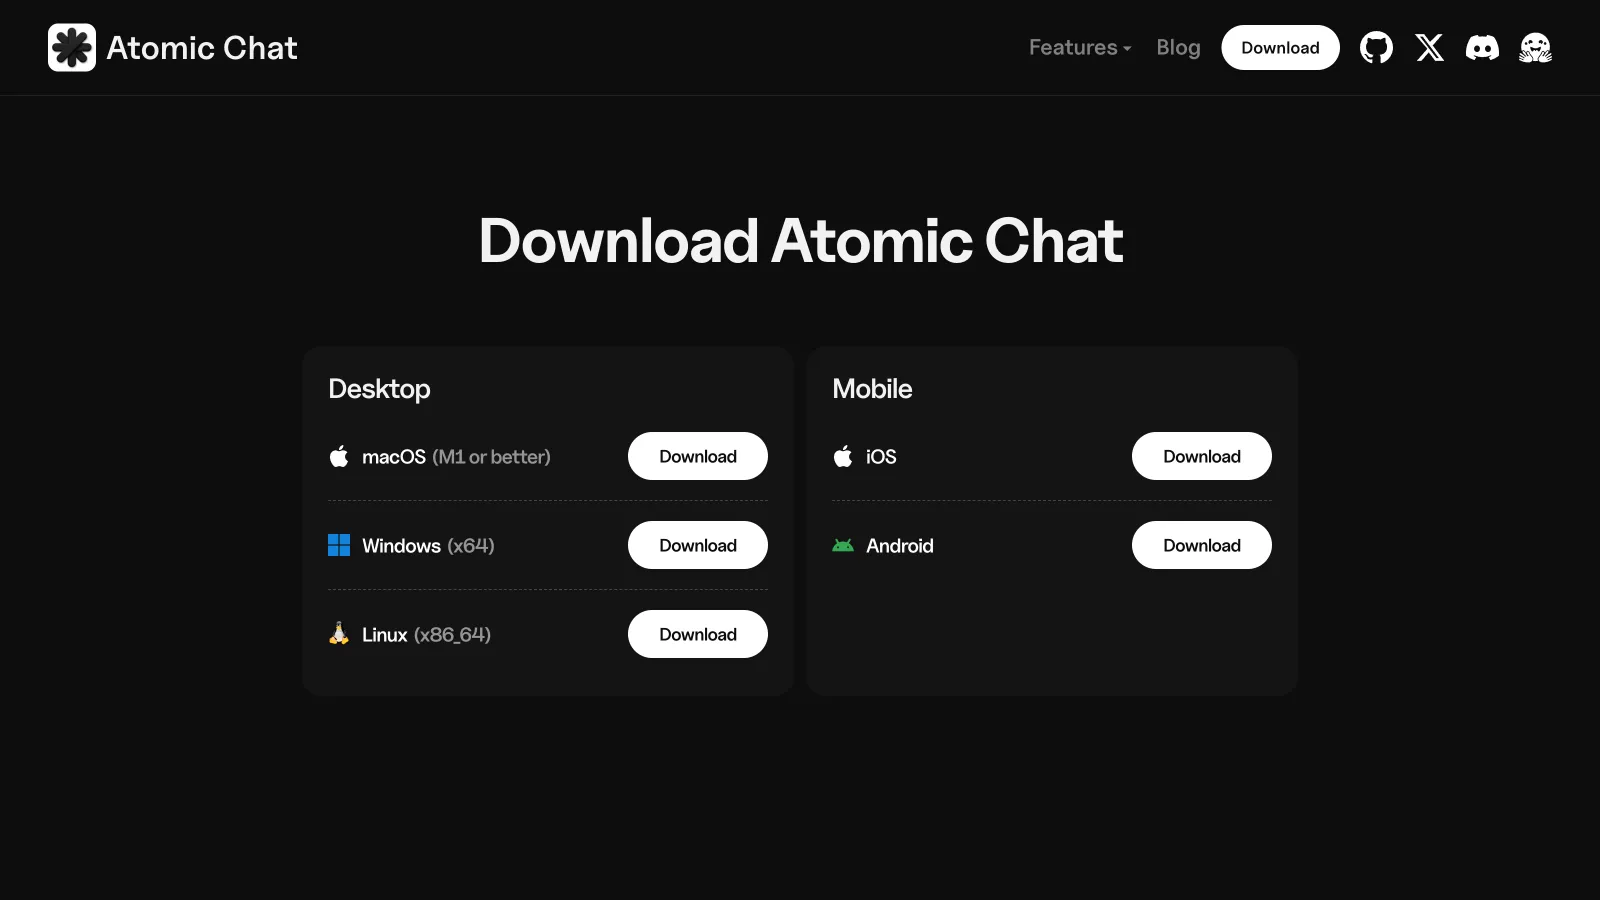
Atomic Chatをインストールする方法は5つあります。
- macOS:Apple Silicon(M1以降)向けのユニバーサル
.dmg。 - Windows:x64向けの
.exeインストーラー。 - Linux:root権限が不要な、x86_64向けの自己完結型
.AppImage。 - iOS:App Storeからインストール。
- Android:Google Playからインストール。
Linuxでは、chmod +xでAppImageに実行権限を付与し、そのまま実行します。初回起動時にアプリからFUSEについての案内が表示された場合は、DebianまたはUbuntuではsudo apt install fuse libfuse2、Fedoraではsudo dnf install fuse fuse-libsでインストールします。
ステップ2:モデルカタログでGemmaを探す
Atomic Chatのインストールが完了したら、Modelsタブを開きます。このタブには、ローカルモデルの最大のリポジトリであるHugging Faceのオープンウェイトモデルがすべて表示されます。検索欄にgemmaと入力します。
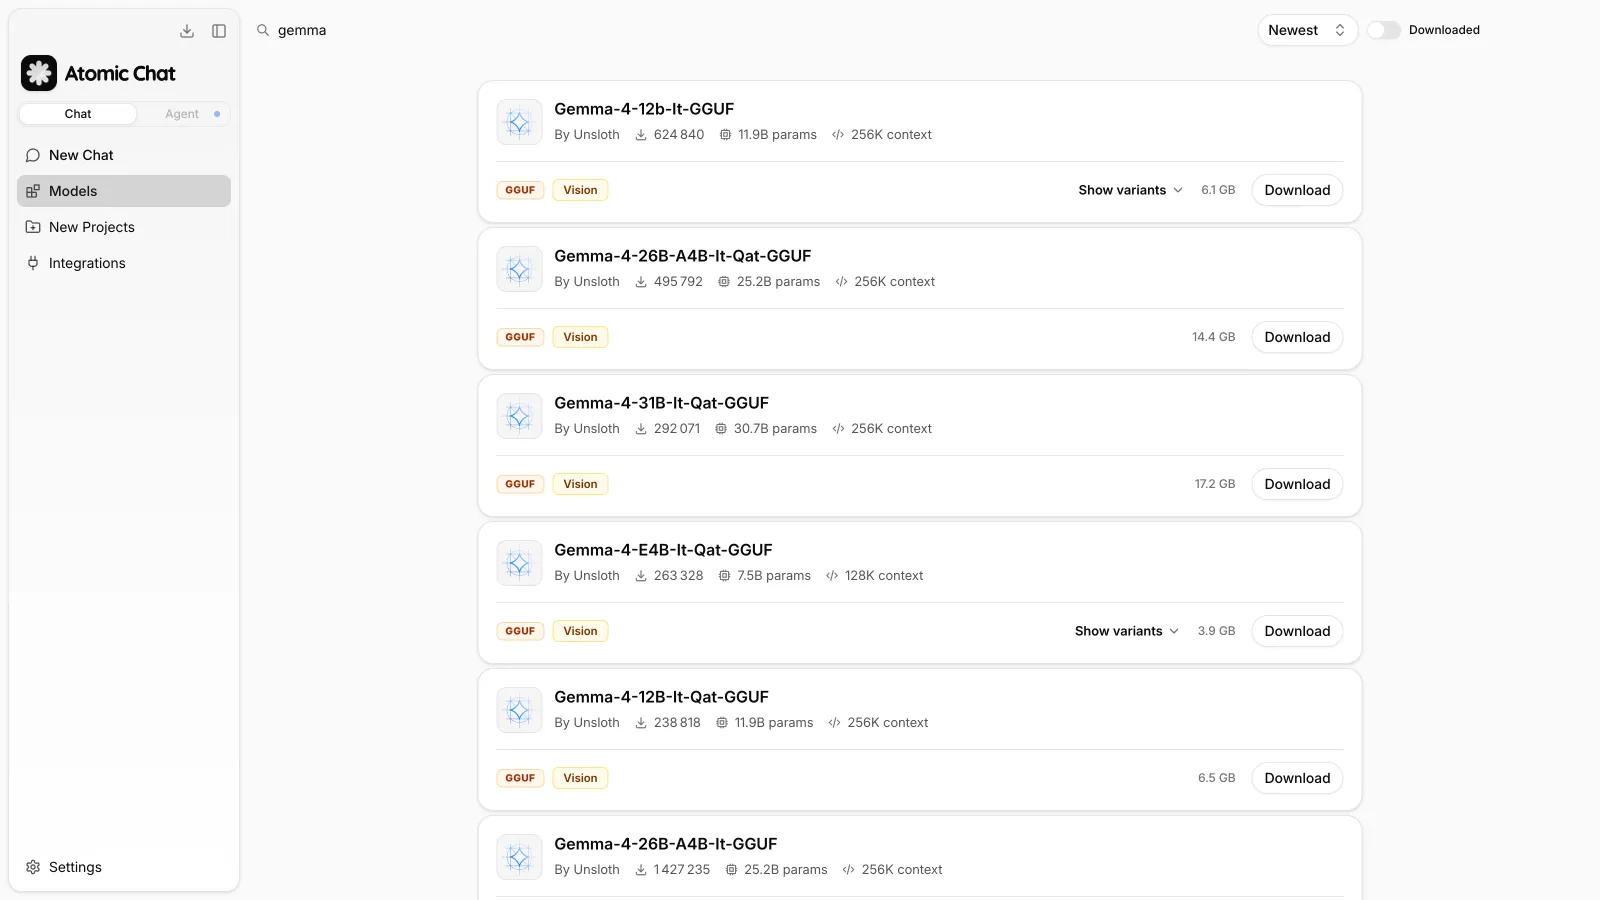
Gemmaモデルの一覧が表示され、各項目には次の情報が示されます。
- パラメータ数:たとえば、Gemma 4 12Bなら11.9Bです。
- コンテキスト長:中規模モデルと大規模モデルでは256Kです。
- タグ:ファイル形式を示す
GGUFに加え、画像を読み取れるモデルにはVisionが付きます。 - ダウンロードサイズ:ディスクに保存されるファイルのサイズです。
検索結果はデフォルトで新しい順に並び、Downloadedトグルを使うと、すでにダウンロード済みのモデルだけに絞り込めます。
ステップ3:Gemma 4モデルをダウンロードする
Downloadをクリックするとデフォルトのファイルをダウンロードできます。Download Optionsを開くと、そのモデルのすべての量子化と、それぞれの正確なサイズを確認できます。
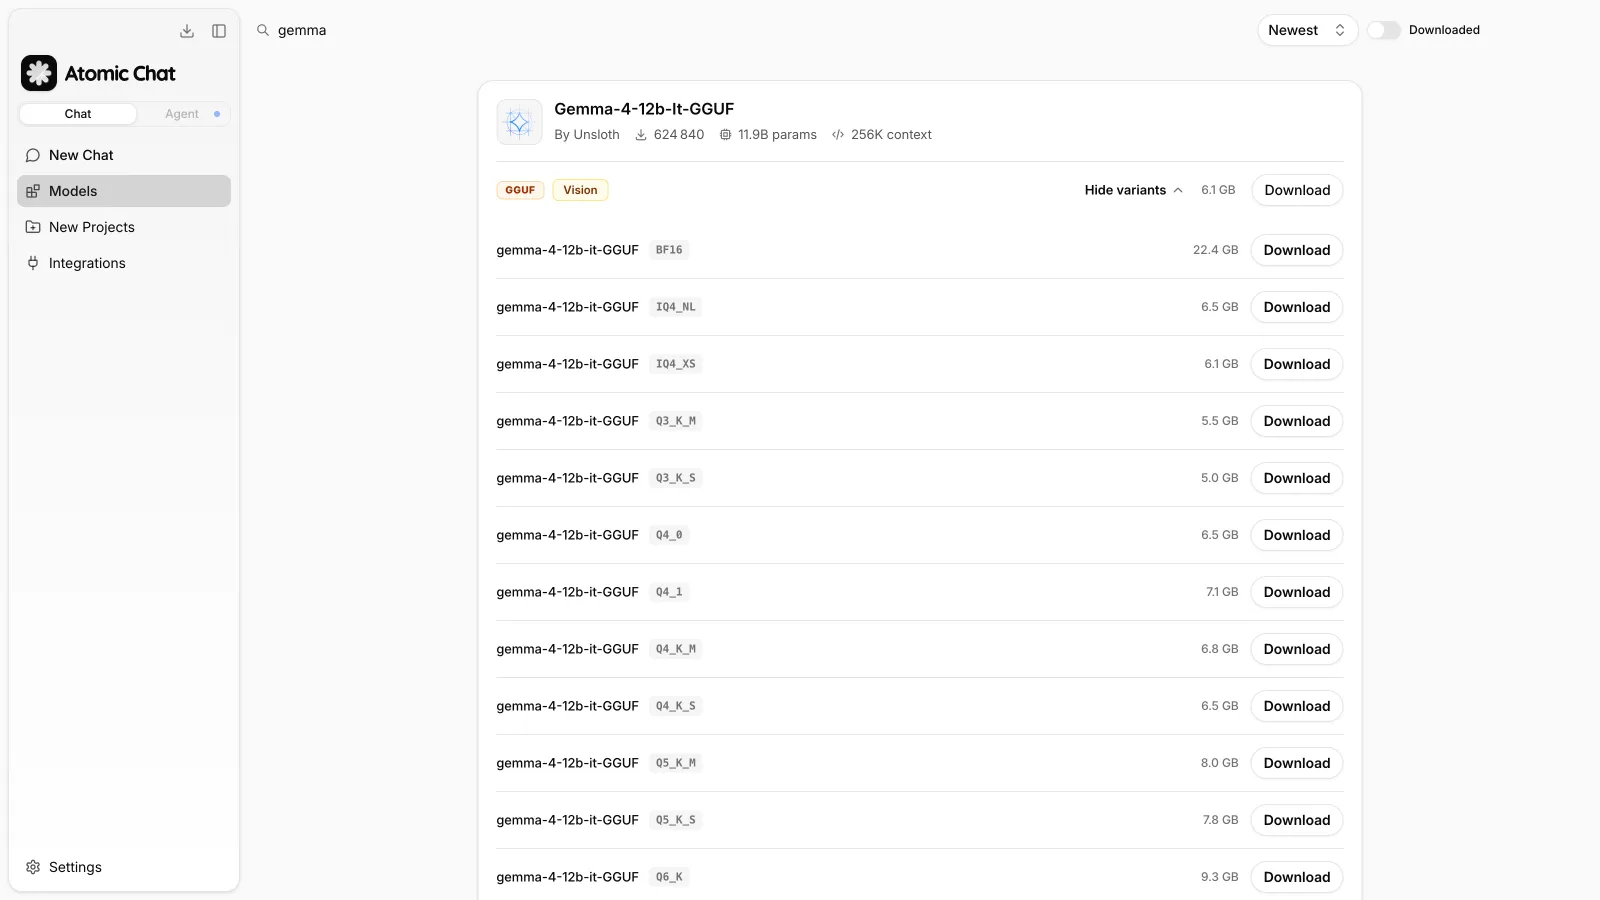
たとえば、Gemma 4 12Bでは、5.0 GBのQ3_K_S、6.8 GBのQ4_K_M、22.4 GBのBF16といったバリエーションが表示されます。
これらの意味や、同じモデルに大きく異なるサイズのファイルがある理由がわからない場合は、GGUFと量子化の解説をお読みください。この記事の後半では、ハードウェアに合ったモデルサイズの選び方も説明します。
ステップ4:Gemmaとローカルでチャットする
Atomic ChatはGemmaモデルを自動的にローカルで実行し、モデルとやり取りするためのチャットインターフェースを内蔵しているため、すぐに使い始められます。
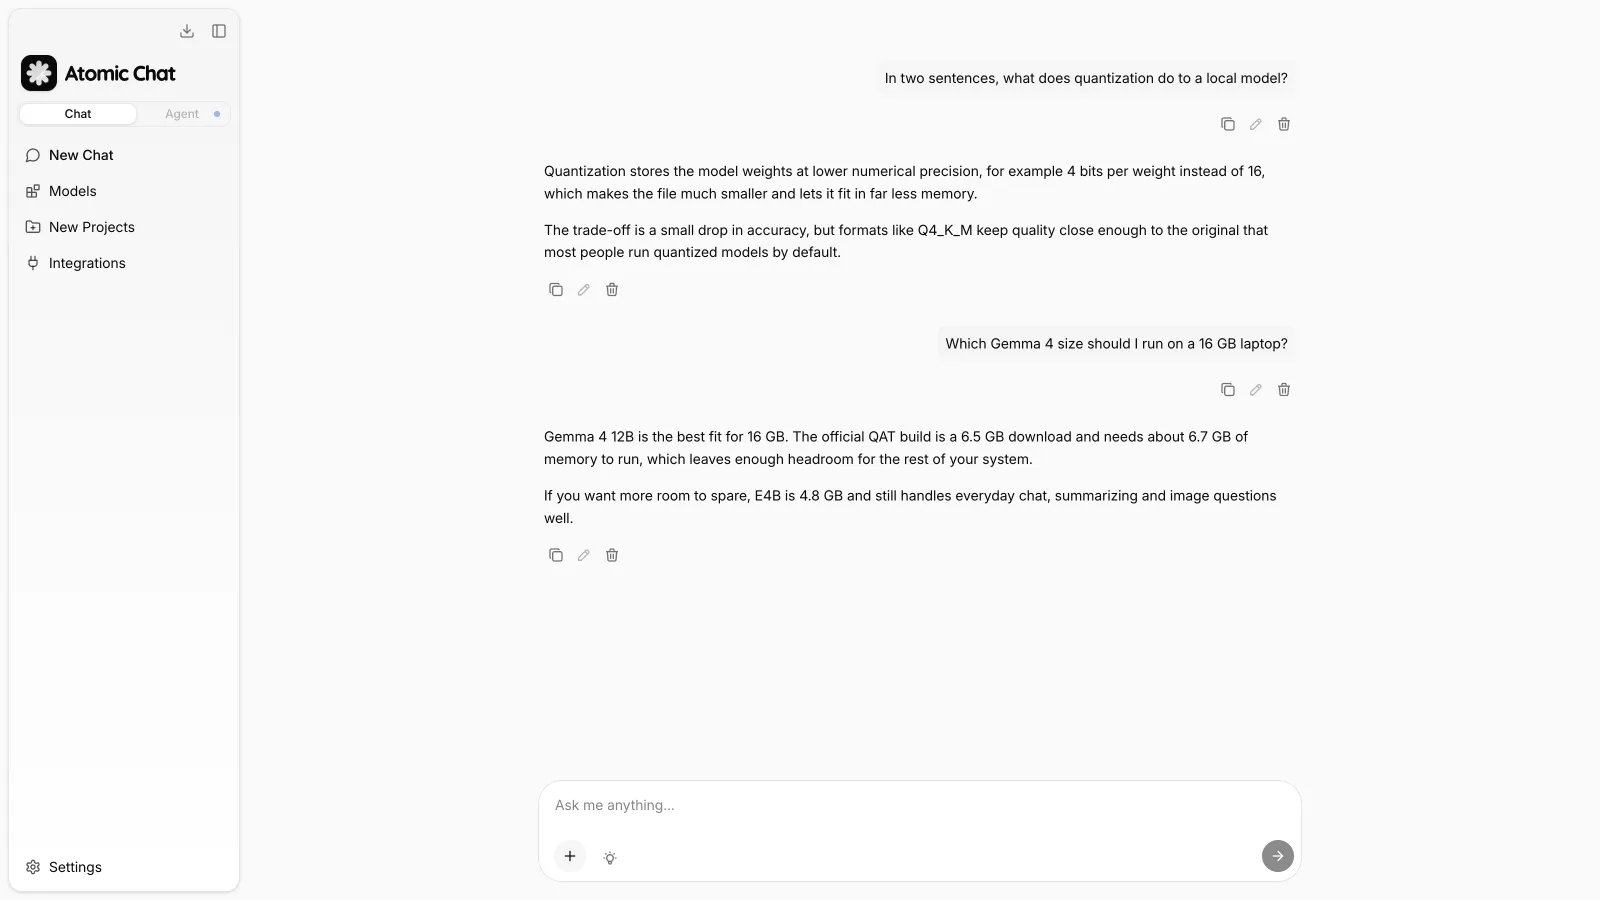
Gemma 4はマルチモーダルに対応しているため、画像を添付してその内容について質問できます。また、E2B、E4B、12Bモデルは音声入力にも対応しています。
モデルはローカルで動作するため、利用制限なしで、オフラインかつ無料で使えます。チャットのプライバシーも完全に保たれます。
Gemma 4のハードウェア要件
Googleは、モデルと精度ごとに必要なメモリ容量を公開しています。以下の表は、システムプロセス用の約20%のオーバーヘッドを含め、4ビットと16ビットの精度でモデルを実行するために必要なメモリ容量を示しています。
| モデル | ダウンロードサイズ(QAT q4_0) | 実行に必要なメモリ(4ビット) | BF16で必要なメモリ |
|---|---|---|---|
| E2B | 3.1 GB | 2.9 GB | 11.4 GB |
| E4B | 4.8 GB | 4.5 GB | 17.9 GB |
| 12B | 6.5 GB | 6.7 GB | 26.7 GB |
| 26B A4B | 13.4 GB | 14.4 GB | 57.7 GB |
| 31B | 16.4 GB | 17.5 GB | 69.9 GB |
Macでは、モデルがシステム全体とユニファイドメモリを共有するため、マシンに搭載されているメモリ容量に合わせてモデルを選びます。
| Mac | ユニファイドメモリ | 実行するモデル |
|---|---|---|
| MacBook Air M1, M2, M3(基本構成) | 8 GB | E2BのQ4 |
| MacBook Air M4, MacBook Pro M4(基本構成) | 16 GB | 12BのQ4 |
| MacBook Pro M4 Pro | 24 GB | 12BのQ5、または26B A4BのQ4 |
| MacBook Pro M4 Pro, M4 Max | 32 GB | 26B A4Bまたは31BのQ4 |
| MacBook Pro M4 Max, Mac Studio | 48 GB以上 | 31BのQ6_KまたはQ8_0 |
単体GPUを搭載したWindowsまたはLinuxマシンでは、重要なのはVRAMです。最高速度で実行するには、モデルがVRAMに収まる必要があるためです。
| GPU | VRAM | 実行するモデル |
|---|---|---|
| RTX 3050、ノートPC向けRTX 4060 | 8 GB | E2BのQ4 |
| RTX 4060 Ti, RTX 5060 Ti | 16 GB | 12BのQ4 |
| RTX 3090, RTX 4090 | 24 GB | 12BのQ5、または26B A4BのQ4 |
| RTX 5090 | 32 GB | 26B A4Bまたは31BのQ4 |
| RTX 6000 Ada、デュアルGPU構成 | 48 GB以上 | 31BのQ6_KまたはQ8_0 |
モデルがVRAMに収まらない場合、収まらない部分はシステムRAMに配置され、生成速度が大幅に低下します。この場合は、モデルのサイズを1段階下げることをおすすめします。
次の点にも注意してください:上記の数値は重みのみを対象としているため、最低システム要件の目安として扱うのが適切です。会話内の各トークンもKVキャッシュとしてメモリにキャッシュされ、チャットが長くなるほどキャッシュも大きくなります。長い文書やコードベースを入力してGemmaの上限である256Kに近づくと、モデルに加えて数GBのメモリが必要になることがあります。
長い文書を扱う場合は、KVキャッシュの分を見込み、モデルサイズか量子化の精度を1段階下げてください。16 GBのマシンなら、12BをQ5ではなくQ4で実行するということです。
ほとんどの人にとって、Gemma 4 12Bが第一候補です。実務に対応でき、多くのノートPCに搭載されている16 GBのメモリにも収まるためです。32 GBのメモリがあれば、Gemma 4 31Bに移行する価値があります。ファミリーで最も高性能なモデルであり、量子化の精度を上げたときの恩恵も最も大きいためです。Gemma 4 E2Bは読み込みが速く、簡単な調べものに素早く答えられるため、高性能なハードウェアでも役立ちます。
Gemma 4のGGUF量子化はどれをダウンロードすべき?
量子化は、モデルの重みを低い精度で保存することで、ファイルサイズと必要なメモリ容量を小さくします。たとえば、Q4_K_Mは重みあたり4ビット、Q8_0は8ビットで保存し、BF16は非圧縮のオリジナルです。GGUFガイドでは、命名規則をさらに詳しく解説しています。
特にGemma 4では、QATビルドを探してください。Googleはこれらに量子化を考慮した学習を用いています。学習中に4ビットの丸め誤差をシミュレートすることで、圧縮に耐えられる重みをモデルに学習させます。その結果、メモリ使用量を約72%削減しながら、通常の学習後量子化よりも元のモデルにかなり近い品質を維持できます。たとえば、Googleの31B QATビルドは約18 GBで動作しますが、フル精度のモデルには58 GBが必要です。
使いたいモデルにQATビルドがない場合は、Q4_K_Mが信頼できる標準的な選択肢です。メモリに余裕があれば、Q5_K_MやQ6_Kに引き上げることもできます。
もう1つ覚えておきたいのは、圧縮率の高い大規模モデルのほうが、精度の高い小規模モデルよりも良い結果を出すことが多いという点です。そのため、精度を1段階下げることで、よりパラメータ数の多いモデルをメモリに収められるなら、通常はそうする価値があります。
どのファイルをダウンロードすべきか迷ったら、QATリリースがあればそれを選んでください。なければ、ほとんどのシステムではQ4_K_Mが最も無難な標準の選択肢です。
Gemma 4のベンチマーク
以下の表は、ベンチマークにおけるGemma 4とGemini 3 Flashの比較を示しています。
| モデル | MMLU Pro | GPQA Diamond | ローカル実行 |
|---|---|---|---|
| Gemma 4 E4B | 69.4% | 58.6% | 可能 |
| Gemma 4 12B | 77.2% | 78.8% | 可能 |
| Gemma 4 26B A4B | 82.6% | 82.3% | 可能 |
| Gemma 4 31B | 85.2% | 84.3% | 可能 |
| Gemini 3 Flash | — | 90.4% | 不可 |
MMLU Proは、さまざまな学問分野にわたる推論能力を測定します。GPQA Diamondは、暗記した事実だけでは答えられない博士課程レベルの科学の問題を出題します。
Googleは、スマートフォンやエッジデバイス向けに開発されたE2Bのベンチマークスコアを公開していないため、ここでは省略しています。
Gemma 4 31Bのベンチマーク性能は、2〜3世代前の中規模クラウドモデルをやや下回ります。これは想定どおりです。オンデバイスAIは常にクラウドAIよりも性能が低くなりますが、それでもGemma 4 12B以上のモデルは実際のコーディングワークフローに利用でき、自動化やチャットには十分すぎるほどの能力があります。
OllamaとLM StudioでGemma 4を実行する方法
Gemma 4をローカルで実行する方法はAtomic Chatだけではなく、上で紹介したGGUFファイルはほかのアプリでも同じように使えます。OllamaはコマンドラインからGemmaを実行できるため、スクリプトでの利用や、ほかのツールにモデルを提供する用途に適しており、1つのコマンドでモデルを取得できます。LM Studioは、モデルの調整を中心に据えたデスクトップインターフェースを備え、モデルごとにパラメータを設定できます。
トレードオフになるのは、モデルを取り巻く機能です。Ollamaには独自のインターフェースがないため、ターミナルを使うか、別のフロントエンドを接続する必要があります。また、LM Studioはデスクトップ専用で、モバイル版はありません。
どちらを使うか迷っている場合は、OllamaとLM Studioの比較で両者を直接比較しています。おすすめのOllama代替ツール10選ではより幅広い選択肢を取り上げ、Ollamaとllama.cppの比較では両者が共通して使うエンジンを解説しています。
よくある質問
自分のハードウェアでGemma 4を実行する際によくある質問です。
Gemma 4のシステム要件は?
Gemma 4はほとんどの最近のコンピューターで実行でき、主な制約は利用可能なメモリ容量です。最小モデルのE2Bは、4ビット量子化版で約2.9 GBを必要とするため、8 GBのRAMを搭載したシステムに適しています。12Bモデルは約6.7 GBを使用するため、16 GBのマシンに適しています。最大の31Bモデルは4ビット形式で約17.5 GBを必要とし、32 GBのメモリを搭載したシステムで最も余裕を持って動作します。GPUがあれば生成速度は目に見えて向上しますが、必須ではありません。GemmaはシステムRAMを使い、CPUだけで実行することもできます。
スマートフォンでGemma 4を実行できますか?
はい。GoogleはE2BとE4Bモデルを、特にスマートフォンやそのほかのエッジデバイス向けに設計しました。モバイル対応版のE2Bは約1 GBしかなく、ローカルで実用的に使えます。さらに、Atomic ChatはiOSとAndroidの両方で利用できるため、対応するGemmaモデルをダウンロードし、インターネット接続に頼らずデバイス上で直接使えます。
Gemma 4は無料で使えますか?
はい。Gemma 4は商用利用を認めるGoogleのGemma 4ライセンスの下で配布されており、公式モデルの重みはすべてHugging Faceから無料でダウンロードできます。Atomic Chatでモデルをローカル実行する場合、サブスクリプション料金、API料金、利用制限はありません。
Gemma 4とGemma 3の違いは?
Gemma 4は、前世代を単純に拡張するのではなく、モデルファミリーを大幅に刷新しています。Per-Layer Embeddingsに基づく新しいE2BとE4Bモデルを追加し、26BのMixture-of-Expertsアーキテクチャを採用するとともに、エンコーダーを使わない12Bのマルチモーダルモデルを導入しています。中規模以上のモデルは、最大256Kトークンのコンテキスト長に対応するようになりました。もう1つの大きな追加点は、小規模モデルが音声と動画の入力にネイティブ対応したことです。この機能はGemma 3にはありませんでした。
Gemma 4はツール呼び出しに対応していますか?
はい。対応するモデルバリエーションではツール呼び出しを利用でき、どのモデルがこの機能を備えているかはモデルカタログに明示されています。AIエージェントを構築する予定があるなら、ツール呼び出しは重要な機能です。モデルが外部の関数やサービスとやり取りできるようになるためです。セットアップの全手順は、AIエージェントをローカルで実行する方法のガイドをご覧ください。
まとめ
Gemma 4は、現在利用できるローカルモデルの中でも、特に柔軟なラインアップを提供しています。8 GBのノートPCでも、32 GBのメモリを搭載したワークステーションでも、ハードウェアに合ったモデルがあります。
要点:
- Gemma 4ファミリーには、E2B、E4B、12B、26B A4B、31Bの5つのローカルモデルがあります。
- 16 GBのRAMを搭載した環境を使うほとんどのユーザーにとって、12Bモデルは品質とリソース使用量のバランスが最も良く、ダウンロードサイズは約6.5 GBです。
- モデル名のEは実効パラメータを意味するeffective parametersの略で、A4Bは、26Bすべてがメモリに読み込まれたままでも、推論中に有効になるのは4Bのパラメータだけであることを示しています。
- GoogleのQAT版Gemma 4は、元のモデルに近い性能を維持しながら、メモリ使用量を約72%削減します。
- Atomic ChatはHugging Faceを直接検索するため、インストール前にモデルサイズ、コンテキスト長、パラメータ数、ダウンロードサイズを簡単に比較できます。
- すべてのGemma 4モデルが画像理解に対応しており、E2B、E4B、12Bはさらに音声入力にも対応しています。
- Gemmaをローカルで実行すると、すべての処理が自分のデバイス内で完結するため、API料金や継続的な料金なしでオフラインで動作します。




