

このガイドでは、次の内容を解説します。
- Qwen3.8 Flash Nextの無検閲版とは何か、アブリテレーションによって何が変わったのか
- どのコミュニティビルドを実行すべきか、それぞれにどのようなハードウェアが必要か
- Atomic Chatまたはllama.cppでQwen3.8 Flash Nextの無検閲版をローカル実行する方法
この記事では、無検閲版のビルドを扱います。Alibabaのオリジナルモデルについては、Qwen3.8 Flash Nextをローカルで実行するガイドを、その他のラインアップについては、Qwenモデルをローカルで実行するガイドをご覧ください。24 GBのカードを搭載したマシンをお使いの場合、デンスモデルの27Bに同じ編集を施したモデルについては、Qwen 3.8 27Bの無検閲版をローカルで実行するガイドで解説しています。
Qwen3.8 Flash Next Uncensoredとは?
Qwen3.8 Flash Next Uncensoredは、Alibabaがリリースしたものではありません。Alibabaは2026年8月26日に、Qwen Community License 1.0の下でQwen3.8 Flash Nextを公開し、コミュニティの公開者が最初の2日間で重みを編集したビルドをリリースしました。このライセンスは、派生した重みを認めています。このガイドで紹介するビルドはすべて、そうしたコミュニティによる編集版であり、それぞれ異なる人物が異なる手法で作成しています。
| 仕様 | Qwen3.8 Flash Next Uncensored |
|---|---|
| 総パラメータ数 | 125Bに加え、51Bのn-gram埋め込みと4BのMTPヘッド |
| トークンあたりのアクティブパラメータ数 | 6B |
| アーキテクチャ | MoE、ハイブリッドアテンション(Gated DeltaNet + Qwen Sparse Attention) |
| エキスパート | ルーティング対象512個、トークンあたり10個がアクティブ、さらに共有エキスパート1個 |
| 層数 | 48 |
| コンテキスト長 | 標準で262,144トークン、1Mまで拡張可能 |
| モダリティ | テキスト、画像、動画の入力 |
| 推論 | 思考はデフォルトでオン、オフに切り替え可能 |
| 複数トークン予測 | アーキテクチャとして対応しているものの、保持の仕方はビルドごとに異なる |
| ベースモデル | Qwen/Qwen3.8-Flash-Next、2026年8月26日リリース |
| ベースモデルのライセンス | Qwen Community License 1.0 |
アブリテレーションはモデルを再学習せずに重みを編集するため、モデルのサイズ、コンテキスト長、ハードウェア要件は変わりません。
手法が文書化されているビルドでは、ビジョンタワーは重みの編集対象から外れています。dealignaiはMTPヘッドも保持していますが、現在のllama.cppのGGUF変換処理ではエクスポートされません。Flash Nextには51Bのn-gram埋め込みテーブルも含まれています。言語モデル自体のパラメータ数は125Bですが、4ビットのファイルサイズが111〜119 GBになるのはこのためです。
Qwen3.8 Flash Nextのアブリテレーション済みモデル:編集によって変わること
研究者は、多くのアライメント済みモデルにおける拒否動作が、モデルの残差ストリーム内にある単一の方向によって制御されていることを発見しました。残差ストリームとは、層から層へ渡される内部状態です。ArditiらはNeurIPS 2024で、重みが公開された13のチャットモデルを対象にこれを示しました。その1つの方向を消すとモデルは有害な指示を拒否しなくなり、再び加えると無害な指示を拒否するようになります。
その方向を特定するには、対応をそろえた有害なプロンプトと無害なプロンプトの集合でモデルを実行し、活性化を記録して、両者の平均の差を求めます。次に、その方向に対して重み行列を直交化することで、モデルがその方向に書き込む能力を取り除きます。この編集は、重みを直接変更します。学習データや勾配降下法は使用しません。
その論文に「abliteration」という言葉は登場しません。これは、著者らが「directional ablation(方向性アブレーション)」と呼んだ手法に対して、コミュニティが作った名称です。
ここでは、アブリテレーション済みと無検閲版は同じファイルを指します。アブリテレーション済みは手法を表す言葉です。無検閲版は結果を表し、追加の指示データによる学習で同様の結果を得たDolphinやHermesなどのモデルも含みます。デンスモデルに同じ編集を施した例については、Qwen 3.8 27Bの無検閲版をローカルで実行するガイドをご覧ください。モデルやツールチェーンを横断して手法そのものを知りたい場合は、アブリテレーション済みモデルとは何かの解説を、より広いカテゴリのビルドについては、ローカルで実行するおすすめの無検閲LLMのまとめをご覧ください。
拒否方向は残差ストリーム内にありますが、Flash Nextにはデンスモデルとは異なる編集が必要です。512個のエキスパートは、通常のLinearモジュールではなく、融合テンソルに格納されています。windowsxpは、25,088個のエキスパート出力射影を含む151個の残差ストリームへの書き込み要素を、バッチ処理で変更しました。拒否に関する結果を比較する際は、そのモデルカードに記載された思考モードでの結果としてのみ比較してください。
Qwen3.8 Flash Nextがアブリテレーションによって失うもの
windowsxpは、思考をオフにし、貪欲デコーディングを使って、同じプロンプトでBF16の編集版と元のチェックポイントを比較測定しました。
| ベンチマーク | Qwen3.8 Flash Next | アブリテレーション済み | 変化 |
|---|---|---|---|
AdvBenchでの拒否、520プロンプト | 99.42% | 0.96% | -98.46ポイント |
HarmBenchでの拒否、400プロンプト | 96.50% | 2.00% | -94.50ポイント |
MMLU、同一の1,000問による対応比較 | 86.00% | 84.40% | -1.60ポイント |
GSM8K、200問 | 96.00% | 97.00% | +1.00ポイント |
公開者は、このMMLUテストについて、対応のあるMcNemar検定のp値を0.017と報告しています。ここで紹介する中で、編集済みモデルとオリジナルを同じ1,000問でテストしているモデルカードは、この公開者のものだけです。dealignaiは、NVFP4で別途実施した2,280問のMMLUテストについて、82.11%から81.93%になったと報告しています。2つの結果は異なる評価ハーネスを使用しており、比較できません。
アブリテレーションは、過剰な拒否とともに、安全性のために意図された拒否も取り除く可能性があります。モデルを頼りにする前に、自分のルールに照らして出力をテストしてください。
Qwen3.8 Flash Nextの無検閲版はどのビルドを実行すべきか?
少なくとも3者が実体のあるFlash Nextの無検閲版ビルドをリリースしており、それらを再パッケージ化した公開者もいます。ハードウェアと、画像認識機能が必要かどうかで選んでください。
| ビルド | 適した用途 | ファイル | 画像認識 | ランタイム |
|---|---|---|---|---|
| windowsxp811203 | テキスト用途と文書化されたテスト | GGUF Q4_K_M〜Q8_0、およびBF16 | GGUFはテキストのみ | Atomic Chatまたはllama.cpp b10661+ |
| orcarouter | 画像認識またはネイティブMLX | GGUF IQ2_XXS〜Q5_K_M、MLX 2〜8ビット | f16プロジェクターを提供 | Atomic Chatまたはllama.cpp b10661+、アクセス制限あり |
| dealignai | MTPを使うサーバー用途 | FP8とNVFP4 | 画像と動画 | 2台のDGX Spark上のSGLang |
テキストモデルとして使うなら、windowsxp811203を選んでください。モデルカードには、方向の取得、ラムダ値のスイープ、変更されたテンソル、変更されていないテンソルが記載されています。GGUFのモデルカードでは、llama.cppによるQ4_K_Mのテストも行っています。128 GB以上のメモリで使用してください。
ネイティブMLXまたは画像入力が必要なら、orcarouterを選んでください。IQ2_XXSからQ5_K_MまでのGGUFに加え、2、3、4、6、8ビットのMLXビルドを提供しています。GGUFリポジトリには、画像認識用のf16プロジェクターもあります。アクセスするには、連絡先情報の共有に同意する必要があります。mradermacherは、同じ編集済みチェックポイントを、一般公開のQ2_K、Q4_K_S、Q6_K、Q8_0、およびmmprojファイルとして再公開しています。
dealignaiは、2台のDGX Spark上でSGLangを介して実行します。NVFP4のモデルカードでは、思考をoff、low、xhighに設定して拒否動作をテストしており、MTPヘッドを保持しています。これはサーバー向けのビルドです。Atomic Chatが読み込むのはGGUFです。
拒否率の数値が一致しない理由
| ビルド | 拒否率 | プロンプト集合 | 条件 |
|---|---|---|---|
| windowsxp811203 | 99.42%から0.96%へ | AdvBench、520プロンプト | BF16、思考なし、貪欲デコーディング、ジェイルブレイクなし |
| orcarouter | 64〜100%から約0〜3.3%へ | モデルカードに名称の記載なし | vLLMで配信、思考モードの記載なし |
| dealignai | 0%、ベースモデルの値は未報告 | HarmBenchの実害を扱う240プロンプト | NVFP4、貪欲デコーディング、思考設定はoff、low、xhigh |
各行では、プロンプト集合、プロンプト数、回答を拒否と判定する人や仕組み、思考がオンだったかどうかが異なります。冒頭で警告し、その後に求められた内容をそのまま提供する回答は、ある公開者の判定方法では拒否と評価され、別の公開者の判定方法では指示への応諾と評価されます。
windowsxpは、同じプロンプトに対するベースモデルの結果を公開しています。dealignaiのテストは、実害を扱う240プロンプトを対象にしています。ビルドを頼りにする前に、自分のプロンプトで試してください。
Qwen3.8 Flash Nextの無検閲版に必要なハードウェア
確認すべきシステム要件はメモリです。BF16のリリースは360 GBあるため、無検閲版のビルドをワークステーションで動かせるようにするのが量子化です。4ビットのファイルは111〜119 GBで、最小のimatrixファイルは74.8 GBです。これらのサイズには、51Bのn-gramテーブルが含まれています。Apple Siliconでは、ファイルサイズを統合メモリ容量と比較してください。
| 利用可能なメモリ | 推奨ビルド | おおよそのサイズ | 確保できるコンテキストの余裕 |
|---|---|---|---|
| 80 GB | IQ2_XXS | 74.8 GB | 約8Kのコンテキスト |
| 96 GB | Q3_K_SまたはIQ3_M | 88.8〜89.5 GB | 約32Kのコンテキスト |
| 128 GB | Q4_K_M | 111〜119 GB | 約32Kなら余裕あり、262Kでは余裕が少ない |
| 192 GB以上 | Q6_K | 156〜168 GB | 標準の最大コンテキスト長 |
| 64 GB以下 | なし | - | 安全な余裕を確保しつつメモリに常駐できるビルドなし |
隣接する2つの量子化段階のファイルが、どちらもコンテキスト用の余裕を残して収まるなら、大きい方を選んでください。数GB多く必要になりますが、特に低ビット側では、誤ったトークンを選ぶ頻度が目に見えて下がります。
ここでの低ビットビルドには、オリジナルモデルの低ビットビルドにはないリスクがあります。公開されている拒否率は、最小のGGUFではなく、元になったBF16またはNVFP4のモデルで測定されたものです。編集そのものを評価する必要がある場合は、Q4_K_M以上を使用してください。
コンテキストによってメモリ使用量はどれだけ増えるか?
上記の数値は、モデルの重みだけのものです。エンジンはKVキャッシュも確保します。会話、ドキュメント、コードベースが長くなるにつれて、キャッシュも大きくなります。
48層のうちQwen Sparse Attentionを使用するのは12層だけで、各層にKVヘッドが2個あります。公式の構成から計算すると、12層 × 2 KVヘッド × 256次元 × キー/バリュー × 2バイトで、1トークンあたり24 KiB、約25 KBになります。これは構成から算出した推定値であり、実行時の実測値ではありません。
| コンテキスト長 | アテンションキャッシュ |
|---|---|
| 8K(一般的なチャット) | 約0.2 GB |
| 32K(長いドキュメント) | 約0.8 GB |
| 128K(大規模なコードベース) | 約3.2 GB |
| 262K(標準の最大コンテキスト長) | 約6.5 GB |
Q4ビルドと262K全体のキャッシュを合計すると、OS用の余裕を含める前の段階で約118〜126 GBになります。マシンのメモリ容量がこの数値に近い場合は、コンテキスト長を小さく保ってください。
Qwen3.8 Flash Nextの無検閲版を実行できるハードウェアは?
- 統合メモリ128 GBのMac(M4/M5 Max、Mac Studio)と128 GBの小型ワークステーション(NVIDIA DGX Spark、AMD Strix Halo):実用的なチャット用のコンテキスト長で、4ビットのファイルが収まります。Macでは、まずデフォルトのGPUメモリ上限を引き上げてください。GGUFビルドはMetalを介してネイティブに動作します。形式の選択で迷っている場合は、GGUFとMLXの比較ガイドをご覧ください。
- 96 GBのGPU(RTX PRO 6000):IQ2またはQ2のファイル全体がVRAMに収まります。より大きなGGUFには、オフロード用のシステムRAMが必要です。
- 96 GBのMacとRAM 96 GBのデスクトップ:適度なコンテキスト長で、IQ2またはQ3のファイルが収まります。Macでは、この場合もGPUメモリ上限を引き上げる必要があります。
- 24 GBのGPU(RTX 3090 / 4090)と96 GB以上のシステムRAM:アテンション層をGPUに、エキスパートの重みをRAMに置いて、4ビットビルドを試せます。OrcaRouterはGGUFのCPUおよびGPUオフロードについて文書化していますが、この構成そのもののスループットを公開した人はいません。
- それだけのシステムRAMを備えていない24 GBのGPU:125Bモデルのどのビルドも実行できません。デンスモデルのQwen 3.8 27Bの無検閲版なら、その規模のハードウェアで同じ編集を施したモデルを使えます。
- スマートフォン:Flash Nextのビルドをメモリに常駐させて実行することはできません。スマートフォンで動く無検閲モデルについては、無検閲モデルのまとめにある小型モデルをご覧ください。
Atomic ChatでQwen3.8 Flash Nextの無検閲版をローカル実行する方法
Atomic Chatは、私たちが開発した無料のオープンソースのローカルAIアプリです。Hugging Faceのモデルブラウザーとチャット機能を内蔵しており、llama.cppを手動でビルドする必要はありません。
Atomic ChatでQwen3.8 Flash Nextの無検閲版を実行する手順は、次のとおりです。
ステップ1:Atomic Chatをインストールする
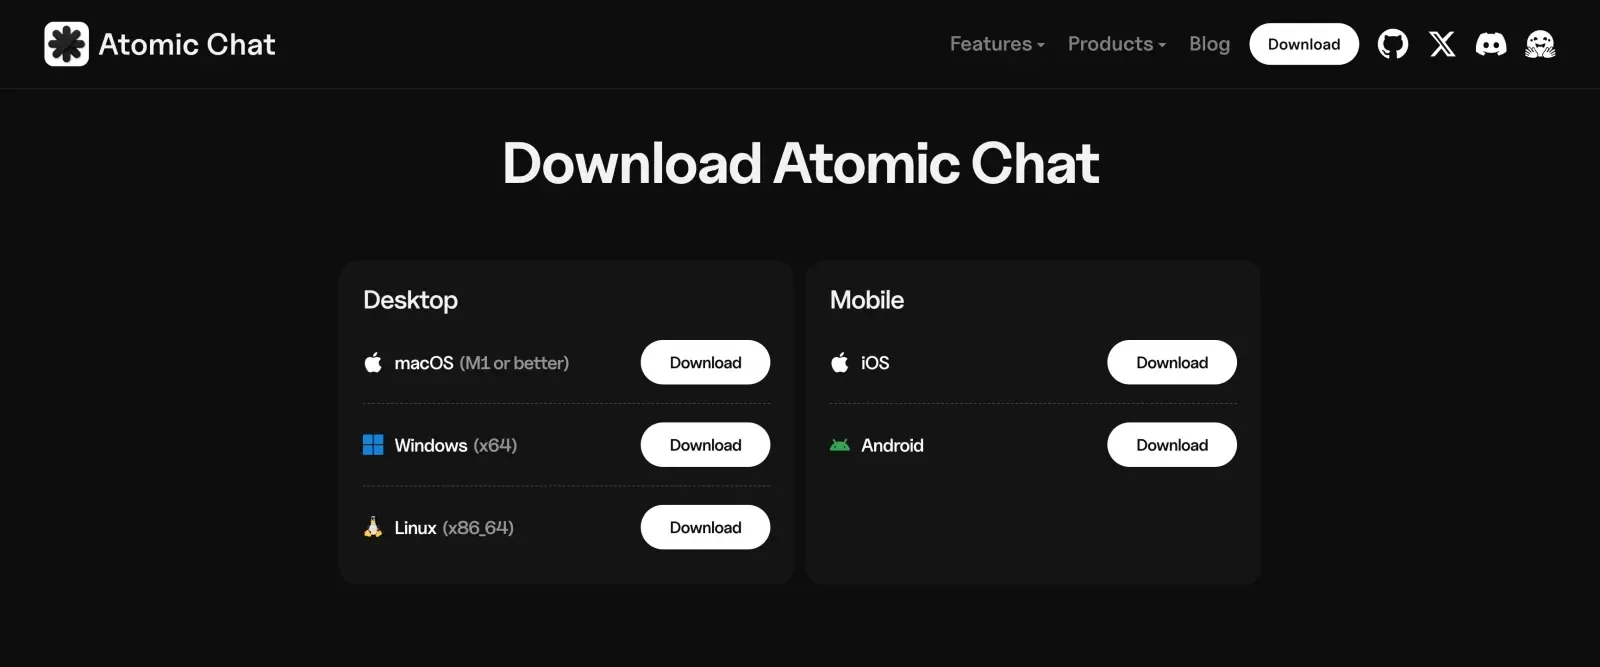
atomic.chatからAtomic Chatをダウンロードし、お使いのプラットフォーム向けのビルドをインストールしてください。
- macOS:ユニバーサル.dmg(IntelとApple Silicon)、macOS 13.6以降
- Windows:x64向けの.exeインストーラー
- Linux:root権限が不要な、x86_64向けの自己完結型.AppImage
- iOS:App Storeから
- Android:Google Playから
Linuxでは、chmod +xでAppImageに実行権限を付け、直接実行してください。初回起動時にアプリがFUSEを要求した場合は、DebianまたはUbuntuではsudo apt install fuse libfuse2、Fedoraではsudo dnf install fuse fuse-libsでインストールします。
ステップ2:Qwen3.8 Flash Nextの無検閲版GGUFを探す
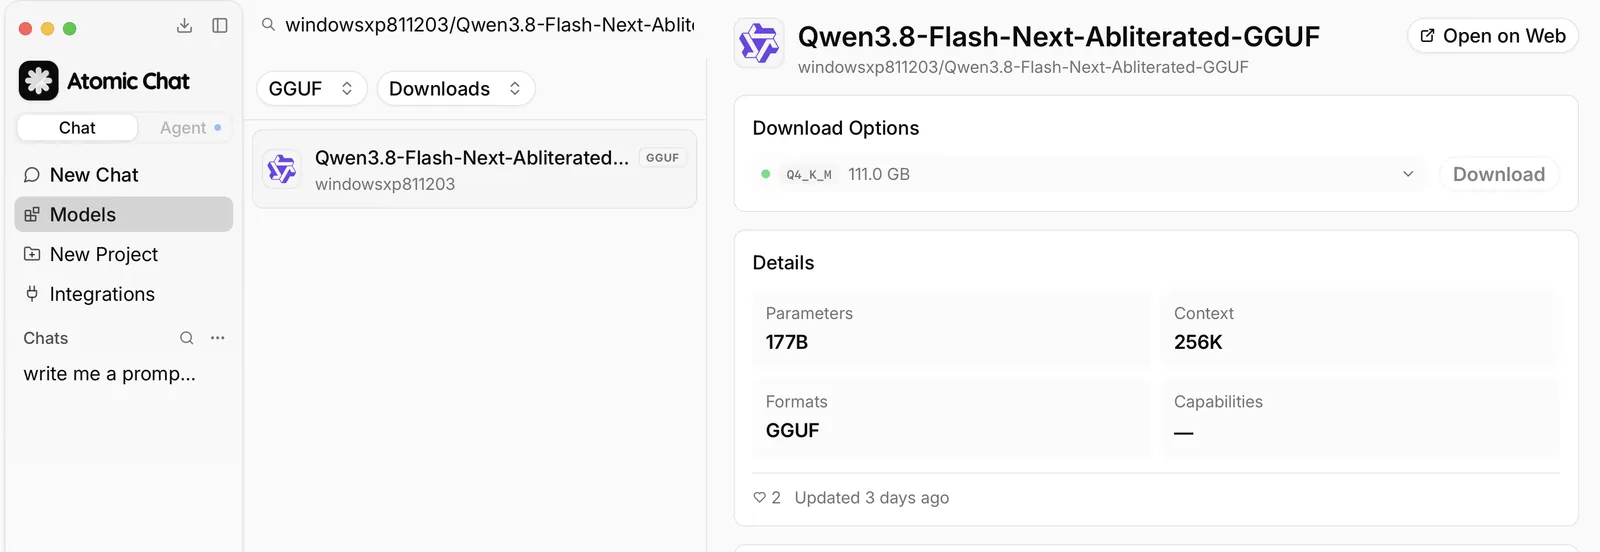
Modelsタブを開き、次を検索します。
windowsxp811203/Qwen3.8-Flash-Next-Abliterated-GGUF
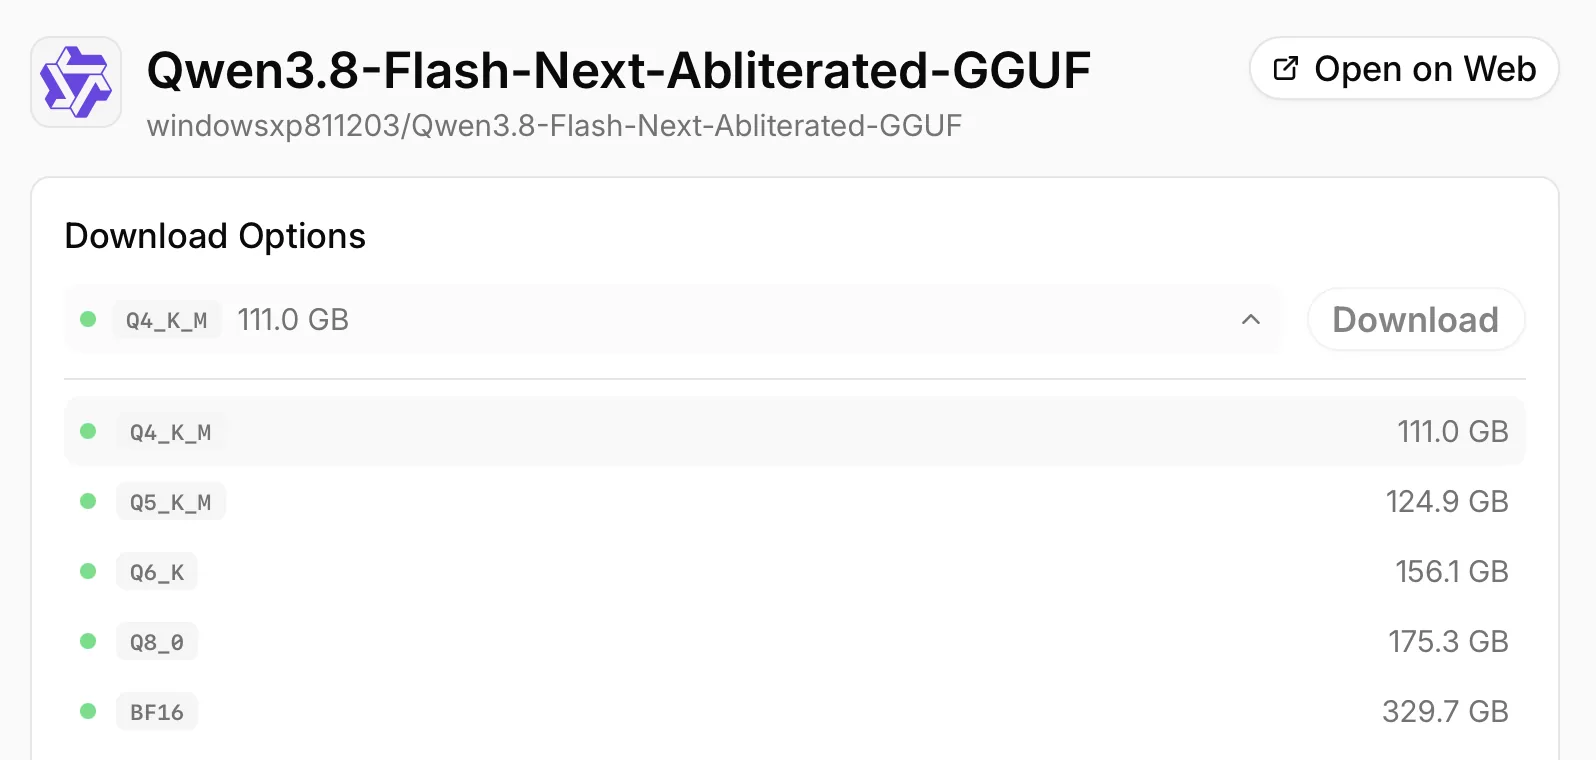
カタログはHugging Faceを利用しているため、公式リポジトリと並んでコミュニティのリポジトリも表示されます。ダウンロード前に検索結果の公開者名を確認し、Download Optionsの選択メニューを展開して、利用可能な量子化形式を表示してください。
注:ほぼ同じ名前のリポジトリが複数あり、そのうち1つにはアクセス制限があります。ダウンロード前に確認すべき点は、トラブルシューティングのセクションをご覧ください。
ステップ3:メモリ容量に合う量子化形式を選ぶ
上記のハードウェア表を参照してください。よくある構成では、次のように選びます。
- 統合メモリまたはRAMが128 GB:111 GBのQ4_K_Mをダウンロードします。
- 160 GB以上:125 GBのQ5_K_Mをダウンロードします。
- 192 GB以上:156 GBのQ6_Kをダウンロードします。
選択メニューには各ビルドが短いタグで表示され、サイズは上記の数値と少し異なります。コンテキスト用の余裕を残して収まる、最も大きな量子化モデルを選んでください。量子化形式の名前の意味がわからない場合は、GGUFとは何か、量子化はどのように機能するかのガイドをご覧ください。
ステップ4:コンテキスト、思考、サンプリングを設定する
モデルが宣言しているコンテキスト長は262Kですが、最大値を設定するとKVキャッシュがあらかじめ確保されます。チャットでは8,192トークン、コードやドキュメントの作業では32,768トークンから始め、処理内容に必要な場合にだけ増やしてください。
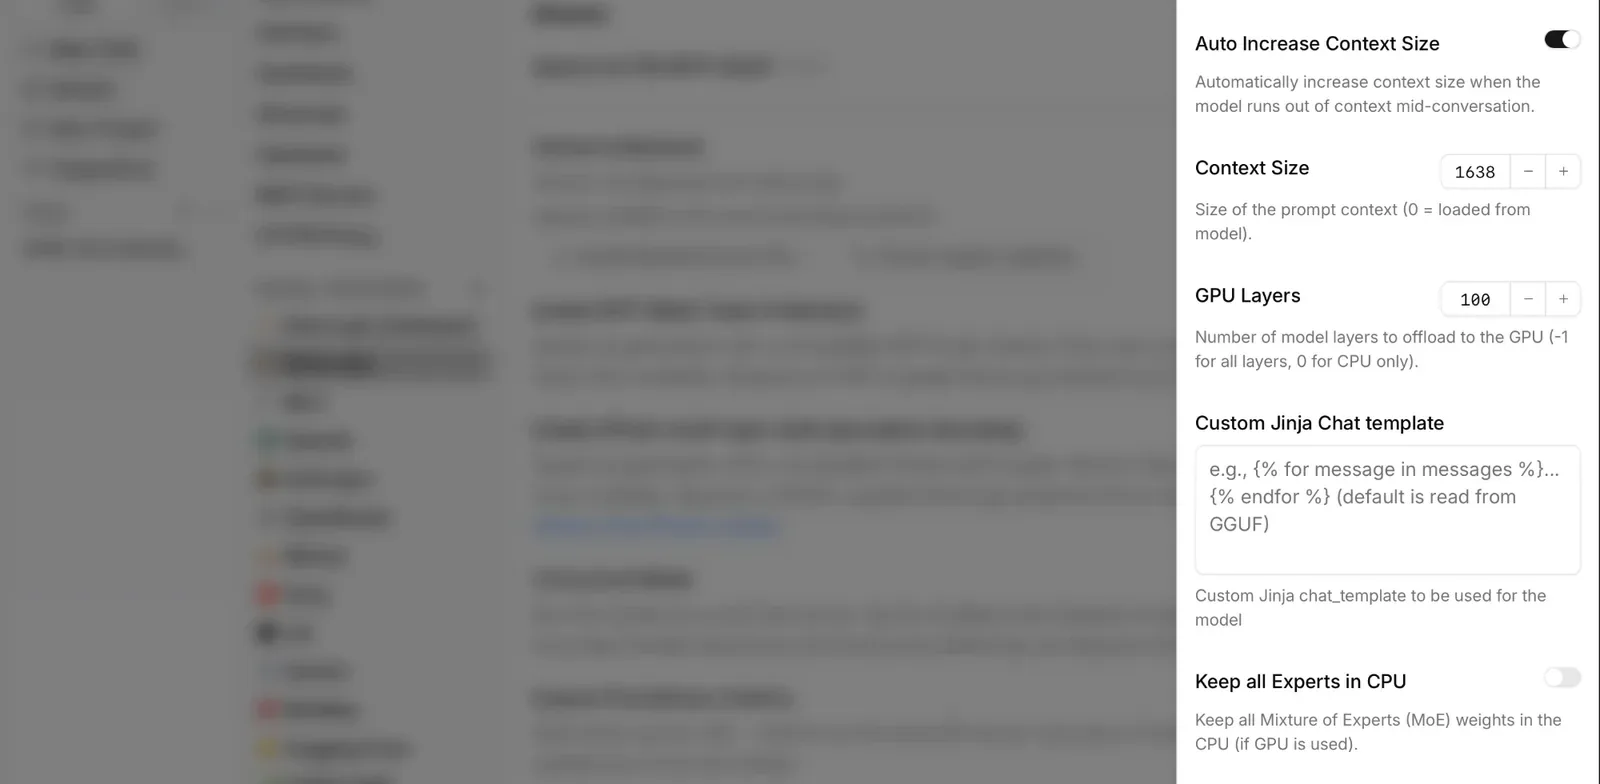
コンテキスト長はチャット画面ではなく、モデル自体の設定にあります。Settings → Model Providers → Llama.cppを開き、モデル一覧で対象のビルドを探して、その行の歯車アイコンをクリックします。そこで次の3項目を設定してください。
- Context Size:8192または32768に設定します。値が0の場合はGGUFから最大値を読み込み、このモデルでは262K全体のコンテキスト長になります。
- Auto Increase Context Size:デフォルトでオンです。会話がコンテキストに収まらなくなるとコンテキスト長を増やすため、ぎりぎり収まっていたビルドがメモリ上限を超えることがあります。上限に近い状態で使用する場合は、オフにしてください。
- GPU Layers:-1は全層をオフロードします。重みがGPUメモリまたは統合メモリに収まるマシンでは、-1を使用してください。
Context SizeまたはGPU Layersを変更するとモデルが再起動するため、長い会話を始める前に設定してください。
思考はデフォルトでオンです。チャット内の電球アイコンでオフに切り替えられます。
サンプリングは別のパネルにあります。チャット上部のモデル名の横にあるスライダーアイコンをクリックしてください。Qwenの推奨設定は元の重みと同じで、思考がオンの場合はtemperature 1.0、top_p 0.95、top_k 20、オフの場合は0.7と0.80です。これらの設定はモデルではなく、チャットプロファイルであるアシスタントに保存されるため、モデルを切り替えても変わりません。
ステップ5:ローカルでチャットする
ダウンロードが完了すると、Atomic Chatがモデルを読み込み、内蔵チャットで開きます。オリジナルが拒否するプロンプトを送り、ダウンロードしたビルドが編集版であることを確認してください。
windowsxpのGGUFはテキスト用のビルドです。画像入力が必要な場合は、代わりにOrcaRouterのアクセス制限付きGGUFと、別ファイルのプロジェクターをダウンロードしてください。画像、重み、プロンプトはお使いのマシン内にとどまります。
Atomic Chatは、http://localhost:1337/v1でOpenAI互換のAPIサーバーも提供します。Claude CodeやClineなどのコーディングエージェントを含め、OpenAI APIで通信できるツールなら、クラウドモデルの代わりにローカルモデルをそのまま差し替えて利用できます。
llama.cppでQwen3.8 Flash Nextの無検閲版を実行する方法
次のような場合は、llama.cppでモデルを直接実行してください。
- ホストとポートをフラグで指定し、ヘッドレスで起動できるサーバーが必要な場合
- GPUオフロードを細かく制御する必要がある場合
- 再現可能なサーバー構成が必要な場合
これらのビルドは、オリジナルと同じqwen4_expアーキテクチャを使用します。llama.cppはb10661以降、アップストリームでこのアーキテクチャに対応しています。このリリースまたはそれ以降のビルドを使用してください。
ステップ1:現行のllama.cppをビルドする
NVIDIA CUDAの場合:
git clone https://github.com/ggml-org/llama.cpp
cmake -S llama.cpp -B llama.cpp/build -DCMAKE_BUILD_TYPE=Release -DGGML_CUDA=ON
cmake --build llama.cpp/build -j --target llama-cli llama-server llama-mtmd-cli
Apple Siliconでは、Metalがデフォルトで有効です。
cmake -S llama.cpp -B llama.cpp/build -DCMAKE_BUILD_TYPE=Release
cmake --build llama.cpp/build -j --target llama-cli llama-server llama-mtmd-cli
ステップ2:モデルを実行する
まず、文書化されている4ビットビルドをダウンロードします。
hf download windowsxp811203/Qwen3.8-Flash-Next-Abliterated-GGUF \
  --include "Qwen3.8-Flash-Next-Abliterated-Q4_K_M.gguf" \
  --local-dir ./qwen-flashnext-uncensored
次に、8Kのコンテキスト長で実行します。
./llama.cpp/build/bin/llama-cli \
  -m ./qwen-flashnext-uncensored/Qwen3.8-Flash-Next-Abliterated-Q4_K_M.gguf \
  --single-turn -c 8192 -n 512 --temp 0.7 \
  -p "Explain how a mixture-of-experts model works."
ファイルは、お使いのシステムに収まる量子化モデルに置き換えてください。VRAMより大きい場合は、モデルがメモリ不足になるまでGPUオフロード量を増やし、その後1段階戻します。OrcaRouterはGGUFのCPUおよびGPUオフロードについて文書化していますが、あらゆるハードウェアへの分散構成で共通して使えるフラグの組み合わせは公開していません。
ステップ3:ローカルのOpenAI互換APIを提供する
llama-cliをllama-serverに置き換えます。
./llama.cpp/build/bin/llama-server \
  -m ./qwen-flashnext-uncensored/Qwen3.8-Flash-Next-Abliterated-Q4_K_M.gguf \
  --alias qwen3.8-flash-next-uncensored \
  --jinja \
  --temp 1.0 --top-p 0.95 --top-k 20 \
  -ngl 99 \
  -c 8192 \
  --host 127.0.0.1 --port 8080
次の方法でテストします。
curl http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{ "model": "qwen3.8-flash-next-uncensored", "messages": [ { "role": "user", "content": "Summarize what an n-gram embedding table does." } ] }'
ネットワーク上のほかのマシンからアクセスする必要がない限り、サーバーは127.0.0.1にバインドしてください。
llama.cppで画像認識を実行する
画像入力には、ビジョンプロジェクターという追加ファイルが1つ必要です。同じリポジトリ内のすべての量子化形式で共有されます。windowsxpのGGUFはテキスト専用なので、代わりにOrcaRouterの画像認識向けの構成を使用してください。リポジトリにはアクセス制限があり、次の2つのファイルをダウンロードする前に、アクセス条件に同意する必要があります。
hf download orcarouter/Qwen3.8-Flash-Next-Uncensored-GGUF \
  --include "Qwen3.8-Flash-Next-Uncensored-Q4_K_M*" "mmproj-*" \
  --local-dir ./qwen-flashnext-uncensored-vision
./llama.cpp/build/bin/llama-mtmd-cli \
  -m ./qwen-flashnext-uncensored-vision/Qwen3.8-Flash-Next-Uncensored-Q4_K_M-00001-of-00003.gguf \
  --mmproj ./qwen-flashnext-uncensored-vision/mmproj-Qwen3.8-Flash-Next-Uncensored-F16.gguf \
  --image your-photo.jpg \
  -ngl 99 -c 8192 \
  -p "What is in this image?"
元のチェックポイントには、投機的デコーディングの仕組みとなる4Bの複数トークン予測ヘッドも含まれています。現在のGGUFコンバーターはこれをエクスポートも実行もしないため、現在のGGUFにはローカルで投機的デコーディングを行う手段がありません。dealignaiはNVFP4ビルドでこのヘッドを保持しており、SGLang NEXTNを介して1ステップあたり約2.4個のドラフトトークンが採用されると報告しています。これは、GPUを2基使う別のサーバー構成です。
Atomic Chatは現行のアップストリーム版llama.cppを同梱しているため、qwen4_expのGGUFを読み込めます。OllamaとLM Studioで同じファイルを読み込むには、それぞれのランタイムの更新が必要です。
トラブルシューティング
モデルがまだ拒否する
アブリテレーションは拒否を減らしますが、完全にはなくしません。次の点を確認してください。
- 電球アイコンで思考をオフにしてください。推論ブロックによって、拒否するかどうかの境界にあるプロンプトへのモデルの対応が変わることがあります。
- より大きな量子化モデルを試してください。拒否するかどうかの境界は、アブリテレーション済みモデルで最も不安定な部分であり、低ビットのファイルはまさにその不安定さを増幅します。
- 意図したビルドを読み込んだことを確認してください。アプリのカタログでは、元の重みと編集済みの重みが非常によく似た名前で並んでいます。
ダウンロードしたビルドが説明どおりのものではない
Qwen3.8-Flash-Nextという名前を冠したリポジトリは、重みが公開される前からHugging Faceに存在しており、ファイルが1つもないアブリテレーション版やジェイルブレイク版も含まれていました。見慣れないリポジトリからダウンロードする前に、モデルカードに実際の手法が記載されていること、ファイル一覧に妥当なサイズのGGUF分割ファイルがあること、公開者の素性を確認できることを確かめてください。125Bモデルの4ビット版が400 MBに収まることはありません。
llama.cppがモデルのアーキテクチャを不明と報告する
お使いのランタイムは、qwen4_expに対応する前のバージョンです。Atomic Chatには、現行のアップストリーム版llama.cppがすでに同梱されています。直接インストールする場合は、llama.cpp b10661以降を使用してください。OllamaとLM Studioで同じファイルを読み込むには、それぞれのランタイムの更新が必要です。
モデルは読み込めるが、生成が非常に遅い
GPUオフロードがゼロになっているか、OSがエキスパートの重みをディスクにスワップしている可能性があります。空きRAMと空きVRAMの合計が、ファイルサイズに数GBの余裕を加えた容量を上回ることを確認し、GPU Layersを-1に設定して、OSがスワップを始める前にMoEオフロードの制御を使用してください。
長いコンテキストでメモリ不足になる
KVキャッシュがメモリの余裕を超えているか、Auto Increase Context Sizeがコンテキスト長を自動的に増やした可能性があります。キャッシュは1トークンあたり約25 KBなので、上限に近い場合はContext Sizeを明示的に設定し、Auto Increaseをオフにしてください。
よくある質問
Qwen3.8 Flash Nextの無検閲版を自分のハードウェアで実行する際によくある質問です。
アブリテレーション済みモデルと無検閲モデルの違いは?
アブリテレーション済みは、モデルをどのように変更したかを表します。重みにある方向のうち、拒否を制御する1つの方向を取り除いたという意味です。無検閲はその結果を表し、重みの編集ではなくファインチューニングで同じ結果を得たモデルも含みます。このガイドで紹介するFlash Nextの3者の公開者は、重みのレベルで直接アブレーションを行ったと説明しているため、どちらの言葉も同じファイルを指します。
Qwen3.8 Flash Next UncensoredはQwen4モデルですか?
いいえ。AlibabaはQwen Community License 1.0の下でQwen3.8 Flash Nextを公開しており、無検閲版は、その重みに個々の公開者がコミュニティで編集を加えたものです。Alibabaが制作したものでも、公認したものでもありません。Flash NextはQwen4-expアーキテクチャのプレビューです。
Qwen3.8 Flash Nextの無検閲版にはどれくらいのRAMが必要ですか?
RAMとVRAMの合計、または統合メモリが約128 GBあれば、実用的なコンテキスト用の余裕を確保して4ビットビルドを実行できます。実用上の最低ラインは80 GBで、OrcaRouterの74.8 GBのIQ2_XXSを使用します。BF16のリリースは360 GBです。
RTX 4090でQwen3.8 Flash Nextの無検閲版を実行できますか?
いいえ、カード単体では実行できません。24 GBのVRAMには、125Bモデルのどのビルドも収まりません。96 GB以上のシステムRAMを併用すれば実行できます。アテンション層をGPUに置き、エキスパートの重みをRAMに移してください。1トークンあたりアクティブになるのは6Bパラメータだけなので、オフロードによる性能低下は、同規模のデンスモデルよりはるかに小さくなります。
MacでQwen3.8 Flash Nextの無検閲版を実行できますか?
はい。GPUメモリ上限を引き上げれば統合メモリ96 GBから実行でき、128 GBなら余裕があります。macOSではデフォルトで、GPUがアクセスできるメモリが統合メモリの約75パーセントに制限されているため、128 GBのMacでモデルが使えるのは約96 GBです。そのままなら2ビットビルドが動作し、sysctl iogpu.wired_limit_mbで上限を引き上げれば4ビットビルドが動作します。GGUFビルドはMetalを介してネイティブに動作します。
Qwen3.8 Flash Nextの無検閲版で最適なビルドはどれですか?
画像認識やネイティブMLXが必要でなければ、windowsxp811203のビルドです。最も詳しく文書化されているビルドで、モデルカードには実際の対象テンソル、ラムダ値のスイープ、拒否率の表、オリジナルモデルと対応をそろえた能力テストが公開されています。128 GBのマシンでテキスト用途に使うなら、この公開者のQ4_K_Mを選んでください。画像入力やMacネイティブのMLXビルドが必要な場合は、代わりにOrcaRouterのビルドを選び、リポジトリのアクセス条件に同意してください。dealignaiは、SGLangを使うBlackwellサーバー向けの別の選択肢であり、ローカルのGGUFアプリ向けではありません。
アブリテレーション済みモデルは能力が低下しますか?
公開されたwindowsxpビルドは、同じ1,000問を使った対応比較でMMLUが1.6ポイント低下し、GSM8Kのスコアは低下しませんでした。ラムダ値のスイープでは、より強い編集を施すと、単純な拒否テストには引き続き合格しながらも、より多くの能力が失われることが示されています。dealignaiは、別の評価ハーネスでMMLUに0.18ポイントの差があったと報告しています。ビルドを頼りにする前に、自分の作業でテストしてください。
Qwen3.8 Flash Nextの無検閲版は無料で商用利用できますか?
モデルカードにQwen Community License 1.0と記載されているwindowsxp811203とdealignaiのビルドについては、はい。ベースライセンスは、商用利用、改変、再配布を認めています。OrcaRouterはリポジトリにApache 2.0と表示しているため、実際にデプロイするリポジトリのライセンスファイルを確認してください。ベースライセンスでは、月間アクティブユーザー数が1億人を超える製品、または月間売上が2,000万ドルを超える製品は、インターフェースにモデル名を表示する必要があります。また、モデルをサービスとして提供するAPI、コーディングアシスタント製品、オフィスアシスタント製品には、Qwenから別途ライセンスを取得する必要があります。
Qwen3.8 Flash Nextの無検閲版ビルドをダウンロードしても安全ですか?
このモデルの名前を冠したリポジトリは、モデル自体より前からHugging Faceに存在していました。モデルカードに実際の手法が記載されていることと、ファイル一覧に妥当なサイズのGGUF分割ファイルがあることを確認してください。推論ツールは最新に保ち、素性を確認できる公開者を選んでください。
Qwen3.8 Flash Nextの無検閲版はローカルで画像認識に対応していますか?
はい、リポジトリがプロジェクターを提供している場合は対応しています。Flash Nextは画像と動画の入力を受け付けるネイティブな視覚言語モデルであり、ビジョンタワーはアブリテレーションで編集する部分の対象外です。OrcaRouterとmradermacherは、ローカルでの画像入力用に別のmmprojファイルを提供しています。windowsxpは元のBF16モデルにビジョンタワーを保持していますが、GGUFリポジトリにはmmprojがないため、そのQ4_K_Mはテキスト用ビルドとして使用してください。
Qwen3.8 Flash Nextの無検閲版はAtomic Chat、Ollama、LM Studioで動作しますか?
現行のアップストリーム版llama.cppを同梱しているAtomic Chatで動作します。OllamaとLM Studioで同じGGUFファイルを読み込むには、それぞれのランタイムをqwen4_exp対応版に更新する必要があります。アプリのランタイムが対応する前でも、モデル検索にリポジトリが表示されることがあります。
Qwen3.8 Flash Nextに自分でアブリテレーションを施せますか?
標準的な手順ではできません。Flash Nextは512個のエキスパートを融合テンソルとして格納しています。windowsxpは25,088個のエキスパート射影に対して独自のバッチ処理を使用し、360 GBのBF16チェックポイントを元に作業しました。これは複数GPUを備えたサーバーで行う作業であり、デスクトップで試すものではありません。Hereticは通常のモデルには引き続き有用ですが、このモデルに使用する前にqwen4_expへの対応を確認してください。
まとめ
128 GBのマシンでは、llama.cpp b10661以降を使用し、windowsxp811203の111 GBのQ4_K_Mをダウンロードして、8Kのコンテキスト長から始めてください。モデルカードには、変更したテンソルと、実測された能力低下が記載されています。
画像入力やMacネイティブの形式が必要な場合は、代わりにOrcaRouterの4ビットビルドをmmprojとともに使用してください。24 GBのカードには、Qwen 3.8 27Bの無検閲版の方が適しています。
重要なポイント:
- Qwen3.8 Flash Nextの無検閲版ビルドは、Alibabaの重みにコミュニティが編集を加えたものです。Alibabaが公開したものではありません。
- アブリテレーションは再学習せずに重みから拒否方向を取り除くため、ベースモデルのサイズやメモリ要件は変わりません。
- 4ビットビルドのサイズは111〜119 GBです。
- 80 GBのマシンでは、短いコンテキストでIQ2ファイルを実行できます。
- 24 GBのカード単体では、Flash Nextのどのビルドも実行できません。
- 公開者ごとの拒否率は、異なるプロンプト集合で測定されています。それらを比較して順位付けすることはできません。




