

2026年5月中旬、Cyeraの研究者が「Bleeding Llama」と名付けた脆弱性を公開しました。深刻度は10点満点中9.1と評価されており、認証されていない攻撃者が、Ollamaサーバーのメモリからプロンプト、システム指示、APIキー、環境変数を直接取り出せます。公開時点では、インターネットからアクセス可能な約300,000のインスタンスが脆弱な状態でした。Ollamaはモデルをローカルで実行するため、プロンプトがコンピューターの外に出ることはありません。
ここで当然の疑問が生じます。インターネットの向こう側にいる攻撃者が、どうやって他人のプロンプトをメモリから読み取れるのでしょうか?
簡潔な答え
「データはローカルにとどまる」という説明は、Ollamaがモデルを処理する仕組みについては正しいものの、利用環境が外部に公開されているかどうかについては何も示していません。
つまり、「ローカル」とはモデルが実行される場所の性質であり、安全性の保証ではありません。Ollamaは127.0.0.1:11434にバインドするため、通信できるのは自分のマシンだけです。このデフォルトの状態で、ノートパソコンを1人で使う環境なら、比較的安全です。
問題は、Ollamaに別の場所からアクセスできるようにしたときに始まります。OLLAMA_HOSTを0.0.0.0に設定し、ファイアウォールや認証レイヤーを用意しなければ、「ローカル」モデルはもはや「ローカル限定」ではありません。その時点でAPIをネットワークに公開しており、Bleeding Llamaが悪用したのは、まさにこの種のミスです。
もうおわかりのとおり、その300,000台のサーバーが特殊な構成で動いていたわけではありません。管理者は別のマシンからOllamaにアクセスするために設定を1つ変更し、入り口に鍵をかけないままにしていました。Bleeding Llamaは、その入り口を通っただけです。
あなたのローカルLLMは安全ですか?
単独ユーザーとして自分のノートパソコンやデスクトップでモデルを実行し、OLLAMA_HOSTをデフォルトのままにして、アプリを最新の状態に保っているなら、おおむね問題ありません。APIはlocalhostでのみ待ち受けるため、リモートの攻撃者がアクセスできるものはありません。残る実質的な作業は、パッチの適用だけです。Ollamaの脆弱性の大半は迅速に修正され、被害を受ける人のほとんどは、何か月も前のバージョンを使っています。新しいリリースが出たら更新すれば、リスクの大部分に対処できます。
例外はWindowsで、後ほど説明します。
Ollamaをネットワークに公開している場合、つまり0.0.0.0に設定したり、ルーターでポート転送したり、社内LANに開放したり、クラウド上のマシンに設置したりしている場合は、今日中に実際の対策が必要です。Ollamaにはいかなる認証機能もないため、開いたポートは完全に開け放たれた入り口になります。アクセスできる人なら誰でも、あなたのハードウェアでプロンプトを実行し、モデルを一覧表示してダウンロードし、汚染されたモデルを送り込み、メモリから機密データを直接読み取れます。
これに当てはまる場合は、監査の項目に進み、APIをlocalhost限定に戻すか、その手前にVPNまたは認証を行うリバースプロキシを置いてください。この状態のまま放置してはいけません。
Windowsユーザーの場合:上記のどちらに当てはまるとしても、さらに注意が必要です。Windowsの自動アップデーターにある2つの脆弱性、CVE-2026-42248とCVE-2026-42249は、2026年5月時点でも未修正で、組み合わせると、攻撃者がログインのたびに実行されるプログラムを仕込めます。
問題の仕組みはアップデーター自体にあるため、実用的な対策は、Ollamaの設定で「Auto-download updates」をオフにし、パッチが提供されるまで公式サイトから手動で更新することです。macOSとLinuxのユーザーは、この部分を飛ばしてかまいません。この欠陥はWindowsビルドに固有のものです。
Ollamaの内部の仕組み
2つのサーバーを1つの仕組みとして理解する
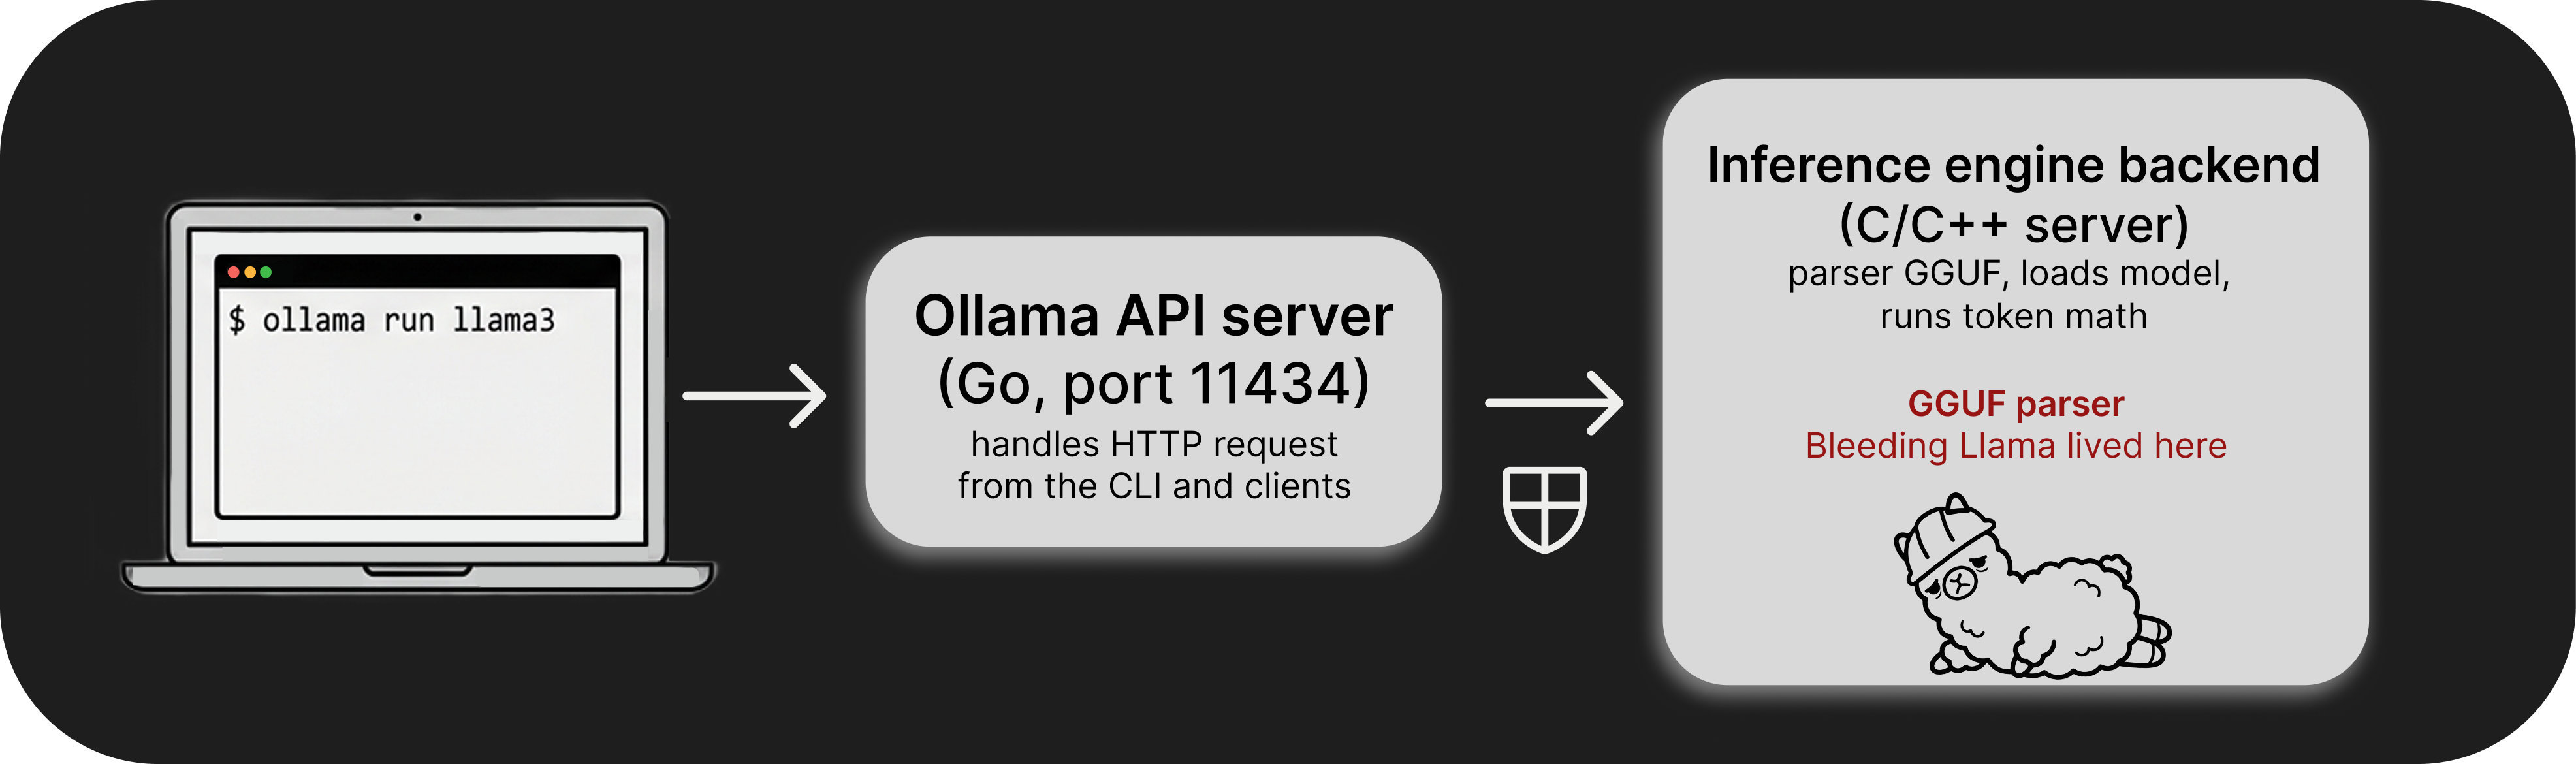
ollama run llama3と入力しても、そのコマンドがモデルを直接実行しているわけではありません。CLIはHTTP経由でバックグラウンドサービスと通信し、そのサービスも計算そのものを実行しているわけではありません。OllamaのGoコードは、Ollamaのソフトウェア構成に含まれるコンパイル済みのC/C++推論エンジンを、2つ目のサーバープロセスとして起動し、サブプロセスとして使用します。
2つのレイヤーはどのように通信するのか
これはOllama自体のソースコード(llm/server.go)で確認できます。そこではollama_llama_serverというバイナリを探し、プラットフォームに応じた拡張子を付け、exec.Command(...)とパラメーターのリストを使って起動しています。それ以降、Goコードはこのプロセスを内部バックエンドとして扱います。
そのバイナリが起動すると、OllamaはローカルのHTTPポートで通信します。同じファイルにはhttp://127.0.0.1:%d/completion と/healthへのリクエストが示されており、これでシステムの構造を十分に把握できます。関与するサーバーは2つあります。ユーザーが操作するポート11434のOllama APIと、その背後で実際にモデルを実行し、モデルファイルを解析する下位レイヤーの推論エンジンです。
この分離がセキュリティ上重要な理由
モデルの読み込み、量子化、GGUFの解析といった負荷の高い処理は、すべてそのC/C++エンジンで行われます。このエンジンはメモリを直接扱い、元をたどれば外部から来たモデルファイルを処理しています。
Bleeding Llamaが存在したのは、まさにその部分です。悪意のあるGGUFファイルの解析中に、ヒープの境界外読み取りが発生しました。HTTPエンドポイントを公開するGoレイヤーは、単純で特に変わったところがないように見えます。バグがあるのは、その1つ下のレイヤー、Ollamaが動かしているエンジンです。「Ollamaの脆弱性」について読むとき、その実体は多くの場合、Ollamaがネットワーク経由でアクセス可能にした下位の推論レイヤーのバグです。
ローカルのモデルと、ネットワークにつながるサーバー
モデル自体はレジストリから取得します。初めてモデルを取得するとき、Ollamaはファイルをダウンロードして検証し、ディスクに書き込みます。通常、保存先はmacOSとLinuxでは~/.ollama配下、Windowsではユーザーディレクトリ内のどこかです。その後の処理はすべてローカルで行われます。モデルはドライブ上に置かれ、RAMまたはVRAMにマッピングされ、プロンプトはクラウドAPIではなくローカルサーバーに送られます
Ollamaはサーバーにデータを送信しますか?
多くの人が実際に気にしている会話の内容については、答えは単純です。Ollamaを使うと、プロンプトとモデルの回答は自分のマシン内にとどまります。モデルはディスク上のファイルを使って実行され、クラウドAPIへのリクエストはありません。「サービス改善のためにデータを使用する場合があります」という扱いも、質問を記録するプロバイダーもありません。
とはいえ、「マシンの外には何も出ない」という説明では、少し単純化しすぎています。ネットワークと通信するものもいくつかあります。
モデルをダウンロードするときはレジストリから取得するため、その運営者と、そこから提供されるファイルを信頼することになります。ほとんどの場合は問題ありませんが、それでもサプライチェーンリスクは残ります。汚染されたモデルは現実的な攻撃経路であり、自分のソフトウェア環境の中で他人の「データ」を実行することを選んでいるのです。
Ollama自体もネットワークと通信します。新しいリリースを確認し、一部のプラットフォームではアップデートを自動的に取得できます。これも外向きの接続であり、更新経路はすでに、問題が起こり得る箇所としてセキュリティの分析記事に登場しています。
バージョン情報やテレメトリーに関する小さな通信が行われる可能性もあります。これらにプロンプトは含まれませんが、あなたにとって「ローカル」が文字どおり「外向きの通信が一切ない」ことを意味するなら、Ollamaはその基準を満たしません。公平に言えば、現代のソフトウェアのほぼすべてが、その基準を満たしません。
これらの点は、プライバシーに関する基本的な利点を覆すものではありません。ローカルLLMはプライバシーを守れますか?最も気になる部分、つまり入力した内容と返ってくる内容については、はい、守れます。クラウドAPIでは、すべてのプロンプトとすべての文書が他者のサーバーに送られ、そこで記録されたり、分析に利用されたりする可能性があります。Ollamaでは、その内容は自分のマシン内に置かれ、処理されます。トレードオフの大半は、モデルの入手元と更新の仕組みに関するものであり、テキストが吸い上げられることではありません。
だからこそ、選ぶツールが重要です。「ノートパソコンの中にとどめる」ことが目的のすべてなら、ネットワーク設定を慎重に行うことに頼るのではなく、その考え方を軸に作られたソフトウェアを使ってください。Atomic Chatのようなデスクトップアプリは、そもそもネットワーク経由でアクセス可能なAPIを公開せずにコンピューター上でモデルを実行するため、こうした例外的な問題の大半を回避できます。「ローカル」は、ソフトウェアが設計によって徹底しなければならない性質です。そうでなければ、本当の意味でローカルとはいえません。
知っておくべきOllamaの脆弱性
Ollamaには、セキュリティに関するこれまでの実績があります。惨憺たるものではありませんが、「ローカルだから大丈夫」と片付けられるほど問題がないわけでもありません。
Probllama(CVE-2024-37032)
最初の大きな問題は、2024年半ばにWizが発見した、モデルを取得する部分である/api/pullendpointのパストラバーサルのバグでした。APIが受け付けるマニフェストでは、digestフィールドはSHA‑256ハッシュであることが想定されていましたが、Ollamaは実際にはそれを強制していませんでした。攻撃者はそのフィールドに../../../ を入れ、ホスト上の任意の場所にOllamaにファイルを書き込ませることができました。適切な標的ファイルを選べば、リモートコード実行につながります。
これが特に問題になったのは、Dockerのデフォルト構成です。コンテナー内ではOllamaサーバーがrootとして実行され、0.0.0.0にバインドされていたため、ネットワークからAPIにアクセスできる人なら誰でも、認証なしでrootとしてコードを実行できました。このバグは2024年5月に修正されたため、ある程度新しいバージョンを使っていれば対処済みです。ただし、入力の確認が不十分なサーバーに信頼できない入力が流れ込む、というパターンが明らかになりました。
Windows自動アップデーターの欠陥(CVE-2026-42248、CVE-2026-42249)
Windowsを使っている場合、今も問題となるのがこれらです。Strigaが2026年4月に詳しく報告しました。2つが組み合わさると更新の仕組みが破綻し、攻撃者がマシンに居座れるようになります。
最初のバグは単純です。Windowsビルドは、ダウンロードしたアップデートの署名を検証するはずの関数を呼び出しますが、その検証は事実上、何もしていません。ダウンロードされたものは何でも有効と見なされ、実行されます。
2つ目もパストラバーサルで、今回はアップデーターが更新のインストール先を決める方法に問題があります。パスの構成要素をHTTPレスポンスヘッダーから直接取り込んでいます。攻撃者が更新レスポンスを制御できれば、../を含むETagヘッダーを送り、インストーラーを誘導して実行ファイルをWindowsのスタートアップフォルダーに直接配置できます。
この2つを組み合わせると、永続化が可能になります。ペイロードはスタートアップに配置され、次回のログイン時に実行され、その後もログインのたびに警告なしで実行されます。影響を受けるのはWindowsだけで、macOSは別の更新機構を使っています。問題は0.12.10から 0.17.5までのWindowsビルドで確認されており、研究者は、その後の0.22.0までのリリースも影響を受ける可能性が高いと警告しました。調査結果の公開時点では、修正済みのWindowsビルドはリリースされておらず、Ollamaから返答がなかったと研究者は述べています。状況が変わるまでは、Windowsでは設定で「Auto‑download updates」をオフにし、この更新経路が一切実行されないようにするのが実用的な対策です。
Bleeding Llama(CVE-2026-7482)
冒頭で紹介した脆弱性であり、この中で最も直接的な「データ漏えい」を引き起こします。Cyeraが2026年5月中旬に公開し、評価は9.1です。GGUFモデルファイルを処理するコードである、モデル量子化パイプラインでのヒープ境界外読み取りです。OllamaはGGUFを読み込む際、ファイル内で宣言されたテンソルの次元を、実際に確保したバッファと照合せずに信用します。不整合なメタデータを含むファイルを与えると、バッファの末尾を越えて読み取り、隣接するメモリにたまたま存在する内容を返します。
その隣接メモリには、他のユーザーのプロンプト、システム指示、APIキー、環境変数が含まれる可能性があります。抽出を開始するには、API呼び出しが3回あれば十分でした。公開されたサーバーでは、これは認証を一切必要としない、直接的なデータ窃取になります。バージョン0.17.1で修正されましたが、公開時にはインターネットからアクセス可能な約300,000のインスタンスが脆弱な状態でした。
Ollamaのセキュリティ上の弱点に共通するパターン
3件のCVEを個別の事例として扱うこともできますが、共通点を見るほうが有益です。2024年には、OligoがOllamaに関する別の問題を6件報告しました。サービス拒否、モデルの窃取、モデル汚染に関するものでした。どの問題にも、APIが信頼できる環境を前提としているという、同じ想定が見られました。入力検証は限定的で、組み込みの認証機能はなく、サーバーは受け取ったものをそのまま処理します。
localhostで動かすことを想定したツールなら、これは妥当な出発点です。問題は、その想定でカバーできない形でOllamaが導入されるケースが増えていることです。他のマシンに公開されたり、さらにはインターネット全体に公開されたりしています。
本当のリスクはコードではなく、外部への公開
上記の脆弱性はいずれも、Ollamaインスタンスにネットワーク経由でアクセスできる場合、より深刻になります。
2025年から2026年にかけて行われたインターネット全体のスキャンでは、パブリックIPで待ち受けるOllamaサーバーが数十台報告されており、手法や時期によって推定値は約175,000台から300,000台の間にあります。多くの場合、これらは通常のインストール環境で、誰かがOLLAMA_HOST=0.0.0.0を設定し、別のマシンからOllamaにアクセスするためにポートを開け、その構成を維持したままにしているようです。
Ollamaには組み込みの認証機能がありません。APIキーも、ログインも、トークンもありません。サーバーは、そのポートに到達するものをすべて信頼できるものとして扱います。パブリックアドレス上では、エンドポイントを見つけた人なら誰でも、あなたのハードウェアでプロンプトを実行し、モデルの重みを取得したり送り込んだりでき、Bleeding Llamaの事例のようにプロセスメモリからデータを読み取れるということです。
公開されたエンドポイントはスキャンされます。一部の攻撃活動では、外部に公開されたサーバーを経由させて第三者のトラフィックを処理し、運用者は通常、予想外に高額な計算リソースの請求が届いて初めて気づきます。
ほとんどのインシデントは、堅牢化されたシステムに対する高度な攻撃手法によるものではありません。共通点はもっと単純で、認証のないAPIがインターネットからアクセスできる状態で放置されていたことです。これは設定の問題なので、修正できる問題でもあります。まずは、Ollamaインスタンスがどこに、どのように公開されているのかを正確に理解することから始めます。
Ollamaの監査:自分で実施するセキュリティ対策
ステップ1:インスタンスのバインド先を確認する
最も重要なのは、Ollamaがlocalhostだけで待ち受けているのか、すべてのネットワークインターフェースで待ち受けているのかという点です。これはOLLAMA_HOSTで制御されます。未設定または127.0.0.1なら、localhost限定なので、おおむね問題ありません。0.0.0.0、または特定のLAN IPやパブリックIPになっている場合、APIには自分のマシンの外からアクセスできます。
macOSまたはLinuxでは、サービスが実行される環境を確認します:
結果が空なら、実際に何が待ち受けているかも確認します:
Windowsでは、環境変数を確認します:
何も表示されないか、127.0.0.1が表示されれば、期待どおりです。0.0.0.0,が表示された場合は、そのまま先に進んでください。ステップ5で修正します。
ステップ2:ポート11434に外部からアクセスできるかをテストする
バインド先からわかるのは設定上の意図であり、実際の状態がわかるのはテストです。同じネットワーク上の別のデバイスから、またはインターネットからのアクセスをテストする場合はWi-Fiを切ってモバイル回線に接続したスマートフォンから、APIへのアクセスを試します:
モデルの一覧が返ってきた場合、そのコマンドを実行した人に対してポートが開いており、認証もありません。応答がないままになるか、接続を拒否される場合は、その場所からはアクセスできません。localhostからのテストは常に成功し、何もわからないため、必ず自分のマシンの外から実行してください。
ステップ3:バージョンを確認して更新する
上記のCVEの大半は現行リリースで修正されているため、古いOllamaを更新することは、簡単に効果を得られる対策です。バージョンを確認します:
Ollamaのサイトにある最新リリースと比較し、古い場合は更新してください。Windowsを使っている場合は、先にステップ4を読むのを忘れないでください。Windowsでは現在、更新機構そのものが問題になっているためです。
ステップ4:Windowsユーザーはアップデートの自動ダウンロードを無効にする
CVE-2026-42248とCVE-2026-42249が修正されるまでは、自動アップデーターは安全機能ではなく、リスク要因です。Ollamaの設定で「Auto-download updates」をオフにしてください。これにより、脆弱なコードの実行経路を遮断できます。
代わりに手動で更新してください:公式サイトから自分でインストーラーをダウンロードし、本物の配布元から取得したことを確認します。
ステップ5:ポートへのアクセスを制限する
ステップ1または2で外部に公開されていることがわかり、実際にはネットワークアクセスが不要なら、最もすっきりした対策は公開をやめることです。OLLAMA_HOSTを未設定にするか、127.0.0.1に設定してOllamaをlocalhostに戻し、サービスを再起動します。
他のデバイスからのアクセスが必要な場合でも、誰に対してもポートを開いたままにしてはいけません。ファイアウォールを使って、接続すべき特定のIPだけを許可します。ufwを使うLinuxでは、おおむね次のようになります:
範囲は、実際に信頼しているネットワークに合わせて調整してください。Windowsでは、Windows Defender Firewallで接続元のリモートアドレスを特定のものに限定した受信規則を作成し、同等の設定を行います。目的はどの環境でも同じです。ポートは信頼できるマシンに応答し、それ以外をすべて無視するようにします。
ステップ6:リモートアクセスを適切に構成する
外出先のノートパソコンから自宅サーバーに接続するなど、ネットワークの外からOllamaにアクセスする必要が本当にある場合でも、ルーターでポート11434をそのまま転送してはいけません。そうすると、インスタンスが先ほどのインターネットスキャンで見つかることになります。安全な選択肢は2つあります:
VPNを使ってプライベートネットワーク内に置きます。TailscaleやWireGuardは暗号化されたトンネルを提供し、Ollamaに届く接続は常にそのネットワーク内からのものだけになります。個人にとっては、これが実際に安全性を保てる最もシンプルな構成です。
または、その手前にリバースプロキシを置きます。NginxやCaddyを使えば、リクエストがOllamaに届く前に認証を要求でき、Ollama自体にはないログインレイヤーを追加できます。こちらは作業が増えるため、チームや本格的なサーバーにより適しています。
ステップ7:コンテナーで実行している場合はDockerを堅牢化する
Probllamaを非常に危険にしたのは、Dockerのデフォルト設定(rootユーザー、0.0.0.0へのバインド)でした。DockerでOllamaを実行する場合、ポートをすべてのインターフェースに公開してはいけません。ホスト上のlocalhostにバインドし(11434:11434ではなく127.0.0.1:11434:11434 )、隔離したDockerネットワーク内に置き、手前で認証を処理するものがない限り、ホストのパブリックインターフェースには公開しないでください。
この7つのステップを実施すれば、記録されているインシデントの大半で悪用された隙を塞げます。
ローカルLLMのセキュリティベストプラクティス:要点一覧
この大半は、Ollamaだけでなく、あらゆるローカル推論サーバーに当てはまります。運用しているなら、以下が実際にリスクを減らす対策です。
- 速やかにパッチを適用する:アップデートは実際の問題を修正しますが、多くの環境では古いビルドが何か月も動き続けています。ソフトウェア構成全体を最新に保つことが、最も簡単に効果を得られる対策です。
- 認証なしで推論APIを公開しない:APIに組み込みの認証機能がない場合、開け放たれた入り口と同じだと考えてください。手前に何らかの仕組み(リバースプロキシ、認証レイヤーなど)を置かない限り、公開してはいけません。
- localhostへのバインドを優先する:デフォルトでは127.0.0.1にしておき、誰がなぜ必要としているのかを正確に把握している場合に限り、外部アクセスを開放してください。
- リモートアクセスにはVPNを使う:TailscaleやWireGuardのようなツールは、ポート転送より安全です。サービスはプライベートネットワーク内に置くべきです。
- モデルの入手元を精査する:信頼できる入手元からモデルをダウンロードしてください。未知の作者による出所の不確かなGGUFファイルにはリスクがあります。Atomic Chatでは、すべてのモデルを精査しています。
- コンテナーとファイアウォール規則で隔離する:Docker内でネットワークを分離して、影響範囲を抑えます。
- 何が待ち受けているかを把握する:どのプロセスがどのポートで公開されているか、ときどき確認してください。新しいツールの追加や設定変更の後にも、再度確認します。
結局、Ollamaは安全ですか?
多くの人が使うべき方法、つまり自分のマシン上でローカルに実行し、最新の状態に保っていれば、十分に安全です。その構成ならプライバシー上の利点は実際にあり、最近のバグの大半も影響しません。それらはネットワークへの公開を前提としており、その環境では公開していないためです。
公開するとリスクが生じます。Ollamaには組み込みの認証機能がなく、無視できないCVEの履歴があり、さらにWindowsでは現在、独自のアップデーターに未修正の問題があります。この組み合わせを実効性のあるアクセス制御なしでネットワーク上に置けば、通常のスキャンを1回受けるだけで問題に直面しかねません。何十万台ものサーバーがBleeding Llamaにさらされたのは、そのためです。
したがって、「Ollamaは安全か」を、はいかいいえで問うのは適切ではありません。本当に問うべきなのは、どのように実行しているか、そして構成を確認したかどうかです。上の監査をまだ実施していないなら、次に取り組んでください。15分あれば、問題のない単独ユーザーなのか、それとも問題のある公開サーバーなのかを確認できます。
❓よくある質問
Ollamaは安全に使えますか?
ほとんどの人にとっては、安全です。自分のマシン上でローカルに実行し、最新の状態を保ち、APIをインターネット全体に公開しなければ、Ollamaは安全です。デフォルト構成ではOllamaはlocalhostでのみ待ち受けるため、コンピューターの外からはアクセスできず、プロンプトはディスク上にとどまります。設定を変更して0.0.0.0にバインドし、手前に認証を設けずにOllamaのポートを公開すると、安全ではなくなります。
Windows上のOllamaは安全ですか?
Windowsでは、より注意が必要です。Windows自動アップデーターの2つの問題(CVE-2026-42248とCVE-2026-42249)は、2026年5月時点でも未修正で、攻撃者がログインのたびに実行されるプログラムを配置できる可能性があります。これらのOllamaの脆弱性が完全に修正されるまでは、Ollamaの設定で「Auto-download updates」をオフにし、公式サイトから手動で更新してください。macOSとLinuxのビルドはこの2つの問題の影響を受けませんが、他の環境と同じLLMセキュリティのベストプラクティスは、引き続き有効です。
Ollamaはデータをサーバーに送信しますか?
Ollamaは設計上、プロンプトやモデルの回答をリモートサーバーに送信しません。推論は自分のハードウェア上で行われるため、デフォルトではテキストがクラウドプロバイダーに送られることはありません。ただし、Ollamaはいくつかの外向きのネットワークリクエストを行います。レジストリからのモデルのダウンロード、新しいバージョンの確認、軽量なバージョンチェックです。これらの呼び出しに会話の内容は含まれません。「Ollamaはサーバーにデータを送信するのか」や「ローカルLLMはデータを送信するのか」と検索する人にとって重要なのは、通常の利用はローカルで行われる一方、アプリがどのように、どこへ接続できるかは、引き続き管理する必要があるという点です。
ローカルLLMはプライバシーを守れますか?
ローカルLLMはクラウドAPIよりもはるかにプライバシーを保ちやすく、自分のマシン上で動作するため、プロンプトが第三者のプロバイダーに記録されたり、学習に再利用されたりすることはありません。実際のリスクは、サプライチェーン(モデルファイルやコンテナーの入手元)、公開されたポート、自動更新機構にあります。設定を誤り、ローカルLLMのポートを公開インターネット上に公開したままにすると。
Ollamaインスタンスが外部に公開されているかを確認するには?
Ollamaのポートが外部に公開されているかを確認するには、まずOLLAMA_HOSTの値を確認します。127.0.0.1、またはまったく設定されていない場合、Ollamaはlocalhostでのみ待ち受けています。0.0.0.0、または特定のLAN IPやパブリックIPの場合、APIはそのネットワークインターフェースで待ち受けます。次に、別のデバイスから以下を実行します:
モデルの一覧が返ってきた場合、そのポートにはアクセス可能で、認証もありません。その場合は、ファイアウォール規則を見直し、信頼できるマシンだけが接続できるように、ローカルLLM環境のセキュリティを強化してください。




