


Z.aiのGLMは、ローカルで実行できる特に高性能なオープンウェイト言語モデルの一つです。このガイドでは、次の内容を解説します。
- ハードウェアに合うGLMモデルの選び方
- GLMを実行するローカルAIアプリのインストール方法
- GLMモデルをオフラインで実行する方法
GLMとは?
GLMはGeneral Language Modelの略で、北京のAI研究機関Z.ai(旧称Zhipu AI)が開発したモデルファミリーです。特に高性能なオープンソースモデルを開発することで知られています。最新のGLMリリースはHugging Faceで確認できます。
現在のオープンウェイトGLMのラインアップ:
| モデル | アーキテクチャ | コンテキスト | 主な用途 |
|---|---|---|---|
| GLM-4.7-Flash | MoE、総数30B / アクティブ約3.6B | 200K | 一般向けハードウェアでのコーディングとエージェントのタスク |
| GLM-4.7 | MoE、総数355B / アクティブ32B | 200K | ワークステーションでの高度なコーディングと推論 |
| GLM-5.1 | MoE、総数753.9B / アクティブ約40B | 198K | 最先端クラスのエージェント型コーディング |
| GLM-5.2 | MoE、総数753.3B / アクティブ約40B | 1M | 最先端クラスの推論とコーディング |
GLMはMixture-of-Experts(MoE)アーキテクチャを採用し、クエリごとにパラメータの一部だけを有効にします。たとえばGLM-4.7-Flashは約300億パラメータを含みますが、生成するトークンごとに使うのは約36億だけです。推論時の計算量を減らすことで、大きなGLMモデルも動かしやすくなります。また、ハードウェアの節で説明するように、GLMはCPUへのオフロードにも特に適しています。
GLMは、次の特徴でも知られています。
- 高性能な推論(「思考」)モード
- 確かなツール呼び出し対応。Z.aiはコーディングエージェント向けに特化した学習を行っています。
GLMのベンチマーク
下の表は、さまざまなモデルを共通の採点方式で評価するArtificial AnalysisのIntelligence IndexにおけるGLMのスコアです。
比較の参考として、プロプライエタリなクラウドモデルのGemini 3.6 Flashと、これを上回る唯一のオープンウェイトモデルであるKimi K3も掲載しました。スコアはIntelligence Index v4.1です。GLM-4.7-Flashの値は完全な評価実行の結果ではなく、Artificial Analysisによる推定です。
| モデル | Intelligence Index |
|---|---|
| Kimi K3 | 57 |
| GLM-5.2(推論あり) | 51 |
| Gemini 3.6 Flash | 50 |
| GLM-4.7(推論あり) | 34 |
| GLM-5.2(推論なし) | 34 |
| GLM-4.7-Flash(推論あり) | 23 |
Z.aiは、GLM-5.2の性能がOpus 4.8に近いことを示す評価結果も公開しています。
| ベンチマーク | GLM-5.2 | GLM-5.1 | GLM-4.7 | Claude Opus 4.8 |
|---|---|---|---|---|
| AIME 2026 | 99.2 | 95.3 | — | — |
| GPQA-Diamond | 91.2 | 86.2 | 85.7 | 93.6 |
| Terminal-Bench 2.1 | 81.0 | 63.5 | — | 85.0 |
| FrontierSWE | 74.4 | 30.5 | — | 75.1 |
| SWE-bench Pro | 62.1 | 58.4 | — | 69.2 |
| HLE(ツール使用あり) | 54.7 | 52.3 | 42.8 | 57.9 |
GLMをローカルで実行する方法
GLMに限らず、AIモデルをローカルで動かすには、モデルファイルをダウンロードし、マシン上で実行する推論アプリが必要です。
このガイドでは、私たちが開発した無料のオープンソースのローカルAIアプリAtomic Chatを例にしますが、Ollama、LM Studio、その他のAI推論プロバイダーも同じように使えます。
GLMはGGUFファイルから実行します。GGUFは、OllamaやLM Studioなど、主要な推論エンジンやアプリが対応する標準形式です。
1. Atomic Chatをインストールする
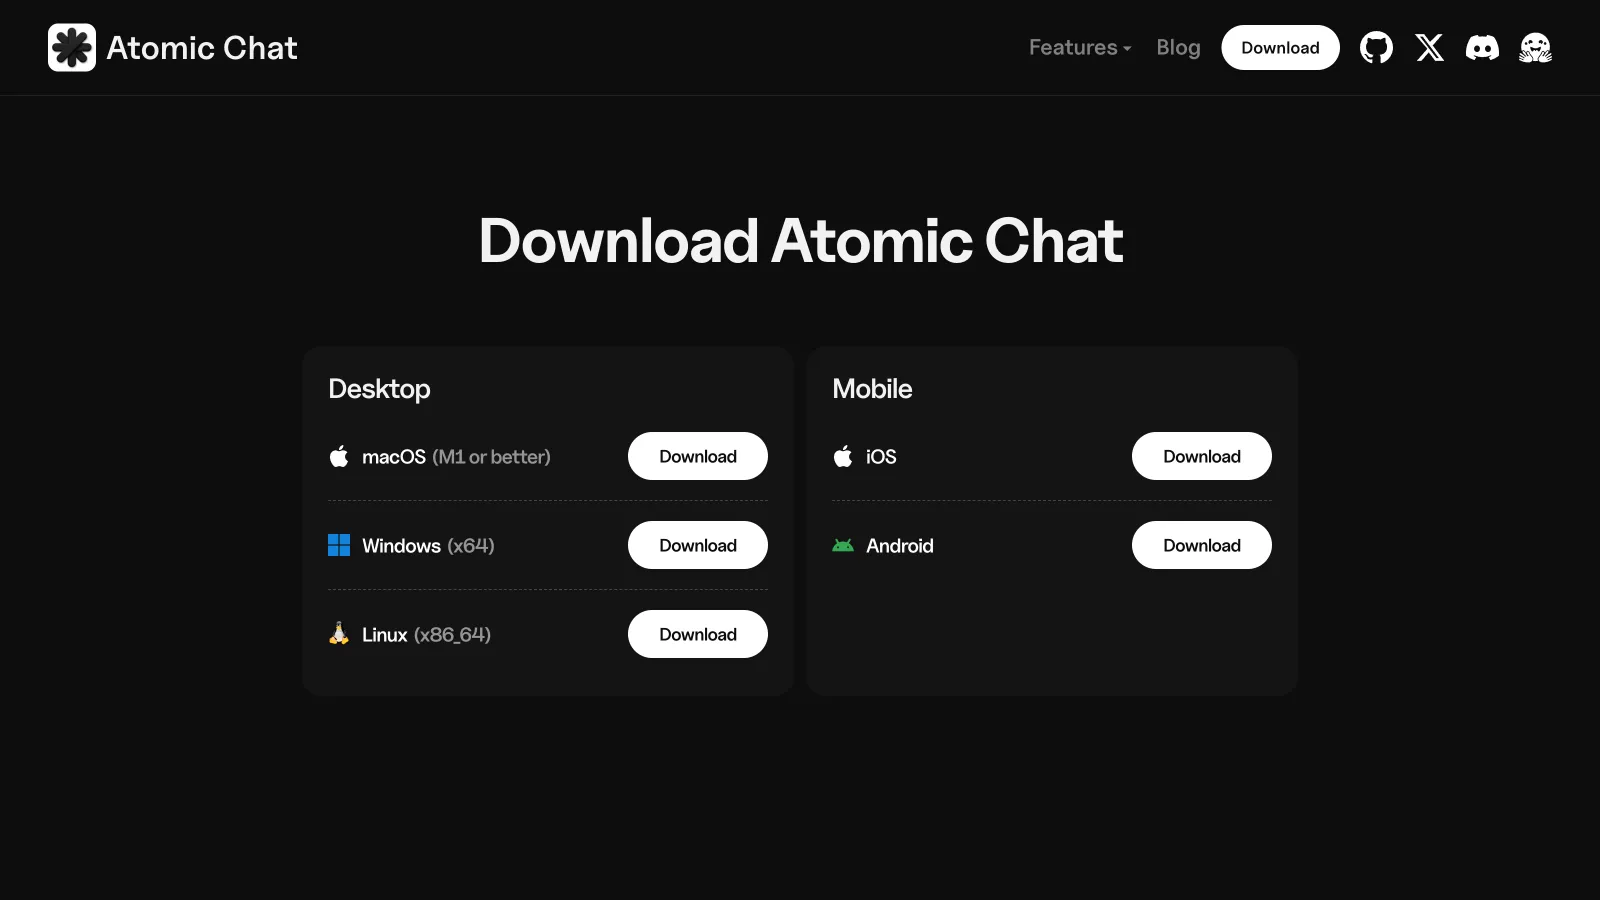
Atomic Chatで手順を進める場合のインストール方法です。atomic.chatにアクセスし、プラットフォームに合うビルドを選びます。
- macOS:IntelとApple Siliconに対応するユニバーサル
.dmg。macOS 13.6以降が必要です。 - Windows:x64向けの
.exeインストーラー。 - Linux:root権限が不要なx86_64向け単体
.AppImage。 - iOS:App Storeから入手。
- Android:Google Playから入手。
Linuxでは、chmod +xでAppImageに実行権限を付け、直接実行します。初回起動時にFUSEが必要と表示された場合は、DebianやUbuntuではsudo apt install fuse libfuse2、Fedoraではsudo dnf install fuse fuse-libsでインストールしてください。
2. GLMモデルを探す
Atomic Chatをインストールしたら、アプリを開いてModelsへ進みます。Modelsカタログには、Hugging Faceで公開されている実行可能なオープンウェイトモデルがすべて表示され、ローカルLLMを探し、ダウンロードし、管理できます。
GLMを検索するには、検索欄をクリックしてglmと入力します。利用できるGLMモデルが表示されます。
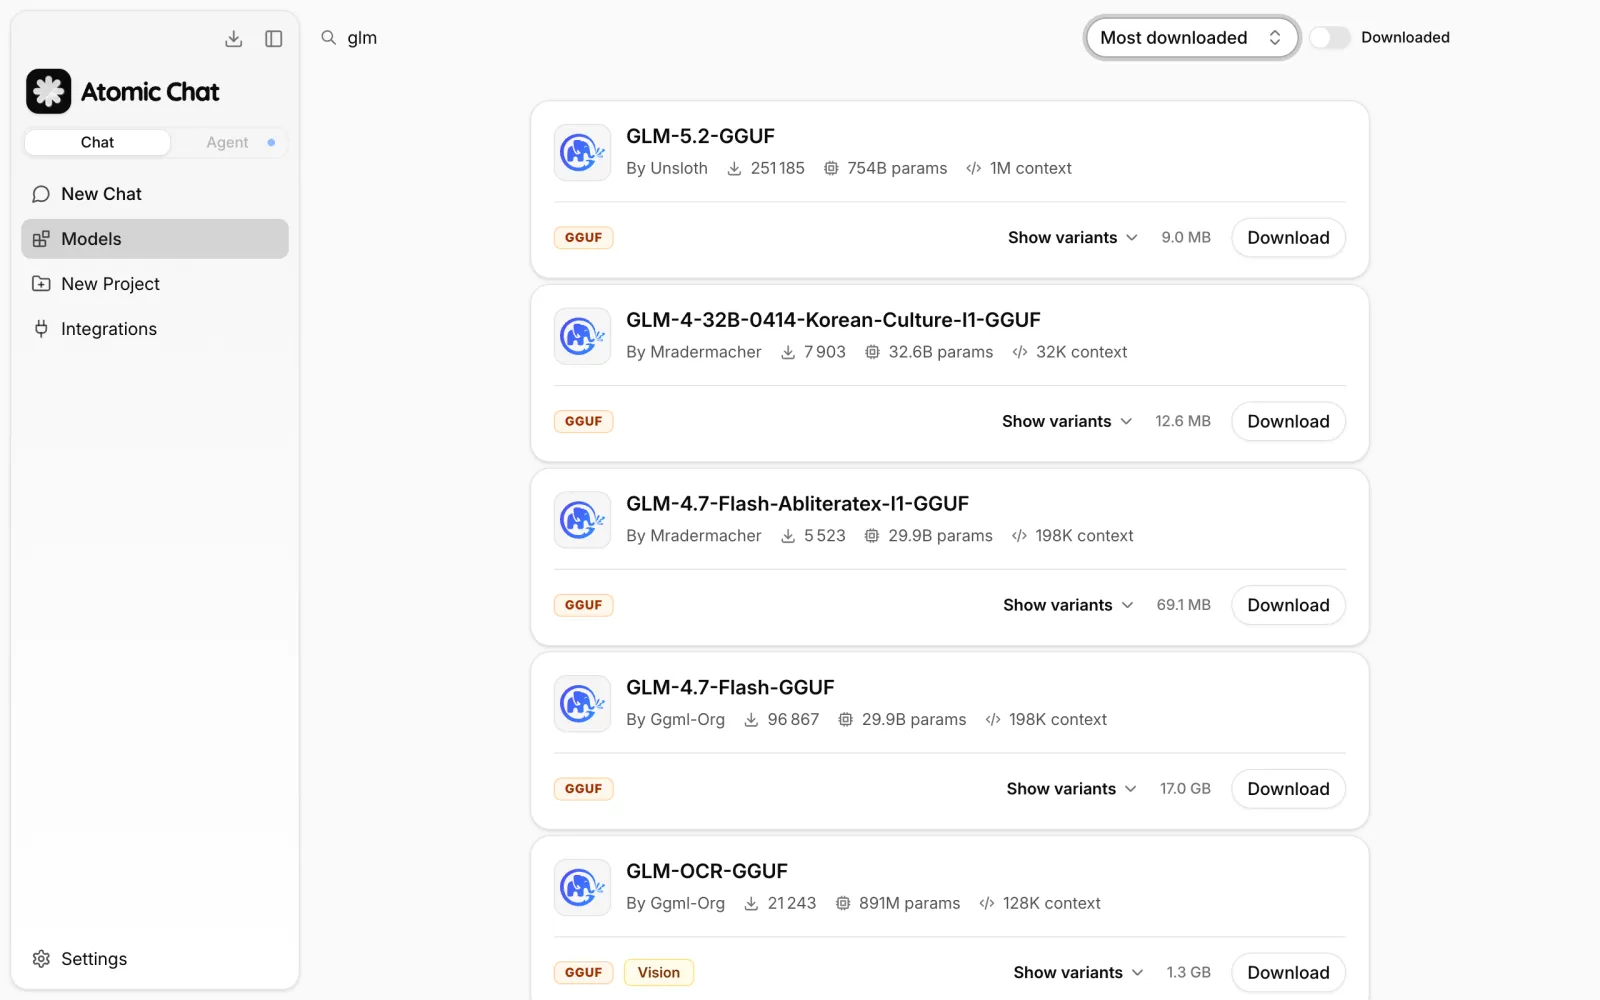
モデルカードには、次の情報が表示されます。
- パラメータ数:モデルのサイズ。GLM-4.7-Flashなら29.9Bなどです。
- コンテキスト長:モデルが対応するコンテキストウィンドウの最大値。
- タグ:GGUF(モデル形式)やVision(マルチモーダル処理への対応)などのメタデータ。
- ダウンロードサイズ:選んだモデルファイルのディスク上のサイズ。
デフォルトでは、新しいリリース順に並びます。Downloadedフィルターを有効にすると、マシン上ですでに利用できるモデルだけを表示できます。
3. GLMモデルをダウンロードする
推奨される版をダウンロードするには、Downloadをクリックします。
特定の量子化版を選びたい場合は、Download Optionsを選択すると、利用できるGGUFリリースがすべて表示されます。

一つのモデルには通常、複数の量子化版があります。たとえばGLM-4.7-Flashには、次のような版があります。
- Q2_K
- Q3_K_M
- Q4_K_M
- IQ4_XS
これらは量子化レベルで、モデルの重みをどのように圧縮したかを表します。Q2のような小さい量子化版はストレージやメモリをあまり使わず、Q8やQ16のような大きい版は一般に元のモデルの精度をより多く保持します。詳しくは、GGUFと量子化の仕組みをご覧ください。
システムに合う量子化版の選び方は、記事の後半で説明します。
4. GLMとチャットを始める
ダウンロードが終わると、Atomic Chatがモデルを自動で読み込み、内蔵のチャット画面で開きます。
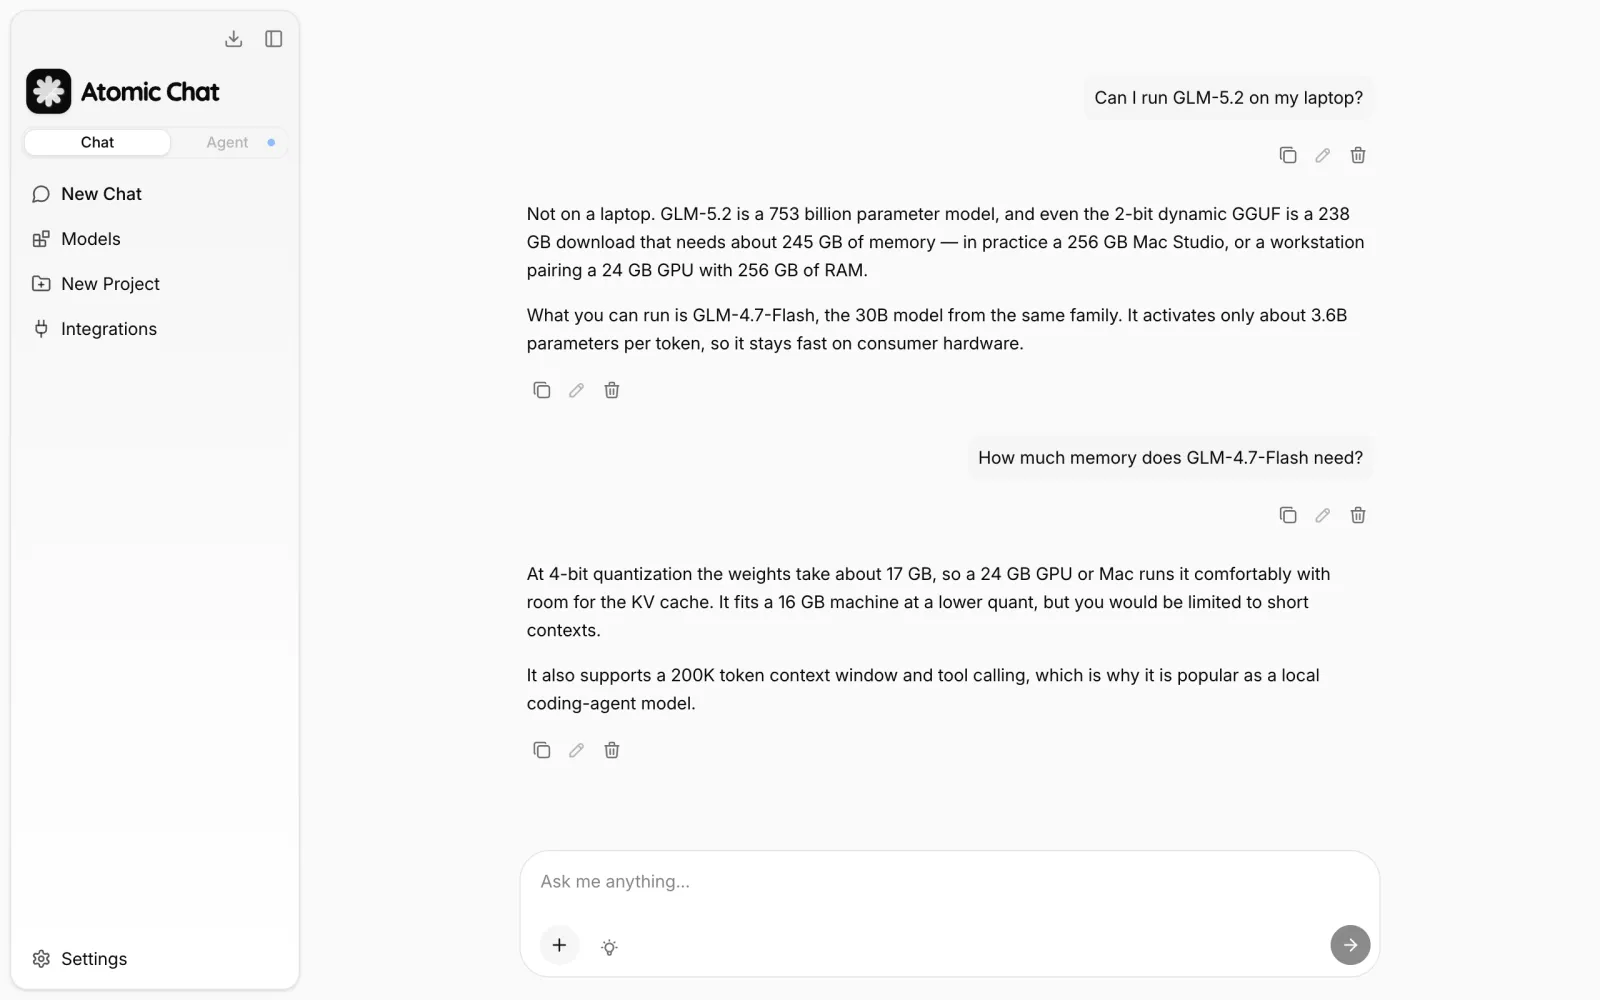
これで準備は完了です。
GLMのハードウェア要件
代表的な量子化レベルでGLMを実行するために必要なメモリは次のとおりです。KVキャッシュやシステム用の余裕を含めた、推奨される合計容量です。
| モデル | 2ビット | 4ビット | 8ビット | BF16 |
|---|---|---|---|---|
| GLM-4.7-Flash | 約16 GB | 約24 GB | 約36 GB | 約64 GB |
| GLM-4.7 | 約128 GB | 約210 GB | 約400 GB | 約750 GB |
| GLM-5.1 | 約245 GB | 約490 GB | 約880 GB(FP8) | >1.5 TB |
| GLM-5.2 | 約245 GB | 約490 GB | 約880 GB(FP8) | >1.5 TB |
たとえば、GLM-4.7-Flashの4ビット版は約17 GBのファイルです。表の約24 GBには、重みとは別にKVキャッシュやシステムが通常使う3-4 GBを加えています。
ほかのGLMは基本的にワークステーション級以上のモデルですが、レンタルGPUでも実行できます。手順はレンタルのグラフィックカードでKimi K3を実行する方法で説明しています。
自分のシステムやレンタルGPUでGLMを動かす際の、ハードウェア別の推奨構成です。
| ハードウェア | モデル | 量子化 |
|---|---|---|
| MacBook Air M2/M3 (16 GB) | GLM-4.7-Flash | IQ2 / Q3 |
| MacBook Pro M4 Pro (24 GB) | GLM-4.7-Flash | Q4 |
| RTX 3090 / RTX 4090 (24 GB VRAM) | GLM-4.7-Flash | Q4 |
| MacBook Pro M4/M5 Max(36-48 GB) | GLM-4.7-Flash | Q4またはQ8 |
| Mac Studio / ワークステーション(64 GB以上) | GLM-4.7-Flash | Q8またはBF16 |
| MacBook Pro / Mac Studio (128 GB) | GLM-4.7 | 2ビット動的量子化 |
| Mac Studio M3 Ultra (256 GB+) | GLM-5.2 | 2ビット動的量子化 |
| 24 GBのGPU + 256 GBのシステムRAM | GLM-5.2 | 2ビット動的量子化 |
前述のとおり、GLMはMixture-of-Experts(MoE)アーキテクチャを使うため、デンスモデルよりもGPUへのオフロードを実用的に行えます。たとえばGLM-5.2が1トークンに使うのは、753Bパラメータのうち約40Bです。そのため、推論エンジンはアテンション層と共有の重みをGPUに残し、エキスパート層をシステムRAMに移せます。24 GBのGPUと256 GBのRAMがある構成なら、この方法でGLM-5.2を実行できますが、性能には限界があります。速度の目安は毎秒3-9トークンです。
一方、GLM-4.7-FlashはVRAMに完全に収まり、同程度のハードウェアで毎秒60-100トークンほどに達します。
GLMの大型MoEモデルは、小型のデンスモデルに比べて強い量子化にも耐えやすい性質があります。小型モデルでは2ビット量子化で品質が大きく損なわれる場合がありますが、最先端規模のMoEモデルには十分なパラメータの冗長性があり、低いビット数でも実用性を保てます。その点で、特に使い道の多いGLMビルドとして、Unslothの動的GGUFリリースがあります。
- GLM-5.2 UD 2-bit:238 GBで、BF16の1.51 TBに比べて小さくなっています。Unslothのテストによると、フル精度の約82%の精度を保ち、RAMとVRAMの合計、またはユニファイドメモリとして約245 GBが必要です。
- GLM-5.2 UD 1-bit:217 GB。メモリ使用量が最小で、精度は約76%です。コンテキスト用にさらに余裕が必要な256 GBのシステムに向いています。
- GLM-5.2 UD-Q4_K_XL / UD-Q5_K_XL:品質の劣化がほとんどない版で、500 GB以上のメモリを持つ複数GPUのシステム向けです。
- GLM-4.7 2ビット動的量子化:約120 GBで、355Bモデルをユニファイドメモリ128 GBのMacで実行できます。
よくある質問
GLMをローカル実行する際によくある質問です。
GLMのローカル実行に必要なRAMやVRAMはどのくらいですか?
GLM-4.7-Flashを4ビット量子化で実行するには、RAM、VRAM、またはユニファイドメモリが約24 GB必要です。ほかのGLMモデルのハードウェア要件は次のとおりです。
- GLM-4.7:4ビット量子化で約210 GBを推奨
- GLM-5.1とGLM-5.2:2ビット動的量子化で約245 GBを推奨
これらは、GPU推論に必要なVRAM、またはApple Silicon Macのユニファイドメモリの容量を示します。
GLM-5.2をローカルで実行できますか?
理論上は可能ですが、GLM-5.2をローカル実行するにはワークステーション級のグラフィックカードが必要です。たとえば、UnslothのGLM-5.2の2ビット動的GGUF版には、KVキャッシュを除いても、ユニファイドメモリ256 GBのMac Studio、または24 GBのGPUと256 GBのシステムRAMをMoEオフロードで組み合わせたLinuxマシンが必要です。24 GBのGPU1枚で動くGLM-4.7-Flashが、ローカル実行には最も適したGLMモデルです。
GLM 5.2は無料ですか?
はい。GLM-5.2はMITライセンスで公開されているため、ダウンロードもローカル実行も無料で、費用は電気代だけです。GLMを動かすアプリの多くも無料です。Ollama、LM Studio、当社のローカルAIアプリAtomic Chatもこれに含まれます。
どのGLMモデルを使うべきですか?
一般向けハードウェアでローカル実行するなら、GLM-4.7-Flashの4ビット量子化版をおすすめします。同クラスで特に高性能なモデルの一つであり、24 GBのGPU1枚、または同容量のユニファイドメモリを搭載したMacで実行できます。
GLMはオフラインで動きますか?
はい。モデルのダウンロード後は完全にオフラインで実行できます。ローカル推論アプリを使う場合、プロンプトと応答は自分のデバイス上で処理されます。
GLMは無料で商用利用できますか?
はい。GLMのオープンウェイトモデルは、特に制約の少ないライセンスの一つであるMITライセンスで公開されています。次のことが認められています。
- 商用利用
- 改変
- 再配布
まとめ
GLMは、現在利用できる特に高性能なオープンウェイトのモデルファミリーの一つです。十分なメモリがあればフラッグシップのGLM-5.2もローカル実行できますが、一般向けハードウェアにはGLM-4.7-Flashが最も適しています。モデルを選んだら、Atomic Chat、LM Studio、Ollamaなどのローカル推論エンジンを用意します。GGUFビルドをダウンロードし、好みのアプリで読み込めば、GLMを完全オフラインで使えます。
関連ガイド
ローカルAIモデルを比較している場合や、初めてローカルLLMを設定する場合は、次のガイドも参考になります。




