
この記事では、小型のローカルモデルから、ClaudeやOpenAIが提供する最高性能のモデルと互角に渡り合う最先端レベルのAIまで、2026年に実行できるおすすめのオープンソースLLMを比較します。おすすめのオープンソースモデルと、自分のマシンでローカル実行する方法を紹介します。
オープンソースモデルとオープンウェイトモデルの違い
おすすめのオープンソースモデルを紹介する前に、ひとつだけ確認しておきましょう。厳密には、オープンソースモデルとは、重み、学習コード、データを含め、そのモデルを再現するために必要なものすべてを、商用利用も含めて自由に使えるライセンスで開発元が公開したモデルのことです。これを実践している開発元はごくわずかです。
その代わりに、開発元はモデルをオープンウェイトとして公開しています。これは、開発元が完成した重みだけを公開するモデルです。ただし、実用上は重みを自由にダウンロードしてローカルで実行でき、多くの場合は商用利用もできます。
オープンソースライセンスを理解する
また、オープンウェイトモデルにはさまざまなライセンスが適用されます。大半のライセンスはダウンロード、実行、商用利用を認めているため、ほとんどのユーザーにとって、モデルがどのライセンスで公開されているかは問題になりません。ただし、いくつかの細かな違いは把握しておく必要があります。もっとも、モデルを非常に成功した商用プロジェクトで使わない限り、こうした違いが問題になることはありません。広く使われているモデルのライセンスは次のとおりです。
- MITとApache 2.0では、許可を得ずにモデルを商用利用し、改変し、製品に組み込んで提供できます。GLM-5.2、DeepSeek-V4、Qwen3.6、Gemma 4、Hunyuan Hy3は、これらのライセンスで公開されています。
- Modified MITには、製品の売上高またはユーザー数が一定の基準を超えた場合にクレジットを表記するという、軽い条件が加わります。MoonshotのKimiモデルは、このライセンスで公開されています。
- コミュニティライセンスは商用利用を認めていますが、クレジットの表記が必要で、年間売上高が$20Mを超える場合はベンダーの書面による許可も必要です。MiniMax-M3モデルは、このライセンスで公開されています。
- 研究専用ライセンスと非商用ライセンスでは、重みのダウンロード以外は認められていません。MiniMax-M2.7は2026年3月にこのライセンスで公開されましたが、コミュニティの反発を受けて、MiniMaxは後継のM3で、より利用しやすいコミュニティライセンスに移行しました。
2026年のおすすめオープンソースLLMは?
最適なモデルの定義は、多くの場合「自分の用途に最適なモデルは何か」に行き着きます。そこで、サイズや設計が異なるモデルを取り上げ、自分で実行しやすい順に並べました。一般消費者向けハードウェアに収まるモデルを先に、データセンター規模のフラッグシップを後に配置しています。各モデルをこのリストに選んだ理由は、以下で詳しく説明します。
| モデル | 開発元 | パラメータ数 | コンテキスト長 | ライセンス | 最適な用途 |
|---|---|---|---|---|---|
| Qwen3.6 | Alibaba | 27Bのデンスモデル | 262K | Apache 2.0 | 自分の環境での実行 |
| Gemma 4 | 2B~31B | 256K | Apache 2.0 | 小型モデルの利用とノートPCでの実行 | |
| gpt-oss-120b | OpenAI | 117B(アクティブ5.1B) | 128K | Apache 2.0 | OpenAIのオープンモデルという選択肢 |
| Hunyuan Hy3 | Tencent | 295B(アクティブ21B) | 256K | Apache 2.0 | ギガバイトあたりの性能 |
| Command A+ | Cohere | 218B(アクティブ25B) | 128K | Apache 2.0 | 企業向けRAG |
| GLM-5.2 | Z.ai | 753B(アクティブ40B) | 1M | MIT | 総合的な最良の選択肢 |
| DeepSeek-V4-Pro | DeepSeek | 1.6T(アクティブ49B) | 1M | MIT | 大規模な長文コンテキスト処理 |
| Kimi K3 | Moonshot AI | 2.8T | 1M | Modified MIT | 最先端レベルのエージェント処理 |
| MiniMax-M3 | MiniMax | 428B(アクティブ23B) | 1M | コミュニティ | マルチモーダル+1Mコンテキスト長 |
| Nemotron 3 Ultra | NVIDIA | 550B(アクティブ55B) | 1M | OpenMDW-1.1 | 最も包括的なオープン公開 |
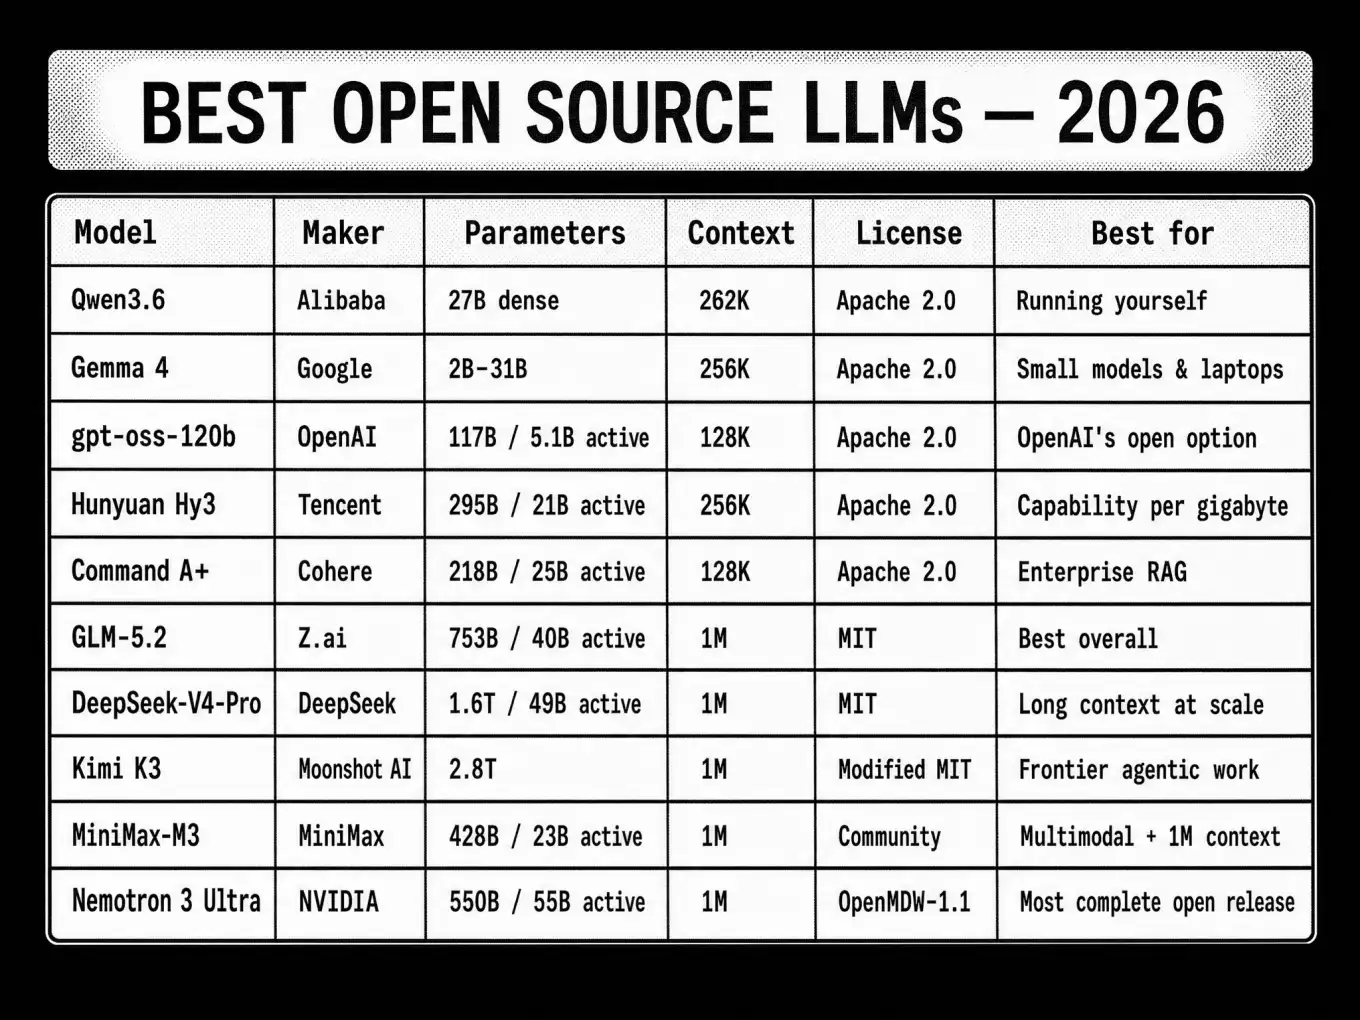
2026年のおすすめオープンソースLLM 10選を比較
まずは、オープンソースLLMのランキングを見てみましょう。最もよく引用される3つのベンチマークで、おすすめのオープンソースLLMを比較します。
| モデル | SWE-bench Verified | GPQA Diamond | MMLU-Pro |
|---|---|---|---|
| Qwen3.6-27B | 77.2 | 87.8 | 86.2 |
| Gemma 4 31B | — | — | 85.2 |
| gpt-oss-120b | 62.4 | — | — |
| Hunyuan Hy3 | — | — | — |
| Command A+ | — | — | — |
| GLM-5.2 | — | 91.2 | — |
| DeepSeek-V4-Pro | 80.6 | — | 87.5 |
| Kimi K3 | — | — | — |
| MiniMax-M3 | 80.5 | 93.0 | — |
| Nemotron 3 Ultra | 70.7 | — | 86.8 |
注:Kimi K3、Hunyuan Hy3、Command A+の行は空欄です。それぞれ独自のベンチマークセットで結果を報告しており、直接比較できないためです。
1. Qwen3.6
2026年4月に公開されたQwen3.6は、Alibabaのオープンウェイトモデルです。一般消費者向けハードウェアで動くため、ローカルでの導入に最も人気のあるLLMのひとつです。
Qwen3.6ファミリーには多くのバリエーションがありますが、まずはデンスモデルの27B版を検討することをおすすめします。
仕様:
| 仕様 | Qwen3.6 |
|---|---|
| バリエーション | 27Bデンスモデル、35B-A3B MoE |
| コンテキスト長 | ネイティブで262K、YaRN使用時は約1M |
| 入力 | テキストと画像 |
| 公開時期 | 2026年4月 |
| ライセンス | Apache 2.0 |
ベンチマーク:
| ベンチマーク | 27B | 35B-A3B |
|---|---|---|
| SWE-bench Verified | 77.2 | 73.4 |
| GPQA Diamond | 87.8 | 86.0 |
| MMLU-Pro | 86.2 | 85.2 |
| LiveCodeBench v6 | 83.9 | — |
| Terminal-Bench 2.0 | 59.3 | — |
| AIME 2026 | 94.1 | — |
| SWE-bench Pro | 53.5 | — |
| VideoMMU | — | 83.7 |
ご覧のとおり、27Bのデンスモデルは、より大きな35BのMoEモデルをも上回っています。そのため、システムで実行できるのであれば、このバリエーションから始めることをおすすめします。
また、このモデルのSWE-bench Verifiedのスコアは77.2で、DeepSeek-V4-Proとほぼ同じです。DeepSeek-V4-Proはこの記事の後半で紹介する別の人気オープンウェイトモデルですが、パラメータ数ではDeepSeekのほうが59倍大きいにもかかわらず、この結果となっています。
27Bに必要なハードウェア:
| 量子化 | サイズ | ハードウェア |
|---|---|---|
| BF16 | 約54GB | RTX PRO 6000 96GBまたは2× RTX 5090 |
| 8ビット | 約28GB | RTX 5090 32GB |
| 4ビット | 約15GB | RTX 5080 16GBまたはRTX 4090 24GB |
最適な用途:セルフホスティングと、オフラインのローカルAIエージェントの実行。27Bは24GB GPU 1基で実行できます。
2. Gemma 4
Gemma 4も、ローカルで実行できる小型のオープンウェイトモデルです。Google DeepMindが開発し、2026年4月に公開されました。
特に、このファミリーにはマルチモーダル入力をネイティブでサポートする2B版と4B版があり、動画や画像に加えて、最大30秒の発話の音声処理にも対応しています。こうした小型のバリエーションは最近のスマートフォンでも動くため、オンデバイスAIに最適ですが、控えめなハードウェアでローカルモデルを実行するユーザーにも役立ちます。
そのため、Gemma 4が2026年に最も多くダウンロードされたオープンモデルファミリーとなったのも不思議ではありません。執筆時点でHugging Faceで最も人気のあるバリエーションは31BとE4Bで、ダウンロード数は1,400万回を超えていました。
仕様:
| 仕様 | Gemma 4 |
|---|---|
| バリエーション | E2B、E4B、12B、26B-A4B MoE、31Bデンスモデル |
| コンテキスト長 | サイズに応じて128K~256K |
| 入力 | テキスト、画像、動画、音声 |
| 公開時期 | 2026年4月 |
| ライセンス | Apache 2.0 |
Gemma 4は、このファミリーで初めて、制約の少ないApacheライセンスで公開されました。以前のGemmaでは、Googleが独自に変更を加えた、制限付きの利用規約が使われていました。
ベンチマーク:
| バリエーション | MMLU-Pro |
|---|---|
| E2B | 60.0 |
| E4B | 69.4 |
| 12B | 77.2 |
| 26B-A4B | 82.6 |
| 31B | 85.2 |
Gemma 4 31Bの性能はQwen3.6 35Bとほぼ同水準です。ローカルでの導入に適したオープンウェイトモデルの中でも、最も知的能力の高いモデルのひとつです。
必要なハードウェア:
| バリエーション | 4ビットでのサイズ | ハードウェア |
|---|---|---|
| E4B | 約3GB | 最近のノートPCまたはスマートフォンならどれでも |
| 12B | 約7GB | RTX 5060 8GB |
| 26B-A4B | 約14GB | RTX 5080 16GB |
| 31B | 約18GB | RTX 4090 24GBまたはRTX 5090 |
最適な用途:控えめなハードウェアでの高度なローカルAIの実行。
3. gpt-oss-120b
gpt-oss-120bは、GPT-2以降に登場したOpenAIの最新オープンウェイトモデルです。OpenAIは、社名に文字どおりopenが入っているにもかかわらず、オープンモデルをあまり公開しません。そのため、現在ではやや古くなっているとはいえ、たとえばコンテキスト長がわずか128Kトークンと小さいものの、ChatGPTのような体験をローカルで再現するうえで、私たちが利用できる最良のモデルです。
もはや最高のオープンウェイトモデルではありませんが、GPT OSSファミリーはツールのサポートが充実しており、アクティブパラメータ数がわずか5.1Bと小さいため、総パラメータ数の割に実行しやすいのが特徴です。
仕様:
| 仕様 | gpt-oss-120b |
|---|---|
| 総パラメータ数 | 117B |
| アクティブパラメータ数 | 5.1B |
| コンテキスト長 | 128Kトークン |
| 公開時期 | 2025年8月 |
| ライセンス | Apache 2.0 |
ベンチマーク:
| ベンチマーク | スコア | 評価環境 |
|---|---|---|
| SWE-bench Verified | 62.4 | OpenAI社内のエージェント実行フレームワーク |
| SWE-bench Verified | 26.0 | swebench.comのbash専用エージェント |
ベンチマークの結果は評価環境によって大きく変わり、このモデルではOpenAI自身が報告した数値が独立した評価の数値を大きく上回っている点に注意してください。判断の際に考慮しておきたい点です。
必要なハードウェア:
| 量子化 | サイズ | ハードウェア |
|---|---|---|
| MXFP4 | 約61GB | H100 80GB、RTX PRO 6000、または64GBのMac |
gpt-oss-120bを実行するハードウェアがない場合は、gpt-oss-20bを検討してください。必要なメモリは約13GBで、RTX 5060 Ti 16GB以上で動きます。
最適な用途:OpenAIらしい振る舞いをするLLMのセルフホスティング。
4. Hunyuan Hy3
Hunyuan Hy3は、Tencentが2026年7月6日に公開したオープンモデルです。パラメータ数は295Bですが、FP8では300GB未満、公式の4ビット量子化では100GB未満に収まりながら、兆単位のパラメータを持つモデルと競合する位置づけです。128GBを超えるVRAMまたは統合メモリがあれば、ローカルで実行できます。
仕様:
| 仕様 | Hunyuan Hy3 |
|---|---|
| 総パラメータ数 | 295B |
| アクティブパラメータ数 | 21B |
| コンテキスト長 | 256Kトークン |
| 公開時期 | 2026年7月 |
| ライセンス | Apache 2.0 |
このモデルを商用利用する場合は、ライセンスを読んでください。4月の公開時には、プレビュー版にEU、英国、韓国を対象外とする地理的制限がありましたが、7月のライセンス変更で撤廃されました。把握しておきたい点です。
必要なハードウェア:
| 量子化 | サイズ | ハードウェア |
|---|---|---|
| FP8 | 約295GB | 4× H200 |
| 4ビットGGUF | 約100GB | 128GBのMac Studioまたは2× RTX PRO 6000 |
| 1ビットGGUF | 約45GB | RTX PRO 6000 96GBまたは64GBのMac |
4ビットと1ビットのGGUFは、Tencentによる公式リリースです。これは珍しいことで、ほとんどの研究機関は、大幅にビット数を削減する量子化をコミュニティに任せています。
最適な用途:128GBのワークステーションやMac Studioのような大容量メモリ搭載マシン1台で、フラッグシップに近い品質を得ること。
5. Command A+
Command A+は、Cohereが2026年5月に公開したオープンウェイトモデルです。他のモデルと異なる特徴は、引用生成機能がモデルの重みに直接組み込まれていることです。たとえばPerplexityのように、モデルが返すすべての回答に出典の引用が付きます。この独自機能により、詳細な調査を行うアプリケーションや、モデルが提供する情報の出所について透明性が必要な場面で、有力な候補となります。
仕様:
| 仕様 | Command A+ |
|---|---|
| 総パラメータ数 | 218B |
| アクティブパラメータ数 | 25B |
| コンテキスト長 | 128Kトークン |
| 言語 | 48 |
| 公開時期 | 2026年5月 |
| ライセンス | Apache 2.0 |
ベンチマーク:
| ベンチマーク | スコア |
|---|---|
| τ²-Bench Telecom | 85.0 |
| Terminal-Bench Hard | 25.0 |
| MMMU-Pro | 63.0 |
注:これは情報検索モデルのため、SWE-benchやGPQAの数値は公開されていません。
必要なハードウェア:
| 量子化 | サイズ | ハードウェア |
|---|---|---|
| BF16 | 約436GB | 8× H100 |
| FP8 | 約218GB | 4× H100 |
| W4A4 | 約110GB | 2× H100または128GBのMac Studio |
最適な用途:社内検索、文書に関するQ&Aなどの企業向けRAGや、回答に出典の引用が必須となるあらゆる導入環境。
6. GLM-5.2
GLM-5.2は、Z.aiが2026年6月に公開した、753Bパラメータの混合エキスパートモデルです。非常に高性能なオープンウェイトAIモデルです。Interconnectsはこれを「オープンモデルにとっての飛躍的な進歩」と評しました。エージェントワークフローでClaude Opus級のLLMを置き換えられる、初のオープンリリースです。
仕様:
| 仕様 | GLM-5.2 |
|---|---|
| 総パラメータ数 | 753B |
| アクティブパラメータ数 | 約40B |
| コンテキスト長 | 1Mトークン |
| 推論 | 推論に割く計算量を2段階から選択可能 |
| 公開時期 | 2026年6月 |
| ライセンス | MIT |
ベンチマーク:
| ベンチマーク | スコア |
|---|---|
| GPQA Diamond | 91.2 |
| SWE-bench Pro | 62.1 |
| Terminal-Bench 2.1 | 82.7 |
| Humanity's Last Exam | 40.5 |
| Humanity's Last Exam、ツール使用 | 54.7 |
注:Z.aiはSWE-bench VerifiedとLiveCodeBenchの結果を報告していないため、ここではそれらの数値を省略しています。
必要なハードウェア:
| 量子化 | サイズ | ハードウェア |
|---|---|---|
| FP8 | 約750GB | 8× B200または複数ノードのH100クラスター |
| 4ビット | 約380GB | 8× H100または512GBのMac Studio |
| 2ビット | 約200GB | 4× H100または256GBのMac Studio |
最適な用途:最も高性能なオープンモデルを必要とするユーザー。ただし、パラメータ数は753Bあるため、実行にはクラウドか本格的なマルチGPUクラスターが必要です。
7. DeepSeek-V4-Pro
2026年4月に公開されたDeepSeek-V4-Proは、DeepSeekのフラッグシップモデルです。長文コンテキストを低コストで処理できるようにしたことで、V4-Proは公開から1か月以内に、本番環境で最も多く導入されたオープンLLMとなりました。1Mトークンのコンテキストを処理する際の計算量はDeepSeekの前世代の約4分の1、メモリ使用量は約10分の1で、これがAPI料金では入力100万トークンあたり$0.43、出力100万トークンあたり$0.87という価格につながっています。
DeepSeek-V4-Proは、低コストで運用できるだけでなく、フラッグシップ級の仕様を備えた、幅広い用途で高性能なモデルです。
仕様:
| 仕様 | DeepSeek-V4-Pro |
|---|---|
| 総パラメータ数 | 1.6T |
| アクティブパラメータ数 | 49B |
| コンテキスト長 | 1Mトークン |
| 公開時期 | 2026年4月 |
| ライセンス | MIT |
ベンチマーク:
| ベンチマーク | スコア |
|---|---|
| SWE-bench Verified | 80.6 |
| LiveCodeBench | 93.5 |
| MMLU-Pro | 87.5 |
| Codeforcesレーティング | 3206 |
| 1Mコンテキスト長でのMRCR | 83.5 |
ハードウェアの観点では、このモデルもクラウドまたはデータセンターでの導入に最も適しています。
必要なハードウェア:
| 量子化 | サイズ | ハードウェア |
|---|---|---|
| 6ビット以下 | 約1.2TB | 複数ノードのデータセンタークラスター |
| 4ビット | 約800GB | 8× B200または16× H100 |
| 2ビット | 約400GB | 8× H100または4× H200 |
最適な用途:APIコストが決め手となる長文コンテキスト処理。DeepSeek-V4-ProモデルのAPI料金は、GPT、Claude、Geminiファミリーの同等モデルの10~30分の1だからです。
8. Kimi K3
Kimi K3は、2026年7月16日に公開された、Moonshot AIの2.8兆パラメータのフラッグシップモデルです。執筆時点では最も高性能なオープンウェイトモデルで、Artificial Analysisの知能指数ではClaude Fable 5とGPT-5.6 Solに次ぐ第3位に位置しています。
仕様:
| 仕様 | Kimi K3 |
|---|---|
| 総パラメータ数 | 約2.8T |
| コンテキスト長 | 1Mトークン |
| ネイティブ形式 | MXFP4、量子化を考慮した学習を実施 |
| 重みのサイズ | 約1.4TB |
| 公開日 | 2026年7月16日 |
| 重みの公開日 | 2026年7月27日 |
| ライセンス | Modified MIT |
ベンチマーク:
| ベンチマーク | スコア | 出典 |
|---|---|---|
| Terminal-Bench 2.1 | 88.3 | Moonshot |
| Terminal-Bench 2.1 | 80.9 | Vals AI、独立評価 |
| BrowseComp | 90.4 | Moonshot |
| DeepSWE | 67.3 | Moonshot |
出典によって性能の数値には多少のばらつきがあり、よくあることですが、社内評価の数値のほうが少し高くなっています。ただし、おおむね同じ水準です。
必要なハードウェア:
| 量子化 | サイズ | ハードウェア |
|---|---|---|
| MXFP4 | 約1.4TB | 複数ノードのデータセンタークラスター |
gpt-ossと同様に、K3は量子化を考慮して学習されているため、ビルドは1種類しかありません。大幅にビット数を削減した2ビット量子化でも約700GBになるため、このモデルのローカルでの導入は現実的ではありませんが、クラウド上のオープンウェイトモデルとして利用できます。
Kimiは、コーディングに特化した1TパラメータのKimi K2.7-Codeも公開しました。これは、GitHub Copilot内で提供された初のオープンウェイトモデルとなりました。4ビットビルド(約510GB)は8× H100で動くため、K3よりも実行しやすいモデルです。それでも、自宅で使うためのモデルではありません。
最適な用途:最先端レベルのエージェント処理。
9. MiniMax-M3
MiniMax-M3は、上海に拠点を置くMiniMaxが開発したフラッグシップモデルです。
MiniMax-M3は、テキスト、画像、動画の入力をサポートするオープンソースのマルチモーダルLLMで、1Mトークンのコンテキスト長と23Bのアクティブパラメータを備えています。
仕様:
| 仕様 | MiniMax-M3 |
|---|---|
| 総パラメータ数 | 428B |
| アクティブパラメータ数 | 23B |
| コンテキスト長 | 1Mトークン |
| 入力 | テキスト、画像、動画 |
| 公開時期 | 2026年6月 |
| ライセンス | MiniMax Community License |
商用利用する場合、ライセンス上は認められていますが、「Built with MiniMax M3」というクレジットを追加する必要があります。
また、スパースアテンション設計により、コンテキストを上限まで使用した場合のプロンプト処理はMiniMax自身の前世代モデルの9倍、生成は15倍高速です。そのため、コンテキストを使い切るような長期にわたるタスクで非常に効率的です。
ベンチマーク:
| ベンチマーク | スコア |
|---|---|
| SWE-bench Verified | 80.5 |
| SWE-bench Pro | 59.0 |
| Terminal-Bench 2.1 | 66.0 |
| Video-MME v2 | 85.4 |
| AA Intelligence Index | 55 |
ハードウェアの観点では、NVFP4なら、非常にハイエンドな家庭用システムでもこのモデルを何とか実行できます。
必要なハードウェア:
| 量子化 | サイズ | ハードウェア |
|---|---|---|
| MXFP8 | 約430GB | 8× H100または4× B200 |
| NVFP4 | 約215GB | 4× H100または256GBのMac Studio |
| 3ビット | 約160GB | 192GBのMac Studio |
最適な用途:マルチモーダルエージェントと、コンテキストを上限まで使用する長期にわたるタスク。
10. Nemotron 3 Ultra
Nemotron 3 Ultraは、NVIDIAのフラッグシップモデルです。中国以外で開発されたオープンウェイトモデルの中で、最も高度なモデルです。また、フラッグシップ級モデルの中で最も真のオープンソースに近いモデルでもあります。NVIDIAは重みだけでなく、次のものも一般公開しているためです。
- 学習データセット(合計3Tトークン超)
- 事後学習の手順とRL環境
- スコアの算出に使用した評価ハーネス
仕様:
| 仕様 | Nemotron 3 Ultra |
|---|---|
| 総パラメータ数 | 550B |
| アクティブパラメータ数 | 55B |
| アーキテクチャ | ハイブリッドMamba-Transformer MoE |
| コンテキスト長 | 1Mトークン |
| 公開時期 | 2026年6月 |
| ライセンス | OpenMDW-1.1 |
純粋な性能では、中国のオープンウェイトモデルにすぐ次ぐ位置にあります。
ベンチマーク:
| ベンチマーク | スコア |
|---|---|
| SWE-bench Verified | 70.7 |
| LiveCodeBench | 89.0 |
| MMLU-Pro | 86.8 |
| 1Mコンテキスト長でのRULER | 95.0 |
| AA Intelligence Index | 47.7 |
必要なハードウェア:
| 量子化 | サイズ | ハードウェア |
|---|---|---|
| BF16 | 約1.1TB | 8× B200または16× H100 |
| FP8 | 約550GB | 8× H100 |
| NVFP4 | 約275GB | 4× H200 |
最適な用途:監査可能な学習データと、米国由来のサプライチェーンを必要とするチーム。
ローカルで実行するのに最適なオープンソースLLMは?
自分のハードウェアでオープンソースモデルを実行する方法や、マシンに合ったモデルサイズと量子化レベルの選び方を知りたい場合は、LLMをローカルで実行する方法のガイドをお読みください。
ローカルでの導入に最適なオープンソースLLMを知りたい方に、答えを簡潔にまとめます。
8GBグラフィックカードに最適なLLM
4ビット量子化のGemma 4 12Bは、8GBに収まる最良のモデルです。短いコンテキストであれば、VRAM使用量は約7GBです。
長い会話のために余裕を確保したい場合は、ひとつ小さいGemma 4 E4Bを選んでください。まさにこのクラスのハードウェア向けに作られています。
24GBグラフィックカードに最適なLLM
RTX 3090、4090、5090をお持ちなら、4ビットのQwen3.6-27Bが最良のローカルLLMです。重みには約15GBが必要なため、コンテキスト用の余裕を確保できます。このモデルは、同規模のモデルの中で最高のコーディング性能も備えています。
僅差の第二候補は4ビットのGemma 4 31Bですが、ベンチマークではやや劣ります。
開発者向けのおすすめローカルモデルについて詳しく知りたい場合は、コーディングに最適なローカルLLMを詳しく紹介したガイドをご覧ください。
96GB以上のグラフィックカードに最適なLLM
RTX 6000 Blackwell、80GBのH100、または128GBの統合メモリを搭載したMacをお持ちなら、実行できる最良のモデルはTencent公式の4ビットビルドのHunyuan Hy3です。約100GBを必要とし、フラッグシップに近い品質を実現します。
オープンソースLLMを実行するためのツール
モデルを選んだら、それを実行するソフトウェアが必要です。シンプルなデスクトップアプリから本番環境向けの推論サーバーまで、オープンソースLLMをローカルで実行するための主なツールを紹介します。
Atomic Chat
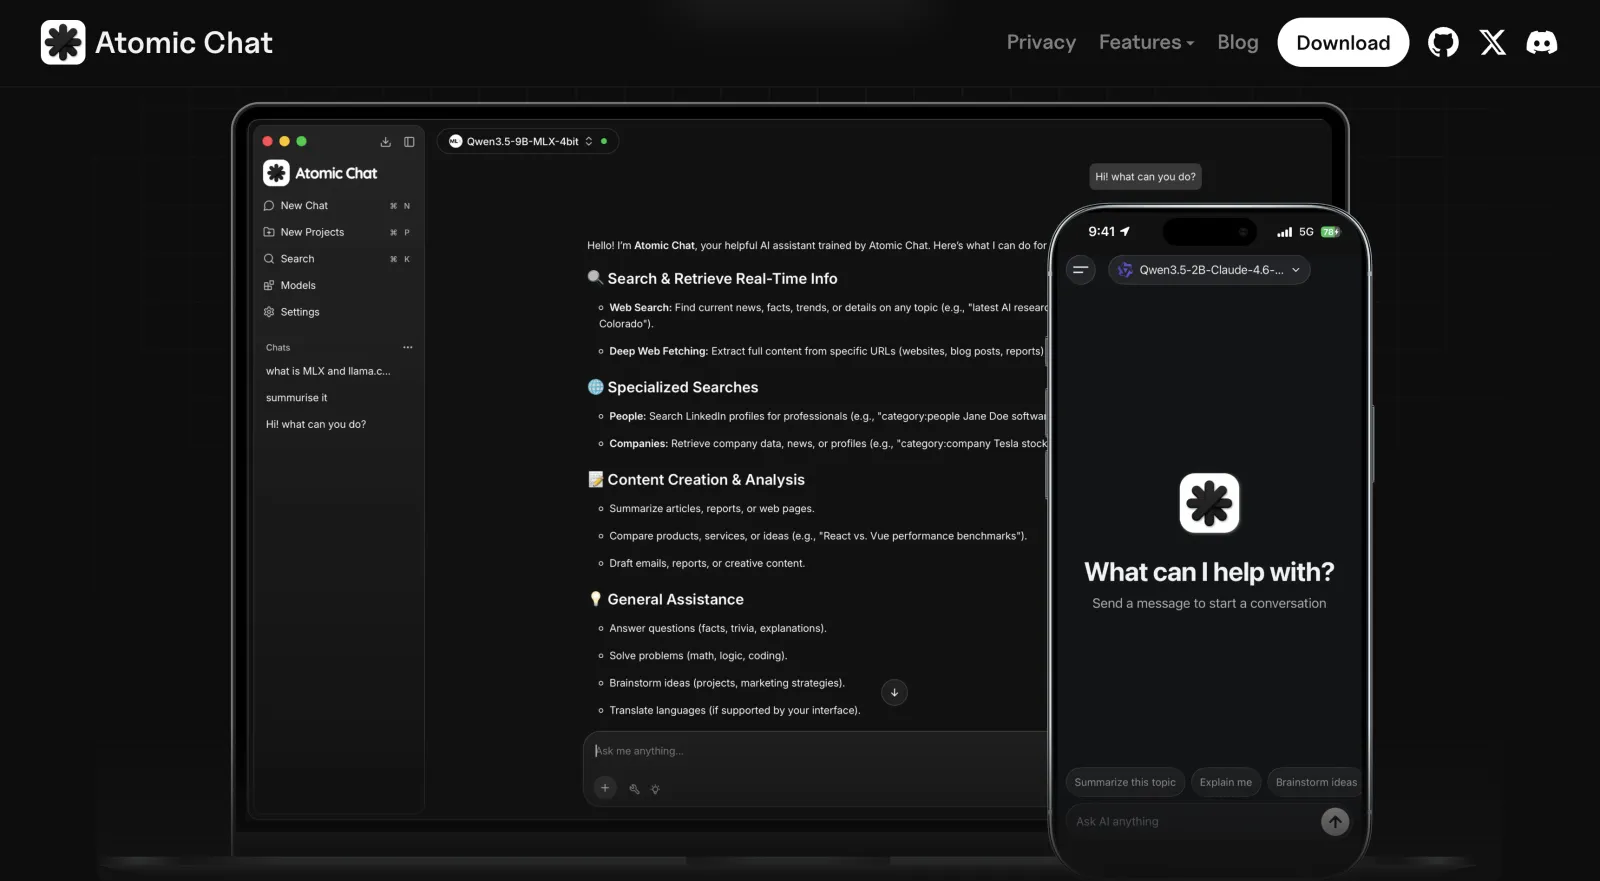
Atomic Chatは、Mac、Windows、Linux、iPhone、Android向けの無料ローカルAIチャットアプリです。上で紹介したモデルを含め、Hugging Faceの1,000以上のオープンモデルを選んで実行できます。Atomic Chatはデバイス上でローカルに推論を実行するため、入力した内容がマシンの外に出ることはなく、レート制限もメッセージ数の上限もありません。GoogleのTurboQuant圧縮を搭載しており、精度を一切低下させずにモデルを3ビットまで縮小し、KVキャッシュを少なくとも6分の1に圧縮します。これにより、このリストにある大型モデルも一般消費者向けのメモリ容量に収まります。TurboQuantは、標準的な32ビットモデルと比べてアテンション計算も最大8倍高速化し、Hermes、OpenClaw、Clineなどのワンクリックで使えるエージェントも、そのまま動作します。
Ollama
Ollamaは、LLMをローカルで実行するためのオープンソースツールです。単一のコマンド(ollama run qwen3.6)で独自のレジストリからモデルをダウンロードして実行し、localhost上にOpenAI互換APIを公開することで、他のアプリケーションがローカルモデルのバックエンドとして利用できるようにします。
ollamaコマンドは、チャット、コードの記述、ウェブ検索ができる対話型エージェントも起動します。また、OllamaはClaude Code、Codex、OpenCode、OpenClawなどのコーディングエージェントと連携します。
LM Studio
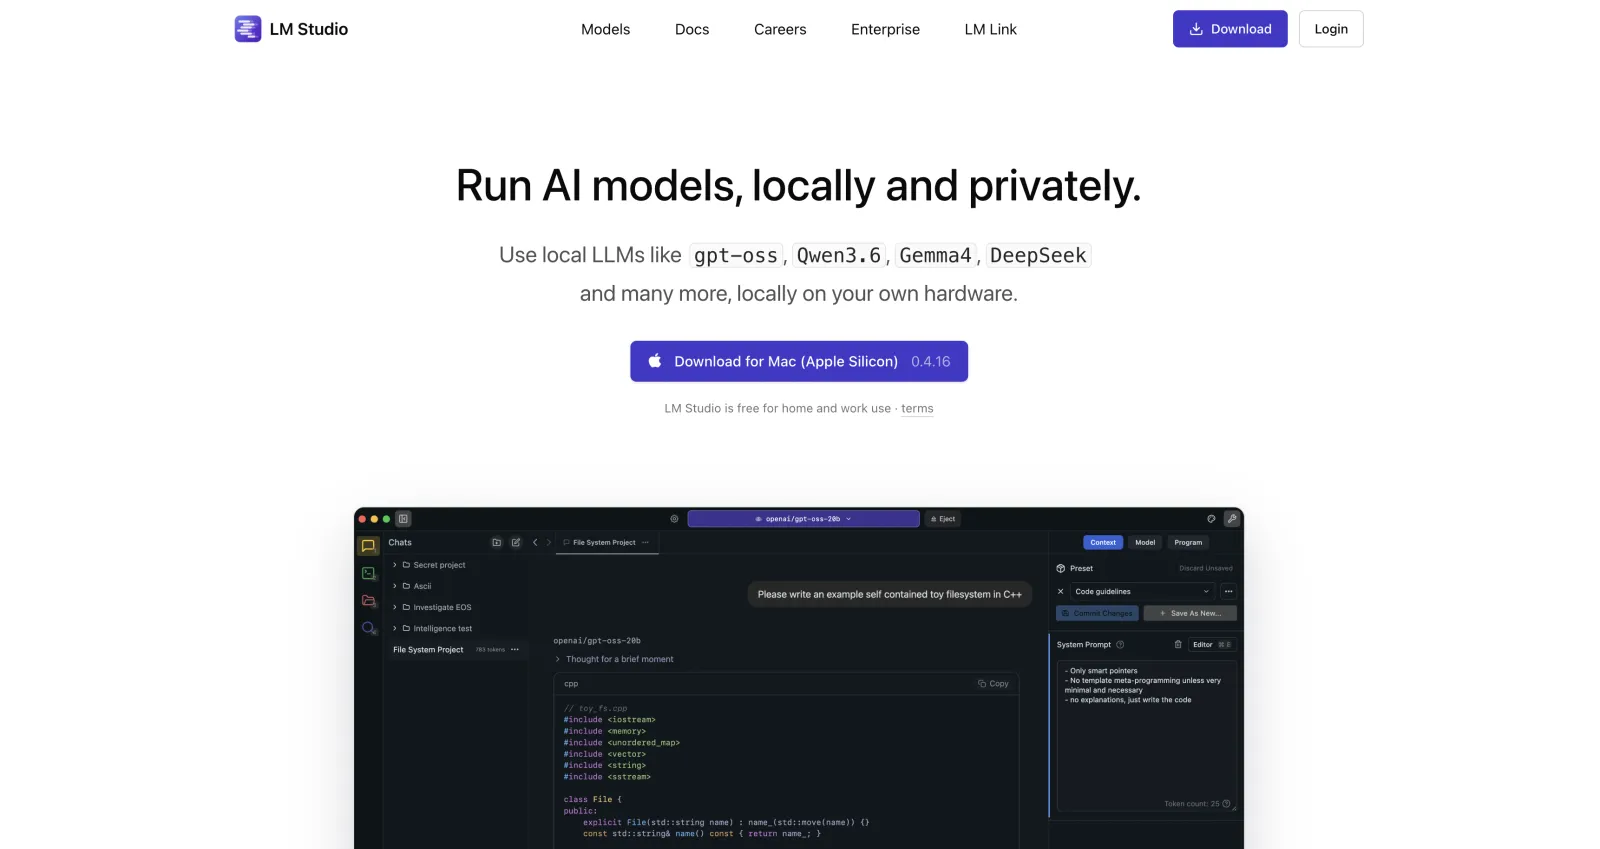
LM Studioは、グラフィカルインターフェースを通じてHugging Faceのモデルをダウンロードし、チャットできる、無料のクローズドソースデスクトップアプリです。すべてのプラットフォームで動くllama.cppと、MシリーズMacで動くAppleのMLXという2つの推論エンジンを使用します。LM Studioによると、MシリーズMacでは、MLXバックエンドが同じハードウェア上のllama.cppより30~50%高速に動作します。
lmsコマンドラインツールと、ローカルのOpenAI互換サーバーも含まれており、他のアプリケーションがバックエンドとして利用できます。最近のMLXアップデートでは、視覚モデル向けのプロンプトキャッシュと、長時間のセッション向けのKVキャッシュのチェックポイント機能が追加されました。
llama.cpp
llama.cppは、Georgi Gerganovが2023年に開発を始めた、オープンソースのC++推論エンジンです。OllamaとLM Studioはいずれもこれを基盤としており、ローカル向けツールで広く使われるGGUFモデル形式も、このプロジェクトから生まれました。CUDA、Apple Metal、Vulkan、AMD ROCm、CPUで動作します。
コマンドラインから実行し、1~2ビットまでの量子化と、レイヤー単位のGPUオフロードをサポートしています。一部のレイヤーをシステムRAMに保持することで、利用可能なVRAMより大きなモデルも実行できます。新しいモデルアーキテクチャへの対応は、通常、GUIツールよりも先にここで実装されます。
vLLM
vLLMは、サーバー向けハードウェア上でLLMを実行するためのオープンソース推論サーバーです。1人でのローカル利用よりも、多数のリクエストを同時に処理する用途に最適化されており、PagedAttentionと連続バッチ処理を使って、高負荷時もGPUの稼働率を維持します。商用の推論プロバイダーの大半がvLLMを運用しています。
FP8、NVFP4、MXFP4、INT4、GGUFの量子化に対応しているほか、マルチGPUでのテンソル並列化とパイプライン並列化もサポートしています。これらの並列化は、このリストで最大規模のモデルを複数のGPUにまたがって実行するために必要です。
よくある質問
2026年のオープンソースLLMの選び方と実行方法について、よくある質問をまとめました。
現在、最良のオープンソースLLMは何ですか?
2026年7月時点で、最良のオープンソースLLMはGLM-5.2です。独自の追加条件がないMITライセンスで提供され、GPQA Diamond(91.2)とエージェント系ベンチマークでオープンモデルをリードしています。自分のハードウェアで実行するなら、Qwen3.6-27Bのほうが適しています。GLM-5.2はパラメータ数が753Bあり、ローカルで扱える規模を超えるためです。
ChatGPTはオープンソースですか?
いいえ。ChatGPTと、その基盤となるGPT-5.xモデルはプロプライエタリです。OpenAIがオープンウェイトとして提供しているのは、Apache 2.0で公開された、別系統のgpt-ossファミリー(120Bと20B)です。高性能なモデルですが、ChatGPTのフラッグシップには大きく及びません。
オープンソースLLMはGPT-5やClaudeに匹敵しますか?
コーディングと推論のベンチマークでは、差は数ポイントにまで縮まりました。MiniMax-M2.5はOpenHandsのコーディング指数でClaude Sonnetを上回り、GLM-5.2もクローズドのフラッグシップに近いスコアを記録しています。Epoch AIは、オープンモデルがクローズドモデルの最先端から約4か月遅れていると推定しています。また、完成度と長期にわたるエージェント処理の信頼性では、ベンチマーク表が示す以上に差があります。
オープンソースLLMは商用利用できますか?
このリストの大半は可能です。MITまたはApache 2.0のモデル(GLM-5.2、DeepSeek-V4、Qwen3.6、Gemma 4、Hunyuan Hy3、Command A+、gpt-oss)には、商用利用の制限がありません。MiniMax-M3のようなコミュニティライセンスのモデルには、クレジットの表記義務や売上高の基準が加わるため、製品を出荷する前にLICENSEファイルを読んでください。
最大のオープンソースLLMは何ですか?
重みが公開されているモデルでは、総パラメータ数が1.6兆のDeepSeek-V4-Proが最大です。2026年7月27日に重みが公開されると、2.8兆パラメータのKimi K3が最大となります。
LM Studioはオープンソースですか?
いいえ。LM Studioは無料ですが、クローズドソースのデスクトップアプリです。基盤となるエンジンのllama.cppはMITライセンスのオープンソースであり、Ollamaも完全にオープンソースです。
コーディングに最適なオープンソースLLMは何ですか?
ホスト型サービスでのエージェントによるコーディングにはKimi K2.7-Code、自分で実行する用途全般にはQwen3.6-27Bです。ローカルで使える選択肢については、コーディングに最適なローカルLLMで詳しく紹介しています。
まとめ
この記事では、2026年に実行できるおすすめのオープンソースAIモデルを紹介しました。主なポイントは次のとおりです。
- 総合的に最良のオープンモデルはKimi K3です。ノートPC、Mac、PCで実行するのに最良のローカルモデルはQwen3.6-27Bです。
- オープンソースと呼ばれるモデルの大半は、実際にはオープンウェイトです。これは、重みは公開されている一方で、学習コードとデータは公開されていないという意味です。モデルの実行や導入、さらには商用利用においても、これによる影響はありません。単なる技術的な区別です。
- 2026年のオープンモデルは非常に高性能です。たとえば、GLM-5.2とKimi K3は、ほとんどのベンチマークでGPT-5.6やClaude Fable 5と数ポイント以内のスコアを記録しています。
- 最高性能のオープンウェイトモデルの大多数は、中国の研究機関から登場しています。たとえば、このリストの10モデルのうち8モデルは、Z.ai、DeepSeek、Alibaba、Moonshot、Tencent、MiniMaxという中国の研究機関によるものです。中国以外で開発された最良のオープンモデルは、NVIDIAのNemotron 3 Ultraです。
オープンウェイトモデルをローカルで実行する最も手早い方法は、Atomic Chatを試すことです。ハードウェアに適した量子化を自動で選び、デバイス上で無料でモデルを実行します。