

NVFP4は、大規模言語モデル(LLM)の推論と学習を高速化するために特別に設計された、NVIDIA独自の4ビット浮動小数点データ形式です。このデータ形式は、元の精度に近い水準を保ちながら、モデルのサイズを16ビット時の4分の1に圧縮します。
モデルをローカルで実行するなら、NVFP4について知っておく必要があります。NVFP4を使えば、使わない場合と比べてはるかに大きなモデルをインストールし、はるかに高速に実行できますが、そのためには適切なハードウェアが必要です。
要点
大規模言語モデルは、GPUメモリに余裕を持って収まらないほど大きくなっています。そのため、実行を高速化するには、精度を大きく損なわずに、数値である重みをより少ないビット数で格納することが重要になります。NVFP4は、この問題に対するNVIDIAの解決策です。モデルの重みを非常に低い精度で格納するための4ビット浮動小数点数形式(E2M1)です。モデルのサイズをFP16の約3.5分の1、FP8の約1.8分の1に縮小し、推論をFP8比で最大約3倍に高速化できます。同時に、大規模言語モデルの精度低下は通常1%未満に抑えられます。
NVFP4とは?
NVFP4は、NVIDIAが開発した4ビット浮動小数点データ形式です。ニューラルネットワーク内の数値、特にモデルの重みと、実行中に生成される中間値を格納するために使われます。名前の「NV」は、開発元であるNVIDIAを指します。NVFP4は2025年6月に初めて発表され、2025年から2026年にかけて、NVIDIAは主要な推論エンジンであるvLLM、SGLang、TensorRT-LLMに対応を追加しました。
NVFP4は、NVIDIAのBlackwell GPUアーキテクチャ向けに設計されました。Blackwellの第5世代Tensor Coreは4ビット浮動小数点演算を直接実行できるため、NVFP4で格納されたモデルはメモリ使用量が少なくなり、実行も高速になります。
NVFP4形式の仕組み:量子化とスケーリング
4ビット浮動小数点形式の根本的な課題は、わずか4ビットでは、現代の言語モデルをそのまま格納するのに十分な数値を表現できないことです。NVFP4の値で表現できる数値は、0から±6までの15種類だけです。
0, ±0.5, ±1, ±1.5, ±2, ±3, ±4, ±6
しかし、大規模言語モデルには数十億個の重みが含まれており、その値の大きさは極めて幅広く分布しています。ゼロに非常に近い値もあれば、その数百倍、数千倍の大きさの値もあります。すべての重みをE2M1の固定範囲に直接収める必要があると、丸め誤差が非常に大きくなり、モデルの精度が大幅に失われてしまいます。
そこでNVFP4は、重みの復元に必要な情報を2つに分けます。1つ目は、E2M1形式で表現できる15種類の値から選んだ4ビット値そのものです。2つ目は、隣接する重みと共有する1つ以上のスケール係数です。この形式では、値全体を直接格納する代わりに、小さな相対値と、元の大きさを復元するのに十分な情報を一緒に格納します。
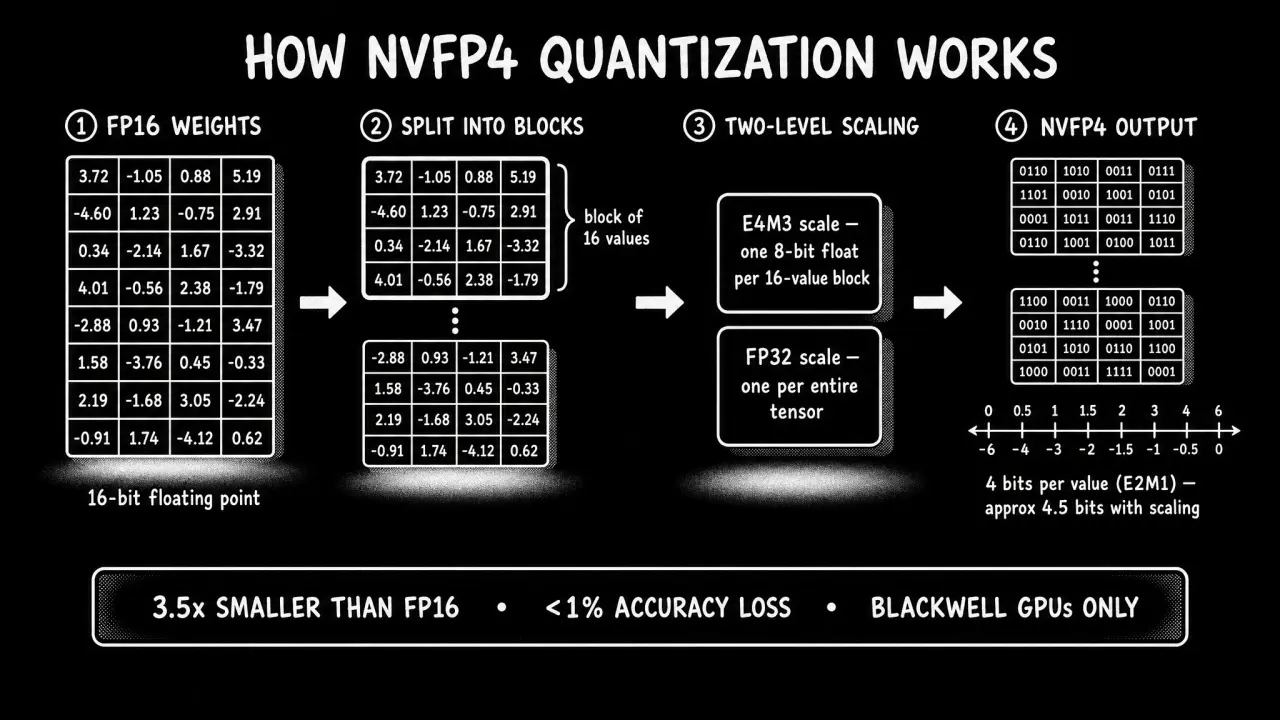
モデルの実行時には、BlackwellのFP4 Tensor Coreが、格納された4ビット値とそのスケール係数を組み合わせ、元の重みの近似値を復元します。この復元はハードウェアで直接実行されるため、追加のスケーリングによるオーバーヘッドは小さく、モデルは元の精度の大部分を維持できます。
この低精度の値と共有スケール係数の組み合わせが、NVFP4と単純な4ビット浮動小数点形式を区別する特徴です。スケーリングの仕組みにより、個々の重みに必要な格納容量を増やすことなく、実用上の数値範囲を広げています。
NVFP4の利点
重みの精度を16ビットから4ビットに下げると、モデルの格納と処理に必要なメモリ量が減ります。これには主に3つの効果があります。
- モデルの小型化。NVFP4モデルのサイズは、同等のFP16モデルの約3.5分の1、FP8モデルの約1.8分の1になります。
- 推論スループットの向上。重みが小さくなるとメモリ転送量が減り、1秒あたりに処理できるモデルの量が増えます。対応ハードウェアでは、推論スループットがFP8の最大3倍になります。
- 精度低下を最小限に抑制。大規模なモデルでは通常、量子化後も元の精度の99%超が維持されます。
モデルの小型化
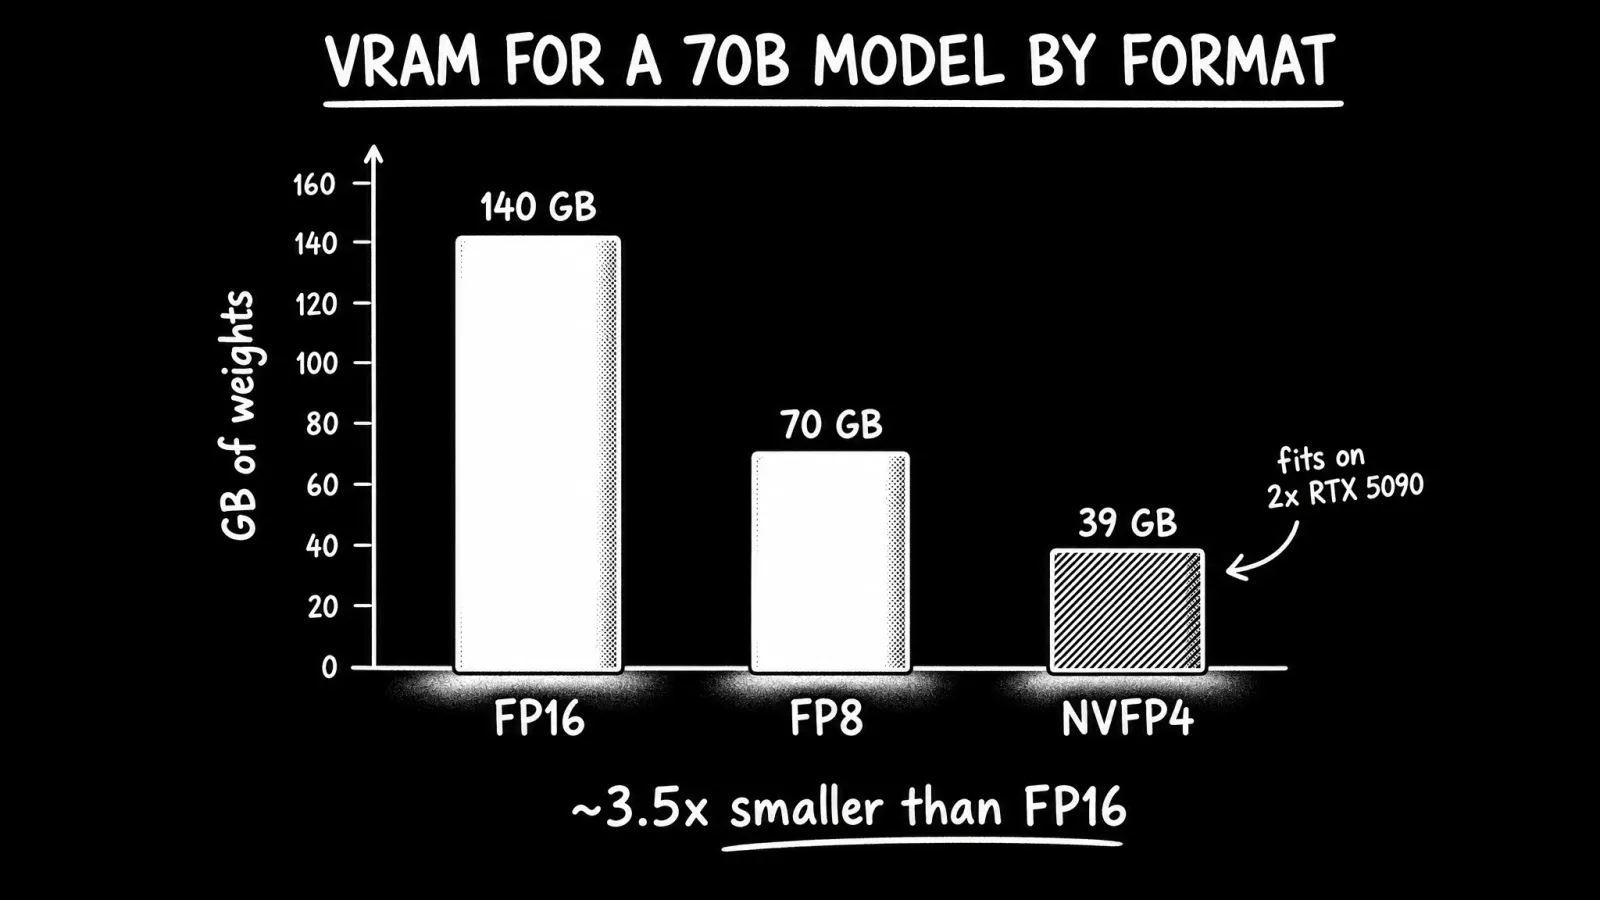
NVFP4の最も直接的な効果は、メモリ使用量の削減です。この形式は、重みの格納容量をFP16比で約3.5分の1、FP8比で約1.8分の1に削減します。
たとえば、700億パラメータのモデルでは、モデル全体をVRAMに読み込めるハードウェアが次のように変わります。
- FP16:重みは約140 GB。80 GBのデータセンターGPUが少なくとも2基必要です。
- FP8:約70 GB。現在のコンシューマー向けGPUのメモリ容量を超えます。
- NVFP4:重みは約39 GB。RTX 5090を2基(各32 GB)、またはB200/B300を1基使用すれば収まります。
小規模なモデルでは、この削減の効果がさらに大きくなります。
NVFP4で格納した32BモデルはRTX 5090を1基使用すれば収まりますが、同等のFP16モデルは収まりません。
NVFP4はKVキャッシュの格納容量もFP8比で最大50%削減でき、同じVRAM容量に収まる最大コンテキスト長を伸ばせます。
推論の高速化
大規模言語モデルの推論は、演算スループットよりもメモリ帯域幅によって制約されることがよくあります。NVFP4は重み1個あたりの格納ビット数が少ないため、メモリとGPUの演算ユニット間で転送する必要があるデータ量が減り、スループットが向上します。
NVIDIAの報告によると、ネイティブのFP4 Tensor Coreを備えたBlackwell GPUでは、推論スループットがFP8比で最大3倍、行列乗算のスループットがBF16比で最大4倍になります。
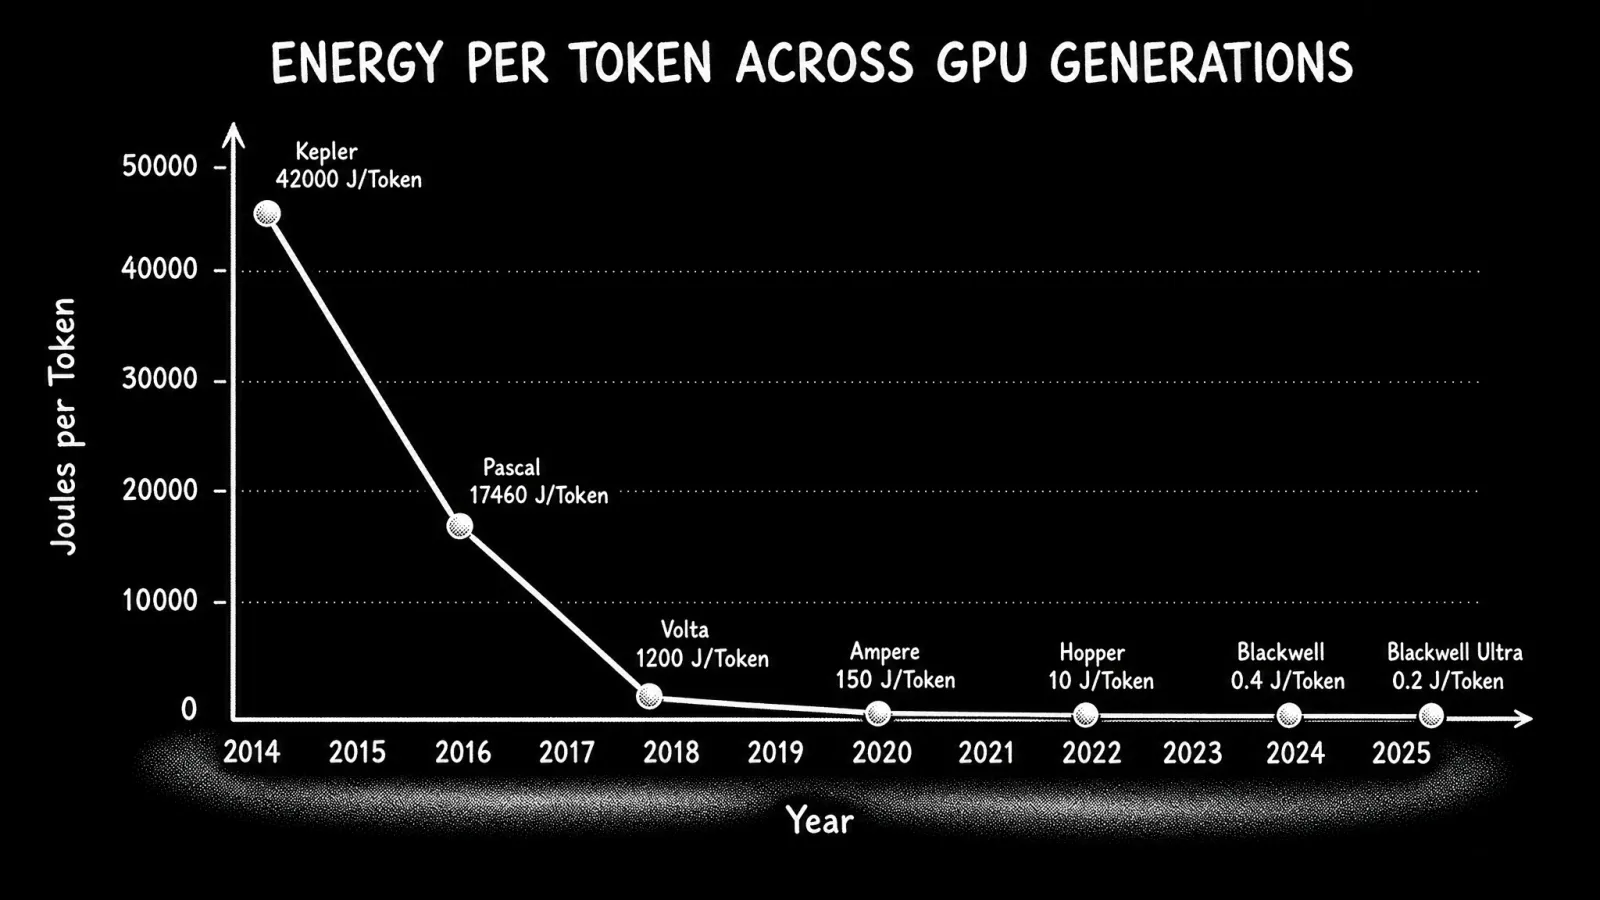
メモリ転送量の削減は、生成トークンあたりのレイテンシとエネルギー消費も低減するため、NVFP4はBlackwellの効率向上を支える重要な要素です。
精度低下を最小限に抑制
量子化は数値精度を下げますが、NVFP4はモデル品質への影響を最小限に抑えるように設計されています。
NVIDIAの報告によると、大規模なモデルをFP8からNVFP4に変換した際の精度低下は1%未満で、モデルの規模に応じて、フル精度時の精度の95〜99%が維持されます。DeepSeek-R1について公開された結果では、7つの評価ベンチマーク全体で差はわずかにとどまっています。
| ベンチマーク | FP8 | NVFP4 |
|---|---|---|
| MMLU-Pro | 85 | 84 |
| GPQA Diamond | 81 | 80 |
| AIME 2024 | 89 | 91 |
| LiveCodeBench | 約1%以内 | 約1%以内 |
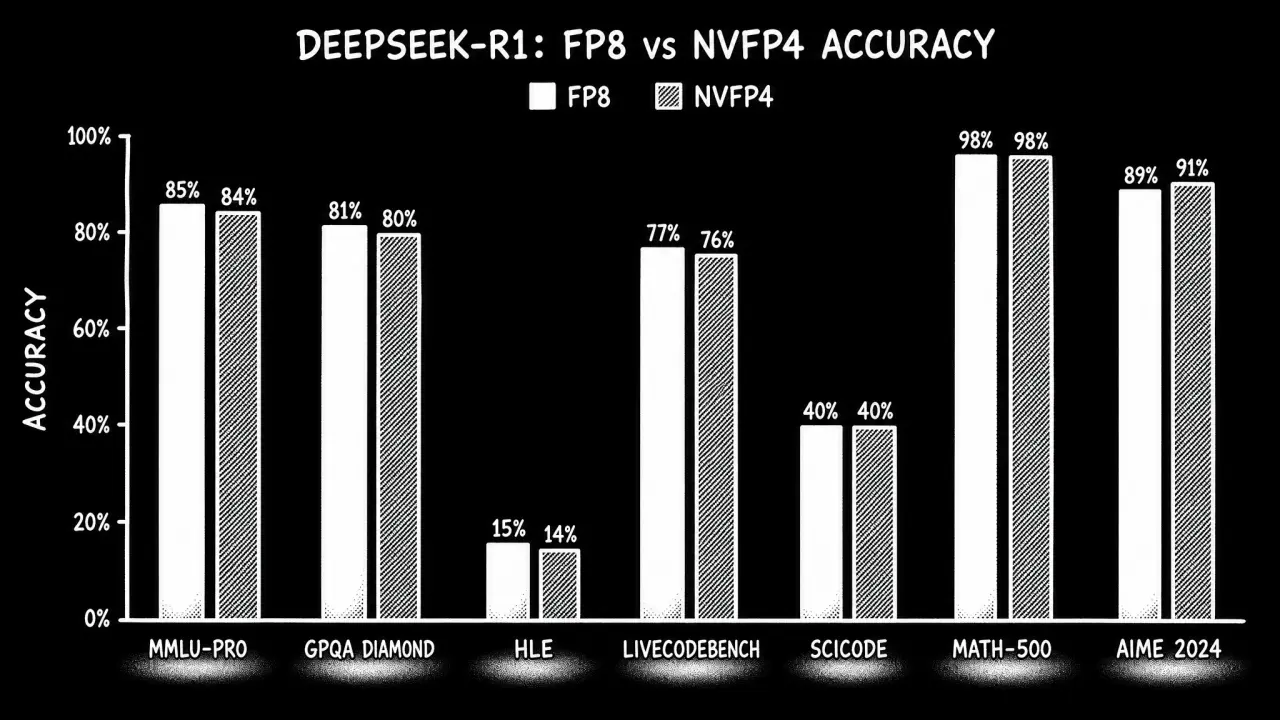
AIME 2024のスコアがわずかに高いことは、一般に、一貫した改善ではなく、量子化によって生じる通常のばらつきによるものとされています。
精度の維持率はモデルの規模にも依存します。パラメータ数が約700億以上のモデルでは通常、元の精度の約99%が維持される一方、7B〜14Bのモデルでは95〜98%が維持されるケースがより一般的です。大規模なモデルは表現上の冗長性が高いため、一般に量子化への耐性も高くなります。
NVFP4を利用できるのは?
NVFP4には専用のFP4 Tensor Coreが必要で、対応しているのはNVIDIAのBlackwellアーキテクチャのみです。現在、NVFP4に対応しているBlackwellハードウェアには、次のものがあります。
- データセンター:B200、B300、GB200、GB300、およびGB300 NVL72システム
- ワークステーション:RTX PRO 6000 Blackwell
- コンシューマー向け:RTX 5090を含むGeForce RTX 50-series GPU
- デスクトップAI:DGX Spark
Hopper(H100、H200)、Ampere(A100)、Ada Lovelace(RTX 40-series)を含む旧アーキテクチャと、それ以前の世代はNVFP4に対応していません。これらのGPUでも、重みを対応形式に変換すればNVFP4で量子化されたモデルを読み込める場合は多いものの、FP4演算をネイティブに実行できないため、BlackwellのFP4 Tensor Coreがもたらすメモリ帯域幅やスループット上の利点は得られません。

NVFP4モデルの実行方法
NVIDIAは、Hugging Faceのnvidia/名前空間で公式のNVFP4チェックポイントを公開しています。例として、次のものがあります。
nvidia/DeepSeek-R1-NVFP4nvidia/DeepSeek-V4-Flash-NVFP4nvidia/Qwen3-30B-A3B-NVFP4nvidia/Qwen3.5-397B-A17B-NVFP4nvidia/Qwen3.6-27B-NVFP4nvidia/Gemma-4-31B-IT-NVFP4nvidia/Kimi-K2.6-NVFP4nvidia/GLM-5.2-NVFP4nvidia/Llama-3.1-8B-Instruct-NVFP4
モデルは順次追加公開されており、Hugging FaceでNVFP4を検索すると最新のチェックポイントを確認できます。モデルのNVFP4版が提供されていない場合は、NVIDIA Model OptimizerまたはLLM Compressorを使って、元の重みから作成することもできます。どちらもキャリブレーション用データセットを使ってモデルを量子化します。
vLLM、SGLang、TensorRT-LLM、ComfyUIでのNVFP4対応
NVFP4モデルの実行には、FP4をネイティブにサポートする推論エンジンも必要です。現在の選択肢には、次のものがあります。
- vLLM:本番環境とローカル環境でのモデル配信向けNVFP4サポート
- SGLang:高スループットのNVFP4推論
- TensorRT-LLM:NVFP4向けのNVIDIAのリファレンスランタイム
- ComfyUI:FLUXやLTXなどのNVFP4画像・動画生成モデル
ただし、Atomic Chatを使っている場合は、NVFP4モデルを実行するために手動で設定する必要はありません。Atomic ChatはNVFP4モデルのサポートとHugging Faceブラウザーを内蔵しているため、アプリ内から直接、ワンクリックでNVFP4モデルを検索、ダウンロード、起動できます。
また、最新の対応NVFP4モデルを確認したい場合は、Hugging Faceのhuggingface.co/models?search=NVFP4で現在の一覧を閲覧することもできます。
NVFP4とMXFP4、FP8(およびGGUF)の比較
モデルのNVFP4版が利用できるようになったら、残る疑問は、それが使用するシステムに最も適した形式かどうかです。これは主に、利用可能なハードウェアの種類と、メモリ使用量、性能、精度の間でどのようなバランスを求めるかによって決まります。以下の表を参考にしてください。
| 項目 | NVFP4 | MXFP4 | FP8 |
|---|---|---|---|
| 値あたりのビット数 | 4 | 4 | 8 |
| ブロックサイズ | 16 | 32 | — |
| スケールの形式 | E4M3(8ビット浮動小数点)+ FP32 | E8M0(2の累乗) | テンソルごと |
| スケールのオーバーヘッド | 重みあたり0.5ビット | 重みあたり0.25ビット | — |
| 開発元 | NVIDIA | Open Compute Project(OCP) | 業界標準 |
| ハードウェア | Blackwellのみ | 複数のアクセラレータ | Hopper、Blackwellなど |
| 一般的な精度 | フル精度時の約95〜99% | やや低い | ~99%+ |
| 最も適した用途 | Blackwellでの効率の最大化 | 移植性を重視した4ビットでの展開 | 圧縮率を控えめにして、より高い精度を確保 |
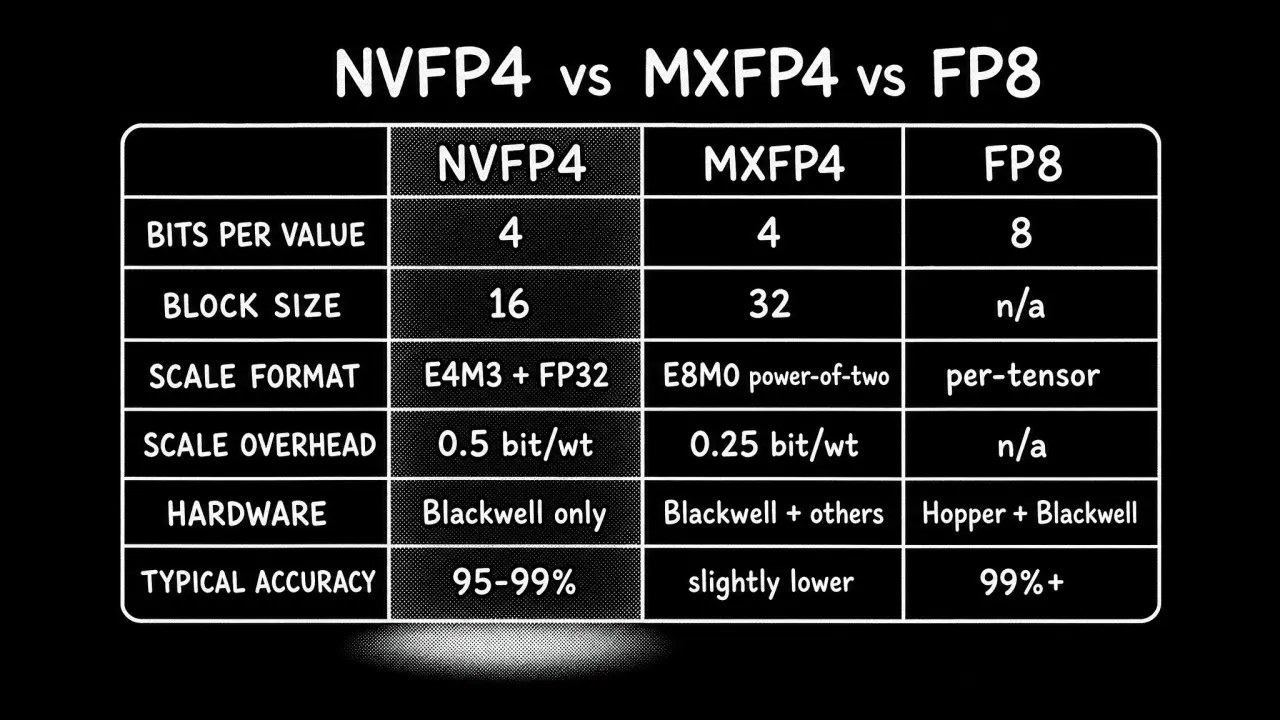
NVFP4とFP8の比較:FP8は、各値を4ビットではなく8ビットで格納します。通常、元のモデルの精度をほぼすべて維持できますが、NVFP4のおよそ2倍のメモリが必要です。モデルが量子化の影響を特に受けやすい場合や、メモリ容量の制約が比較的緩い場合には、FP8が選ばれることが多くなります。
MXFP4は、Open Compute Projectが標準化したオープンな4ビット浮動小数点形式です。NVFP4とは異なり、単一のハードウェアベンダーに依存せず、複数のアクセラレータアーキテクチャで動作するように設計されています。スケーリングの粒度が粗いため、一般に精度はNVFP4よりもやや低くなります。NVIDIAの事前学習実験では、MXFP4で学習したモデルが同等のNVFP4モデルと同じ品質に達するには、約36%多くの学習トークンが必要でした。
GGUFは、llama.cppエコシステム向けに開発されたQ4_K_Mなどのバリエーションを含む、別系統の量子化形式を使用します。GGUFは、複数のベンダーのCPUとGPUに幅広く対応するように設計されています。Blackwell GPUでは、NVFP4は専用のFP4 Tensor Coreで直接実行されるため、同程度のサイズのGGUF量子化よりも、一般に高いスループットと高い精度を実現します。ただし、CPUやBlackwellより前のGPUでは、通常はGGUFのほうが実用的な選択肢です。
PTQとQATの比較
モデルを選ぶときやチェックポイントを作成するときに理解しておくべきもう1つの重要な要素は、そのモデルがどのようにNVFP4へ変換されたかです。Hugging Faceでは、チェックポイントに次の2つの手法のいずれかがラベルとして付けられています。
- 学習後量子化(PTQ)は、小規模なキャリブレーション用データセットを使い、再学習を行わずに、学習済みモデルを1回の処理でNVFP4に変換します。高速で、元の学習パイプラインにアクセスする必要もありません。
- 量子化を考慮した学習(QAT)は、4ビット演算を学習そのものに組み込み、モデルが低精度の影響を補うように学習させます。はるかに多くの計算資源が必要ですが、精度をさらに回復できます。
NVFP4の精度が高い理由
上記の比較で示した精度上の優位性は、この形式における2つの設計上の判断によるものです。
- ブロックの大きさ。
- 各ブロックのスケール係数をどれだけ高い精度で格納するか。
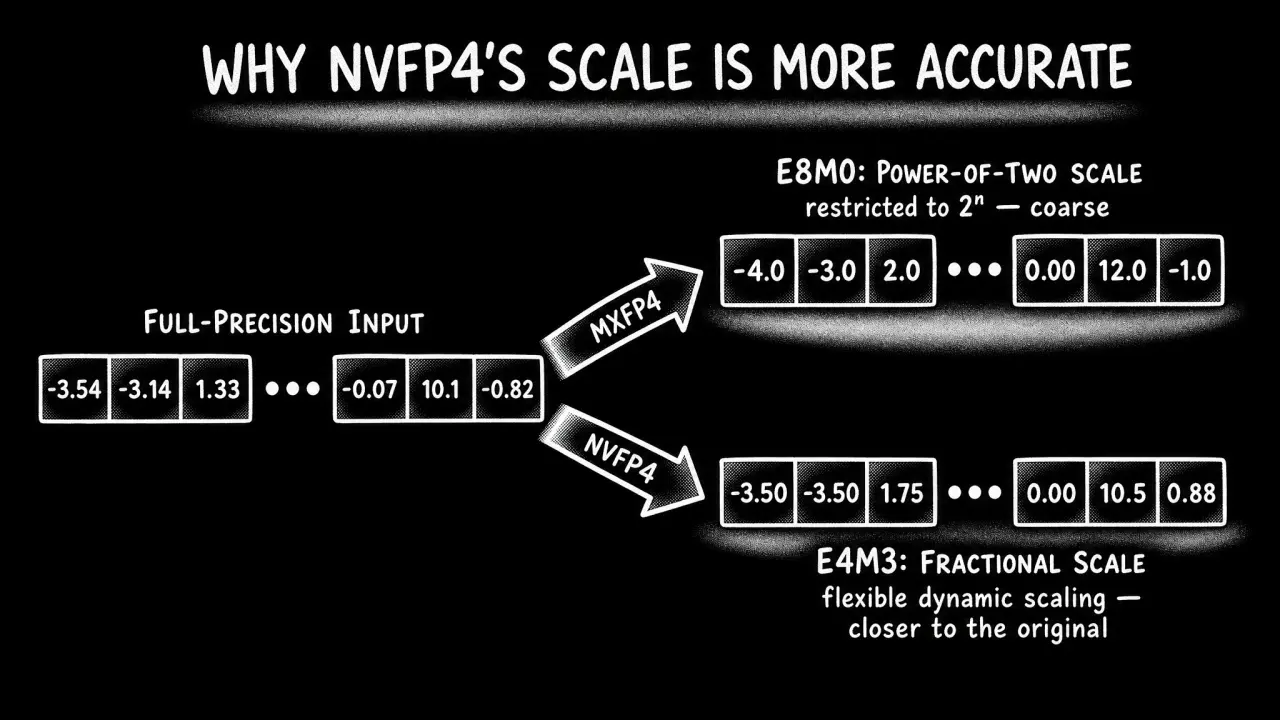
前述のとおり、NVFP4は重みを16個ずつのブロックにまとめ、各ブロックに個別のスケールを割り当てます。
MXFP4は、その2倍の大きさとなる32個ずつのブロックを使います。ブロックが小さいほど、各スケール係数が受け持つ重みの数が少なくなり、それらにより適切に合わせられます。そのため、突出して大きな重みが1つあっても、隣接する重みへの歪みの影響は32個ではなく16個にとどまります。
NVFP4のスケール係数自体も、非常に高精度です。NVFP4はこの係数を、小数を含む細かな刻み幅を取れる真の8ビット浮動小数点値(E4M3)として格納します。MXFP4はこれを2の累乗値(E8M0)として格納するため、×2、×4、×8という倍々の段階でしかスケーリングできず、理想的なスケールを超えてしまうことがよくあります。
NVIDIAの報告によると、より細かなブロック分割とスケーリングを組み合わせることで、2の累乗によるスケーリングに比べて量子化誤差が約88%低減します。これが、同じ4ビットという制約の下で、NVFP4がMXFP4よりも精度をよく維持できる理由です。
よくある質問
NVFP4はMXFP4より優れていますか?
精度については、一般にそうです。NVFP4の16個の値からなるブロックと8ビットのE4M3スケール係数は、MXFP4の32個の値からなるブロックと2の累乗スケールよりも、精度をより多く回復できます。オープン標準であるMXFP4のほうが移植性は高いものの、Blackwellハードウェアで品質を優先するなら、NVFP4がより有力な選択肢です。
NVFP4はH100やRTX 40-seriesで動作しますか?
いいえ。NVFP4には、B200、B300、RTX 50-series、RTX PRO 6000、DGX SparkなどのBlackwell GPUが必要です。Hopper(H100、H200)とAda(RTX 40-series)は、NVFP4に必要なFP4 Tensor Coreを備えていません。
NVFP4では精度がどれくらい低下しますか?
大規模なモデルでは通常1%未満で、全体としてフル精度時の精度の95〜99%を回復します。大規模なモデルほど低下が小さく、7B〜14Bの小規模なモデルでは低下がやや大きくなります。
NVFP4の値の範囲はどれくらいですか(-8から7.5ですか)?
「-8から7.5」という範囲は4ビットの整数形式に由来するもので、NVFP4には当てはまりません。浮動小数点形式であるNVFP4の単一の値(E2M1)は、0, ±0.5, ±1, ±1.5, ±2, ±3, ±4, ±6という離散的な値を取り、最大の大きさは±6です。さらに2段階のスケーリングによって、これらの離散値をモデルの実際の、はるかに広い重みの範囲に対応付けるため、実効的な範囲は適用するスケール係数によって決まります。
どのNVFP4モデルをダウンロードできますか?
NVIDIAはHugging Faceのnvidia/名前空間で、DeepSeek-R1とV4、Qwen3、Gemma 4、Kimi K2、GLM-5、Llama 3.1の派生モデルなど、多くのモデルを公開しています。Hugging Faceで「NVFP4」を検索すると、現在の一覧が表示されます。
NVFP4はローカルでの利用に適していますか?
Blackwell GPUであれば、適しています。品質低下を最小限に抑えながら、より大きなモデルを少ないVRAMに収められるため、デスクトップまたはワークステーション向けのカード1枚でモデルを実行する用途に適しています。




