

要点
結論:DeepSeekをローカルで実行するには、Atomic ChatのようなローカルAIアプリをインストールする必要があります。アプリがモデルのダウンロードを処理し、モデルと対話するためのインターフェースを提供します。モデルの重みをダウンロードすれば、自分のマシンでDeepSeekをオフラインで実行できます。最も重要なのは、お使いのハードウェアで実行できるDeepSeekのバージョンを選ぶことです。目安として、モデルのサイズの約2倍の空きメモリが必要なので、8Bモデルを実行したい場合は、少なくとも16GBのVRAMまたはユニファイドメモリが必要です。
- DeepSeekをエラーなく快適な速度でローカル実行するには、モデルのファイルサイズの約2倍の空きRAMが必要です。最適なハードウェアは、NVIDIA GPUまたはApple Silicon Macです。
- DeepSeek R1には、ローカルのハードウェアで実行できる1.5B、8B、32Bの蒸留版があります。たとえば、DeepSeek R1 8Bは16GBのMacBook Proで実行できます。
- Atomic Chatは、DeepSeek R1をローカルで実行する最も簡単な方法です。オープンソースのローカルAIアプリで、Hugging FaceからDeepSeekをワンクリックでダウンロードできるモデルブラウザーと、モデルとの対話を始められるチャットインターフェースを備えています。
- OllamaでもDeepSeekをローカルで実行できます。Ollamaは以前、CLIのみでしたが、最近ではGUIも追加されています。開発者にはOllamaを最適な選択肢としておすすめします。
- DeepSeekのオフライン実行は無料です。自分のハードウェアでDeepSeekを実行すると、プライバシーを保ちながらAIとチャットできます。ただし、蒸留モデルの性能は、オンラインで対話できるDeepSeekのフラッグシップ版には及ばないことに注意してください。
DeepSeekをローカルで実行するには、どのようなハードウェアが必要ですか?
目安は、モデルのファイルサイズの約2倍の空きメモリを確保することです。DeepSeek R1 8Bでは、コンテキストウィンドウとOSの分を考慮すると、約16 GBの余裕が必要になります。
この目安を守らないとどうなるのでしょうか?モデルがクラッシュするか、動作が非常に遅くなります。
また、DeepSeekはほぼあらゆる種類のマシンでローカル実行できますが、NVIDIA GPUまたはApple Silicon Macがあると有利です。その理由は次のとおりです。
- NVIDIA GPU:Nvidia GPUは数千の演算を並列処理でき、ディープラーニングの高速化を目的とした専用ハードウェアを搭載しているため、AIの計算を可能な限り高速に実行できます。Nvidiaは、開発者がデータサイエンスで同社のアーキテクチャを効率よく利用できるエコシステムであるCUDAも開発しました。学習用データセンターの大半がNVIDIA製のカードを使っているのは、このためです。
- Apple Silicon Mac(M1以降):AppleのMetalフレームワークにより、NVIDIAの最適な代替選択肢となります。ローカルAIアプリはMetalを使い、同様の並列処理による高速化を実現します。また、このチップは、プロセッサとグラフィックスコアが1つのRAM領域を共有するユニファイドメモリを採用しています。そのため、16 GBのMacでは、16GBのVRAMを搭載したグラフィックスカードを備えるPCと、おおむね同じモデルを実行できます。
DeepSeekはCPUで実行できますか?はい、ただし低速です。現実的には、CPUで実用的な速度で動作するのはDeepSeek R1 1.5Bだけです。
ハードウェアに十分なストレージの空き容量があることも確認してください。
次のセクションでは、DeepSeekのモデルをローカルで実行するために必要なハードウェアについて説明します。
ローカル実行におすすめのDeepSeek R1モデル
DeepSeekのローカル実行について語られる場合、ほぼ常にDeepSeekの推論モデルであるDeepSeek R1を指しています。
ただし、オリジナルのR1は巨大なモデルで、一般消費者向けのハードウェアの大半では実行できません。そのため、蒸留版が作られました。
では、蒸留モデルとは何でしょうか?DeepSeekがR1自身の回答を使って再学習させた、小型の通常のモデル(QwenまたはLlamaのモデルのいずれか)です。
蒸留モデルは、R1の段階的に推論するスタイルを模倣するように学習されています。オリジナルのDeepSeek R1には完全には及びませんが、十分近い性能を発揮しながら、ノートパソコンや1枚のグラフィックスカードで実行できる軽さを保っています。
「十分近い」とは、どれほどの性能なのでしょうか?ノートパソコンに収まるモデルから想像する以上の性能です。
たとえば、数学と推論のテストでは、大きめの蒸留モデルはOpenAIのo1-miniを上回り、GPT-4oにも大差をつけています。
以下は、リリース時にDeepSeekが評価したスコアです(高いほど優れています)。
| モデル | AIME 2024(数学) | MATH-500 | GPQA Diamond(科学) |
|---|---|---|---|
| DeepSeek R1 1.5B | 28.9 | 83.9 | 33.8 |
| DeepSeek R1 7B | 55.5 | 92.8 | 49.1 |
| DeepSeek R1 8B | 50.4 | 89.1 | 49.0 |
| DeepSeek R1 14B | 69.7 | 93.9 | 59.1 |
| DeepSeek R1 32B | 72.6 | 94.3 | 62.1 |
| DeepSeek R1 70B | 70.0 | 94.5 | 65.2 |
| OpenAI o1-mini | 63.6 | 90.0 | 60.0 |
| GPT-4o | 9.3 | 74.6 | 49.9 |
要点:14Bの蒸留モデルでさえ、3つのテストすべてでo1-miniを上回るスコアを出しています。自宅で高い推論性能を得るために、最大のモデルを使う必要はありません。
DeepSeek R1には、15億から700億パラメータまで、6つのサイズの蒸留モデルがあります。パラメータが多いほどモデルは賢くなりますが、実行も難しくなります。
| モデル | ダウンロードサイズ | 適した用途 |
|---|---|---|
| DeepSeek R1 1.5B | 1.1 GB | 古いマシンやメモリの少ないマシン向けの、最も軽量な選択肢 |
| DeepSeek R1 7B | 4.7 GB | 一般的なノートパソコンでの日常的な利用 |
| DeepSeek R1 8B | 5.2 GB | 多くの人にとって最適な、汎用性の高い選択肢 |
| DeepSeek R1 14B | 9.0 GB | メモリに余裕があれば、回答の質が明らかに向上 |
| DeepSeek R1 32B | 20 GB | ハイエンドGPUや大容量メモリを搭載したMacでの高性能な推論 |
| DeepSeek R1 70B | 43 GB | ワークステーション向けの、最も高性能な蒸留モデル |
まずはDeepSeek R1の8B蒸留モデルから始めることをおすすめします。推論とコーディングに適しており、応答も高速です。
8Bモデルが遅すぎると感じる場合は、1.5Bの蒸留モデルを試してください。8Bでタスクをこなせない場合は、速度は落ちますが、より正確な14Bまたは32Bモデルを試してください。
完全版のDeepSeek R1 671Bをローカルで実行できますか?
結論から言うと、地下室に商用グレードのデータセンターでもない限り、できません。
DeepSeek R1 671Bは蒸留されていないモデルで、重みのサイズは404 GBです。非常に強い1.58ビットの動的量子化を使って約131 GBに縮小しても、品質は大幅に低下し、毎秒2〜4トークンという低速で実行するために、なお約192 GBのRAMが必要です。そのようなハードウェアを持っていない限り、「DeepSeek R1をローカルで実行する」とは、蒸留モデルを実行することを意味します。
Atomic ChatでDeepSeekをローカル実行する方法
DeepSeek R1をローカルで実行する最も簡単な方法は、モデルのダウンロードを処理し、チャットウィンドウを提供するデスクトップアプリを使うことです。ターミナルに触れる必要はありません。
Atomic Chatは、macOS、Windows、Linux向けの無料のオープンソースアプリです(GitHubで公開)。
AtomicChatでDeepSeekのモデルを実行する方法は次のとおりです。
- atomic.chatからAtomic Chatをダウンロードし、ほかのアプリと同じようにインストールします。推論エンジンはアプリがセットアップします。
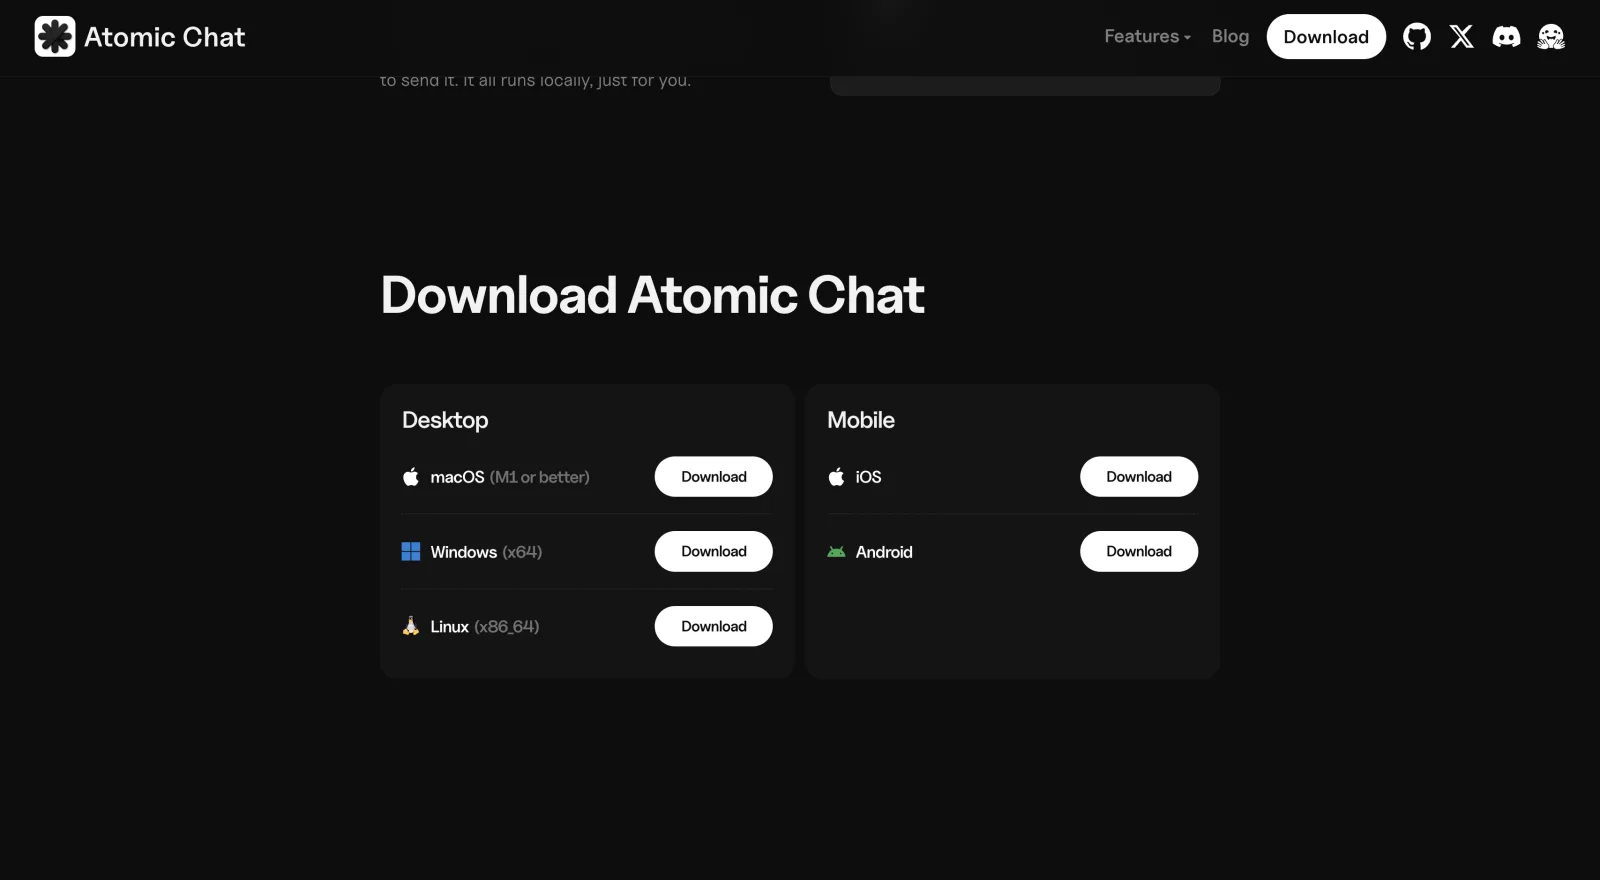
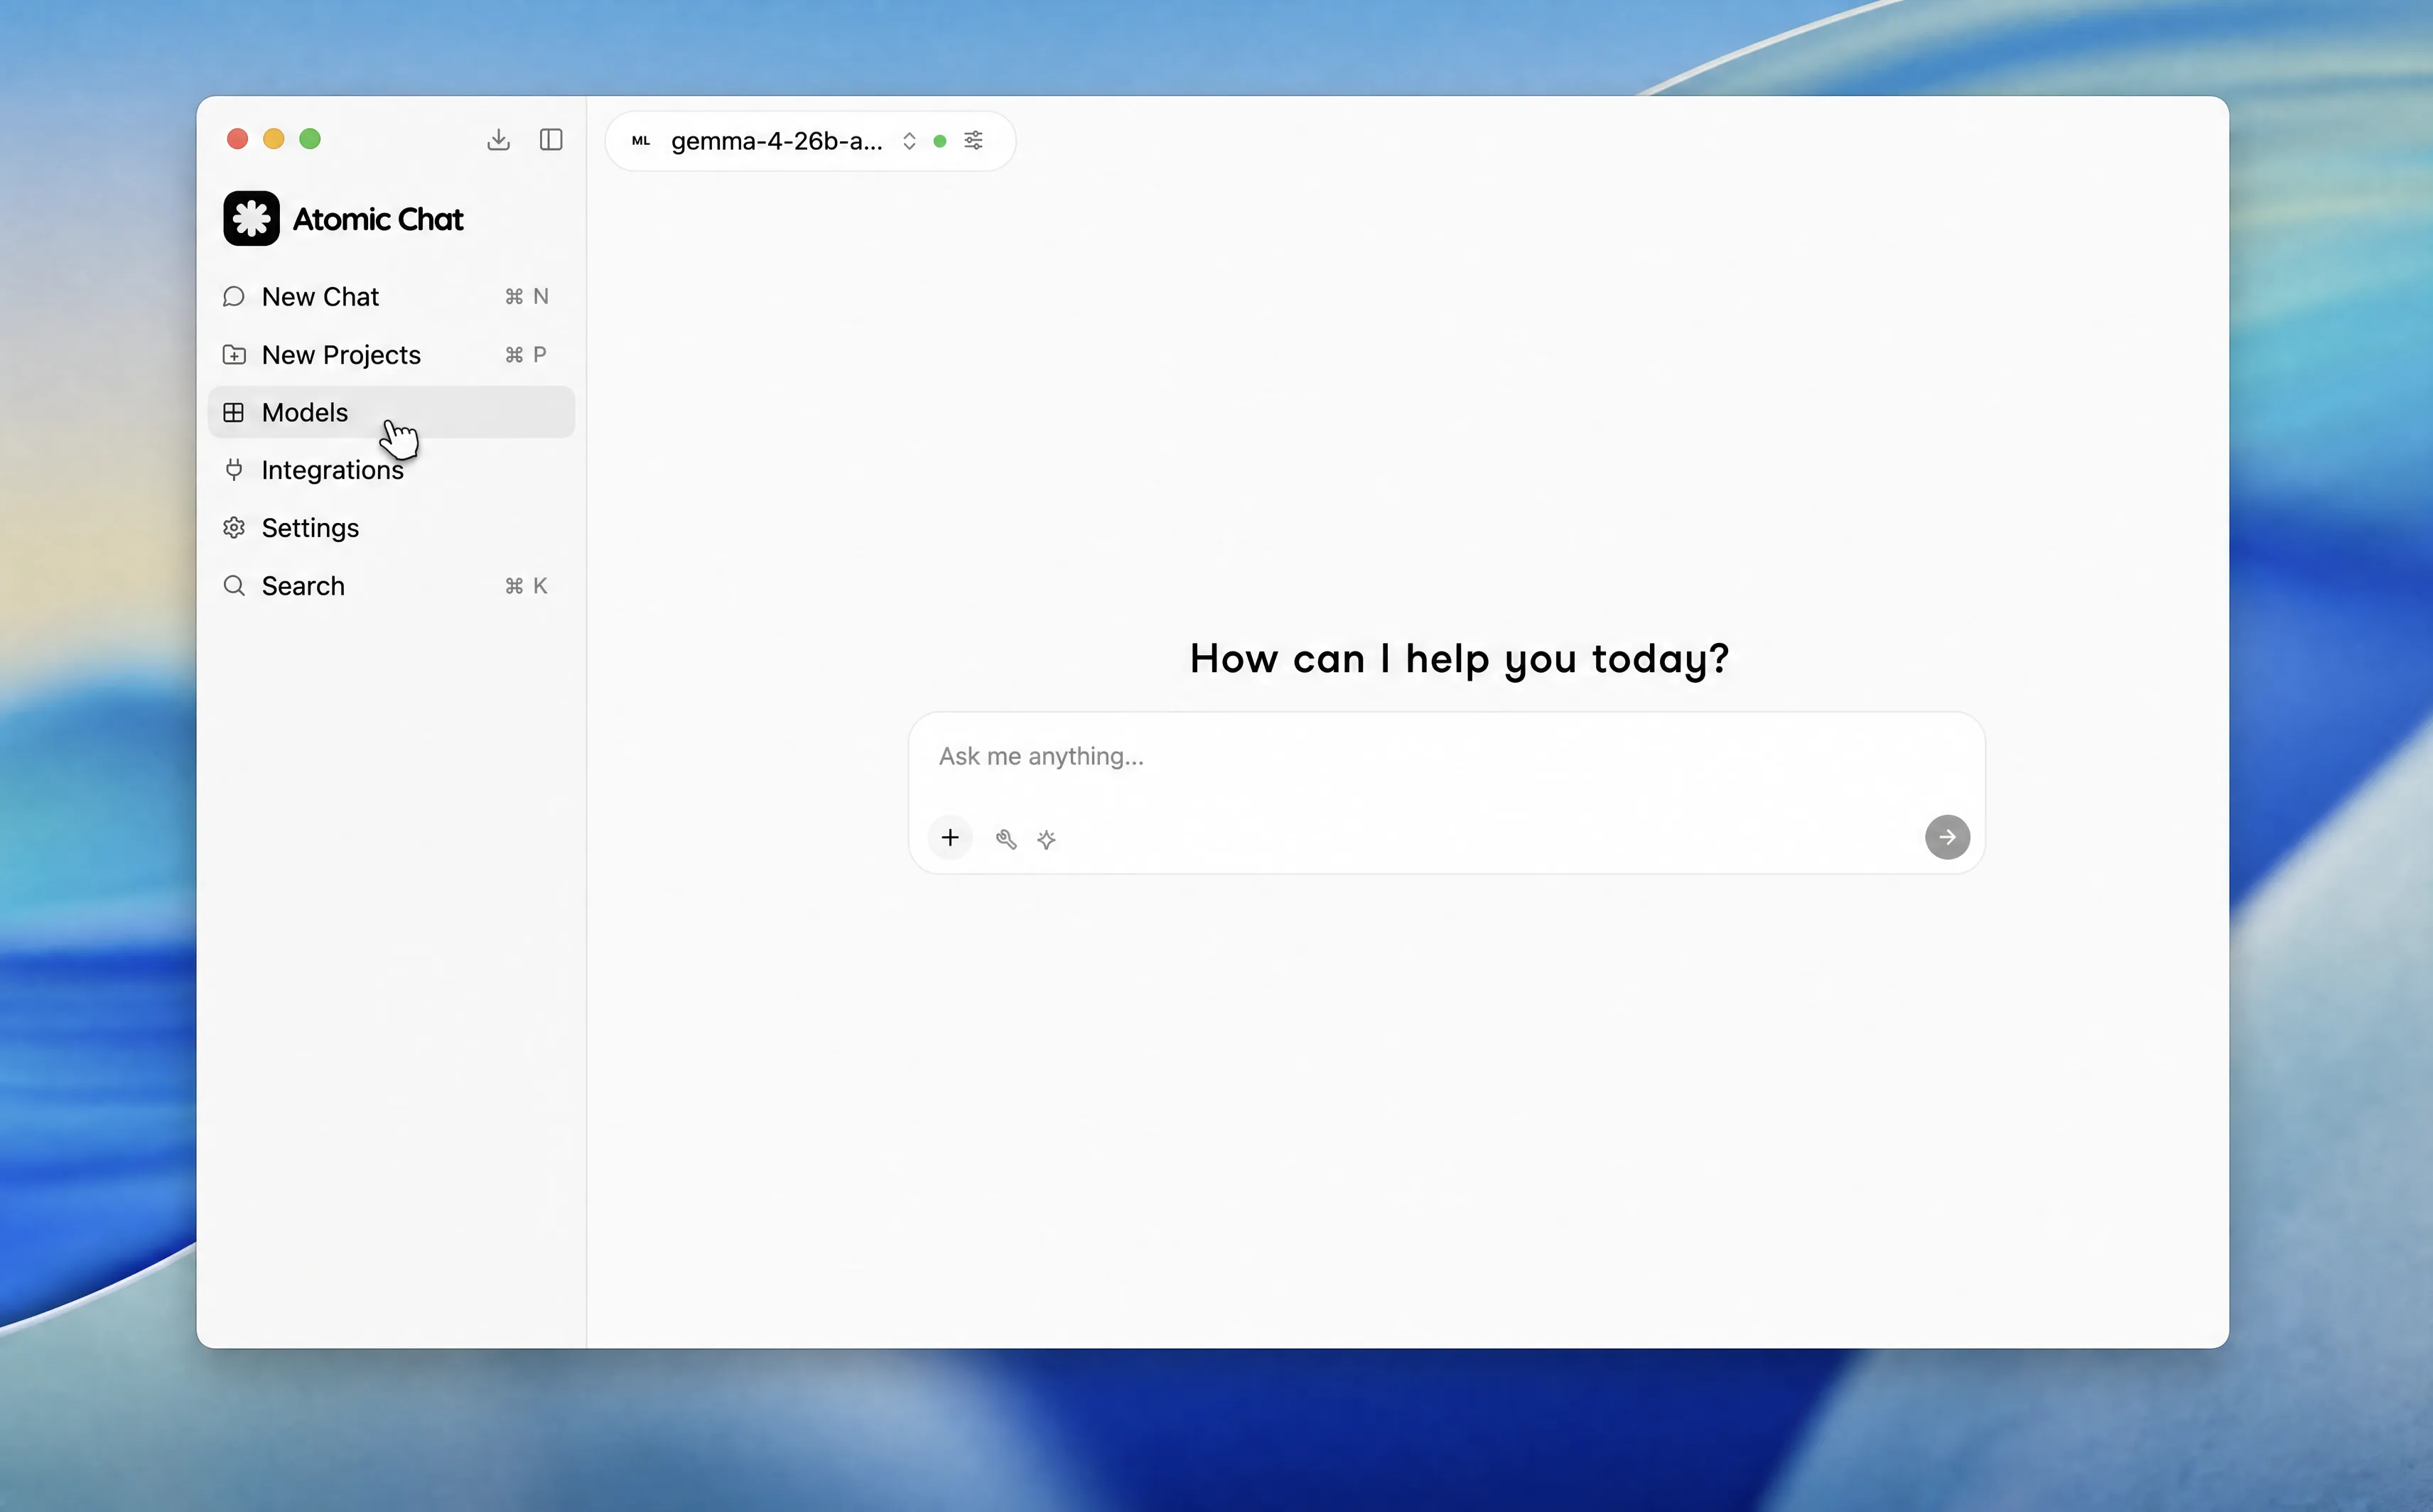
- 左側のサイドバーでModelsを開きます。ここでは、アプリ内からHugging Faceのライブラリを閲覧、検索できます。
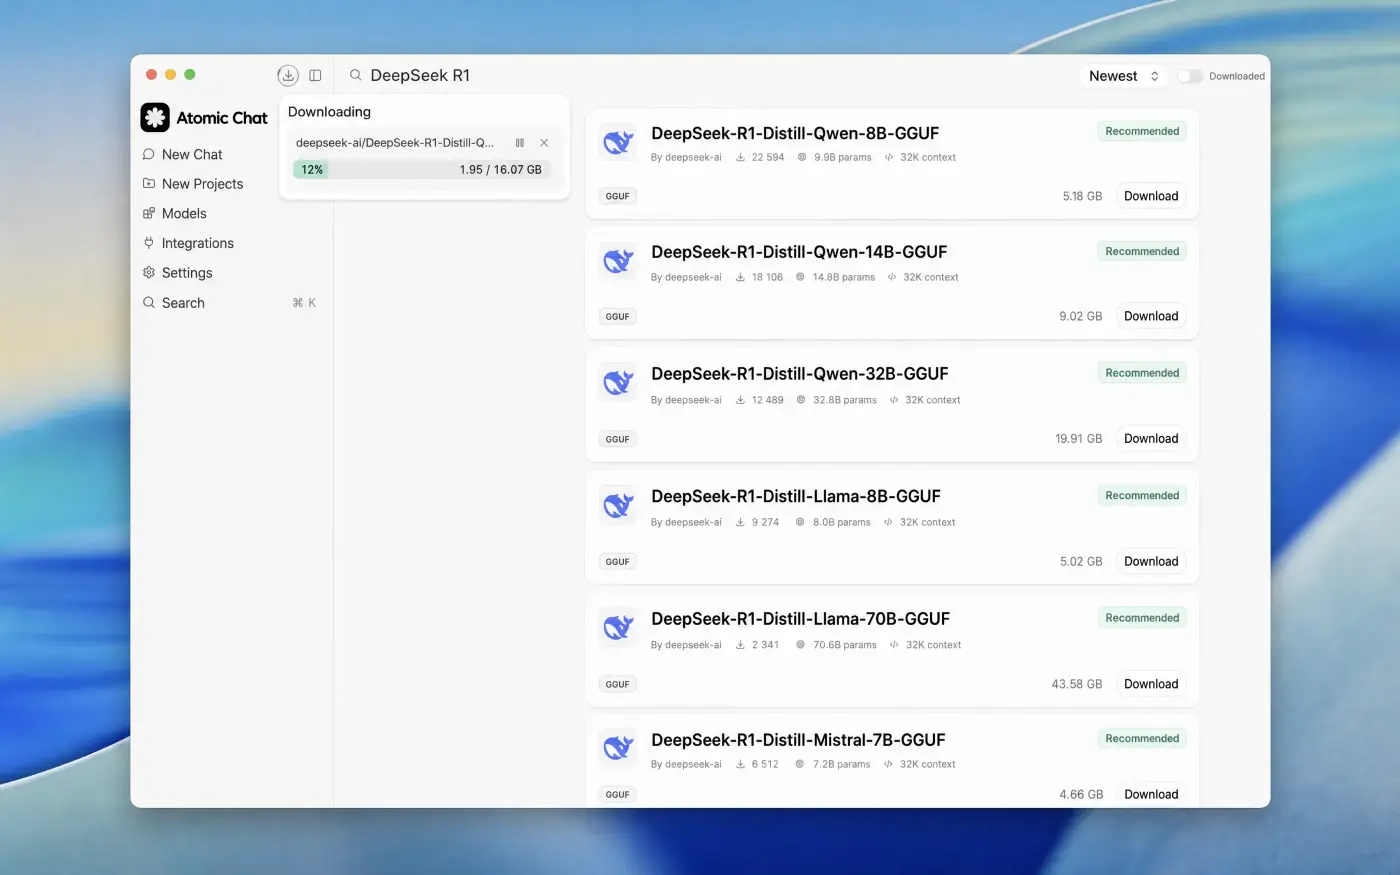
- 「DeepSeek R1」を検索し、サイズを選んでダウンロードします。Atomic Chatには、DeepSeek R1の蒸留版がサイズとともに一覧表示され、ワンクリックでダウンロードできるDownloadボタンが用意されています。
お使いのメモリに収まるモデルを選ぶと、アプリがHugging Faceから重みを取得します。迷ったら8Bの蒸留モデルから始めてください。
- チャットを始めます。ダウンロードが完了するとモデルが読み込まれ、通常のチャットウィンドウでDeepSeek R1と完全オフラインで対話できます。
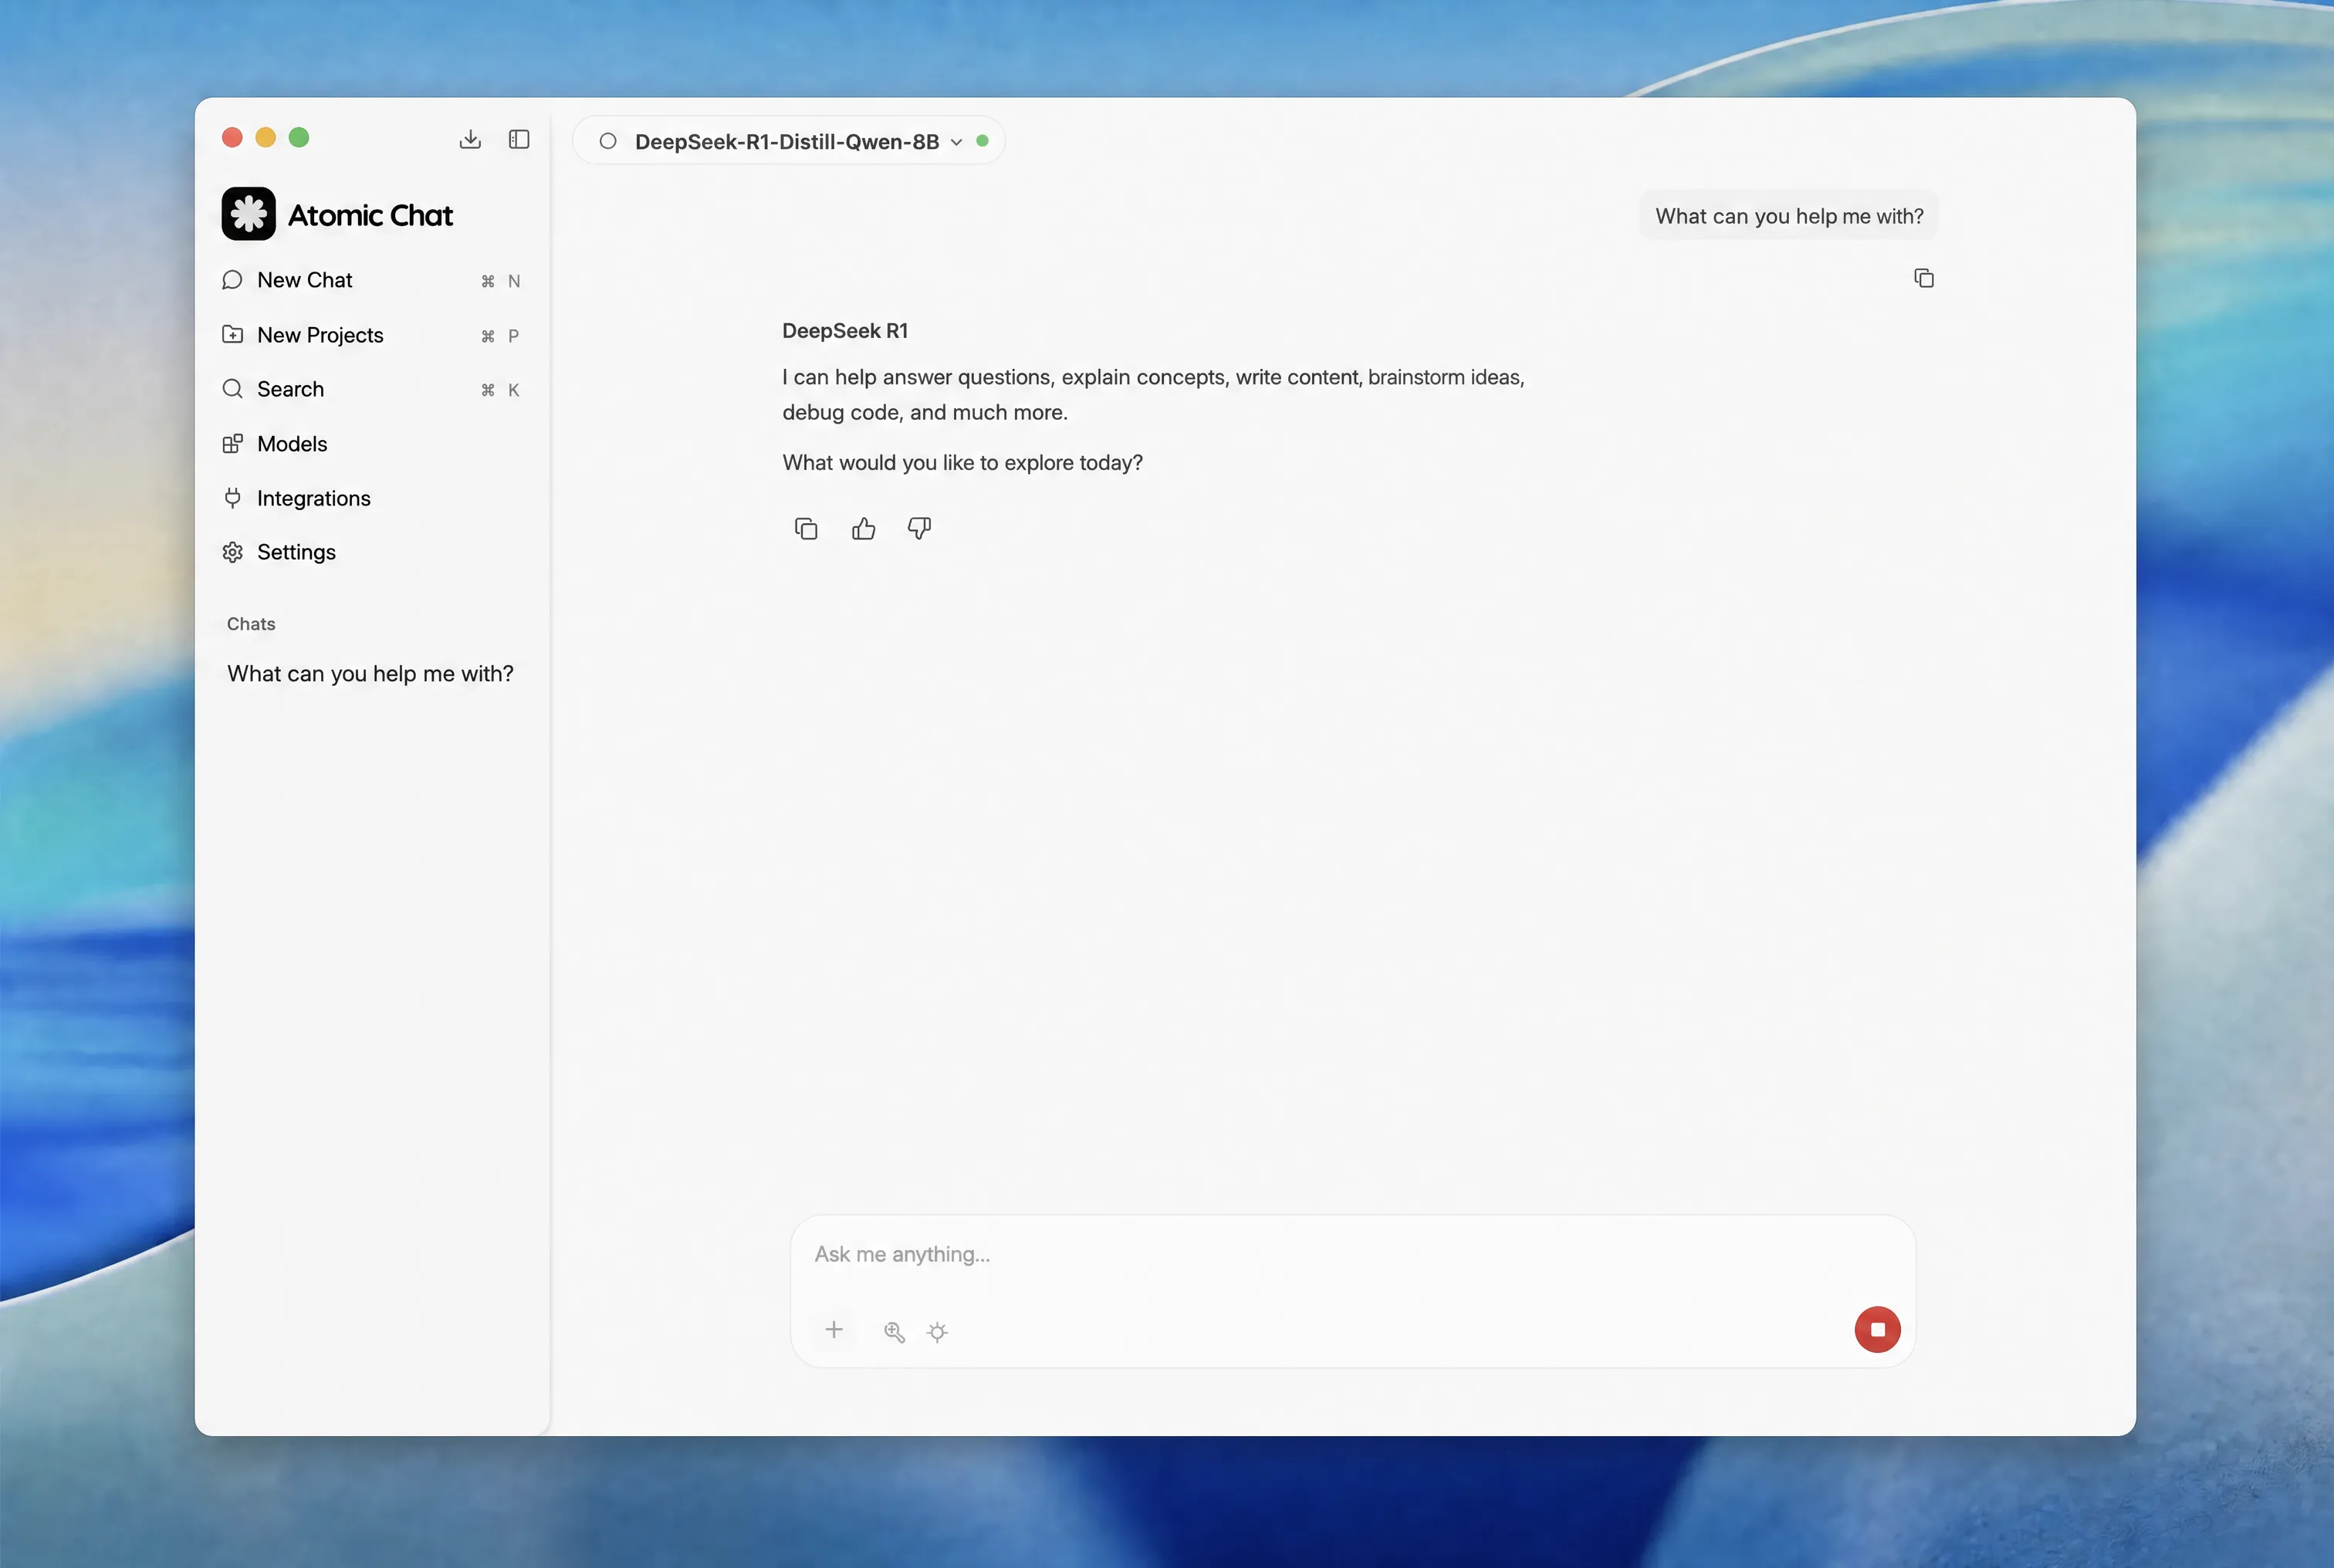
DeepSeek R1 GGUFモデルを選ぶと、Atomic Chatは速度と性能のバランスが取れる適切な量子化も自動で選択します。
また、AtomicChatはTurboQuant推論エンジンを搭載し、Multi-Token Predictionモデルを採用しています。この2つを組み合わせることで、同じハードウェアでもモデルが30〜70%高速に動作します。
開発者向けに、Atomic Chatはhttp://localhost:1337/v1でOpenAI互換APIを公開しているため、OpenAI SDKとやり取りするツールなら、接続先をローカルのDeepSeekに切り替えられます。サーバーはデフォルトでループバック接続のみに制限されているため、設定を変更しない限り、ネットワークには何も公開されません。また、MCPもサポートしており、OpenCodeやGooseなどのエージェントツールからローカルモデルを呼び出せます。
OllamaでDeepSeek R1をローカル実行する方法
Ollamaは、macOS、Windows、LinuxでDeepSeek R1などのモデルをローカル実行するための、無料のオープンソースツールです。OllamaでDeepSeekをローカル実行する方法は2つあります。
方法A:Ollamaのデスクトップアプリ
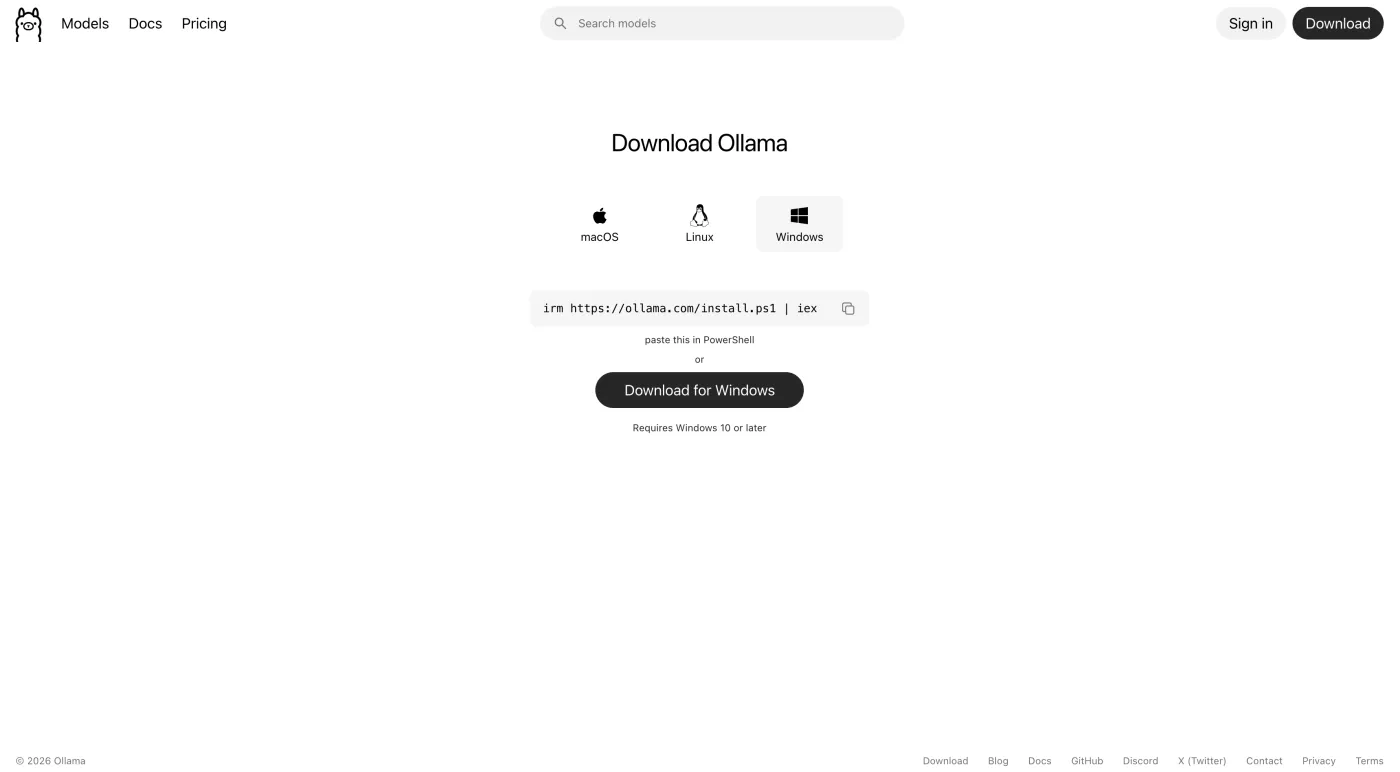
- Ollamaをインストールします。Ollamaの公式サイトからインストーラーをダウンロードして実行します。macOS版とWindows版が用意されています。
Ollamaのデスクトップアプリがインストールされ、バックグラウンドで動作します。メニューバー(Mac)またはシステムトレイ(Windows)のアイコンをクリックして、チャットウィンドウを開きます。
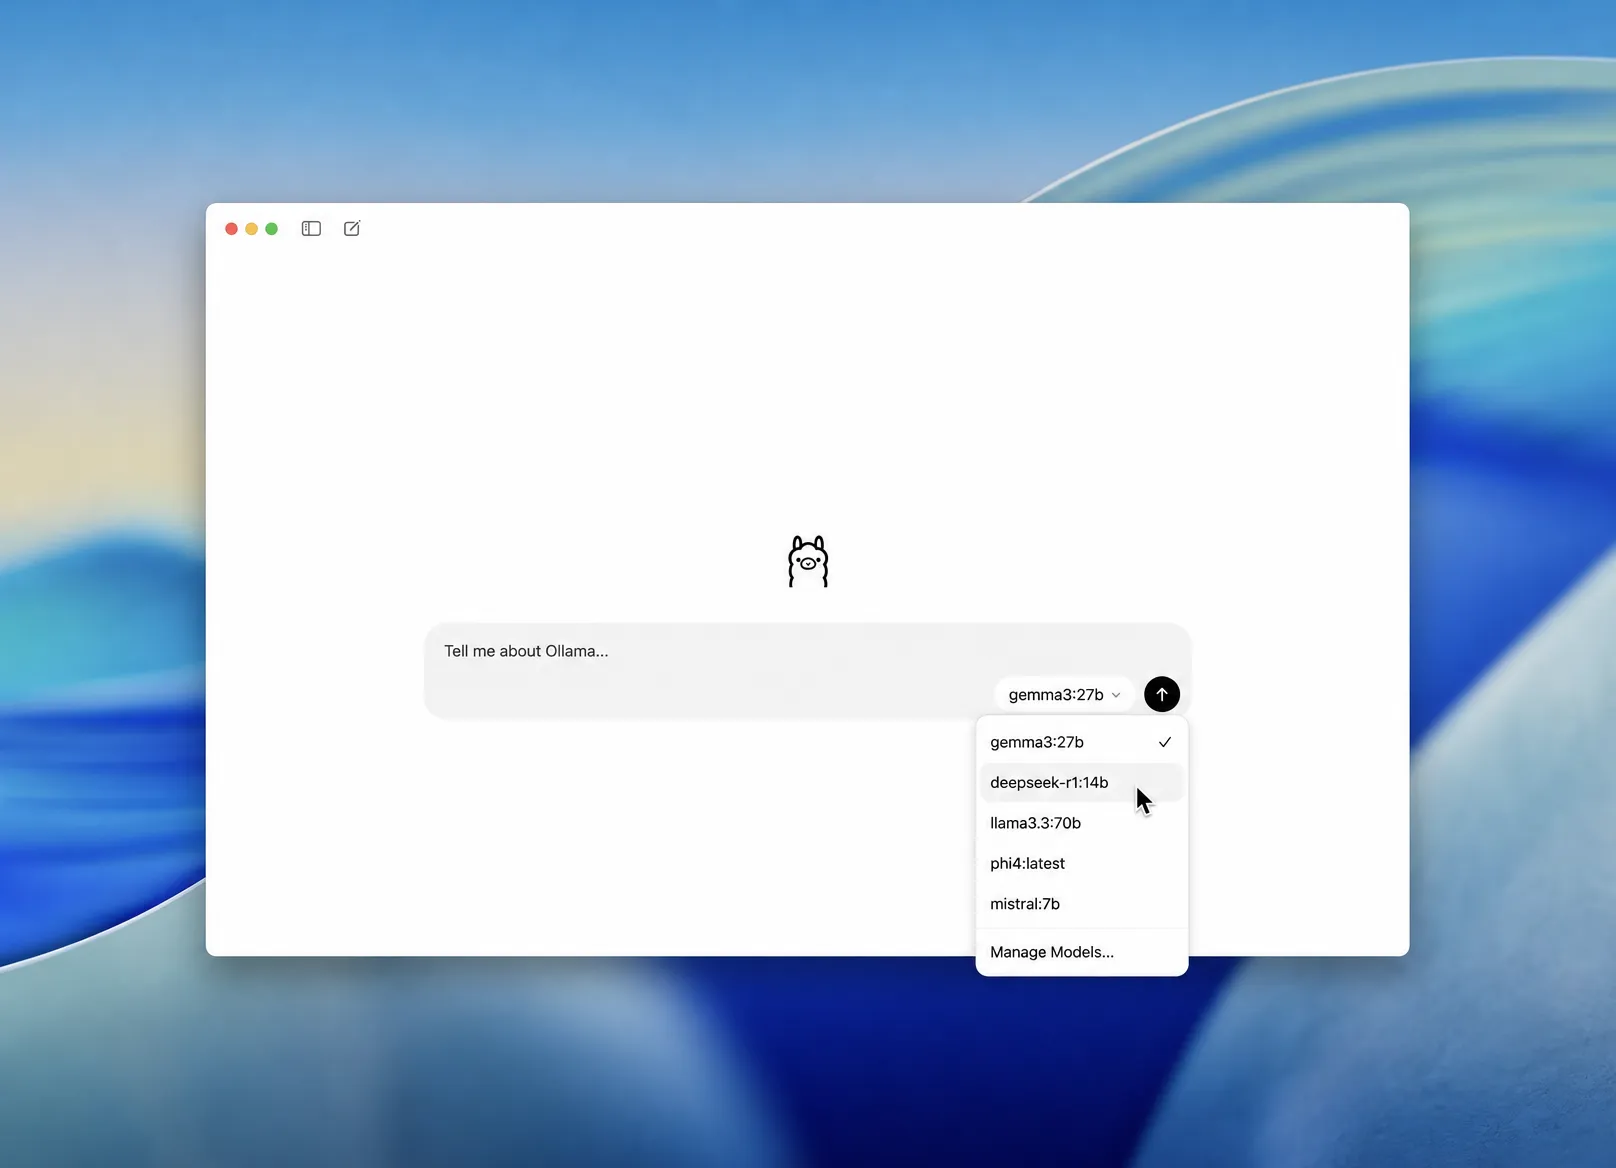
- モデルのドロップダウンからDeepSeek R1を選びます。メッセージ入力欄の横にあるモデル選択メニューを開き、DeepSeek R1のサイズを選びます。まだ持っていないモデルを選ぶと、自動でダウンロードされます。
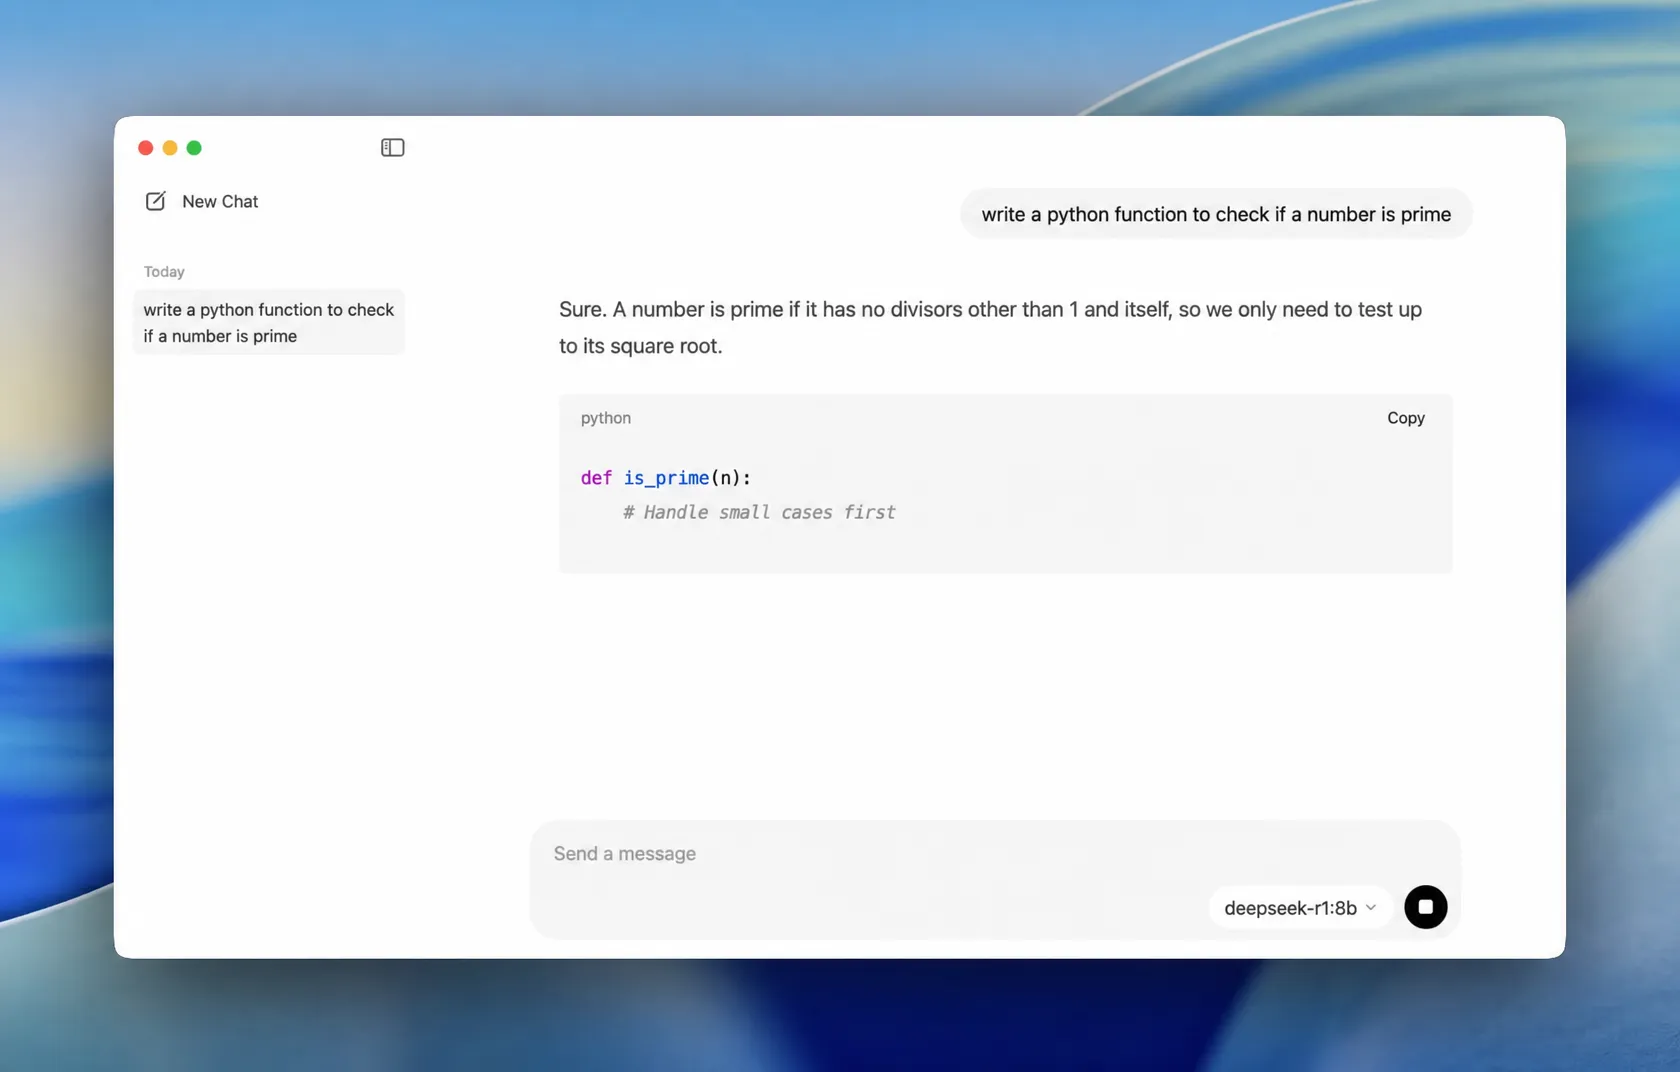
- メッセージを送信します。ダウンロードが完了したら、プロンプトを入力してEnterキーを押します。DeepSeek R1がチャットウィンドウ内で回答し、これ以降はすべてオフラインで動作します。
方法B:ターミナル
まだOllamaをインストールしていない場合は、インストールしてください。
- インストーラーを使う場合:macOSまたはWindowsを使っている場合は、Ollamaの公式サイトにアクセスしてインストーラーをダウンロードします。インストールすると、コマンドラインツールも一緒にインストールされます。
- インストールスクリプトを使う場合:シェルで次の1行を実行します。
- パッケージマネージャーを使う場合:すでに使っているものがあれば、次のコマンドでインストールできます。
続いて、このコマンドをコピーし、シェルに貼り付けて実行します。
初回実行時にはollamaがモデルをダウンロードするため、モデルのサイズによっては時間がかかる場合があります。
2回目以降の実行ではモデルがキャッシュされているため、すぐに起動します。8bの部分はモデルタグです。別のサイズを実行するには、この部分を変更します。
DeepSeekをローカルで実行するメリット
自分のマシンでDeepSeekを実行する人には、通常3つの理由があります。いずれも、自分のデータ、費用、アクセスを自分で管理することに行き着きます。
プロンプトがサーバーに送られることはありません。モデルが完全にローカルで動作していれば、プライバシーのリスクはゼロです。入力した内容がDeepSeekにも、それ以外の誰にも送られないと分かっていることは、大きな安心につながります。
ダウンロード後は無料で、レート制限もありません。サブスクリプションもトークン単位のAPI料金もありません。クラウドAPIでは月に数百〜数千ドルかかることもある大量の利用でも、その費用はゼロになります。
インターネット接続が一切なくても動作します。重みがディスクに保存されていれば、DeepSeekは飛行機の中でも、ファイアウォールの内側でも、エアギャップ環境でも動作します。公式のDeepSeekサービスが停止したり、ブロックされたりしても、使い続けられます。
DeepSeekをローカルで実行する際の制約
DeepSeekのローカル実行にはトレードオフもあり、理解しておく価値があります。主な3つを紹介します。
ローカルのDeepSeek蒸留モデルは、クラウドのフラッグシップ版DeepSeekには及びません。ローカルの8Bモデルは、プライバシーを保ちながら行う日常的な作業に適していますが、答えが一意に定まらない最難関の推論では、クラウド上の完全版R1やGPT-5.5などのモデルは別格です。
速度はハードウェアに左右されます。高性能なGPUなら毎秒50トークン以上を生成できますが、CPUだけでDeepSeekをローカル実行する場合は、毎秒2〜5トークンまで落ちることもあり、非常に低速です。
ローカルのDeepSeekは自分で設定する必要があります。Atomic Chatを使えばローカルモデルを始めるのは非常に簡単ですが、Webサイトで使う場合と比べると、追加の手順は必要です(たとえば、モデルのサイズをマシンのメモリに合わせたり、量子化が性能に与える影響を理解したりする必要があります)。ローカルのDeepSeekはストレージ容量も使い、実行中はシステムに負荷をかけます。
それでも、日常的な作業では、ローカルの8Bまたは14BのDeepSeek R1蒸留モデルは、今でも強く支持する人がいるGPT-4oとほぼ同等の性能を備えています。
よくある質問
DeepSeekのローカル実行について、よくある質問に回答します。
DeepSeekはローカルで実行できますか?
はい、DeepSeekはローカルで実行できます。DeepSeekはR1をオープンウェイトモデルとして公開しているため、重みを無料でダウンロードし、自分のマシンで実行できます。一般的なパソコンでは、Atomic ChatなどのアプリやOllamaを通じて、蒸留版(1.5Bから70B)のいずれかを実行します。完全版の671Bモデルには、サーバークラスのハードウェアが必要です。
DeepSeek R1を実行するには、どれくらいのRAMが必要ですか?
モデルのファイルサイズの約2倍の空きメモリを見込んでください。8Bの蒸留モデル(約5 GB)は、8 GBのGPU VRAMまたは16 GBのシステムRAMを備えたマシンで快適に動作します。1.5Bモデルは約4 GBで動作しますが、32Bと70Bの蒸留モデルには、それぞれ24 GBと48 GBが必要です。
DeepSeekのローカル実行は無料ですか?
はい。モデルの重み、Atomic Chat、Ollamaはすべて無料で、モデルをダウンロードした後に利用料金はかかりません。費用がかかるのは、すでにお持ちのハードウェアと、重みを保存するディスク容量だけです。
DeepSeekをオフラインで実行するのは安全で、プライバシーも守られますか?
DeepSeekのオフライン実行では、ローカルソフトウェアとして最大限のプライバシーが得られます。重みをダウンロードした後は、モデルが完全にデバイス上で動作し、プロンプトがDeepSeekやほかの誰かのサーバーに送信されることはありません。これが、公式アプリよりもローカル環境を選ぶ主な理由です。
MacでDeepSeek R1を実行するには、どの方法が最適ですか?
Apple Silicon Mac(M1以降)では、Atomic Chatのようなデスクトップアプリを使うのが最も簡単です。より高速なDeepSeek R1のMLXビルドを実行でき、Macのユニファイドメモリも効率よく利用できるためです。16 GBのMacなら8Bの蒸留モデルを快適に実行でき、32 GBなら14Bと32Bも選択肢に入ります。
ローカルで使う場合、DeepSeek R1とV3にはどのような違いがありますか?
DeepSeek R1は推論モデルです。段階的に思考し、多くの人が数学やコーディングのためにローカルで実行しているモデルです。DeepSeek V3は、その基盤となる汎用チャットモデルです。ここで紹介したローカル向けの蒸留モデルはR1のバージョンです。V3もオープンウェイトですが、完全版のモデルは大きいため、ローカル環境ではR1の蒸留モデルが実用的な選択肢になります。
DeepSeekをローカルで実行する最も簡単な方法
まとめると、DeepSeekはローカルで実行できますが、注意点があります。DeepSeekはオープンソースですが、オリジナルの完全版モデルは巨大で、一般消費者向けデバイスの大半では実行できません。その解決策が蒸留モデルです。DeepSeekがR1自身の推論を使ってファインチューニングした小型のQwenモデルやLlamaモデルであり、R1の思考方法の多くを身に付けながら、お使いのデバイスで実行できる小ささを保っています。オリジナルには完全には及びませんが、大きめの蒸留モデルはそれに近づいており、中規模のモデルでも数学と推論ではすでにOpenAIのo1-miniを上回っています。誰でも実行でき、Atomic Chatのようなアプリを使えば非常に簡単に利用できるのは、うれしい点です。




