

24 GBのGPUまたは32 GBのMacでは、Qwen3.8 27Bから始めてください。64 GBのMacでは、当社の分割GGUFビルドを使ってFlash Nextを実行できます。より大きなGLM、Kimi、Qwen Maxの各モデルには、サーバー向けハードウェアが必要です。
このガイドでは、次の内容を解説します。
- GPT-6 Astraとは
- Claude Fable 5.1およびOpus 5とのベンチマーク比較
- ChatGPTサブスクリプションを使ってAtomic ChatでGPT-6 Astraを利用する方法
- サーバー向けハードウェアが必要なオープンウェイトモデル
- デスクトップPCやMacBookで動作するローカルモデル
GPT-6 Astraとは?
GPT-6 AstraはOpenAIが開発した言語モデルで、GPT-5.6 Solの後継です。OpenAIは2026年9月3日にAstraをリリースしました。100万トークンのコンテキスト長を備え、テキストと画像の入力に対応しています。
GPT-6 Astraの主な仕様:
| 仕様 | GPT-6 Astra |
|---|---|
| リリース日 | 2026年9月3日 |
| APIモデルID | gpt-6-astra |
| コンテキスト長 | 1,050,000トークン |
| 最大出力 | 128,000トークン |
| モダリティ | テキストと画像の入力、テキストの出力 |
| 推論強度 | Low, medium, high, xhigh, max |
| API料金 | 入力1Mトークンあたり$10、出力1Mトークンあたり$50 |
| 重みの公開 | なし |
AstraはCodexで、コンテキストウィンドウをまたいでメモを保持し、以前のメッセージやツール出力を検索しながら、長時間にわたるコーディングタスクを進められます。OpenAIはChatGPTとAPIを通じてこのモデルを提供しています。Atomic Chatは、ユーザーのChatGPTアカウントを通じて接続します。
オフラインで利用するには、以下で紹介するダウンロード可能なモデルのいずれかが必要です。重みをダウンロードしても、Astraのコンピューター操作ツールやCodexのワークフローは含まれません。
GPT-6 Astraの料金はいくらですか?
標準のAPI料金は、入力100万トークンあたり$10、出力100万トークンあたり$50です。キャッシュ済み入力は100万トークンあたり$1です。
リクエストの入力が272,000トークンを超えると、リクエスト全体に高い料金が適用されます。入力100万トークンあたり$20、出力100万トークンあたり$75です。キャッシュされていない入力300,000トークンと出力10,000トークンのリクエストは、$6.75かかります。
Atomic ChatにChatGPTサブスクリプションを接続すると、アカウントのCodex利用枠を使用します。上記のAPI料金は、別途課金されるAPI利用に適用されます。
GPT-6 Astraのベンチマーク
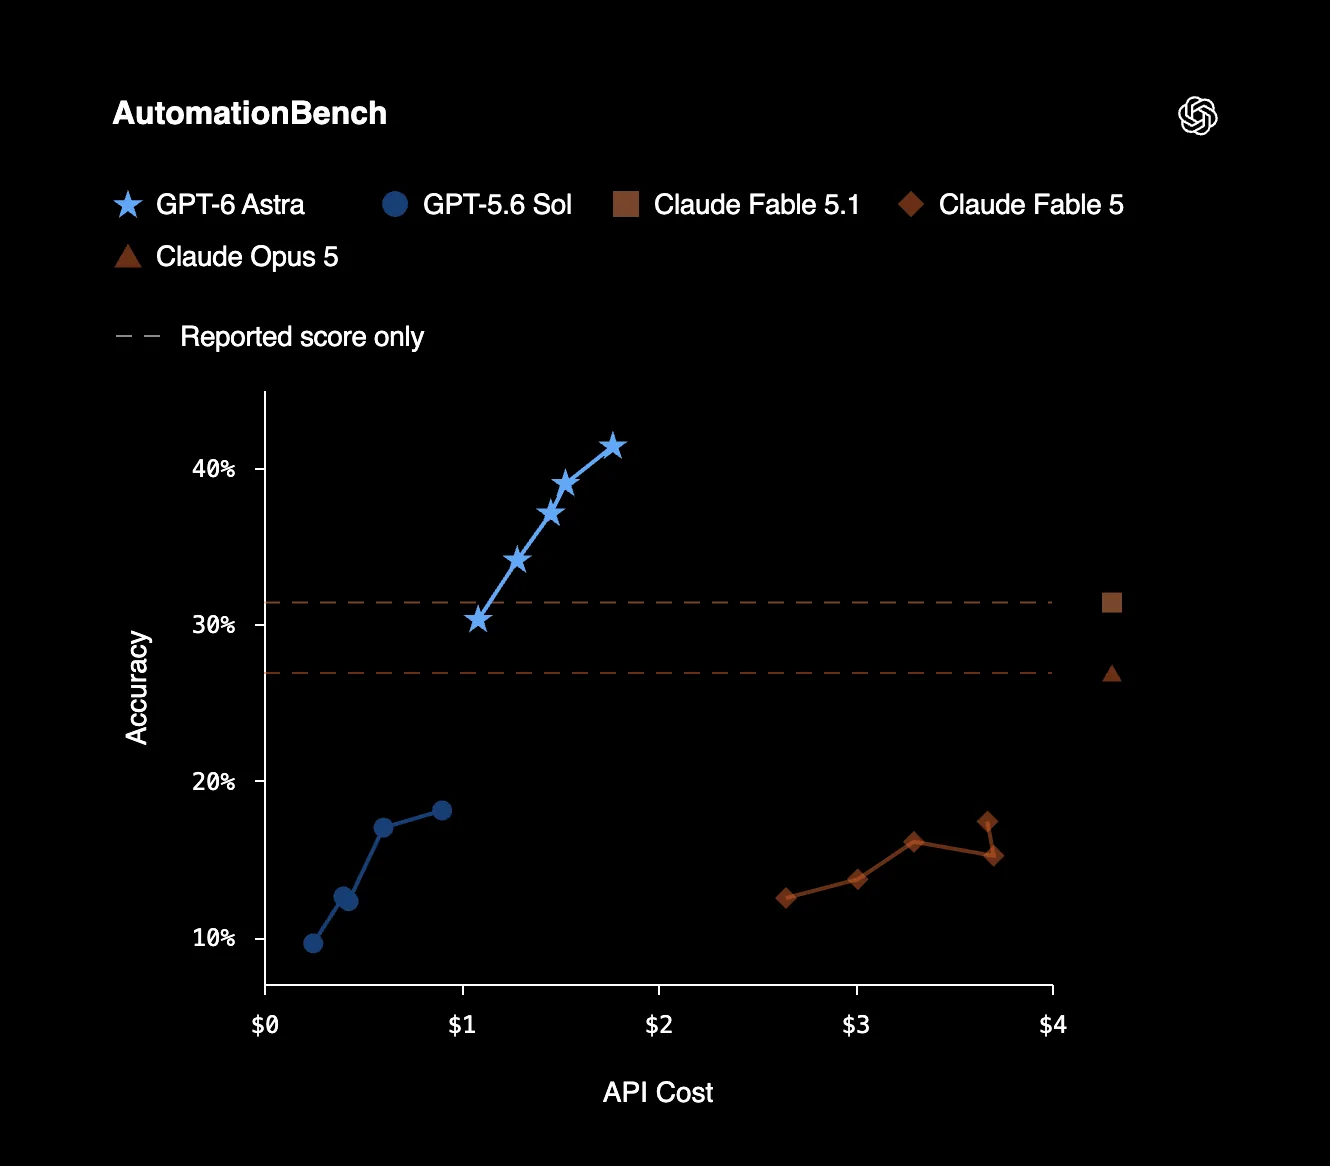
OpenAIのリリース時の数値では、AstraをClaude Fable 5.1、Claude Opus 5、Gemini 3.8 Flashと比較しています。
| ベンチマーク | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5 | Gemini 3.8 Flash |
|---|---|---|---|---|
AutomationBench オフィス業務の自動化 | 41.4 | 31.4 | 26.9 | - |
Artificial Analysis Intelligence Index v4.1.1 汎用的な知能 | 61.2 | 65.7 | 63.1 | 58.7 |
Terminal-Bench 4.0 ターミナルエージェント | 57.9 | 55.8 | 52.6 | 19.1 |
DeepSWE v1.1 エージェントによるコーディング | 74.1 | 67.4 | 73.7 | 73.8 |
GPQA Diamond 専門家レベルの科学 | 96.0 | 93.7 | 93.7 | 95.3 |
Humanity's Last Exam (ツール使用) 専門家レベルの問題 | 57.2 | 65.0 | 63.6 | - |
Astraは6つのベンチマークのうち4つでFable 5.1とOpus 5を上回っています。両モデルに対する差が最も大きいのはAutomationBenchです。Intelligence IndexとHumanity's Last Examでは、Fable 5.1のほうが高いスコアを維持しています。
これらはOpenAIが報告した結果で、各推論強度で得られたスコアのうち最高値を使用しています。ChatGPTやその他の本番アプリでは、異なるツールや設定が使われる場合があります。
Atomic ChatでGPT-6 Astraを利用する方法
Atomic ChatにChatGPTサブスクリプションを接続し、アカウントで利用可能なモデルを使えます。この接続ではOpenAIのCodexサービスを使用し、Codexで使用しているものと同じアカウントの利用枠を使います。
接続手順は次のとおりです。
ステップ1:Atomic Chatをインストールする
atomic.chatからデスクトップアプリをダウンロードし、Mac、Windows PC、またはLinuxマシンにインストールします。
ステップ2:ChatGPTアカウントを接続する
Cloudを開き、ChatGPT subscription (Codex)を見つけて、Connect in browserをクリックします。Codexで使用しているChatGPTアカウントでサインインし、Atomic Chatに戻ります。別途OpenAI APIキーを用意する必要はありません。
ステップ3:GPT-6 Astraを選択する
Atomic Chatが、アカウントで利用可能なモデルを読み込みます。その一覧にGPT-6 Astraが表示されたら選択し、チャットを開きます。
Astraを利用できるかどうかは、アカウントのアクセス権によって異なります。サブスクリプションを接続しても、契約プランに含まれないモデルが利用可能になったり、Codexの利用上限が増えたりすることはありません。
Astraとダウンロードしたローカルモデルを、同じアプリで管理できます。接続したアカウントを通じてAstraを使い、自分のコンピューター上で会話を処理したいときはローカルモデルに切り替えられます。
GPT-6 Astraの代わりとなるオープンウェイトモデル
GLM-5.3、GLM-5.3 Flash、Qwen Max、Kimi K3、DeepSeek V4 Flashは、Astraとの比較対象となる大規模なオープンウェイトモデルです。重みはダウンロードできますが、実行にはサーバー向けハードウェアが必要です。
より小さなQwenとLagunaのモデルは、このガイドの後半で紹介します。デスクトップPCやMacBookで使うなら、これらのモデルが検討対象です。
GPT-6 Astraとオープンウェイトモデルの比較
| モデル | 総パラメータ数 | アクティブパラメータ数 | ハードウェア |
|---|---|---|---|
| GLM-5.3 | 753Bチェックポイント | - | 複数GPUを搭載したサーバー |
| GLM-5.3 Flash | 320B | 18B | 複数GPUを搭載したサーバー |
| Qwen3.8-2.4T-A95B | 2.4T | 95B | データセンターのクラスター |
| Kimi K3 | 2.8T | 104B | データセンターのクラスター |
| DeepSeek V4 Flash 0731 | コア部分は284B | 13B | 複数GPUを搭載したサーバー |
MoEモデルは、トークンごとにパラメータの一部だけを使用します。ただし、ダウンロードにはモデル全体が含まれます。
各ベンダーが報告したモデルのスコアは次のとおりです。各研究組織は、それぞれ独自の評価環境を使用しています。
| ベンチマーク | GPT-6 Astra | GLM-5.3 | GLM-5.3 Flash | Qwen3.8 Max | Kimi K3 | DeepSeek V4 Flash |
|---|---|---|---|---|---|---|
DeepSWE エージェントによるコーディング | 74.1 | 66.9 | 63.4 | 56.6 | 67.5 | 54.4 |
HLE ツール使用 | 57.2 | 62.5 | 55.3 | 56.2 | 56.0 | - |
Terminal-Bench 2.1 ターミナルエージェント | - | 88.2 | 84.3 | 86.6 | 88.3 | 82.7 |
出典:OpenAI、GLM-5.3、GLM-5.3 Flash、Qwen、Kimi、DeepSeek。これらは各ベンダーのモデルのスコアであり、量子化されたGGUFファイルのスコアではありません。
DeepSWEの結果は、モデルカードにバージョンの記載がないDeepSeekを除き、v1.1を使用しています。ハイフンは、引用元にスコアの記載がないことを示します。
Qwen3.8-2.4T-A95Bは、Qwen Maxのダウンロード可能なバージョンです。テキストのみに対応し、すべてのリクエストで推論を行います。上記のスコアはホスト型のQwen3.8 Maxのもので、こちらは画像入力、思考を行わない応答、組み込みツールにも対応しています。
より小さなGLMを使いたい場合、GLM-5.3 Flashは総パラメータ数320B、アクティブパラメータ数18Bです。当社のKimi K3ガイドでは、より大きなこのモデルをレンタルGPUで実行する方法を解説し、DeepSeek V4 Flashガイドでは、そのGGUFビルドとセットアップを解説しています。
Macやワークステーション向けのローカル代替モデル
当社の分割GGUFビルドを使えば、64 GBのMacでQwen3.8 Flash Nextを実行できます。Laguna S 2.1には、さらに多くのメモリが必要です。現在の公式Q4_K_Mファイルだけで96 GBあります。
Qwen3.8 Flash Next
Flash Nextは、アクティブパラメータ数6Bの125B Mixture-of-Expertsモデルで、さらにn-gramテーブルと予測ヘッドを備えています。当社のGGUFはn-gramテーブルをSSD上に保持するため、ダウンロードしたデータ全体がメモリに収まる必要はありません。
64 GBのMacBook Pro M5 MaxでAD-3.84bpw-IQ4_XS-M64ビルドを測定したところ、毎秒36トークンでした。ダウンロードサイズは84.9 GBで、GPUに常駐する重みは45.8 GBです。アプリとコンテキストキャッシュは、追加のメモリを使用します。
ファイルとセットアップについては、当社のFlash Nextをローカルで実行するガイドをご覧ください。測定の詳細はAtomic GGUFリポジトリに記載されています。
Laguna S 2.1
Laguna S 2.1は、アクティブパラメータ数が約8Bの、Poolsideの118Bコーディングモデルです。Poolsideは、Terminal-Bench 2.1で70.2、DeepSWEで40.4と報告しています。
公式のQ4_K_Mのダウンロードは96 GBです。そのため、このビルドは64 GBのMacの容量を超えます。重みとコンテキストキャッシュを収められるだけのメモリを搭載したマシンが必要です。Poolsideのリポジトリには、llama.cppとOllamaでの実行手順が含まれています。
普段使いのハードウェア向けのローカル代替モデル
Qwen3.8 27BとLaguna XS 2.1は、普段使いのマシンで実行できる小型モデルです。以下の構成では、24 GBのGPUを搭載したデスクトップPC、または32~36 GBの統合メモリを搭載したMacBookを指します。
| モデル | パラメータ数 | GGUFファイル | ハードウェア |
|---|---|---|---|
| Qwen3.8 27B | 27Bデンスモデル | Atomic AD-Q4_K_M、17.1 GB | 24 GBのGPUまたは32 GBのMac |
| Laguna XS 2.1 | 総数33B、アクティブ3B | 公式Q4_K_M、20.3 GB | Metal対応の36 GBのMac |
Qwen3.8 27B
24 GBのGPUでは、Qwen3.8 27Bが第一候補です。当社のAD-Q4_K_Mファイルは17.1 GBで、8Kのコンテキストとランタイムに使う容量を確保できます。同じビルドは、32 GBのApple Silicon Macにも収まります。
Qwenの公開結果では、27BはSWE-bench Proで61.7、GPQA Diamondで89.2を記録しています。このモデルはテキストだけでなく画像も入力できるため、コードに加えてスクリーンショットや文書にも利用できます。
ネイティブのコンテキスト長は262,144トークンですが、すべてを割り当てる必要はありません。8,192から始めてください。会話が長くなるとKVキャッシュによるメモリ使用量が増え、最大のコンテキスト長を使うには24 GBのカードをはるかに上回るメモリが必要です。
当社のQwen3.8 27Bガイドでは、ほかの量子化形式やハードウェア構成を解説しています。
Laguna XS 2.1
Laguna XS 2.1はLaguna Sの小型版で、総パラメータ数は33B、トークンごとのアクティブパラメータ数は3Bです。公式Q4_K_Mファイルは20.3 GBで、Poolsideは36 GBのMac構成を掲載しています。
Poolsideは、SWE-bench Proの公開データセットで47.6と報告しています。Qwenの公開スコアのほうが高いものの、ベンダーごとに異なるコーディングエージェントと評価設定を使用しています。
Macでは、GGUFリポジトリのランタイム手順に従ってください。PoolsideはそこでMetal向けの実行手順を提供していますが、メインのモデルカードではollama runに関するApple Siliconの問題を指摘しています。
Atomic Chatでローカルモデルを実行する方法
Atomic Chatには、Hugging Faceのモデルブラウザーとチャット機能が組み込まれています。llama.cppを自分でビルドせずに、ローカルモデルをダウンロードできます。
Qwen3.8 27Bを実行する手順は次のとおりです。
ステップ1:当社のQwen3.8 27B GGUFを探す
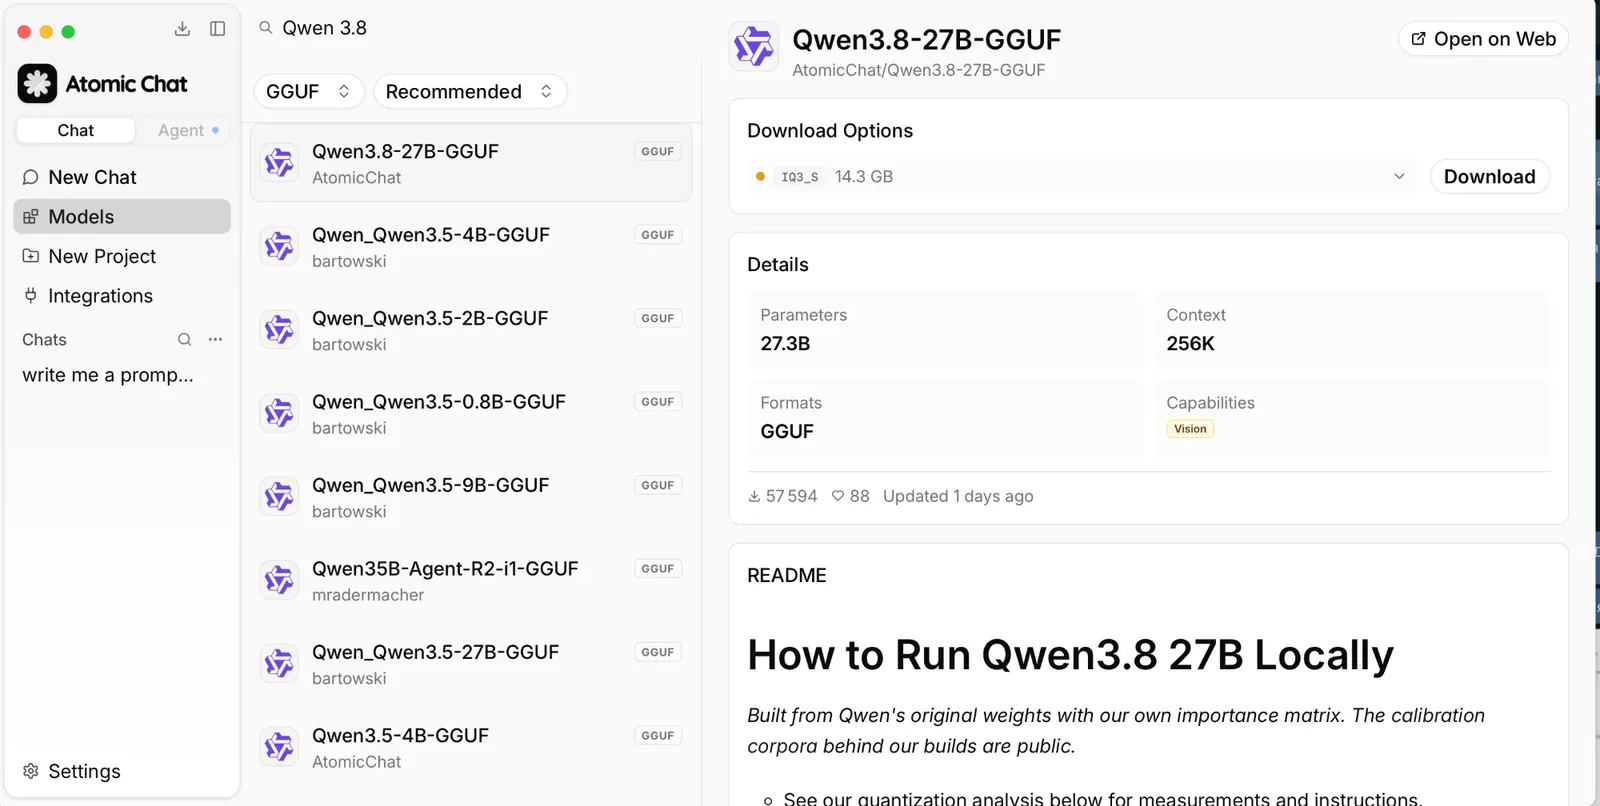
Modelsタブを開き、AtomicChat/Qwen3.8-27B-GGUFを検索します。AtomicChatのリポジトリを選び、Download Optionsを展開します。
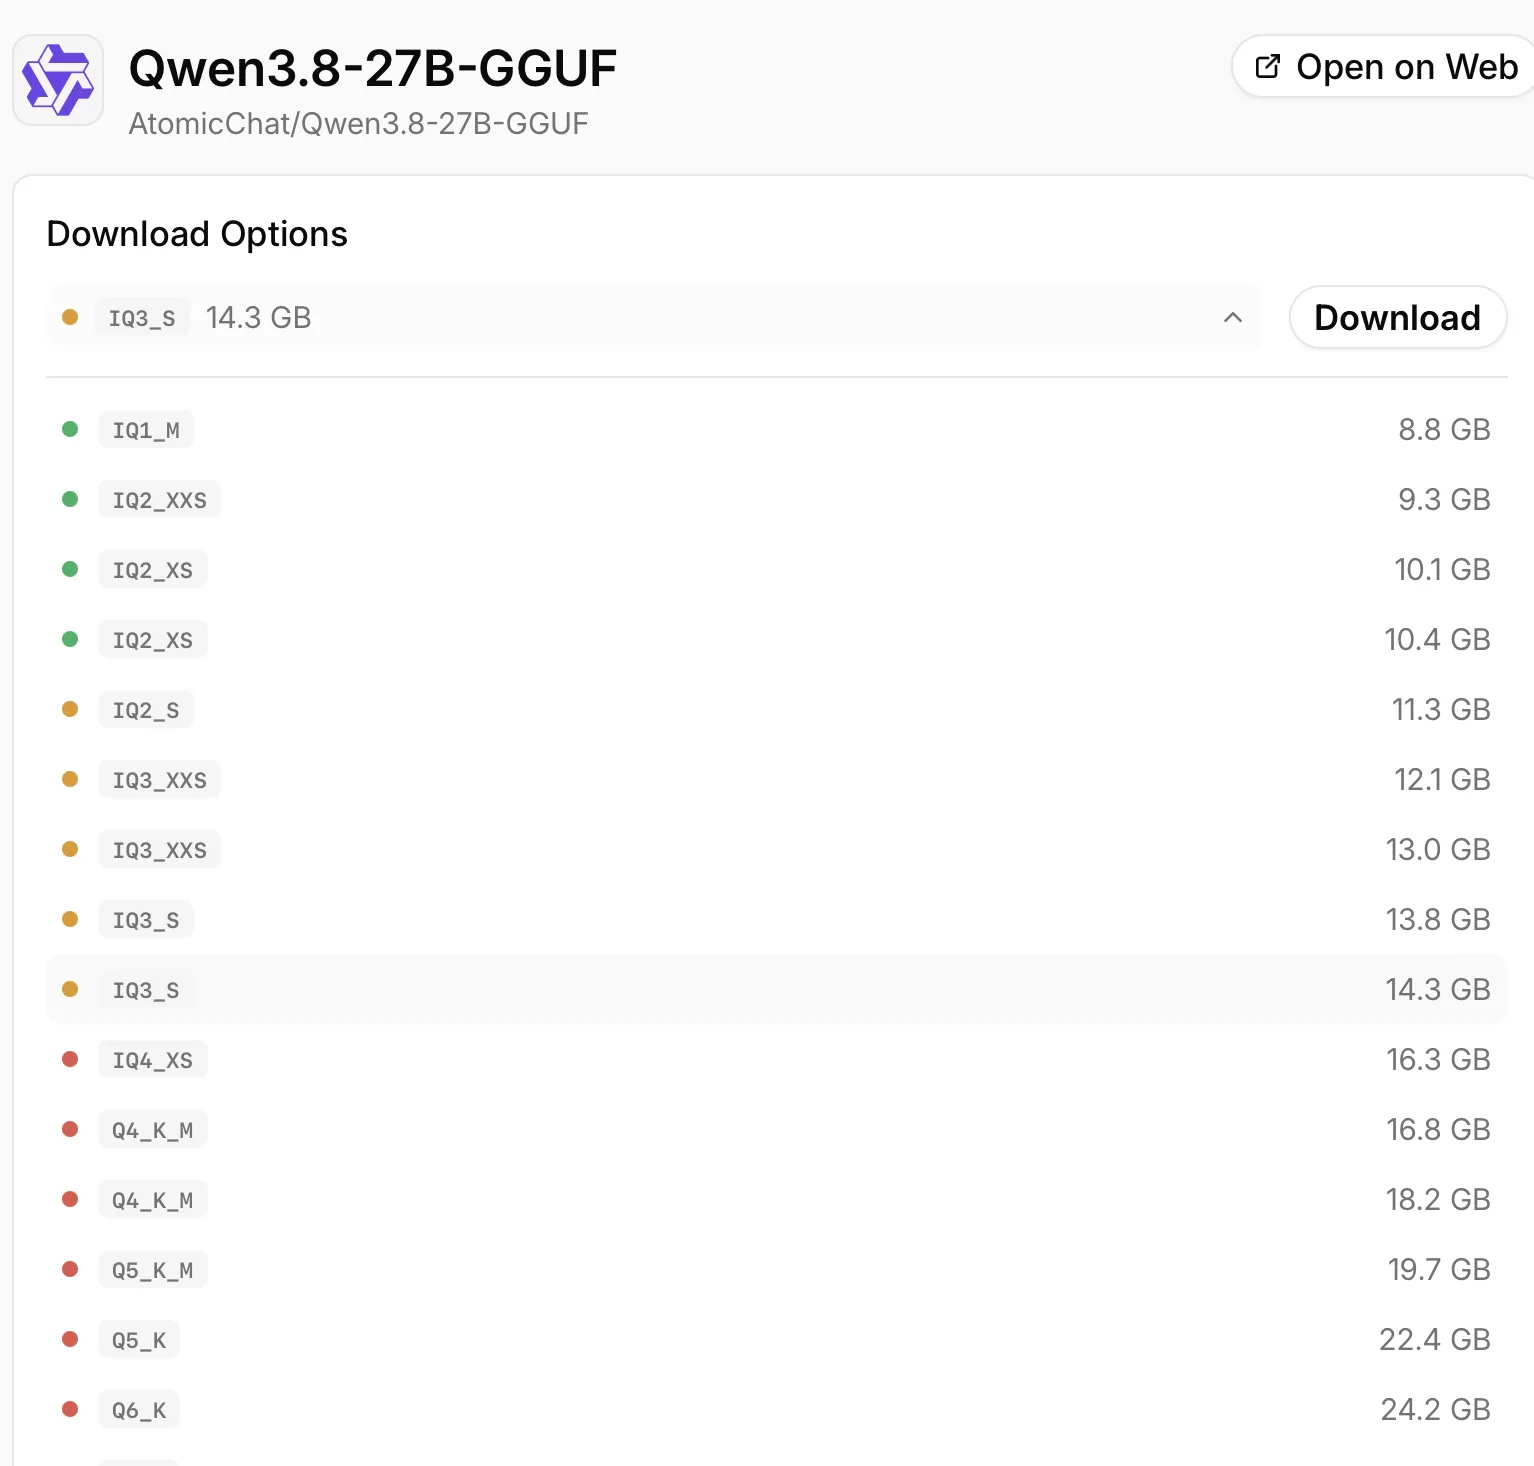
ステップ2:メモリ容量に合った量子化を選ぶ
24 GBのGPUまたは32 GBのMacの構成では、AD-Q4_K_Mをダウンロードします。選択画面には短縮名のQ4_K_Mが表示されるため、ファイルサイズを確認して17.1 GBのビルドを特定してください。
ステップ3:コンテキスト長を設定する
Settings > Model Providers > Llama.cppを開き、ダウンロードしたモデルを見つけて、その行の歯車アイコンをクリックします。
Context Sizeを8192、GPU Layersを-1に設定し、全レイヤーをGPUにオフロードします。メモリ上限に近い場合は、長いチャットでマシンの搭載量を超えるメモリが割り当てられないように、Auto Increase Context Sizeをオフにしてください。
ステップ4:ローカルでチャットする
ダウンロードが完了すると、Atomic Chatがモデルを読み込み、内蔵チャットで開きます。回答は自分のコンピューターが生成します。
http://localhost:1337/v1にあるAtomic ChatのOpenAI互換サーバーを通じて、コーディングツールを接続することもできます。その設定方法は、ローカルLLMセットアップガイドで解説しています。
よくある質問
ChatGPTサブスクリプションを使って、Atomic ChatでGPT-6 Astraを利用できますか?
はい。ChatGPT subscriptionプロバイダーを接続し、アカウントで利用可能なモデルからAstraを選択してください。この接続では、Codexの利用枠を使用します。
GPT-6 Astraはローカルで実行できますか?
いいえ。OpenAIは、ダウンロード可能なAstraの重みを公開していません。Atomic Chatでは、接続したOpenAIアカウントを通じてAstraが動作し、ダウンロードしたQwenやLagunaのモデルは自分のハードウェアで動作します。
GPT-6 AstraはClaude Fable 5.1やOpus 5より優れていますか?
上記のOpenAIの比較では、Astraは6つのベンチマークのうち4つでリードしています。Intelligence Indexとツールを使用したHumanity's Last Examでは、Fable 5.1とOpus 5の両方がより高いスコアを記録しています。
24 GBのGPUに最適なローカル代替モデルは何ですか?
17.1 GBのAtomic AD-Q4_K_Mビルドを使ったQwen3.8 27Bです。コンテキスト長は8Kから始めてください。64 GBのMacでは、より大きなFlash Nextモデルも実行できます。
ローカルモデルはChatGPTの利用枠を消費しますか?
いいえ。ダウンロードしたモデルは自分のコンピューターで動作し、ChatGPTサブスクリプションを使用しません。利用枠が適用されるのは、接続したChatGPTプロバイダーを通じてモデルを選択した場合です。
まとめ
ChatGPTサブスクリプションを使ってAtomic ChatでAstraを利用し、同じアプリにローカルモデルも保持できます。24 GBのGPUまたは32 GBのMacでは、Qwen3.8 27B AD-Q4_K_Mをダウンロードし、コンテキスト長8Kから始めてください。64 GBのMacでは、当社で動作を検証した、より大きな選択肢としてFlash Nextがあります。
要点:
- OpenAIのリリース時の比較では、選定された自動化とコーディングのベンチマークでAstraがリードしています。
- Atomic ChatでChatGPTを接続すると、アカウントのCodex利用枠を使用します。
- Qwen3.8 27Bは、4ビット量子化で24 GBのGPUに収まります。
- Flash Nextは、n-gramテーブルをSSD上に置くことで、64 GBのMacで動作します。
- GLM-5.3、Qwen Max、Kimi K3、DeepSeek V4 Flashには、サーバー向けハードウェアが必要です。




