

7つのローカルテキスト埋め込みモデルをSciFactとNFCorpusでテストし、検索品質、インデックス作成速度、メモリ使用量を比較しました。
- Qwen3-Embedding-8Bは両データセットで最高のnDCG@10を記録しましたが、メモリ使用量が最も多く、インデックス作成も最も低速でした。Recall@10はEmbeddingGemmaのほうが高い結果でした。
- EmbeddingGemma-300Mは、ピークVRAM使用量が0.96 GiBでありながら、nDCG@10でQwen3-8Bに迫りました。ただし、単一クエリのレイテンシは今回の比較で最も高くなりました。
- all-MiniLM-L6-v2は今回のテストで1,074.7チャンク/秒という最速のインデックス作成速度を記録し、標準のベクトル次元数で最小のインデックスを生成しました。
- Multilingual E5 Largeは100言語に対応しています。今回の英語のみのテストでは、多言語検索で最も優れたモデルを決めることはできません。
モデルの概要
| モデル | パラメータ数 | 次元数 | モデルの入力上限 | 重みファイル | ライセンス |
|---|---|---|---|---|---|
| BAAI/bge-m3 | 567.8M | 1,024 | 8,192 | 2.12 GiB | MIT |
| nomic-ai/nomic-embed-text-v1.5 | 136.7M | 768 | 8,192 | 0.51 GiB | Apache-2.0 |
| Qwen/Qwen3-Embedding-0.6B | 595.8M | 1,024 | 32k | 1.11 GiB | Apache-2.0 |
| intfloat/multilingual-e5-large | 559.9M | 1,024 | 512 | 2.09 GiB | MIT |
| google/embeddinggemma-300m | 300Mクラス | 768 | 2,048 | 1.15 GiB | Gemma Terms |
| Qwen/Qwen3-Embedding-8B | 7.57B | 4,096 | 32k | 14.10 GiB | Apache-2.0 |
| sentence-transformers/all-MiniLM-L6-v2 | 22.7M | 384 | 256 | 0.08 GiB | Apache-2.0 |
最適な埋め込みモデル:品質、速度、メモリ
以下の表では、検索品質と速度・メモリ使用量を分けて示しています。両データセットで、nDCG@10はQwen3-8Bが最も高く、Recall@10はEmbeddingGemmaが最も高い結果でした。
| モデル | SciFact nDCG@10 | SciFact Recall@10 | NFCorpus nDCG@10 | NFCorpus Recall@10 |
|---|---|---|---|---|
| Qwen3-Embedding-8B | 0.7953 | 0.9183 | 0.4075 | 0.1968 |
| EmbeddingGemma-300M | 0.7861 | 0.9202 | 0.3901 | 0.2013 |
| Nomic Embed Text v1.5 | 0.7156 | 0.8411 | 0.3488 | 0.1736 |
| Qwen3-Embedding-0.6B | 0.7011 | 0.8332 | 0.3567 | 0.1692 |
| Multilingual E5 Large | 0.6852 | 0.7934 | 0.3299 | 0.1553 |
| all-MiniLM-L6-v2 | 0.6529 | 0.8229 | 0.3183 | 0.1602 |
| BGE-M3 | 0.6510 | 0.7951 | 0.3155 | 0.1518 |
| BM25ベースライン | 0.6402 | 0.7707 | 0.2969 | 0.1471 |
| モデル | クエリ p50 / p95 | インデックス作成(チャンク/秒) | ピークVRAM使用量 | SciFactインデックス |
|---|---|---|---|---|
| Qwen3-Embedding-8B | 34.9 / 42.1 ms | 26.1 | 16.60 GiB | 152.5 MiB |
| EmbeddingGemma-300M | 43.0 / 46.6 ms | 315.0 | 0.96 GiB | 28.6 MiB |
| Nomic Embed Text v1.5 | 10.2 / 11.3 ms | 727.3 | 0.47 GiB | 28.6 MiB |
| Qwen3-Embedding-0.6B | 32.0 / 37.6 ms | 169.9 | 2.49 GiB | 38.1 MiB |
| Multilingual E5 Large | 18.5 / 20.1 ms | 434.3 | 1.29 GiB | 38.1 MiB |
| all-MiniLM-L6-v2 | 6.2 / 7.1 ms | 1,074.7 | 0.24 GiB | 14.3 MiB |
| BGE-M3 | 15.2 / 17.4 ms | 433.0 | 1.30 GiB | 38.1 MiB |
標準のベクトル次元数による密ベクトル検索を使用し、各テキストチャンクを1つの正規化済みベクトルに変換して、コサイン類似度で比較しました。検索後のリランキングは行っていません。インデックスサイズは、SciFactデータセットに必要な非圧縮のfloat32ベクトル行列のサイズを表しており、データベースの追加オーバーヘッドは含みません。
クエリのp50とp95は、それぞれレイテンシの中央値と95パーセンタイル値です。テストレポートには時間の測定範囲が明記されていないため、これらの値をRAG全体の応答時間として扱うべきではありません。
インデックス作成のスループットは、1秒間にエンコードされるチャンク数を測定します。重みファイルのサイズ、ピークVRAM使用量、ベクトルインデックスのサイズは、それぞれ異なるリソースを測定するものです。
EmbeddingGemma-300M:高い再現率と少ないメモリ使用量
EmbeddingGemma-300Mは、スマートフォン、ノートPC、デスクトップでの検索向けにGemma 3を基に構築された、Googleのコンパクトなテキスト埋め込みモデルです。
| モデルの仕様 | EmbeddingGemma-300M |
|---|---|
| 対応言語 | 100以上の自然言語 |
| クエリプロンプト | task: search result | query: |
| 文書プロンプト | title: none | text: |
| プーリング | 平均 |
| 標準のベクトル次元数 | 768次元 |
| Matryoshka対応 | 768、512、256、128次元 |
| 入力上限 | 2,048トークン |
| 対応するdtype | float32またはbfloat16。float16には非対応 |
| ライセンス | Gemma Terms |
今回のテストで、EmbeddingGemmaはnDCG@10が2番目に高く、Recall@10が最も高い結果となり、ピークVRAM使用量は0.96 GiBでした。
| RTX A6000でのテスト | 結果 |
|---|---|
| SciFact nDCG@10 / Recall@10 | 0.7861 / 0.9202 |
| NFCorpus nDCG@10 / Recall@10 | 0.3901 / 0.2013 |
| クエリのレイテンシ、p50 / p95 | 43.0 / 46.6 ms |
| インデックス作成速度 | 315.0チャンク/秒 |
| ピークVRAM使用量 | 0.96 GiB |
| SciFactベクトルインデックス | 28.6 MiB |
ただし、クエリのレイテンシも7モデルの中で最も高い結果でした。
単一クエリのレイテンシよりも、検索品質とメモリ使用量の少なさを重視する場合は、EmbeddingGemmaを選びましょう。
all-MiniLM-L6-v2:最速かつ最小
all-MiniLM-L6-v2は、10億組を超えるテキストペアで学習した6層のsentence-transformerです。
短い文や段落をコンパクトな密ベクトルに変換し、セマンティック検索、クラスタリング、類似度の算出に利用できます。チェックポイントが小さく入力形式もシンプルなため、ローカル検索でよく使われるベースラインとなっています。
| モデルの仕様 | all-MiniLM-L6-v2 |
|---|---|
| 対応言語 | 英語 |
| クエリ / 文書のプレフィックス | なし / なし |
| プーリング | 平均 |
| 標準のベクトル次元数 | 384次元 |
| 入力上限 | 256 WordPiece |
| ライセンス | Apache-2.0 |
MiniLMは、今回測定した中で最速のモデルでした。また、標準のベクトル次元数で最小のインデックスを生成し、ピークVRAM使用量も7モデルの中で最も少ない結果でした。
| RTX A6000でのテスト | 結果 |
|---|---|
| SciFact nDCG@10 / Recall@10 | 0.6529 / 0.8229 |
| NFCorpus nDCG@10 / Recall@10 | 0.3183 / 0.1602 |
| クエリのレイテンシ、p50 / p95 | 6.2 / 7.1 ms |
| インデックス作成速度 | 1,074.7チャンク/秒 |
| ピークVRAM使用量 | 0.24 GiB |
| SciFactベクトルインデックス | 14.3 MiB |
ただし、埋め込みの品質ではEmbeddingGemmaとQwen3-8Bを大きく下回りました。
モデルの入力上限である256 WordPieceを超える文書は、切り捨てを避けるためにチャンク分割が必要です。
結論:インデックス作成速度、クエリのレイテンシの低さ、ベクトルデータベースの小ささを最も重視する場合は、MiniLMを選びましょう。
Nomic Embed Text v1.5:高速なミドルレンジの選択肢
Nomic Embed Text v1.5は、検索、分類、クラスタリング向けに設計された英語モデルで、Matryoshka埋め込みに対応しています。
Nomicの公式手順に従い、ベクトル全体にレイヤー正規化を適用し、目的の次元数に切り詰めた後、L2正規化を適用してください。これによりベクトルのストレージ使用量は減りますが、モデルのパラメータ数は減りません。
| モデルの仕様 | Nomic Embed Text v1.5 |
|---|---|
| 対応言語 | 英語 |
| クエリのプレフィックス | search_query: |
| 文書のプレフィックス | search_document: |
| プーリング | 平均 |
| 標準のベクトル次元数 | 768次元 |
| 対応するMRLの次元数 | 512、256、128、64次元 |
| 入力上限 | 8,192トークン |
| ライセンス | Apache-2.0 |
今回のテストでは、Nomicはクエリのレイテンシと一括インデックス作成の両方で、MiniLMに次いで2番目に高速でした。
| RTX A6000でのテスト | 結果 |
|---|---|
| SciFact nDCG@10 / Recall@10 | 0.7156 / 0.8411 |
| NFCorpus nDCG@10 / Recall@10 | 0.3488 / 0.1736 |
| クエリのレイテンシ、p50 / p95 | 10.2 / 11.3 ms |
| インデックス作成速度 | 727.3チャンク/秒 |
| ピークVRAM使用量 | 0.47 GiB |
| SciFactベクトルインデックス | 28.6 MiB |
SciFactで別途実施したMatryoshkaのテストでは、ベクトルを768次元から512次元に削減しても、nDCGの低下はわずかでした(元の次元数では0.7179、削減後は0.7111)。256次元では、精度の低下がより顕著になりました(0.6857)。
結論:最高の検索スコアを達成することよりも、メモリ使用量の少なさ、クエリのレイテンシの低さ、再インデックス作成の速さを重視する場合は、Nomicを選びましょう。
Qwen3-Embedding-0.6B:コンパクトなQwenの選択肢
Qwen3-Embedding-0.6Bは、Qwenの埋め込みモデルの中で最小のモデルです。
| モデルの仕様 | Qwen3-Embedding-0.6B |
|---|---|
| 対応言語 | プログラミング言語を含む100以上の言語 |
| クエリ形式 | タスク指示を含む登録済みのクエリプロンプト |
| 文書のプレフィックス | なし |
| プーリング | 左パディングを使用し、最後のトークンを取得 |
| ベクトルの次元数 | 32から1,024次元 |
| 公式のコンテキスト長 | 32kトークン |
| 今回の共通テストで使用した上限 | 8,192トークン |
| ライセンス | Apache-2.0 |
Qwen3-0.6Bは、今回の検索ランキングで中位付近に位置しました。NFCorpusのnDCGではNomicを上回りましたが、上位10件の結果に含まれる関連文書はNomicのほうが多いままでした。
| RTX A6000でのテスト | 結果 |
|---|---|
| SciFact nDCG@10 / Recall@10 | 0.7011 / 0.8332 |
| NFCorpus nDCG@10 / Recall@10 | 0.3567 / 0.1692 |
| クエリのレイテンシ、p50 / p95 | 32.0 / 37.6 ms |
| インデックス作成速度 | 169.9チャンク/秒 |
| ピークVRAM使用量 | 2.49 GiB |
| SciFactベクトルインデックス | 38.1 MiB |
Nomicはクエリのレイテンシがより低く、インデックス作成もより高速でした。一方、EmbeddingGemmaはピークメモリ使用量がより少なく、検索スコアがより高い結果でした。Qwenのクエリには、モデルカードの推奨どおりタスク指示を使用してください。文書にはその指示は不要です。
結論:多言語に対応し、指示を考慮するQwenの埋め込み処理を、より小さなチェックポイントで利用したい場合は、Qwen3-Embedding-0.6Bを選びましょう。
Multilingual E5 Large:100言語に対応する検索
Multilingual E5 Largeは、多言語のテキストペアで学習した、XLM-RoBERTaベースの24層モデルです。短いクエリで長い文章の集合を検索する、非対称検索向けに設計されています。
| モデルの仕様 | Multilingual E5 Large |
|---|---|
| 対応言語 | 100 |
| クエリのプレフィックス | query: |
| 文書のプレフィックス | passage: |
| プーリング | 平均 |
| 標準のベクトル次元数 | 1,024次元 |
| 入力上限 | 512トークン |
| ライセンス | MIT |
2つの英語データセットでのテスト結果:
| RTX A6000でのテスト | 結果 |
|---|---|
| SciFact nDCG@10 / Recall@10 | 0.6852 / 0.7934 |
| NFCorpus nDCG@10 / Recall@10 | 0.3299 / 0.1553 |
| クエリのレイテンシ、p50 / p95 | 18.5 / 20.1 ms |
| インデックス作成速度 | 434.3チャンク/秒 |
| ピークVRAM使用量 | 1.29 GiB |
| SciFactベクトルインデックス | 38.1 MiB |
このモデルの入力上限は512トークンのため、長い文書にはチャンク分割が必要です。
結論:複数の言語に対応する検索モデルが必要な場合は、Multilingual E5 Largeを選びましょう。
Qwen3-Embedding-8B:今回のテストで最高のnDCG@10
Qwen3-Embedding-8BはQwen3埋め込みシリーズで最大のチェックポイントで、ベクトルの次元数は0.6Bモデルの4倍です。
| モデルの仕様 | Qwen3-Embedding-8B |
|---|---|
| 対応言語 | プログラミング言語を含む100以上の言語 |
| クエリ形式 | タスク指示を含む登録済みのクエリプロンプト |
| 文書のプレフィックス | なし |
| プーリング | 左パディングを使用し、最後のトークンを取得 |
| ベクトルの次元数 | 32から4,096次元 |
| 公式のコンテキスト長 | 32kトークン |
| 今回の共通テストで使用した上限 | 8,192トークン |
| ライセンス | Apache-2.0 |
Qwen3-Embedding-8BのnDCG@10は、EmbeddingGemmaよりNFCorpusで0.0174、SciFactで0.0092高い結果でした。Recall@10は両方でEmbeddingGemmaのほうが高くなりました。統計的有意性の検定は報告されていません。
Qwen3-8Bのインデックス作成速度は26.1チャンク/秒で、Qwen3-0.6Bは169.9チャンク/秒、MiniLMは1,074.7チャンク/秒でした。標準の4,096次元ベクトルは、1,024次元ベクトルの4倍の未圧縮ストレージ容量を必要とします。
| RTX A6000でのテスト | 結果 |
|---|---|
| SciFact nDCG@10 / Recall@10 | 0.7953 / 0.9183 |
| NFCorpus nDCG@10 / Recall@10 | 0.4075 / 0.1968 |
| クエリのレイテンシ、p50 / p95 | 34.9 / 42.1 ms |
| インデックス作成速度 | 26.1チャンク/秒 |
| ピークVRAM使用量 | 16.60 GiB |
| SciFactベクトルインデックス | 152.5 MiB |
別途実施したMatryoshkaのテストでは、Qwen3-8BのSciFact nDCG@10は、4,096次元で0.7960、1,024次元で0.7905、256次元で0.7672でした。1,024次元に削減すると、未圧縮のベクトル行列のサイズは75%減少しますが、モデルの重みや、そのメモリ使用量は減りません。
自分のコーパスで得られるnDCG@10の高さが、追加のメモリ使用量とインデックス作成の遅さに見合う場合は、Qwen3-Embedding-8Bを選びましょう。
BGE-M3:密ベクトル、疎ベクトル、マルチベクトルによる検索
BGE-M3は、北京智源人工智能研究院(Beijing Academy of Artificial Intelligence)の検索モデルです。1つのチェックポイントで複数の検索方式に対応するよう設計されており、別々の埋め込みモデルを管理せずにセマンティック検索とキーワード検索を組み合わせたい場合に役立ちます。
| モデルの仕様 | BGE-M3 |
|---|---|
| 検索モード | 密ベクトル、疎ベクトル、マルチベクトル |
| 対応言語 | 100+ |
| クエリ / 文書のプレフィックス | なし / なし |
| 密ベクトルのプーリング | CLSトークン |
| 標準のベクトル次元数 | 1,024次元 |
| 入力上限 | 8,192トークン |
| ライセンス | MIT |
今回の比較では、単一の密ベクトルによる検索を対象としています。疎ベクトル、ハイブリッド、マルチベクトルの各モードは評価していません。
| RTX A6000でのテスト | 結果 |
|---|---|
| SciFact nDCG@10 / Recall@10 | 0.6510 / 0.7951 |
| NFCorpus nDCG@10 / Recall@10 | 0.3155 / 0.1518 |
| クエリのレイテンシ、p50 / p95 | 15.2 / 17.4 ms |
| インデックス作成速度 | 433.0チャンク/秒 |
| ピークVRAM使用量 | 1.30 GiB |
| SciFactベクトルインデックス | 38.1 MiB |
結論:多言語検索、疎ベクトル検索、またはマルチベクトル検索を利用する予定がある場合は、BGE-M3を選びましょう。
検索品質、速度、メモリのテスト方法
BEIRのSciFactとNFCorpusのコーパス全体を、公式のテストクエリおよび関連性判定とともに使用しました。
- SciFactには5,183件の文書と300件のテストクエリが含まれています。
- NFCorpusには3,633件の文書と323件のテストクエリが含まれています。
テストでは、およそ250語を上限とする共通のチャンクを使用しました。これはトークン化後の入力が同じになることを保証するものではありません。250語はMiniLMの256 WordPieceという上限を超える場合があります。レポートには、切り捨てが発生した割合や、チャンクのスコアを文書のスコアに集約した方法が明記されていないため、ランキングの差の解釈には限界があります。
各モデル固有のプロンプト、プーリング方式、トークン化を使用し、1基のNVIDIA RTX A6000上で、主にbfloat16で実行しました。モデルごとの正確なdtype、バッチサイズ、ライブラリのバージョン、モデルのリビジョンはレポートに記録されていません。
検索品質は標準的なランキング指標(nDCG@10とRecall@10)で測定し、クエリのレイテンシの中央値と95パーセンタイル値は、ウォームアップ後の100回の実行で測定しました。
Recall@10はクエリごとの関連文書数に依存するため、SciFactとNFCorpusの値を直接比較すべきではありません。今回の比較におけるBM25ベースラインのSciFact nDCG@10は0.6402でした。
nDCGの小さな差について統計的有意性を主張するには、クエリ単位で対応のある分析を行う必要があります。繰り返し実行した際のばらつきだけでは、普遍的な有意性のしきい値を設定することはできません。
RAGパイプラインに適した埋め込みモデルの選び方
1. メモリとレイテンシの制約から考える
EmbeddingGemmaは、少ないメモリ使用量で高い検索品質を求める場合の候補です。今回の測定では、MiniLMとNomicのほうがクエリのレイテンシは低い結果でした。チェックポイントが小さくても、必ずクエリが高速になるわけではありません。
2. より大きなモデルを選ぶ前に検索の失敗を確認する
まず、検索で取得できなかった文書を調べましょう。トークンの切り捨て、クエリと文書のプロンプト、対象言語への対応を確認してください。そのうえで、別の埋め込みモデル、キーワード検索、ハイブリッド検索を比較し、関連文書がすでに取得されているものの順位が低すぎる場合は、リランカーを比較してください。
3. データベースの制約に応じてベクトルの次元数を最適化する
インデックスのストレージ使用量やRAMがボトルネックになる場合は、Matryoshka対応モデルを使用してベクトルの次元数を切り詰めましょう。
ローカル埋め込みとAPI埋め込みの比較
ローカル埋め込みモデルでは、文書のテキストを自分で管理するハードウェア上に保持できます。使用するチェックポイントを厳密に固定し、バッチ処理を調整し、全体の再インデックス作成にかかるコストを算出できます。これは非公開のコーパスや、処理量を予測できる大量処理に役立ちます。ローカルだからといって無料ではありません。ハードウェア、電力、エンジニアの作業時間、モデルの監視には引き続きコストがかかります。
埋め込みAPIを使えばモデルのサービングが不要になり、通常はスケーリングも容易になります。小規模なチームや処理量に変動があるワークロードでは、よりシンプルな選択肢になり得ます。一方で、トークン単位またはリクエスト単位のコスト、システム外へのデータ送信、プロバイダーの制限、バージョン管理がトレードオフとなります。
APIの応答時間には、ネットワーク通信、キューでの待機、プロバイダー側のバッチ処理が含まれます。APIリクエストとローカルGPUでの測定を同等に扱うのではなく、実際に運用するパイプライン全体を比較してください。
埋め込みにどちらの方式を選んでも、生成モデルはローカルで実行できます。RAGシステムの回答生成については、LLMをローカルで実行する方法をご覧ください。形式とランタイムの選択については、GGUFガイドとローカルLLMアプリをご覧ください。
これらのモデルをローカルで実行する方法
これらの埋め込みモデルは、PythonとSentence Transformersを使ってローカルで実行できます。手順は次のとおりです。
Sentence Transformersをインストールします:
pip install -U sentence-transformers次のコードをsearch.pyとして保存します:
from sentence_transformers import SentenceTransformer

model = SentenceTransformer("Qwen/Qwen3-Embedding-0.6B")

documents = [
    "Refunds are available within 30 days of purchase.",
    "The Pro plan includes ten team seats.",
    "Invoices can be downloaded from Billing settings.",
]
query = "Where can I get my invoice?"

document_vectors = model.encode_document(
    documents,
    normalize_embeddings=True,
)
query_vector = model.encode_query(
    query,
    normalize_embeddings=True,
)

scores = model.similarity(query_vector, document_vectors)[0]
top_results = scores.topk(k=2)

for score, index in zip(top_results.values, top_results.indices):
    print(f"{score.item():.3f}  {documents[index.item()]}")
実行します:
python search.py初回実行時にモデルが自動的にダウンロードされます。Sentence Transformersは、対応している利用可能なGPUを使用し、それ以外の場合はCPUで実行されます。
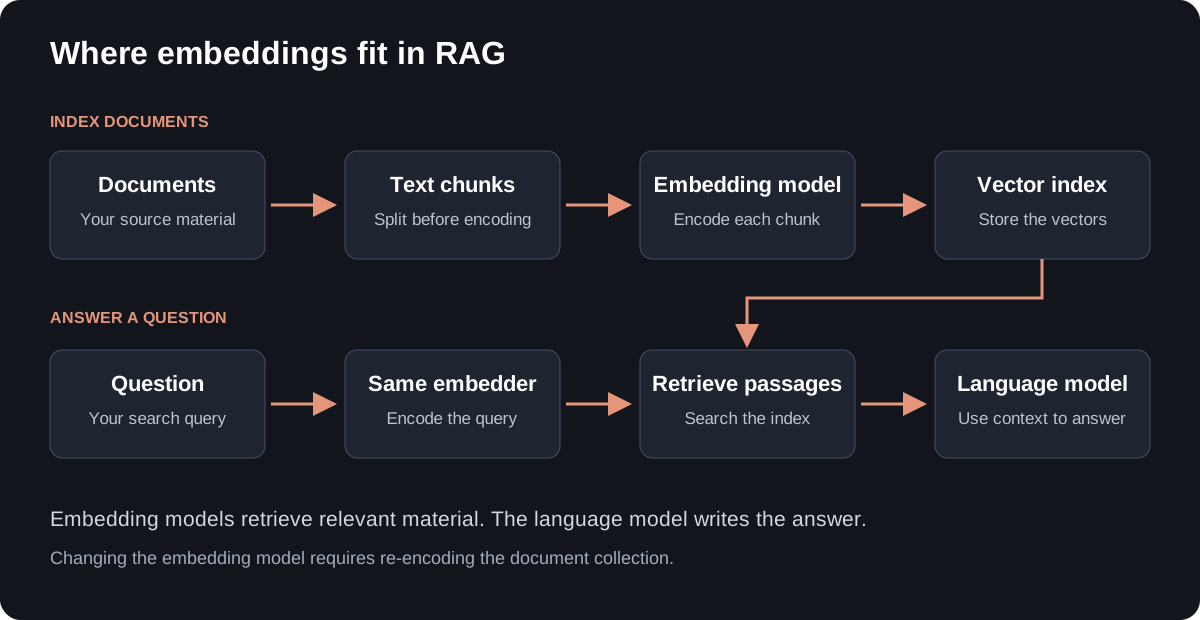
別のモデルをテストするには、そのモデルが対応するローダー、dtype、クエリと文書のプロンプトを使用してください。モデルを切り替える際は、すべての文書とクエリを再エンコードしてください。ベクトルの次元数が一致していても、2つの埋め込み空間に互換性があるわけではありません。
よくある質問
RAGに最適な埋め込みモデルはどれですか?
SciFactとNFCorpusの結果では、Qwen3-Embedding-8Bが最高のnDCG@10を記録しました。EmbeddingGemmaはRecall@10がより高く、ピークVRAM使用量がより少なく、インデックス作成もより高速でしたが、クエリのレイテンシはより高い結果でした。自分のコーパスとレイテンシの制約に基づいて選んでください。
埋め込みモデルは大きいほど常に高性能ですか?
必ずしもそうではありません。たとえば、300MクラスのEmbeddingGemmaモデルは、7.57BパラメータのQwen3モデルに匹敵する性能を示しています。検索品質に影響する主な要因には、アーキテクチャの設計、学習データセットの多様性、検索プロンプトの構造、プーリング手法、コーパスの特性があります。
埋め込み処理をローカルで実行できますか?
はい。これらのモデルは、それぞれのライセンスの下でローカル推論に使える重みをダウンロードできます。今回のテストでは、ピークVRAM使用量が1 GiB未満のモデルが複数ありましたが、これらの測定には48 GBのRTX A6000を使用しています。EmbeddingGemmaには、ApacheやMITライセンスではなくGemma Termsが適用されます。
RAGにリランカーは必要ですか?
必ずしも必要ではありません。リランカーは、追加のレイテンシと計算コストを伴うものの、取得した候補の順位を改善できます。ただし、最初の検索段階で取得されなかった関連文書を取り戻すことはできません。




