
Qwen 3.7-PlusとMiniMax M3は、リリースの間隔がわずか12時間の2つのモデルです。どちらも中国発で、コーディング、特にOpenClawやHermesなどのエージェントによる自律的なコーディングに最適だとされています。機能も似ています。どちらもマルチモーダルに対応し、視覚コンテンツの認識性能が向上しており、その結果、視覚的な資料をもとにコードを書く能力も高まっています。
この2つを見ると、実際のワークフローでコーディングに優れているのはどちらか、という疑問が自然に浮かびます。ベンチマークを分析して読者にわかりやすく解説し、自分たちでも実際にテストを行いました。
Qwen 3.7-Plusとは
比較に入る前に、新しいQwen 3.7-Plusがどのようなモデルかを見てみましょう。
Qwen 3.7-Plusは、Alibabaがより大規模な姉妹モデルのQwen 3.7 Maxとともにリリースした、マルチモーダルのフラッグシップモデルです。Plusは、思考サイクル全体の完了を待つのではなく、数秒で回答が必要なときに使うモデルです。以下の特徴が、3.7-Plusの高速化を支えています。
Qwen 3.7-Plusの特徴:
- マルチモーダル対応。 2週間前に登場したQwen 3.7 Maxは対応していません。画像を使ってチャットしたくても処理できないため、別のモデルに切り替える必要があります。その選択肢がQwen 3.7-Plusです。スクリーンショットをもとにデバッグし、UI要素を操作し、CLIコマンドを実行できます。
- 日常的な大量処理向けに設計 => 推論の深さを抑える代わりに、応答を高速化し、トークン消費を削減します(応答ごとの生成トークン数は約4分の1になる見込みです)。
- ツール呼び出し、自らのプログラミング、検証、テスト、自律的な反復に対応:コードを書き、テストし、失敗を見つけ、人間の入力なしにこのサイクルを繰り返せます。
MiniMax M3とは
MiniMax 3は、中国のMiniMaxによる最新のフロンティアモデルで、新しい独自アーキテクチャであるMiniMax Sparse Attention(MSA)を基盤としています。
一方、MiniMax M3には以下の特徴があります:
- MSA(MiniMax Sparse Attention):各ステップでコンテキスト全体を参照し直す代わりに、KVキャッシュをブロック単位で処理します。1Mトークンでは、前モデルの1/20の計算量で動作し、プリフィルは9.7倍、デコードは15.6倍高速です。
- 2段階の料金設定:512K未満のリクエストでは、1Mトークンあたり入力$0.60、出力$2.40です。それを超えると、料金は2倍の$1.20 / $4.80になります。同程度のコンテキスト長を持つフロンティアモデルの中では、最も安価なモデルの1つです。
- オープンウェイト:重みは2026年6月11日ごろにHuggingFaceで公開される予定です。セルフホストする場合は、 Atomic Chatなどのツールを通じてローカルで動作し、API費用がかからず、データをオンプレミスに保持できます。
- ネイティブなマルチモーダル対応:テキスト、画像、動画は、別のレイヤーとして後から追加されたのではなく、最初から学習に含まれていました。3つすべてを同時に入力として受け付けます。
長時間の自律実行や、コストを重視するワークロードに適しています。ただし、コーディングベンチマークのスコアそのものを最優先の選定基準にする場合は、適合度が下がります。
Qwen 3.7-Plus vs MiniMax M3:コーディングに最適なのはどちらか
Qwen 3.7-PlusはMiniMax M3より安価:
料金の差は劇的ではありませんが、月間使用量で考えると、その差が広がる可能性があります。Qwen 3.7-Plusは、コーディングでトークン消費の大半を占める出力の料金で優位に立ちます。出力1Mトークンあたり$3.75対$4.80で、22%の差です。月間200Mトークンを使用するエージェント活用チームでは、QwenはM3と比べて月額$122を節約できます。
通常のワークロードから大量処理まで、一般的な月間トークン使用量は、個人ならおよそ5M-20M、エージェントを使うワークフローや中規模のチームなら50M-200Mです。
| 入力料金($/1Mトークン) | 出力料金($/1Mトークン) | |
|---|---|---|
| MiniMax M3 | $1.20 | $4.80 |
| Qwen 3.7-Plus | $1.25 | $3.75 |
MiniMax M3 / Qwen 3.7-Plusを個人で使う場合の月額費用の目安:
- 軽いワークロード(>5M):MinimaxM3は$17 / Qwen 3.7-Plusは$14
- 通常のワークロード(10M):MinimaxM3は$34 / Qwen 3.7-Plusは$28
- 重いワークロード(20M):MinimaxM3は$67 / Qwen 3.7-Plusは$55
→ 個人のワークフローでは、Qwen 3.7-Plusで約$3-$12を節約できます
エージェントやチームでMiniMax M3 / Qwen 3.7-Plusを使う場合の月額費用の目安:
- 軽いワークロード(50M):MinimaxM3は$168 / Qwen 3.7-Plusは$138
- 通常のワークロード(100M):MinimaxM3は$336 / Qwen 3.7-Plusは$275
- 重いワークロード(200M):MinimaxM3は$672 / Qwen 3.7-Plusは$550
→ チームやエージェントで作業する場合、Qwen 3.7-Plusで約$30-$122を節約できます
コーディング:各モデルが優位に立つ分野
ターミナルとシェルの作業では、Qwenがリードしています。Terminal-Bench 2.0では70.3対66.0です。また、複数のプログラミング言語を使うコードベース(SWE-Bench Multilingual、複数言語にわたる修正:75.8%)と、API/関数呼び出し(BFCLv4:72.9%)でもスコアが報告されています。どちらも、M3には対応する公表スコアがない分野です。
UIのスクリーンショットを読み取ったり、コードとあわせてモックアップを設計したりする用途では、Qwen 3.7-Plusのマルチモーダル性能の数値が特に優れています。ScreenSpot Proは79.0で、同じ評価におけるGPT-5.4とGemini 3.1 Proを上回っています。
1時間を超えて実行するタスク全般では、M3のほうが優れています。CUDAカーネルの最適化タスクでは、M3は24時間で1,959回のツール呼び出しを行い、147回の提出のうち145回目まで改善を続けました(ほとんどのモデルは30回を過ぎると改善が止まります)。SWE-Bench Proは、人工的に作られた関数ではなく、実際のGitHubのissue解決を評価します。コードベースを読み、バグを特定し、修正コードを書く作業です。M3のスコアは59.0%で、Qwenは57.6%です。差は小さいものの、実際のソフトウェアエンジニアリングの作業に最も近いベンチマークでの差です。
実行中にウェブ調査が必要なタスクでは、BrowseCompの83.5というスコアにより、M3は公表スコアの最上位に位置しています。ほとんどのモデルは30を過ぎると改善が止まります。これは合成ベンチマークではなく、負荷がかかった状態でコンテキストの一貫性を保てるかを直接試すテストです。
マルチモーダル機能とツールの使用
画像ではQwen 3.7-Plusが優位:
Qwen 3.7-Plusは画像入力に対応し、その処理でも優れた性能を発揮します。ScreenSpot Pro(「送信ボタンはどこにあるか」など、スクリーンショット内の特定のUI要素の位置を特定する評価)のスコアは79.0%で、同じ評価におけるGPT-5.4とGemini 3.1 Proを上回っています。
RealWorldQA:86.9%。 Figmaのモックアップ、アーキテクチャ図、不具合のあるUIのスクリーンショットをモデルに渡して、コードの生成や修正を依頼するワークフローでは、Qwen 3.7-Plusが具体的に役立ちます。画像を読み取り、コードについて推論できるためです。
動画ではMiniMax M3が優位:
M3は、動画入力と、MiniMax Codeを通じたデスクトップコンピューターの操作にも対応しています。重要なのはコンピューターの操作です。モデルは見えているものを説明するだけでなく、ブラウザーの操作、クリック、フォームへの入力といったアクションを実行できます。スクリーンショットを見て問題点を説明できるQwen 3.7-Plusに対し、M3はバグを再現する画面録画を見て、関連ファイルを開き、修正できます。
Minimax M3 vs Qwen 3.7-Plus:実際の作業での性能
モデルに与えたタスク:「洗練された、完全に自己完結する事前登録用ランディングページを、単一のHTMLファイルで作成してください(外部CSSフレームワークは使わず、vanilla JSのみ使用)。製品は、個人創業者向けのAIライティングアシスタント『Nova』です。」
ヒーローセクション
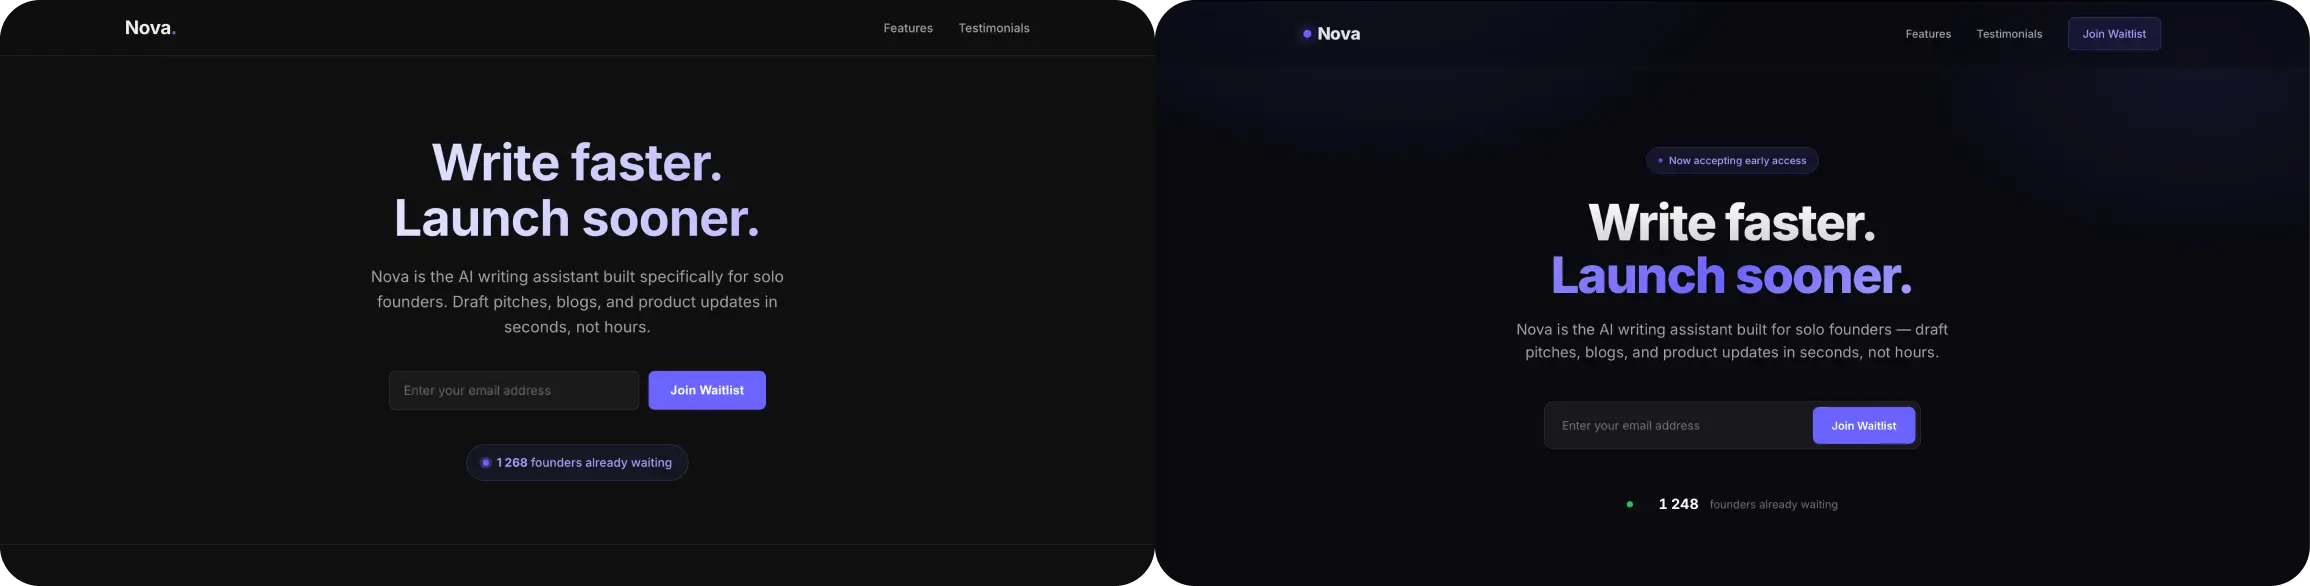
Qwen 3.7-Plusは最初のクリックで読み込めました。すっきりした黒い背景、白い見出し、機能するフォームがあり、問題はありませんでした。
このバージョンは、先に修正が必要でした。出力されたのはHTMLのbodyがないCSSとJavaScriptで、つまりページではなく、ページの部品だったのです。ただし、組み立て直すと違いがはっきり見えます。右側にはヒーローセクションの背後に紫の光があり、見出しの2行目にはアクセントカラーが使われ、ライブ表示のバッジもあります。左側は平坦な見た目です。
このように、デザインではMiniMax M3がはるかに優れていますが、Qwen 3.7-Plusはより明快なコードを生成しました。
機能紹介セクション
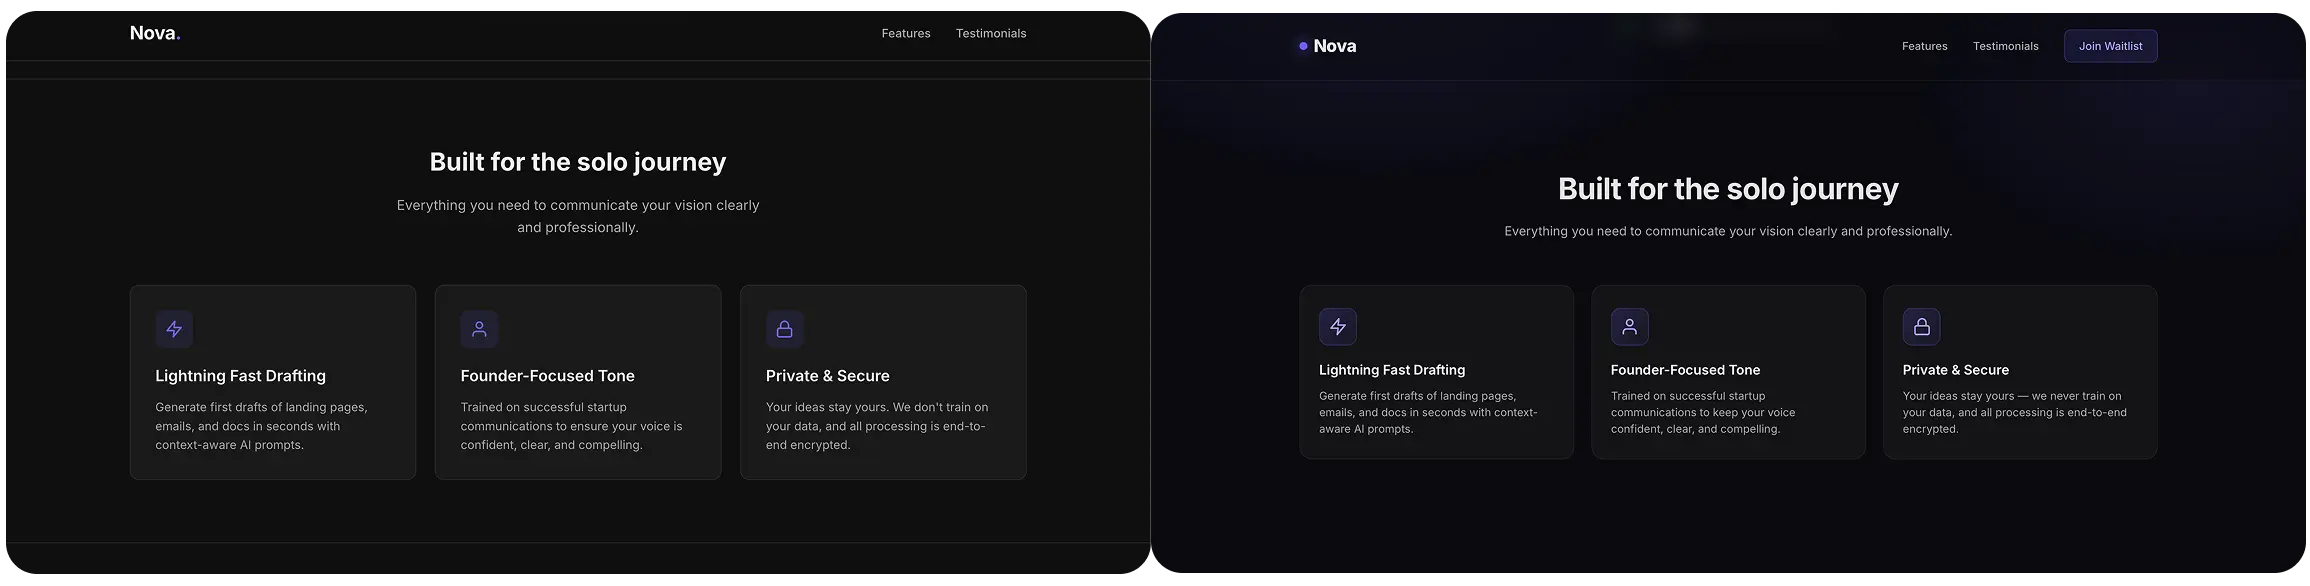
どちらも同じ3枚のカード、同じアイコン、ほぼ同じ文章を採用しました。MiniMaxのカードは、わずかに暖かみのある暗い背景に配置され、余白にもゆとりがあります。Qwenのカードは実用的ですが、詰め込まれた印象です。
ここではどちらも方向性を誤っていませんが、見た目は再びMiniMax M3のほうが優れていました。
利用者の声セクション

Qwenは引用文を先に配置し、発言者の情報を下部に置いています。ごく標準的なカードレイアウトです。
MiniMaxはその順序を逆にし、名前と役割を上部に、引用文を下に配置しています。ウィジェットというより、実際のレビューに近い印象です。また、右側のアバターのグラデーションは人物ごとに異なり、青、ピンク、緑が使われています。一方、Qwenは3人すべてに同じ紫を使っていました。
結果として、Qwenは動くページを生成し、MiniMaxは見栄えがよいものの、動かすには大幅な修正が必要なページを生成しました。これが本番コードのレビューなら、QwenのPRはマージされ、MiniMaxのPRは「HTMLはどこですか?」と差し戻されるでしょう。
用途別の選び方
bashスクリプトとシェル自動化に最適なモデル
Qwen 3.7-Plusです。Terminal-Bench 2.0では70.3で、M3は66.0です。2つのモデルのベンチマーク間で最も大きな差であり、最も一貫して見られる差でもあります。
人間の監視なしで動く自律型コーディングエージェントに最適なモデル
MiniMax M3です。24時間のGPUカーネル最適化タスクで、1,959回のツール呼び出しを行い、147回の提出のうち145回目に最高の結果を達成しました。ほとんどのほかのモデルは30回目の提出を過ぎると改善が止まりました。ここではアーキテクチャの違いが実際に表れています。
修正なしで動く必要がある本番コードに最適なモデル
Qwen 3.7-Plusです。両モデルにガードレールを設けず、同じプロンプトを与えました。Qwenの出力は最初のクリックで読み込めましたが、M3の出力はHTMLのbodyがないCSSとJSでした。見栄えはよいものの、実行可能なページではありませんでした。ただし、MiniMax M3でプロンプトを再実行しても費用はほとんどかからないため、こちらも有力な選択肢です。
バイブコーディングとUIのプロトタイピングに最適なモデル
MiniMax M3です。初回実行時の正しさよりデザインの品質を重視する場合、M3の出力のほうが優れています。また、ナプキンに描いたスケッチをプレイ可能なゲームにするタスクも、1回の実行で処理しました(入力6,920トークン、総費用$0.028)。
セルフホスト型のプライベートなコーディングアシスタントに最適なモデル
MiniMax M3です。オープンウェイトでの公開は2026年6月11日ごろの予定です。ローカルで動作し、APIを使わず、コードがマシンの外に出ることはありません。Qwen 3.7-Plusにはローカルにデプロイする方法がありません。
よくある質問
Qwen 3.7-PlusとQwen 3.7 Maxは同じモデルですか?
いいえ。Maxはテキスト専用で、Plusは画像入力にも対応しています。一般に見かけるコーディングのベンチマークや比較の多くは、Maxを対象としています。記事やスレッドに明記されていなければ、Maxと考えてください。
コーディングの種類ごとに、どちらのモデルが優れていますか?
Qwen 3.7-Plus:ターミナル/シェルスクリプト(Terminal-Benchは70.3対66.0)、複数のプログラミング言語を使うコードベース、API/関数呼び出し、UIのスクリーンショットや図の読み取りを含むワークフローです。M3:実際のGitHubのissue解決(SWE-Bench Proは59.0%対57.6%)、数時間かけてコンテキストが埋まっていく長時間の自律実行、セッションの途中で外部情報を取得する必要があるコーディングタスクです。デバッグ、テスト生成、コードレビューについては、どちらのモデルもタスク別のベンチマークデータを公開していません。
MiniMax M3をローカルで実行できますか?
リリース時点では実行できません。重みは2026年6月1日から約10日以内にHuggingFaceで公開すると発表されました。公開後は、Atomic Chatのようなローカルモデル実行ツールでセルフホストし、推論を完全にオンプレミスで行えます。ただし、現時点でもAPI経由でAtomic Chat 上のMiniMax M3を試すことはできます。ハードウェア要件はほぼなく、出力も高速です。
APIを使うコーディングのワークロードでは、どちらが安価ですか?
Qwen 3.7-Plusです。出力1Mトークンあたり$3.75で、M3は$4.80です。入力料金はほぼ同じです。コーディングでは入力より出力のトークン数が多くなるため、API費用ではQwenが有利です。オープンソースの重みが公開された後は、セルフホストしたM3のほうが安価になります。
結論
同じ条件で、Qwenは動くコードを生成し、M3は見栄えがよいものの、読み込む前に修正が必要なコードを生成しました。これは実際に、ベンチマークが示す傾向とも一致しています。 正確さが重視されるタスクではQwenが優位で、より長時間かかる、より意欲的なタスクではM3が優位です。要するに、プロンプトの再実行を許容できるなら、 費用は高くなく、特にプロンプトをより具体的にすると、実際によい結果が得られます。
人によっては、料金差よりもオープンソースかどうかが重要です。M3の重みがHuggingFaceで公開されれば、ローカルでの実行費用は実質的にかかりません。ただし、最大の魅力は費用ではありません。 機密データを扱う開発者にとって重要なのは、何もマシンの外に出ないことです。M3をローカルで実行する場合はクラウドAPIを使う必要がなく、推論のためにデータを第三者のサーバーへ送信する必要もありません。残念ながら、Qwen 3.7-Plusにはローカルで実行する方法がまったくありません。
今すぐAPIで使うなら、Qwenのほうが安価で、動くコードを生成します。ローカルへのデプロイやデータのプライバシーを今後の計画に含めているなら、重みの公開前からM3の導入に向けて準備する価値があります。