

Ling 3.0 Flashは、Ant Groupの最新のオープンウェイト推論モデルです。総パラメータ数は124Bで、GGUF量子化版のサイズは32 GBからとなっており、ハイエンドのMacやワークステーションで実用的に実行できます。
このガイドでは、次の内容を解説します。
- Ling 3.0 Flashの概要とハードウェア要件
- Atomic ChatでLing 3.0をローカル実行する方法
- TurboQuant版llama.cppのコマンドラインからLing 3.0を実行する方法
Ling 3.0 Flashとは?
Ling 3.0 Flashは、Ant GroupのinclusionAIチームが開発した124BのMixture-of-Experts(MoE)言語モデルです。トークンごとのアクティブパラメータ数は5.1Bで、デフォルトで推論が有効になっています。
注目すべき点は、Antが従来のフラッグシップモデルである1TパラメータのRing-2.6-1Tを置き換えるためにLing 3.0 Flashを開発したことです。その総パラメータ数は従来のフラッグシップの約12%、アクティブパラメータ数は8%でありながら、主要ベンチマークの大半で同等以上の性能を示しています。
| 仕様 | Ling-3.0-flash |
|---|---|
| 総パラメータ数 | 124B |
| トークンごとのアクティブパラメータ数 | 5.1B |
| エキスパート | ルーティング対象512個 + 共有1個、トークンごとに8個がアクティブ |
| アテンション | ハイブリッド線形:KDAブロック35個 + ゲート付きMLAブロック7個 |
| コンテキスト長 | 256Kトークン |
| ライセンス | MIT |
Ling 3.0 Flashは、42層のTransformer層のうち35層でKimi Delta Attentionを使用しています。標準的なアテンションとは異なり、コンテキスト長に応じて増大するKVキャッシュの代わりに固定サイズの状態を保持することで、推論中のメモリ使用量を削減します。この点については、ハードウェア要件の説明で改めて取り上げます。
Hugging Faceの公式リリースには、SGLangやvLLMなどの推論フレームワーク向けに、BF16、FP8、FP4、INT4のチェックポイントが含まれています。ただし、Ling 3.0をローカルで実行するにあたっては、私たちが作成したGGUFビルドを使用します(詳細は後述します)。
以下の表は、Ling 3.0 Flashのベンチマーク結果をRing-2.6-1T、MiniMax-M2.7、DeepSeek V4 Flash、Nemotron 3 Super 120B、およびクローズドソースの比較対象であるGPT-5.4-miniとClaude Sonnet 4.6と比較したものです。
| ベンチマーク | Ling-3.0-flash | Ring-2.6-1T | MiniMax-M2.7 | DeepSeek-V4-Flash | Nemotron-3-Super-120B | GPT-5.4-mini | Claude Sonnet 4.6 |
|---|---|---|---|---|---|---|---|
| パラメータ数 | 124B / アクティブ5.1B | 1T / アクティブ63B | 230B / アクティブ10B | 284B / アクティブ13B | 120B / アクティブ12B | — | — |
| AIME 2026 | 93.2 | 95.8 | 94.2 | 96.5 | 91.7 | 92.9 | 94.4 |
| HMMT Feb 2026 | 87.0 | 93.5 | 71.9 | 94.8 | 84.9 | 83.9 | 85.6 |
| SWE-bench Multilingual | 72.4 | 56.7 | 76.5 | 73.3 | 42.7 | 71.0 | 75.9 |
| SWE-bench Pro | 56.6 | 53.9 | 56.2 | 52.6 | 34.1 | 47.9 | 48.3 |
| HLE | 22.7 | 18.3 | 28.1 | 34.8 | 18.3 | 20.6 | 30.0 |
公開されているベンチマークに加え、私たちも簡単な独自テストを実施し、2つのワンショットのコーディングプロンプトで、Ling 3.0 Flashを同規模の3つのオープンモデル、gpt-oss 120B、Nemotron 120B、Qwen3.5 122Bと比較しました。まずは、跳ねるボールの物理シミュレーションです。
続いて、スネークゲームです。
Ling 3.0をローカルで実行する方法
事前準備
Ling 3.0をローカルで実行するには、モデルを読み込んで実行できるローカルAIアプリと、対応形式のモデルファイルが必要です。
このガイドでは、デバイス上でのオープンモデルの実行に標準対応した、私たちのローカルAIアプリAtomic Chatを使用します。Atomic ChatはTurboQuantエンジンを採用しており、Ling 3.0が使用するbailingmoe3アーキテクチャに対応しています。
ハードウェア要件
以下の表は、利用可能なハードウェアに応じて、ダウンロードを推奨するLing 3.0 Flashのビルドを示しています。
| ハードウェア | 無理なく実行できるビルド |
|---|---|
| MacBook Pro M4/M5 Max (48 GB) | IQ2_XXS (39.2 GB)、余裕が少ないためGPUメモリ上限の引き上げが必要 |
| MacBook Pro / Mac Studio (64 GB) | IQ2_M (49.1 GB)、または設定調整によりIQ3_XXS (57.1 GB) |
| Mac Studio (96 GB) | IQ4_XXS (69.3 GB)またはQ4_K_S (74.2 GB) |
| Mac Studio (128 GB) | AD-Q5_K_M (89.4 GB)、推奨ビルド |
| Mac Studio (192 GB+) | Q6_K (107.5 GB)またはQ8_0 (133.1 GB) |
| PC、24 GB GPU + 64 GB RAM | エキスパートをCPUにオフロードしてIQ2_Mを実行 |
| PC、32 GB GPU + 96 GB RAM | エキスパートをCPUにオフロードしてIQ4_XXSを実行 |
| ワークステーション、96 GB GPUを4基 | どのビルドも全体をGPU上で実行可能 |
PCのVRAM(Macの場合はユニファイドメモリ)がモデル全体を収めるのに足りない場合、通常はより小さいモデルを探すことをお勧めします。しかし、Ling 3.0 Flashはモデルの一部をシステムRAMにオフロードしても、比較的効率よく実行できます。Mixture-of-Experts設計のため、推論中のメモリ使用量が同規模のデンスモデルより少ないからです。
また、Ling 3.0 Flashのハイブリッドアテンション機構は、長いコンテキストでのメモリ使用量をさらに削減します。標準的なTransformerでは、トークンが生成されるたびにKVキャッシュが増大し、大きなメモリオーバーヘッドが生じることがあります。一方、Ling-3.0-flashは、固定サイズの状態を持つ35個のKimi Delta Attention(KDA)ブロックと、圧縮されたKVキャッシュを持つ7個のMLAブロックを使用しています。これにより、長い会話に必要なメモリが削減され、モデルの256Kというコンテキスト長をローカルハードウェアでより実用的に利用できます。すべての層で標準的なアテンションを使用するアーキテクチャと同じようには、メモリ使用量が増大しないためです。
ここまでの内容を踏まえると、Atomic ChatでLing 3.0を実行する手順は簡単です。
1. Atomic Chatをインストールする
atomic.chatから、お使いのプラットフォーム向けのAtomic Chatをダウンロードしてインストールします。
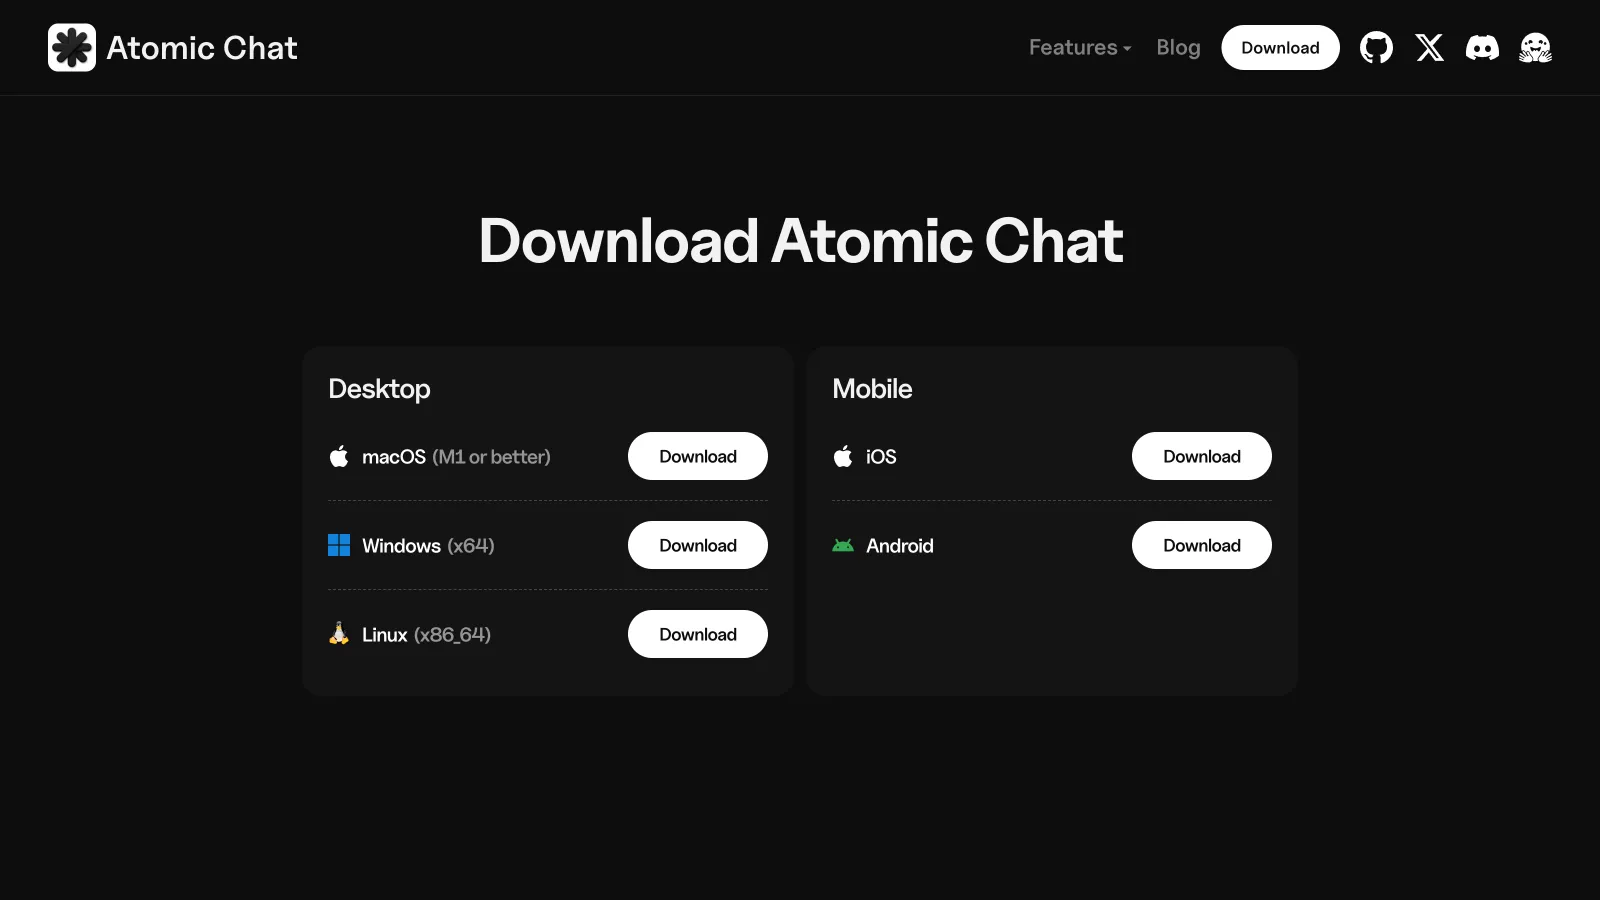
利用可能なビルド:
- macOS:Apple Silicon(M1以降)向けのユニバーサル
.dmg。 - Windows:x64向けの
.exeインストーラー。 - Linux:x86_64向けのスタンドアロン
.AppImage。 - iOS:App Storeから入手できます。
- Android:Google Playから入手できます。
Linuxでは、起動する前にAppImageに実行権限を付与します。
chmod +x AtomicChat.AppImage
アプリがFUSE依存関係の不足を報告した場合は、お使いのディストリビューションのパッケージマネージャーでインストールしてください。DebianとUbuntuの場合:
sudo apt install fuse libfuse2
Fedoraの場合:
sudo dnf install fuse fuse-libs
2. モデルカタログでLing 3.0を探す
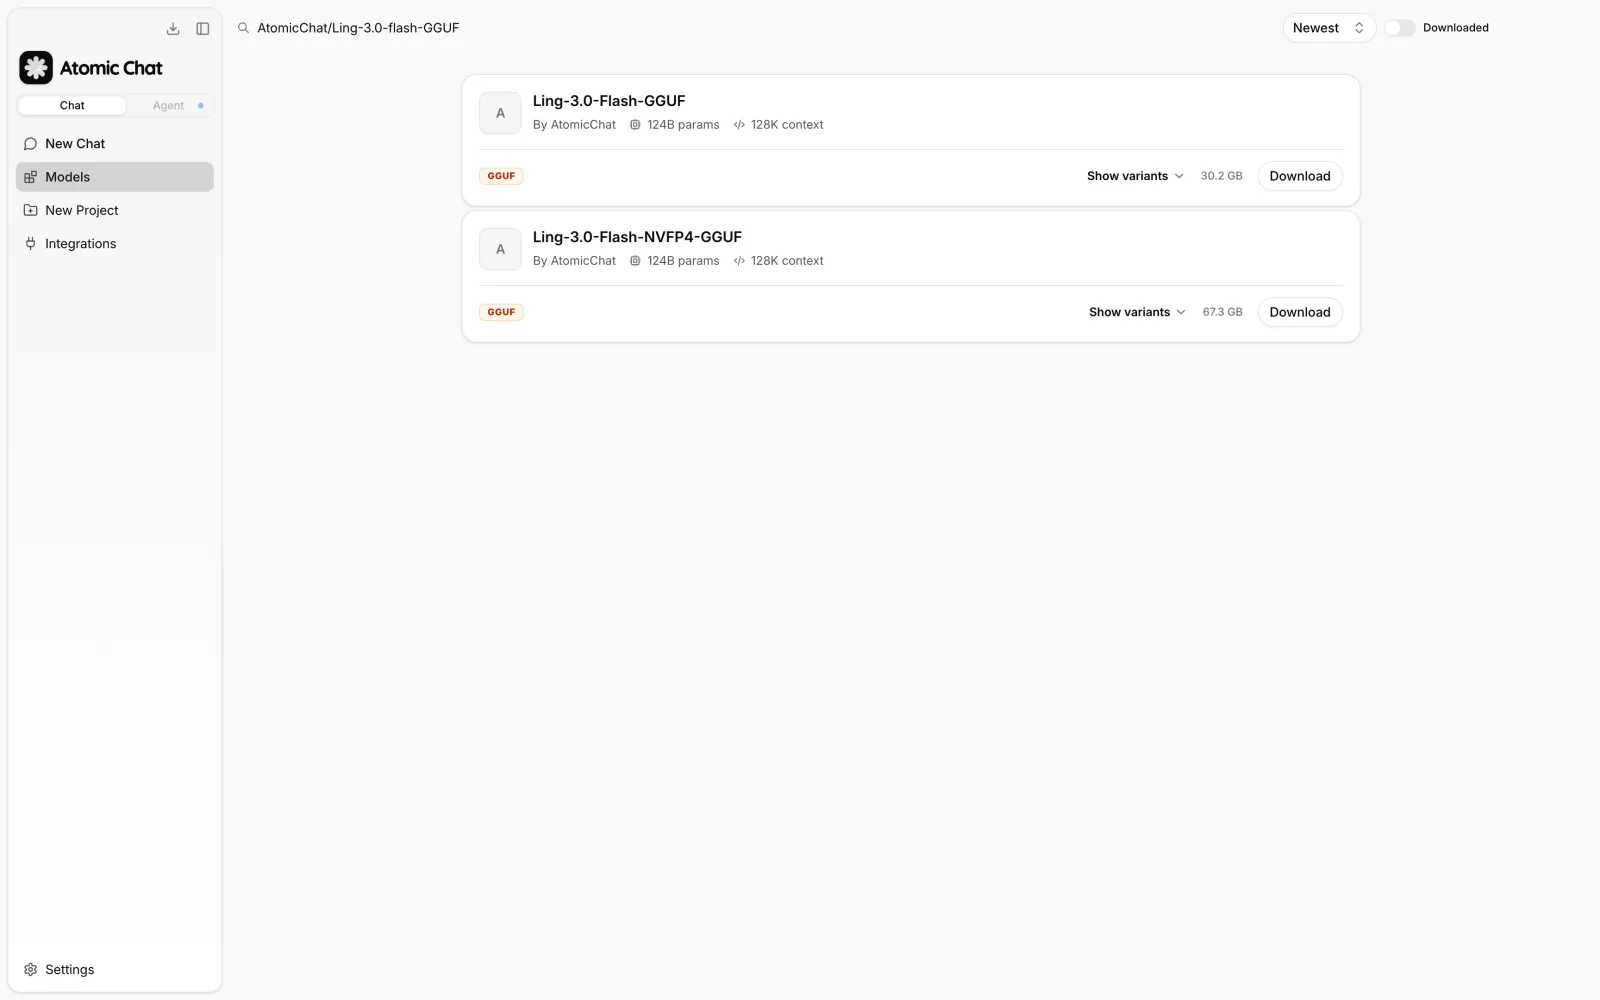
Atomic Chat → Modelsを開きます。カタログにはHugging Faceのオープンウェイトモデルが掲載されており、アプリ内で直接ダウンロードして管理できます。
検索する文字列:AtomicChat/Ling-3.0-flash-GGUF
lingを検索して、利用可能なLingモデルを探すこともできます。
3. Ling 3.0のビルドをダウンロードする
Downloadをクリックしてモデルのダウンロードを開始するか、Download Optionsを選択して利用可能な量子化版を表示します。
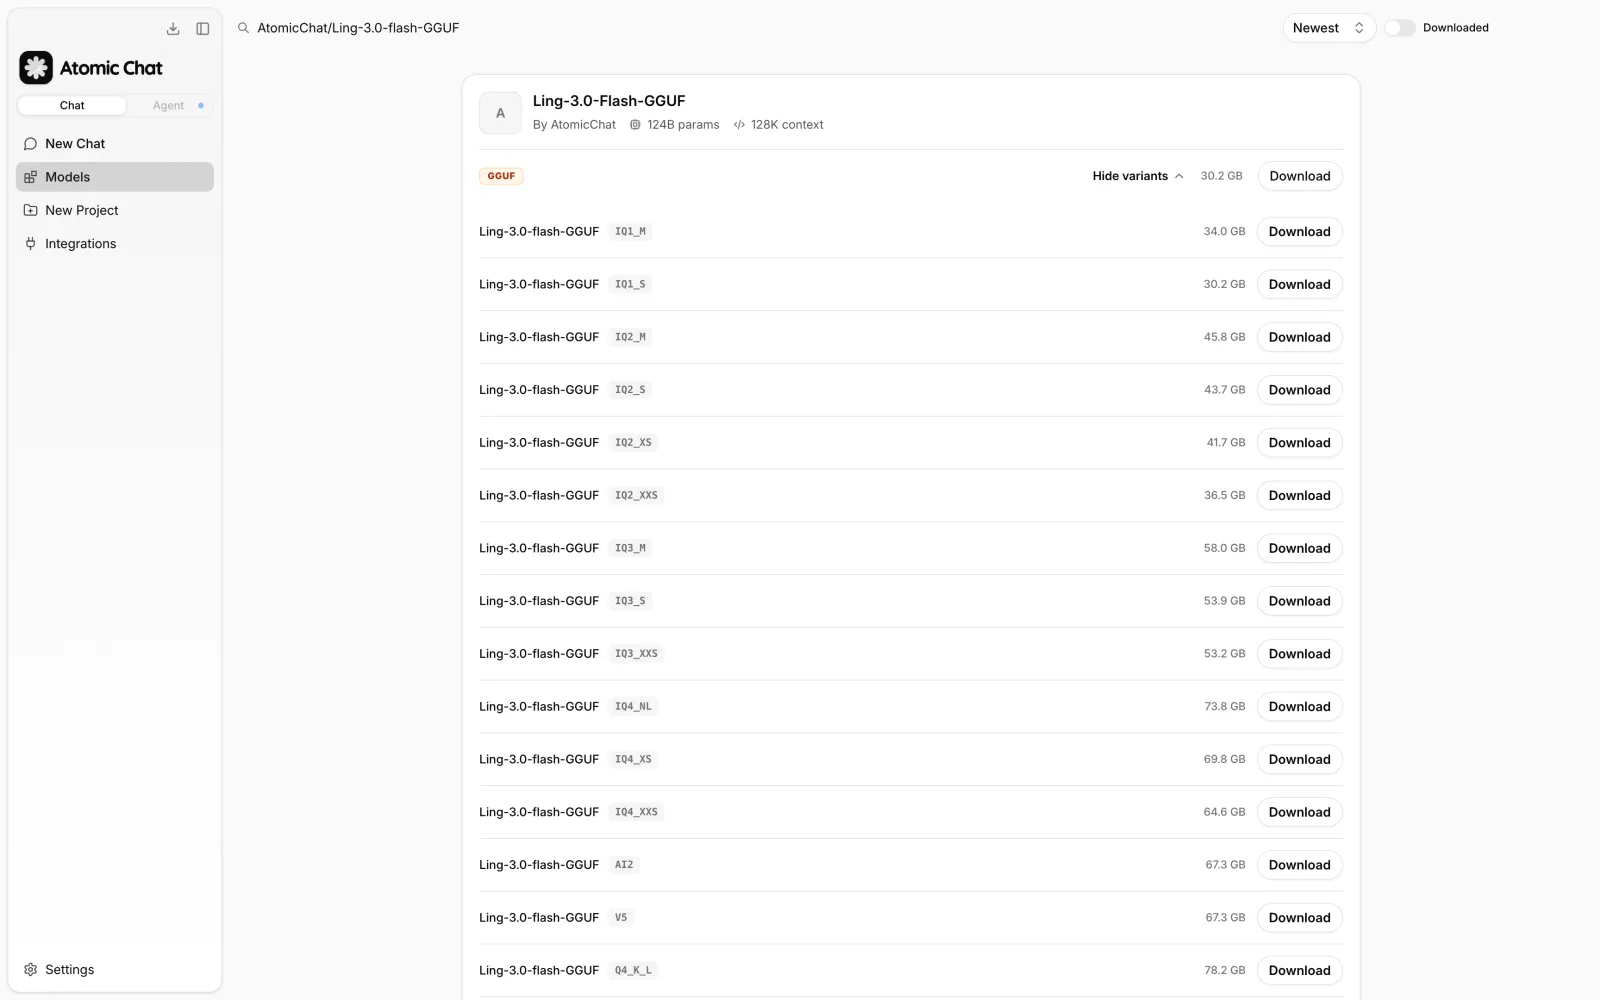
利用可能なビルドはIQ1_S (32.4 GB)からQ8_0 (133.1 GB)まであり、量子化していないBF16の重み(249 GB)も利用できます。利用可能なメモリに収まる量子化版を選んでください。OSと推論ランタイムのために、少なくとも8 GBの空きメモリを確保してください。
4. Ling 3.0とのチャットを始める
ダウンロードが完了すると、Atomic Chatがモデルを読み込み、内蔵チャットで開きます。
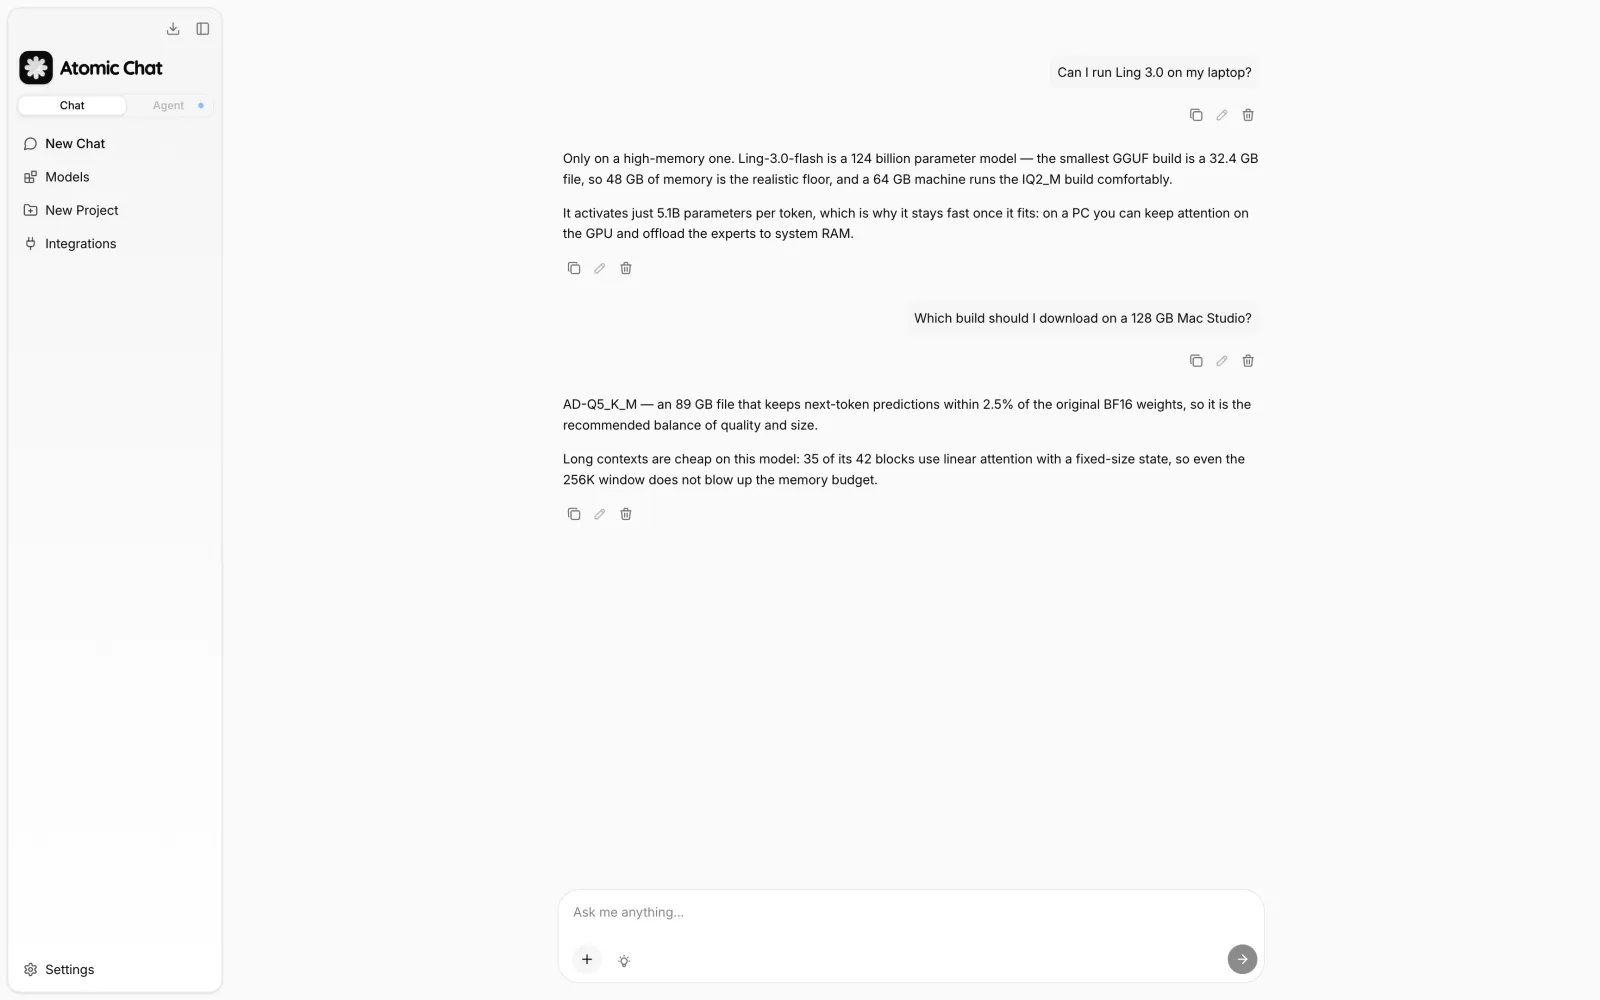
思考モードはデフォルトで有効になっています。Ling-3.0-flashは最終回答の前に推論過程を生成でき、Atomic Chatではこの出力の表示と非表示を切り替えられます。
Atomic Chatはモデルをローカルで実行し、以下のアドレスでOpenAI互換APIサーバーも提供します。
http://localhost:1337/v1
これにより、Claude CodeやClineなどのコーディングエージェントを含む、OpenAI API形式に対応したツールで、Ling 3.0をローカルモデルとして利用できます。
Ling 3.0 Flash向けAtomic Dynamic GGUFビルド
このガイドで紹介するGGUFファイルはAtomic Chatチームが作成したもので、AtomicChat/Ling-3.0-flash-GGUFリポジトリから入手できます。
124BのMoEモデルをローカルで実行するには大幅な量子化が必要で、通常は性能が大きく低下します。Ling 3.0では、モデルのすべての部分が同じように重要なわけではないため、この方法では維持できるはずの品質を大きく損なってしまいます。
私たちは、この問題に対処するためにAtomic Dynamic(AD)量子化を開発しました。ADはモデル全体に固定のビット配分を適用するのではなく、量子化誤差の影響が大きい部分では高い精度を保ち、圧縮に対する耐性が高い部分をより強く圧縮します。
その結果、同程度のファイルサイズで、元のBF16モデルの品質をより多く保持するGGUFビルド群が得られました。標準的なllama.cppの量子化と比較すると、テストした量子化レベルでは、ADビルドはBF16との差が31〜41%小さくなっています。
これらのファイルにはTurboQuantビルドが必要です。Ling 3.0が使用するbailingmoe3アーキテクチャは、執筆時点では上流のllama.cppでまだサポートされていないためです。
Ling 3.0 FlashのAtomic Dynamicビルドの仕組み
Atomic Dynamicは、すべてのテンソルに同じ量子化設定を割り当てるのではなく、誤差が最終出力に影響しやすい部分により多くのビットを割り当てます。
ビット配分は、次の3つの観点から調整します。
- テンソルの役割。テンソルによって誤差への敏感さは異なります。MoEルーター(
ffn_gate_inp)は、その誤差によって選択されるエキスパートが変わる可能性があるため、F32のまま保持します。アテンションの構成要素、KDAゲート、共有エキスパート、出力テンソルも、高い精度を維持します。 - 射影の感度。各エキスパートの内部では、射影ごとにモデル品質への影響が異なります。ADは、SwiGLUブロック内でより感度の高い部分である
down_projに、gate_projやup_projよりも高い精度を割り当てます。 - モデルの深さ。すべての層が同じように寄与するわけではありません。両端に近いMoEブロック(層2、3、39、40、41)には、量子化の影響が小さい中間層よりも高い精度を割り当てます。
Ling 3.0のパラメータの大半はルーティング対象のエキスパートに格納されているため、圧縮の大部分はここで行われます。残りの構成要素は高い精度を維持し、最終的なモデルサイズへの追加分は約4 GBにとどまります。
ADと標準量子化の比較
以下の表は、ADビルドと標準量子化を比較したものです。_STOCKが付いたファイルは標準的なllama.cppの量子化処理を使用し、_FLATはADのテンソルごとの調整を無効にします。
| ADビルド | サイズ | 比較対象 | サイズ | 差 |
|---|---|---|---|---|
| AD-Q5_K_M | 89.4 GB | Q5_K_M_STOCK | 88.3 GB | KLダイバージェンスが31%低下 |
| AD-Q4_K_S | 74.2 GB | Q4_K_M_STOCK | 75.3 GB | KLダイバージェンスが38%低下 |
| AD-IQ4_XXS | 69.3 GB | IQ4_XS_STOCK | 66.4 GB | KLダイバージェンスが41%低下 |
また、リポジトリ内のすべてのビルドについて、元のBF16モデルに対するKLダイバージェンスで評価しました。
| ビルド | サイズ | Top-1トークン一致率 |
|---|---|---|
| Q8_0 | 133.1 GB | 98.1% |
| Q6_K | 107.5 GB | 97.9% |
| AD-Q5_K_M | 89.4 GB | 97.5% |
| AD-Q4_K_S | 74.2 GB | 96.6% |
| AD-IQ4_XXS | 69.3 GB | 96.4% |
| IQ3_M | 62.2 GB | 95.3% |
| IQ2_M | 49.1 GB | 92.5% |
| IQ1_S | 32.4 GB | 86.6% |
ご覧のとおり、IQ3の水準までは品質が徐々に低下します。Q4以上では元のモデルに近い振る舞いを示しますが、IQ2ビルドでも十分に実用的です。
llama.cppでLing 3.0を実行する
これらのGGUFファイルは、TurboQuant版llama.cppを使ってコマンドラインから実行することもできます。
TurboQuantのリリースページから、お使いのプラットフォーム向けにビルド済みのアーカイブをダウンロードします。以下のビルドが用意されています。
- Linux(CUDA 12/13、ROCm、Vulkan、CPUのみ)
- Linux arm64
- macOS Apple Silicon
- Windows
執筆時点では、ビルド済みリリースにIntel GPUのサポートは含まれておらず、ソースからのビルドが必要です。
たとえば、NVIDIA GPUを搭載したLinuxの場合:
wget https://github.com/AtomicBot-ai/atomic-llama-cpp-turboquant/releases/download/b10269-1.5.0/llama-turboquant-linux-x64-cuda-13.3.tar.gz
tar xzf llama-turboquant-linux-x64-cuda-13.3.tar.gz && cd llama-turboquant-*
./llama-cli -m Ling-3.0-flash-AD-Q5_K_M-00001-of-00002.gguf --jinja -ngl 99 -c 32768
-ngl 99はすべての層をGPUにオフロードし、-c 32768はコンテキスト長を設定します。Apple Siliconでは、同じコマンドがMetalを通じてネイティブに実行され、MLXは必要ありません。
4基のRTX PRO 6000 BlackwellにAD-Q5_K_Mを完全にGPUオフロードした場合の実測速度は、プロンプト処理が3,309トークン/秒、生成が106.6トークン/秒です。
よくある質問
Ling 3.0 Flashをローカルで実行するには、どのようなハードウェアが必要ですか?
Ling 3.0 Flashは124BのMoEモデルのため、大容量のメモリが必要です。48 GBのシステムでも最小の量子化版を実行できますが、より実用的な出発点は64 GBです。128 GBあれば、AD-Q5_K_Mなどの高品質なビルドを実行できます。
Ling 3.0の最小の量子化版はどれですか?
公開されている最小のGGUFビルドは、32.4 GBのAD-IQ1_Sです。メモリの少ないシステムでもモデルを実行できますが、サイズの大きい量子化版と比べると品質は低下します。
Ling 3.0 FlashはMacで実行できますか?
はい。Ling 3.0 Flashは、Apple Silicon搭載のMacでMetalを通じて動作します。モデルとランタイムの両方がユニファイドメモリを使用するため、メモリ容量の大きいMacでは、より大きな量子化版を実行できます。
Ling 3.0 Flashはインターネット接続なしで実行できますか?
はい。モデルファイルのダウンロード後は、デバイス上でローカルに推論を実行します。インターネット接続が必要なのは、モデルとアップデートをダウンロードするときだけです。
Ling 3.0 Flashはオープンソースですか?
Ling 3.0 Flashの重みはMITライセンスで公開されています。このライセンスでは、商用用途を含め、使用、改変、再配布が認められています。
Ling 3.0 Flashと従来のLingまたはRingモデルの違いは何ですか?
Ling 3.0 Flashは、従来のLingとRingのアプローチを単一のハイブリッド推論モデルに統合しています。同じモデルの重みで、通常のチャットと推論ワークフローに対応します。
Ling 3.0 Flashには、なぜ特別なllama.cppビルドが必要なのですか?
Ling 3.0 Flashは、bailingmoe3モデルアーキテクチャを使用しています。GGUFファイルには、Atomic Chatで使用しているTurboQuantビルドなど、このアーキテクチャに対応したllama.cppビルドが必要です。
まとめ
Ling 3.0 Flashは、量子化ビルドによるローカル推論向けに設計された124BのMoEモデルです。適切なハードウェアがあれば、大容量メモリを搭載したMac、ワークステーション、GPUシステムで実行できます。
主なポイント:
- Ling-3.0-flashは、総パラメータ数124B、トークンごとのアクティブパラメータ数5.1B、コンテキスト長256Kを備え、MITライセンスで公開されています。
- モデルの実行には、Atomic ChatやTurboQuant版llama.cppなど、
bailingmoe3アーキテクチャに対応したソフトウェアが必要です。 - 利用可能なGGUF量子化版は、32.4 GB (AD-IQ1_S)から133.1 GB (Q8_0)まであります。品質とメモリ使用量のバランスでは、AD-Q5_K_M (89.4 GB)を推奨します。
- 実用的な出発点は48 GBのメモリで、128 GBのシステムなら、より高品質な量子化版を実行できます。
- Ling 3.0のハイブリッドアテンション設計は、標準的なアテンションアーキテクチャと比べ、長いコンテキストを扱うワークロードでメモリ使用量の削減に役立ちます。




